Optimización de inferencias de YOLO26 con el motor DeepSparse de Neural Magic#
Al implementar modelos de detección de objetos como Ultralytics YOLO26 en distintos tipos de hardware, puedes encontrarte con problemas específicos, como la optimización. Aquí es donde entra en juego la integración de YOLO26 con el motor DeepSparse de Neural Magic. Esta integración transforma la forma de ejecutar los modelos YOLO26 y permite alcanzar un rendimiento de nivel GPU directamente en las CPU.
Esta guía te muestra cómo implementar YOLO26 usando DeepSparse de Neural Magic, cómo ejecutar inferencias y cómo comparar el rendimiento para garantizar que esté optimizado.
Neural Magic fue adquirida por Red Hat en enero de 2025 y está dejando de ofrecer las versiones comunitarias de sus bibliotecas deepsparse, sparseml, sparsezoo y sparsify. Para obtener más información, consulta el aviso publicado en el archivo Readme del repositorio de sparsify en GitHub.
DeepSparse de Neural Magic#
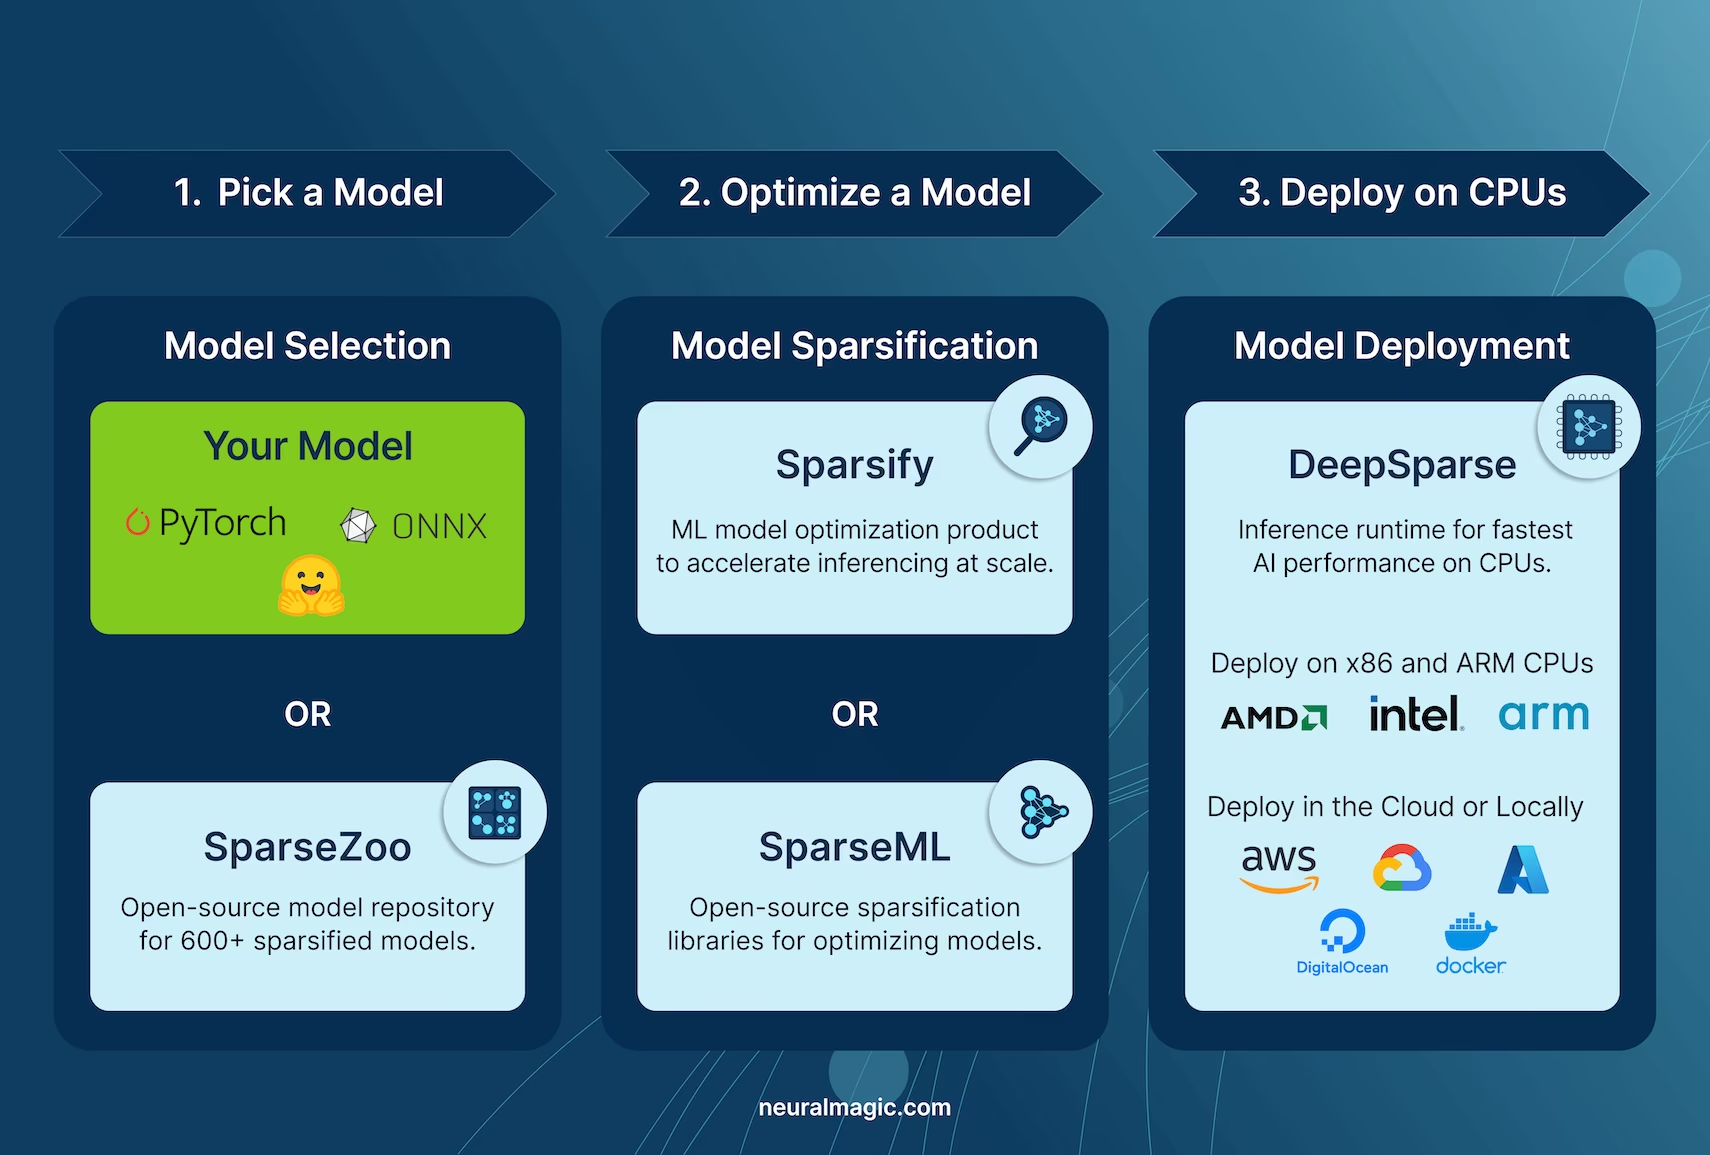
DeepSparse de Neural Magic es un entorno de ejecución de inferencias diseñado para optimizar la ejecución de redes neuronales en CPU. Aplica técnicas avanzadas como la esparsidad, la poda y la cuantización para reducir drásticamente las exigencias computacionales sin perder precisión. DeepSparse ofrece una solución ágil para ejecutar redes neuronales de forma eficiente y escalable en distintos dispositivos.
Ventajas de integrar DeepSparse de Neural Magic con YOLO26#
Antes de explicar cómo implementar YOLO26 usando DeepSparse, veamos las ventajas de utilizar DeepSparse. Entre sus principales ventajas se incluyen:
- Mayor velocidad de inferencia: alcanza hasta 525 FPS (con YOLO11n), acelerando significativamente las capacidades de inferencia de YOLO en comparación con los métodos tradicionales.
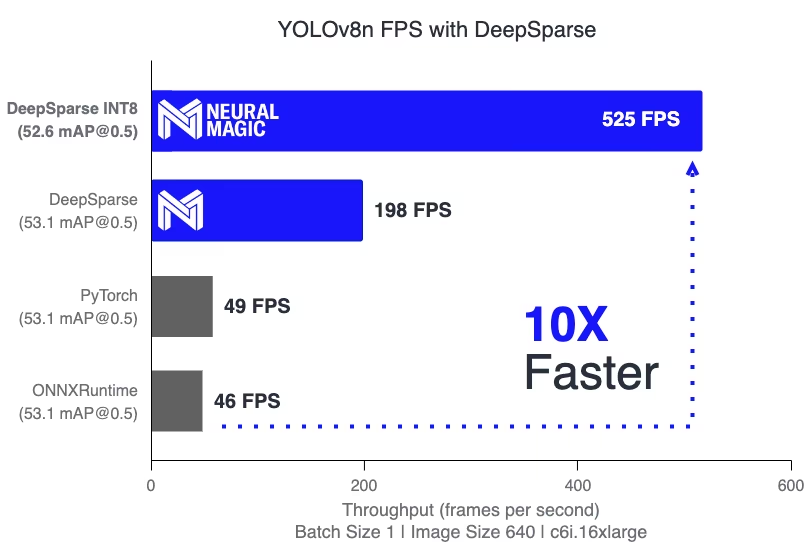
- Eficiencia optimizada del modelo: utiliza poda y cuantización para mejorar la eficiencia de YOLO26, reduciendo el tamaño del modelo y los requisitos computacionales sin perder precisión.
-
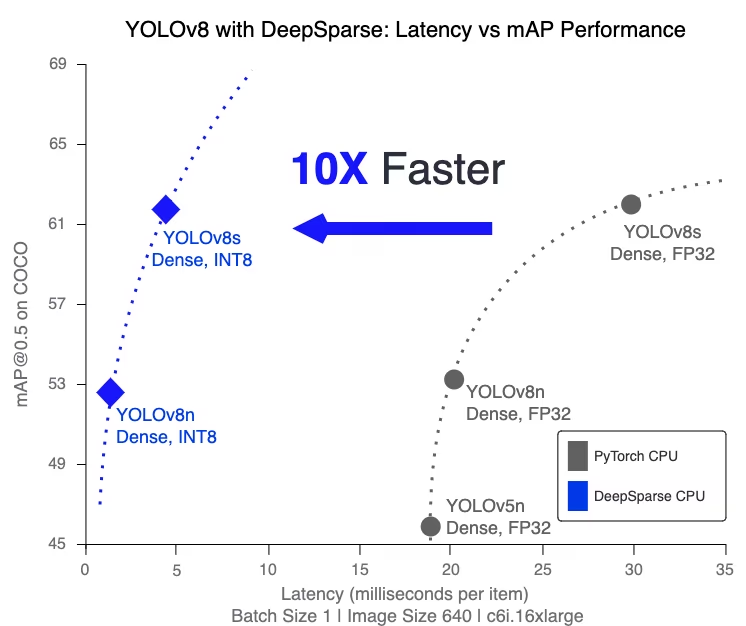
Alto rendimiento en CPU estándar: ofrece un rendimiento similar al de una GPU en CPU, proporcionando una opción más accesible y rentable para distintas aplicaciones.
-
Integración e implementación simplificadas: ofrece herramientas fáciles de usar para integrar YOLO26 en aplicaciones, incluidas funciones de anotación de imágenes y vídeos.
-
Compatibilidad con distintos tipos de modelos: es compatible tanto con modelos YOLO26 estándar como optimizados mediante esparsidad, lo que aporta flexibilidad en la implementación.
-
Solución rentable y escalable: reduce los costes operativos y permite implementar modelos avanzados de detección de objetos de forma escalable.
¿Cómo funciona la tecnología DeepSparse de Neural Magic?#
La tecnología DeepSparse de Neural Magic se inspira en la eficiencia del cerebro humano al realizar cálculos con redes neuronales. Adopta los dos principios clave siguientes del cerebro:
-
Esparsidad: el proceso de esparsificación consiste en podar información redundante de las redes de aprendizaje profundo, lo que da lugar a modelos más pequeños y rápidos sin comprometer la precisión. Esta técnica reduce significativamente el tamaño de la red y sus necesidades computacionales.
-
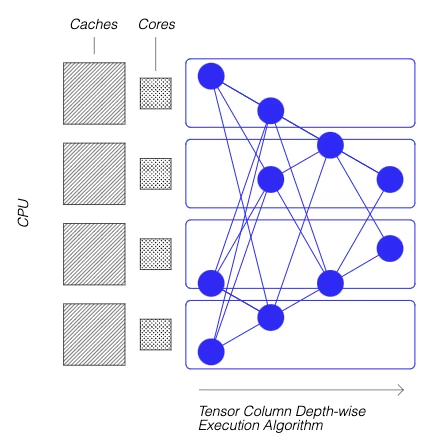
Localidad de referencia: DeepSparse utiliza un método de ejecución único que divide la red en columnas tensoriales. Estas columnas se ejecutan en profundidad y caben completamente en la caché de la CPU. Este enfoque imita la eficiencia del cerebro, minimizando el movimiento de datos y maximizando el uso de la caché de la CPU.
Creación de una versión dispersa de YOLO26 entrenada con un conjunto de datos personalizado#
SparseZoo, un repositorio de modelos de código abierto de Neural Magic, ofrece una colección de puntos de control de modelos YOLO26 preesparsificados. Con SparseML, integrado perfectamente con Ultralytics, puedes ajustar estos puntos de control dispersos en tus conjuntos de datos específicos mediante una interfaz de línea de comandos sencilla.
Consulta la documentación de SparseML YOLO26 de Neural Magic para obtener más información.
Uso: implementación de YOLO26 con DeepSparse#
Implementar YOLO26 con DeepSparse de Neural Magic requiere unos sencillos pasos. Antes de consultar las instrucciones de uso, asegúrate de revisar la variedad de modelos YOLO26 ofrecidos por Ultralytics. Esto te ayudará a elegir el modelo más adecuado para los requisitos de tu proyecto. Así puedes empezar.
Paso 1: instalación#
Para instalar los paquetes necesarios, ejecuta:
# Install the required packages
pip install deepsparse[yolov8]
Paso 2: exportación de YOLO26 al formato ONNX#
El motor DeepSparse requiere modelos YOLO26 en formato ONNX. Exportar tu modelo a este formato es esencial para garantizar la compatibilidad con DeepSparse. Utiliza el siguiente comando para exportar modelos YOLO26:
# Export YOLO26 model to ONNX format
yolo detect export model=yolo26n.pt format=onnx opset=13
Este comando guardará el modelo yolo26n.onnx en tu disco.
Paso 3: implementación y ejecución de inferencias#
Con tu modelo YOLO26 en formato ONNX, puedes implementarlo y ejecutar inferencias mediante DeepSparse. Puedes hacerlo fácilmente con su intuitiva API de Python:
from deepsparse import Pipeline

# Specify the path to your YOLO26 ONNX model
model_path = "path/to/yolo26n.onnx"

# Set up the DeepSparse Pipeline
yolo_pipeline = Pipeline.create(task="yolov8", model_path=model_path)

# Run the model on your images
images = ["path/to/image.jpg"]
pipeline_outputs = yolo_pipeline(images=images)
Paso 4: evaluación comparativa del rendimiento#
Es importante comprobar que tu modelo YOLO26 funciona de forma óptima en DeepSparse. Puedes comparar el rendimiento de tu modelo para analizar el rendimiento y la latencia:
# Benchmark performance
deepsparse.benchmark model_path="path/to/yolo26n.onnx" --scenario=sync --input_shapes="[1,3,640,640]"
Paso 5: funciones adicionales#
DeepSparse proporciona funciones adicionales para integrar YOLO26 de forma práctica en aplicaciones, como la anotación de imágenes y la evaluación de conjuntos de datos.
# For image annotation
deepsparse.yolov8.annotate --source "path/to/image.jpg" --model_filepath "path/to/yolo26n.onnx"

# For evaluating model performance on a dataset
deepsparse.yolov8.eval --model_path "path/to/yolo26n.onnx"
Al ejecutar el comando annotate se procesa la imagen especificada, se detectan los objetos y se guarda la imagen anotada con cuadros delimitadores y clasificaciones. La imagen anotada se almacenará en una carpeta annotation-results. Esto ayuda a ofrecer una representación visual de las capacidades de detección del modelo.
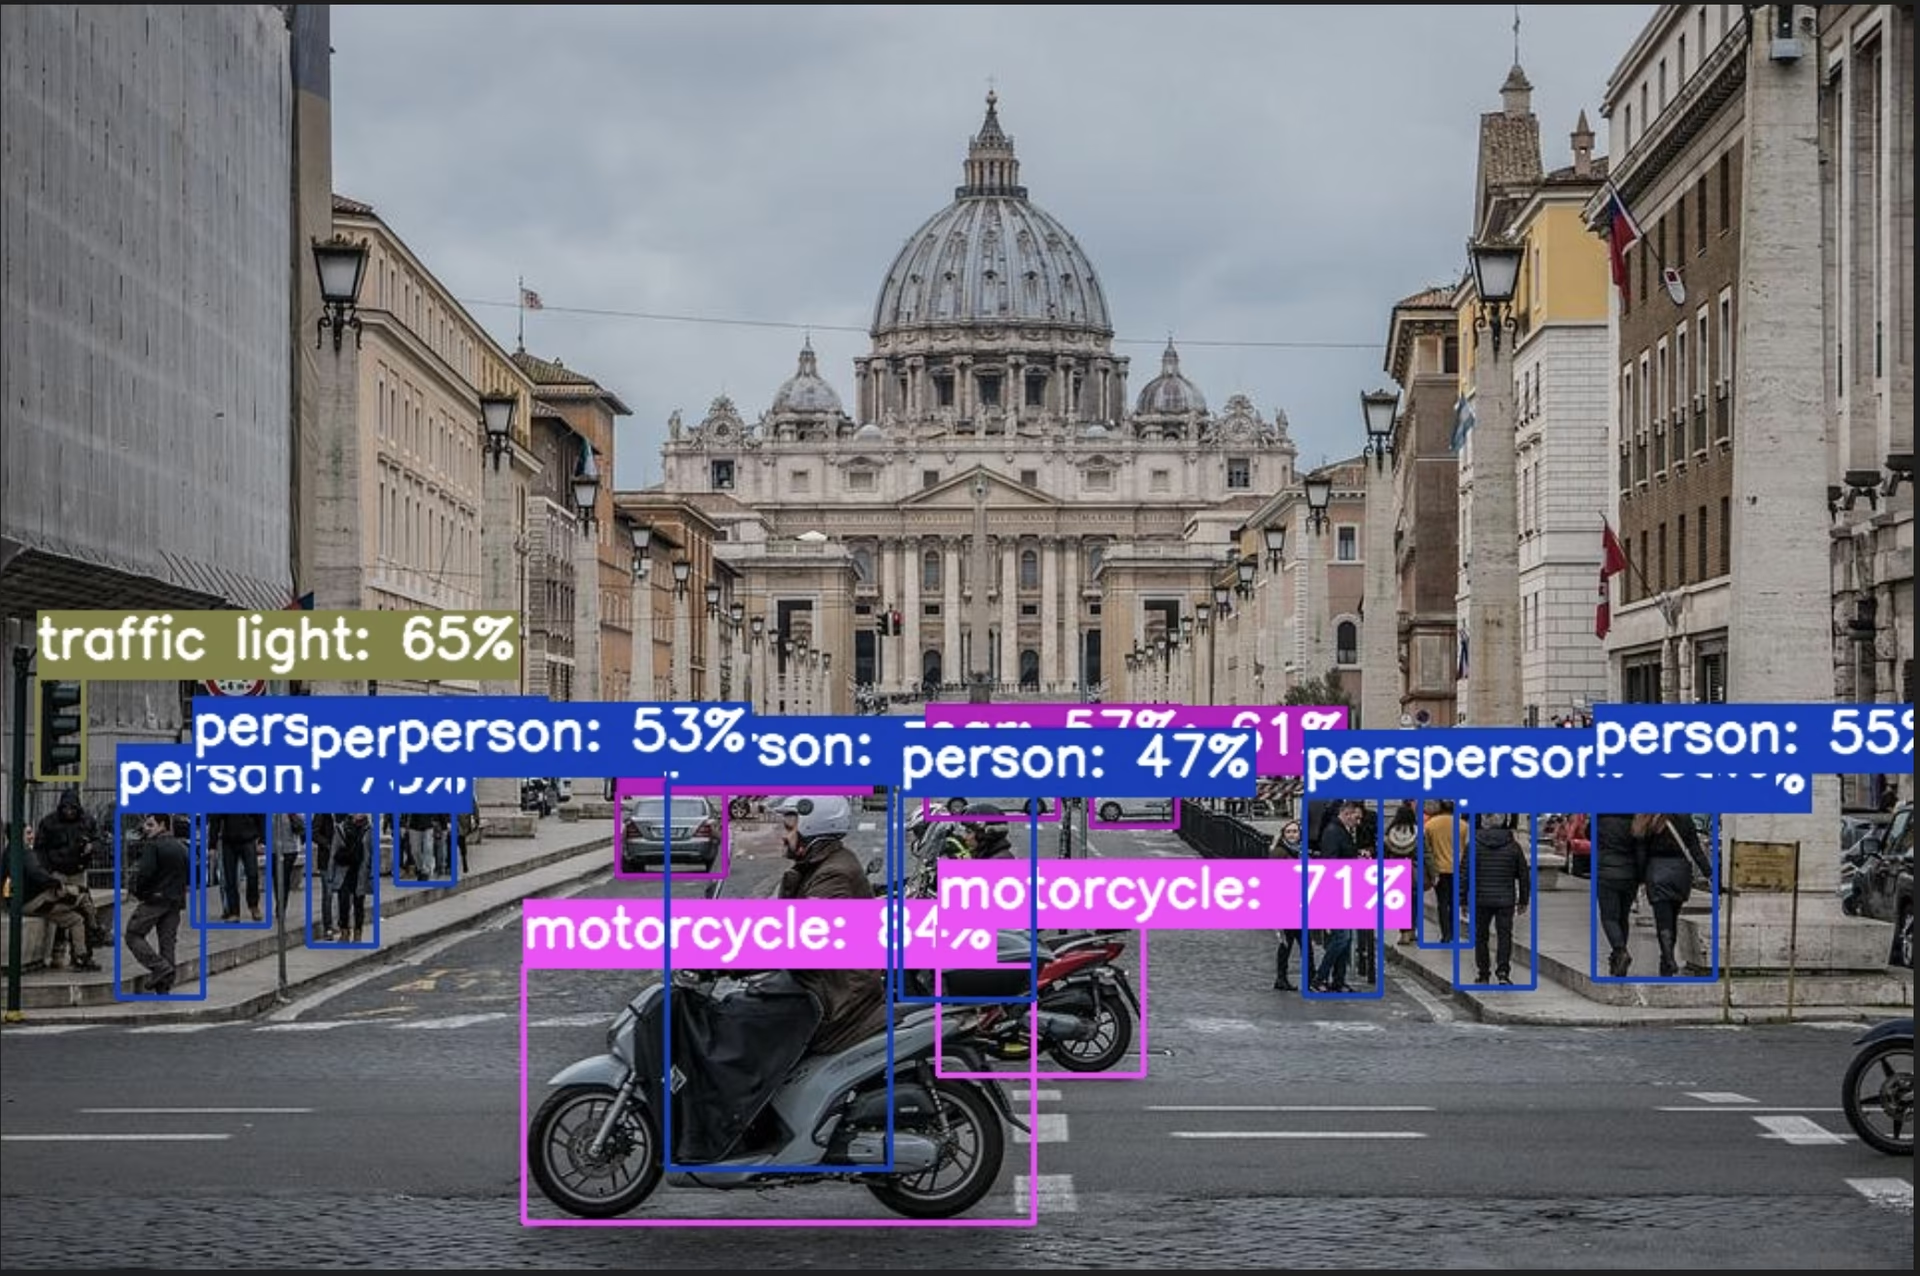
Después de ejecutar el comando eval, recibirás métricas de salida detalladas, como precisión, recall y mAP (precisión media promedio). Esto proporciona una visión completa del rendimiento de tu modelo en el conjunto de datos y resulta especialmente útil para ajustar y optimizar tus modelos YOLO26 para casos de uso específicos, garantizando una alta precisión y eficiencia.
Resumen#
En esta guía se ha explicado la integración de YOLO26 de Ultralytics con el motor DeepSparse de Neural Magic. Se ha mostrado cómo esta integración mejora el rendimiento de YOLO26 en plataformas con CPU, ofreciendo una eficiencia de nivel GPU y técnicas avanzadas de esparsidad de redes neuronales.
Para obtener información más detallada y un uso avanzado, visita el repositorio de DeepSparse de Neural Magic. También puedes explorar la guía de integración de YOLO26 y ver una sesión de demostración en YouTube.
Además, para comprender mejor las distintas integraciones de YOLO26, visita la página de la guía de integraciones de Ultralytics, donde encontrarás muchas otras posibilidades interesantes de integración.
Preguntas frecuentes#
El motor DeepSparse de Neural Magic es un entorno de ejecución de inferencias diseñado para optimizar la ejecución de redes neuronales en CPU mediante técnicas avanzadas como la esparsidad, la poda y la cuantización. Al integrar DeepSparse con YOLO26, puedes lograr un rendimiento similar al de una GPU en CPU estándar, mejorando significativamente la velocidad de inferencia, la eficiencia del modelo y el rendimiento general sin perder precisión. Para obtener más información, consulta la sección sobre DeepSparse de Neural Magic.
Instalar los paquetes necesarios para implementar YOLO26 con DeepSparse de Neural Magic es muy sencillo. Puedes instalarlos fácilmente mediante la CLI. Este es el comando que debes ejecutar:
pip install deepsparse[yolov8]Una vez instalados, sigue los pasos indicados en la sección Instalación para configurar tu entorno y empezar a utilizar DeepSparse con YOLO26.
Para convertir modelos YOLO26 al formato ONNX, necesario para garantizar la compatibilidad con DeepSparse, puedes utilizar el siguiente comando de la CLI:
yolo detect export model=yolo26n.pt format=onnx opset=13Este comando exportará tu modelo YOLO26 (
yolo26n.pt) a un formato (yolo26n.onnx) que puede utilizar el motor DeepSparse. Encontrarás más información sobre la exportación de modelos en la sección Exportación del modelo.Evaluar el rendimiento de YOLO26 en DeepSparse te ayuda a analizar el rendimiento y la latencia para garantizar que tu modelo esté optimizado. Puedes utilizar el siguiente comando de la CLI para ejecutar una evaluación comparativa:
deepsparse.benchmark model_path="path/to/yolo26n.onnx" --scenario=sync --input_shapes="[1,3,640,640]"Este comando te proporcionará métricas de rendimiento esenciales. Para obtener más información, consulta la sección Evaluación comparativa del rendimiento.
Integrar DeepSparse de Neural Magic con YOLO26 ofrece varias ventajas:
- Mayor velocidad de inferencia: alcanza hasta 525 FPS (con YOLO11n), lo que demuestra las capacidades de optimización de DeepSparse.
- Eficiencia optimizada del modelo: utiliza técnicas de esparsidad, poda y cuantización para reducir el tamaño del modelo y las necesidades computacionales sin perder precisión.
- Alto rendimiento en CPU estándar: ofrece un rendimiento similar al de una GPU en hardware de CPU rentable.
- Integración simplificada: proporciona herramientas fáciles de usar para una implementación e integración sencillas.
- Flexibilidad: admite modelos YOLO26 estándar y optimizados mediante esparsidad.
- Rentabilidad: reduce los costes operativos mediante un uso eficiente de los recursos.
Para profundizar en estas ventajas, visita la sección Ventajas de integrar DeepSparse de Neural Magic con YOLO26.