Utilità semplici#
Il pacchetto ultralytics offre una varietà di utilità per supportare, migliorare e accelerare i tuoi flussi di lavoro. Questa guida mette in evidenza alcune delle più utili per gli sviluppatori, tra le tante disponibili, e funge da riferimento pratico per programmare con gli strumenti Ultralytics.
Guarda: Utility Ultralytics | Annotazione automatica, Explorer API e conversione dei dataset
Dati#
Etichettatura automatica / Annotazioni#
L'annotazione dei dataset è un processo dispendioso in termini di risorse e tempo. Se hai un modello Ultralytics YOLO di rilevamento degli oggetti addestrato su una quantità ragionevole di dati, puoi usarlo con SAM per annotare automaticamente altri dati nel formato di segmentazione.
from ultralytics.data.annotator import auto_annotate

auto_annotate(
    data="path/to/new/data",
    det_model="yolo26n.pt",
    sam_model="mobile_sam.pt",
    device="cuda",
    output_dir="path/to/save_labels",
)
Questa funzione non restituisce alcun valore. Per ulteriori dettagli:
- Consulta la sezione di riferimento per
annotator.auto_annotateper approfondire il funzionamento della funzione. - Usala insieme alla funzione
segments2boxesanche per generare riquadri di delimitazione per il rilevamento degli oggetti.
Visualizzare le annotazioni dei dataset#
Questa funzione visualizza le annotazioni YOLO su un'immagine prima dell'addestramento, aiutandoti a identificare e correggere eventuali annotazioni errate che potrebbero causare risultati di rilevamento non corretti. Disegna i riquadri di delimitazione, etichetta gli oggetti con i nomi delle classi e regola il colore del testo in base alla luminanza dello sfondo per migliorare la leggibilità.
from ultralytics.data.utils import visualize_image_annotations

label_map = {  # Definisci la mappa delle etichette con tutte le etichette delle classi annotate.
    0: "person",
    1: "car",
}

# Visualize
visualize_image_annotations(
    "path/to/image.jpg",  # Percorso dell'immagine di input.
    "path/to/annotations.txt",  # Percorso del file di annotazione dell'immagine.
    label_map,
)
Convertire le maschere di segmentazione nel formato YOLO#
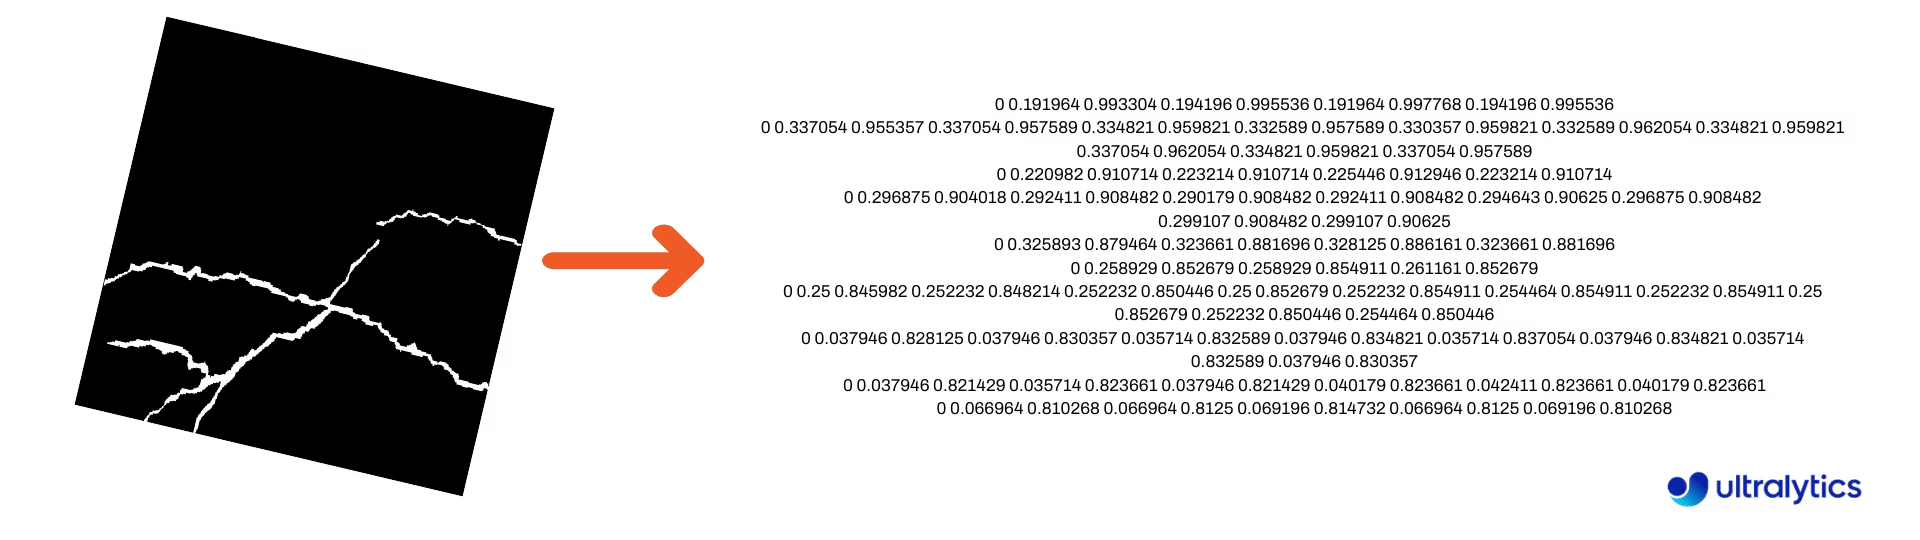
Usa questa funzione per convertire un dataset di immagini con maschere di segmentazione nel formato di segmentazione Ultralytics YOLO. La funzione prende la directory contenente le immagini delle maschere in formato binario e le converte nel formato di segmentazione YOLO.
Le maschere convertite verranno salvate nella directory di output specificata.
from ultralytics.data.converter import convert_segment_masks_to_yolo_seg

# `classes` è il numero totale di classi nel dataset.
# Il dataset COCO contiene 80 classi.
convert_segment_masks_to_yolo_seg(masks_dir="path/to/masks_dir", output_dir="path/to/output_dir", classes=80)
Convertire COCO nel formato YOLO#
Usa questa funzione per convertire le annotazioni JSON di COCO nel formato YOLO. Per i dataset di rilevamento degli oggetti (riquadri di delimitazione), imposta sia use_segments sia use_keypoints su False.
from ultralytics.data.converter import convert_coco

convert_coco(
    "coco/annotations/",
    use_segments=False,
    use_keypoints=False,
    cls91to80=True,
)
Per ulteriori informazioni sulla funzione convert_coco, consulta la pagina di riferimento.
Ottenere le dimensioni dei riquadri di delimitazione#
import cv2

from ultralytics import YOLO
from ultralytics.utils.plotting import Annotator

model = YOLO("yolo26n.pt")  # Load pretrain or fine-tune model

# Process the image
source = cv2.imread("path/to/image.jpg")
results = model(source)

# Extract results
annotator = Annotator(source, example=model.names)

for box in results[0].boxes.xyxy.cpu():
    width, height, area = annotator.get_bbox_dimension(box)
    print(f"Bounding Box Width {width.item()}, Height {height.item()}, Area {area.item()}")
Convertire i riquadri di delimitazione in segmenti#
Con i dati esistenti dei riquadri di delimitazione x y w h, puoi convertirli in segmenti usando la funzione yolo_bbox2segment. Organizza i file delle immagini e delle annotazioni come segue:
data
|__ images
    ├─ 001.jpg
    ├─ 002.jpg
    ├─ ..
    └─ NNN.jpg
|__ labels
    ├─ 001.txt
    ├─ 002.txt
    ├─ ..
    └─ NNN.txt
from ultralytics.data.converter import yolo_bbox2segment
yolo_bbox2segment(
im_dir="path/to/images",
save_dir=None, # salvato in "labels-segment" accanto alla directory delle immagini
sam_model="sam_b.pt",
)Consulta la pagina di riferimento di yolo_bbox2segment per ulteriori informazioni sulla funzione.
Convertire i segmenti in riquadri di delimitazione#
Se hai un dataset che usa il formato dei dataset di segmentazione, con questa funzione puoi convertirli facilmente in riquadri di delimitazione diritti (o orizzontali) (formato x y w h).
import numpy as np

from ultralytics.utils.ops import segments2boxes

segments = np.array(
    [
        [805, 392, 797, 400, 812, 402, 808, 714, 808, 392],
        [115, 398, 113, 400, 150, 410, 150, 400, 149, 298],
        [267, 412, 265, 413, 300, 420, 300, 413, 299, 412],
    ],
    dtype=np.float32,
)

segments2boxes([s.reshape(-1, 2) for s in segments])
# >>> array([[804.5, 553. ,  15. , 322. ],
#           [131.5, 354. ,  37. , 112. ],
#           [282.5, 416. ,  35. ,   8. ]],
# dtype=float32) # riquadri di delimitazione xywh
Per capire come funziona questa funzione, consulta la pagina di riferimento.
Utilità#
Compressione delle immagini#
Comprimi un singolo file immagine riducendone le dimensioni e mantenendo le proporzioni e la qualità. Se l'immagine di input è più piccola della dimensione massima, non verrà ridimensionata.
from pathlib import Path

from ultralytics.data.utils import compress_one_image

for f in Path("path/to/dataset").rglob("*.jpg"):
    compress_one_image(f)
Suddivisione automatica del dataset#
Suddividi automaticamente un dataset in partizioni train/val/test e salva le partizioni risultanti in file autosplit_*.txt. Questa utilità crea file di suddivisione persistenti; l'argomento di addestramento fraction seleziona invece un sottoinsieme riproducibile per una run.
from ultralytics.data.split import autosplit

autosplit(
    path="path/to/images",
    weights=(0.9, 0.1, 0.0),  # (partizioni frazionarie per addestramento, convalida e test)
    annotated_only=False,  # suddividi solo le immagini con un file di annotazione quando è True
)
Consulta la pagina di riferimento per ulteriori dettagli su questa funzione.
Poligono di segmentazione in maschera binaria#
Converti un singolo poligono (come elenco) in una maschera binaria delle dimensioni dell'immagine specificate. Il poligono deve essere un array 1D piatto di coordinate N, contenente valori x, y alternati che definiscono il contorno del poligono.
N deve essere sempre pari.
import numpy as np

from ultralytics.data.utils import polygon2mask

imgsz = (1080, 810)
polygon = np.array([805, 392, 797, 400, ..., 808, 714, 808, 392])  # (N,) coordinate x, y in formato piatto

mask = polygon2mask(
    imgsz,  # tuple
    [polygon],  # input come elenco
    color=255,  # binario a 8 bit
    downsample_ratio=1,
)
Riquadri di delimitazione#
Istanze di riquadri di delimitazione (orizzontali)#
Per gestire i dati dei riquadri di delimitazione, la classe Bboxes permette di convertire i formati delle coordinate dei riquadri, ridimensionare i riquadri, calcolare le aree, aggiungere offset e altro.
import numpy as np

from ultralytics.utils.instance import Bboxes

boxes = Bboxes(
    bboxes=np.array(
        [
            [22.878, 231.27, 804.98, 756.83],
            [48.552, 398.56, 245.35, 902.71],
            [669.47, 392.19, 809.72, 877.04],
            [221.52, 405.8, 344.98, 857.54],
            [0, 550.53, 63.01, 873.44],
            [0.0584, 254.46, 32.561, 324.87],
        ]
    ),
    format="xyxy",
)

boxes.areas()
# >>> array([ 4.1104e+05,       99216,       68000,       55772,       20347,      2288.5])

boxes.convert("xywh")
print(boxes.bboxes)
# >>> array(
#     [[ 413.93, 494.05,  782.1, 525.56],
#      [ 146.95, 650.63,  196.8, 504.15],
#      [  739.6, 634.62, 140.25, 484.85],
#      [ 283.25, 631.67, 123.46, 451.74],
#      [ 31.505, 711.99,  63.01, 322.91],
#      [  16.31, 289.67, 32.503,  70.41]]
# )
Consulta la sezione di riferimento di Bboxes per altri attributi e metodi.
Molte delle funzioni seguenti (e altre ancora) sono accessibili tramite la classe Bboxes; se invece preferisci usare direttamente le funzioni, consulta le sottosezioni successive per scoprire come importarle singolarmente.
Ridimensionamento dei riquadri#
Quando ingrandisci o riduci un'immagine, puoi ridimensionare di conseguenza le coordinate dei riquadri di delimitazione corrispondenti usando ultralytics.utils.ops.scale_boxes.
import cv2 as cv
import numpy as np

from ultralytics.utils.ops import scale_boxes

image = cv.imread("ultralytics/assets/bus.jpg")
h, w, c = image.shape
resized = cv.resize(image, None, fx=1.2, fy=1.2)
new_h, new_w, _ = resized.shape

xyxy_boxes = np.array(
    [
        [22.878, 231.27, 804.98, 756.83],
        [48.552, 398.56, 245.35, 902.71],
        [669.47, 392.19, 809.72, 877.04],
        [221.52, 405.8, 344.98, 857.54],
        [0, 550.53, 63.01, 873.44],
        [0.0584, 254.46, 32.561, 324.87],
    ]
)

new_boxes = scale_boxes(
    img1_shape=(h, w),  # dimensioni dell'immagine originale
    boxes=xyxy_boxes,  # riquadri dell'immagine originale
    img0_shape=(new_h, new_w),  # dimensioni dell'immagine ridimensionata (scala a)
    ratio_pad=None,
    padding=False,
    xywh=False,
)

print(new_boxes)
# >>> array(
#     [[  27.454,  277.52,  965.98,   908.2],
#     [   58.262,  478.27,  294.42,  1083.3],
#     [   803.36,  470.63,  971.66,  1052.4],
#     [   265.82,  486.96,  413.98,    1029],
#     [        0,  660.64,  75.612,  1048.1],
#     [   0.0701,  305.35,  39.073,  389.84]]
# )
Conversioni del formato dei riquadri di delimitazione#
XYXY → XYWH#
Converti le coordinate dei riquadri di delimitazione dal formato (x1, y1, x2, y2) al formato (x, y, larghezza, altezza), dove (x1, y1) è l'angolo in alto a sinistra e (x2, y2) è l'angolo in basso a destra.
import numpy as np

from ultralytics.utils.ops import xyxy2xywh

xyxy_boxes = np.array(
    [
        [22.878, 231.27, 804.98, 756.83],
        [48.552, 398.56, 245.35, 902.71],
        [669.47, 392.19, 809.72, 877.04],
        [221.52, 405.8, 344.98, 857.54],
        [0, 550.53, 63.01, 873.44],
        [0.0584, 254.46, 32.561, 324.87],
    ]
)
xywh = xyxy2xywh(xyxy_boxes)

print(xywh)
# >>> array(
#     [[ 413.93,  494.05,   782.1, 525.56],
#     [  146.95,  650.63,   196.8, 504.15],
#     [   739.6,  634.62,  140.25, 484.85],
#     [  283.25,  631.67,  123.46, 451.74],
#     [  31.505,  711.99,   63.01, 322.91],
#     [   16.31,  289.67,  32.503,  70.41]]
# )
Tutte le conversioni dei riquadri di delimitazione#
from ultralytics.utils.ops import (
    ltwh2xywh,
    ltwh2xyxy,
    xywh2ltwh,  # xywh → angolo in alto a sinistra, w, h
    xywh2xyxy,
    xywhn2xyxy,  # normalizzato → pixel
    xyxy2ltwh,  # xyxy → angolo in alto a sinistra, w, h
    xyxy2xywhn,  # pixel → normalizzato
)

for func in (ltwh2xywh, ltwh2xyxy, xywh2ltwh, xywh2xyxy, xywhn2xyxy, xyxy2ltwh, xyxy2xywhn):
    print(help(func))  # stampa le docstring delle funzioni
Consulta la docstring di ogni funzione oppure visita la ultralytics.utils.ops pagina di riferimento per saperne di più.
Tracciamento#
Utilità per le annotazioni#
Ultralytics include una classe Annotator per annotare vari tipi di dati. È particolarmente adatta ai riquadri di delimitazione per il rilevamento degli oggetti, ai keypoint di posa e ai riquadri di delimitazione orientati.
Annotazione dei riquadri#
import cv2 as cv
import numpy as np

from ultralytics.utils.plotting import Annotator, colors

names = {
    0: "person",
    5: "bus",
    11: "stop sign",
}

image = cv.imread("ultralytics/assets/bus.jpg")
ann = Annotator(
    image,
    line_width=None,  # default auto-size
    font_size=None,  # default auto-size
    font="Arial.ttf",  # must be ImageFont compatible
    pil=False,  # use PIL, otherwise uses OpenCV
)

xyxy_boxes = np.array(
    [
        [5, 22.878, 231.27, 804.98, 756.83],  # class-idx x1 y1 x2 y2
        [0, 48.552, 398.56, 245.35, 902.71],
        [0, 669.47, 392.19, 809.72, 877.04],
        [0, 221.52, 405.8, 344.98, 857.54],
        [0, 0, 550.53, 63.01, 873.44],
        [11, 0.0584, 254.46, 32.561, 324.87],
    ]
)

for nb, box in enumerate(xyxy_boxes):
    c_idx, *box = box
    label = f"{str(nb).zfill(2)}:{names.get(int(c_idx))}"
    ann.box_label(box, label, color=colors(c_idx, bgr=True))

image_with_bboxes = ann.result()
Puoi usare i nomi da model.names quando lavori con i risultati del rilevamento. Consulta anche la pagina di riferimento di Annotator per ulteriori informazioni.
Annotazione sweep di Ultralytics#
import sys

import cv2
import numpy as np

from ultralytics import YOLO
from ultralytics.solutions.solutions import SolutionAnnotator
from ultralytics.utils.plotting import colors

# User defined video path and model file
cap = cv2.VideoCapture("path/to/video.mp4")
model = YOLO(model="yolo26s-seg.pt")  # Model file, e.g., yolo26s.pt or yolo26m-seg.pt

if not cap.isOpened():
    print("Error: Could not open video.")
    sys.exit()

# Initialize the video writer object.
w, h, fps = (int(cap.get(x)) for x in (cv2.CAP_PROP_FRAME_WIDTH, cv2.CAP_PROP_FRAME_HEIGHT, cv2.CAP_PROP_FPS))
video_writer = cv2.VideoWriter("ultralytics.avi", cv2.VideoWriter_fourcc(*"mp4v"), fps, (w, h))

masks = None  # Initialize variable to store masks data
f = 0  # Initialize frame count variable for enabling mouse event.
line_x = w  # Store width of line.
dragging = False  # Initialize bool variable for line dragging.
classes = model.names  # Store model classes names for plotting.
window_name = "Ultralytics Sweep Annotator"

def drag_line(event, x, _, flags, param):
    """Mouse callback function to enable dragging a vertical sweep line across the video frame."""
    global line_x, dragging
    if event == cv2.EVENT_LBUTTONDOWN or (flags & cv2.EVENT_FLAG_LBUTTON):
        line_x = max(0, min(x, w))
        dragging = True

while cap.isOpened():  # Loop over the video capture object.
    ret, im0 = cap.read()
    if not ret:
        break
    f = f + 1  # Increment frame count.
    count = 0  # Re-initialize count variable on every frame for precise counts.
    results = model.track(im0, persist=True)[0]

    if f == 1:
        cv2.namedWindow(window_name)
        cv2.setMouseCallback(window_name, drag_line)

    annotator = SolutionAnnotator(im0)

    if results.boxes.is_track:
        if results.masks is not None:
            masks = [np.array(m, dtype=np.int32) for m in results.masks.xy]

        boxes = results.boxes.xyxy.tolist()
        track_ids = results.boxes.id.int().cpu().tolist()
        clss = results.boxes.cls.cpu().tolist()

        for mask, box, cls, t_id in zip(masks or [None] * len(boxes), boxes, clss, track_ids):
            color = colors(t_id, True)  # Assign different color to each tracked object.
            label = f"{classes[cls]}:{t_id}"
            if mask is not None and mask.size > 0:
                if box[0] > line_x:
                    count += 1
                    cv2.polylines(im0, [mask], True, color, 2)
                    x, y = mask.min(axis=0)
                    (w_m, _), _ = cv2.getTextSize(label, cv2.FONT_HERSHEY_SIMPLEX, 0.5, 1)
                    cv2.rectangle(im0, (x, y - 20), (x + w_m, y), color, -1)
                    cv2.putText(im0, label, (x, y - 5), cv2.FONT_HERSHEY_SIMPLEX, 0.5, (255, 255, 255), 1)
            else:
                if box[0] > line_x:
                    count += 1
                    annotator.box_label(box=box, color=color, label=label)

    # Generate draggable sweep line
    annotator.sweep_annotator(line_x=line_x, line_y=h, label=f"COUNT:{count}")

    cv2.imshow(window_name, im0)
    video_writer.write(im0)
    if cv2.waitKey(1) & 0xFF == ord("q"):
        break

# Release the resources
cap.release()
video_writer.release()
cv2.destroyAllWindows()
Trovi ulteriori dettagli sul metodo sweep_annotator nella nostra sezione di riferimento qui.
Annotazione con etichetta adattiva#
SolutionAnnotator.adaptive_label disegna un'etichetta la cui forma viene selezionata con l'argomento shape (che sostituisce i vecchi metodi circle_label e text_label):
- Rettangolo:
annotator.adaptive_label(box, label=names[int(cls)], color=colors(cls, True), shape="rect") - Cerchio:
annotator.adaptive_label(box, label=names[int(cls)], color=colors(cls, True), shape="circle")
Guarda: Guida approfondita alle annotazioni di testo e cerchio con demo dal vivo in Python | Annotazioni Ultralytics 🚀
import cv2

from ultralytics import YOLO
from ultralytics.solutions.solutions import SolutionAnnotator
from ultralytics.utils.plotting import colors

model = YOLO("yolo26s.pt")
names = model.names
cap = cv2.VideoCapture("path/to/video.mp4")

w, h, fps = (int(cap.get(x)) for x in (cv2.CAP_PROP_FRAME_WIDTH, cv2.CAP_PROP_FRAME_HEIGHT, cv2.CAP_PROP_FPS))
writer = cv2.VideoWriter("Ultralytics circle annotation.avi", cv2.VideoWriter_fourcc(*"MJPG"), fps, (w, h))

while True:
    ret, im0 = cap.read()
    if not ret:
        break

    annotator = SolutionAnnotator(im0)
    results = model.predict(im0)[0]
    boxes = results.boxes.xyxy.cpu()
    clss = results.boxes.cls.cpu().tolist()

    for box, cls in zip(boxes, clss):
        annotator.adaptive_label(box, label=names[int(cls)], color=colors(cls, True), shape="circle")
    writer.write(im0)
    cv2.imshow("Ultralytics circle annotation", im0)

    if cv2.waitKey(1) & 0xFF == ord("q"):
        break

writer.release()
cap.release()
cv2.destroyAllWindows()
Consulta la pagina di riferimento di SolutionAnnotator per ulteriori informazioni.
Varie#
Profilazione del codice#
Controlla quanto tempo impiega il codice per essere eseguito/elaborato usando with oppure un decoratore.
from ultralytics.utils.ops import Profile

with Profile(device="cuda:0") as dt:
    pass  # operazione da misurare

print(dt)
# >>> "Elapsed time is 9.5367431640625e-07 s"
Formati supportati da Ultralytics#
Devi usare a livello di programmazione i formati di immagine o video supportati da Ultralytics? Se necessario, usa queste costanti:
from ultralytics.data.utils import IMG_FORMATS, VID_FORMATS

print(IMG_FORMATS)
# {'avif', 'bmp', 'dng', 'heic', 'heif', 'jp2', 'jpeg', 'jpg', 'mpo', 'png', 'tif', 'tiff', 'webp'}

print(VID_FORMATS)
# {'asf', 'avi', 'gif', 'm4v', 'mkv', 'mov', 'mp4', 'mpeg', 'mpg', 'ts', 'wmv', 'webm'}
Rendi divisibile#
Calcola il più piccolo numero intero maggiore o uguale a x che sia divisibile per y.
from ultralytics.utils.ops import make_divisible

make_divisible(7, 3)
# >>> 9
make_divisible(7, 2)
# >>> 8
Domande frequenti#
Il pacchetto Ultralytics include utilità progettate per semplificare e ottimizzare i flussi di lavoro di machine learning. Tra le principali utilità trovi l'annotazione automatica per etichettare i dataset, la conversione di COCO nel formato YOLO con convert_coco, la compressione delle immagini e la suddivisione automatica dei dataset. Questi strumenti riducono il lavoro manuale, garantiscono coerenza e migliorano l'efficienza dell'elaborazione dei dati.
Se hai un modello Ultralytics YOLO di rilevamento degli oggetti preaddestrato, puoi usarlo con il modello SAM per annotare automaticamente il tuo dataset in formato di segmentazione. Ecco un esempio:
from ultralytics.data.annotator import auto_annotate

auto_annotate(
    data="path/to/new/data",
    det_model="yolo26n.pt",
    sam_model="mobile_sam.pt",
    device="cuda",
    output_dir="path/to/save_labels",
)
Per ulteriori dettagli, consulta la sezione di riferimento di auto_annotate oppure usa Ultralytics Platform come alternativa ospitata senza codice, con mascheramento tramite clic attraverso SAM 2.1, SAM 3 o SAM 3.1, oppure con previsioni di modelli YOLO preaddestrati e ottimizzati per le attività di rilevamento, segmentazione e OBB.
Per convertire le annotazioni JSON di COCO nel formato YOLO per il rilevamento degli oggetti, puoi usare l'utilità
convert_coco. Ecco un esempio di codice:from ultralytics.data.converter import convert_coco convert_coco( "coco/annotations/", use_segments=False, use_keypoints=False, cls91to80=True, )Per ulteriori informazioni, visita la pagina di riferimento di convert_coco.
Ultralytics Platform offre analisi automatiche dei dataset: la scheda
Chartsmostra la distribuzione delle suddivisioni, il conteggio delle classi più frequenti, gli istogrammi delle dimensioni delle immagini e mappe di calore 2D delle posizioni delle annotazioni, aiutandoti a individuare squilibri e valori anomali prima dell'addestramento.Per convertire i dati esistenti dei riquadri di delimitazione (nel formato
x y w h) in segmenti, puoi usare la funzioneyolo_bbox2segment. Assicurati di organizzare i file in directory separate per immagini ed etichette.from ultralytics.data.converter import yolo_bbox2segment yolo_bbox2segment( im_dir="path/to/images", save_dir=None, # salvato in "labels-segment" accanto alla directory delle immagini sam_model="sam_b.pt", )Per ulteriori informazioni, visita la pagina di riferimento di yolo_bbox2segment.