CIFAR-10データセット#
CIFAR-10(Canadian Institute For Advanced Research)データセットは、60,000枚の32x32カラー画像を10クラスに均等分割した、古典的な画像分類ベンチマークです。航空機、自動車、鳥、猫、鹿、犬、カエル、馬、船、トラックの10クラスで構成されています。あらかじめ50,000枚のトレーニング画像と10,000枚のテスト画像(各クラス6,000枚)に分割されているため、分類モデルのトレーニングやベンチマークを始めるための、軽量でバランスの良いデータセットです。さらに細かい分類に挑戦する場合は、関連するCIFAR-100データセットをご覧ください。
Ultralytics Platform上のCIFAR-10でサンプルをプレビューし、データセットの統計情報を確認して、トレーニング用にクローンできます。
主な特徴#
- CIFAR-10には32x32ピクセルのカラー画像が60,000枚含まれており、10クラスに均等に分けられています。
- 各クラスには正確に6,000枚の画像が含まれています。そのうち5,000枚がトレーニング用、1,000枚がテスト用であるため、データセットは完全にバランスが取れています。
- 10クラスは、航空機、自動車、鳥、猫、鹿、犬、カエル、馬、船、トラックです。
- データセットにはあらかじめtrain/test分割が含まれているため、手動または自動で分割する必要はありません。
- CIFAR-10は、画像分類および物体認識の研究で標準的に使用されるベンチマークです。
データセットの構成#
CIFAR-10には公式の事前定義済み分割が含まれているため、自動または手動でパーティション分割する必要はありません。
- クラス: 10(航空機、自動車、鳥、猫、鹿、犬、カエル、馬、船、トラック)
- 画像の合計: 60,000(32x32カラー)
- トレーニングセット: 50,000枚(クラスあたり5,000枚)
- テストセット: 10,000枚(クラスあたり1,000枚)
CIFAR-10には独立した検証用フォルダーがないため、Ultralyticsではデフォルトでトレーニング中に10,000枚のテストセットを検証用分割として使用します。
アプリケーション#
CIFAR-10は、従来の畳み込みニューラルネットワーク(CNNs)やサポートベクターマシン(SVMs)から最新のディープアーキテクチャまで、画像分類モデルのトレーニングと評価に広く使用されています。画像サイズが小さくクラスのバランスが取れているため、新しいアルゴリズムの迅速な実験やベンチマーク、コンピュータービジョンの基礎教育に適しています。
使用方法#
画像サイズ32で、CIFAR-10上でYOLOモデルを100エポックトレーニングします。利用可能な引数の一覧については、トレーニングページと画像分類タスクガイドをご覧ください。
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-cls.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="cifar10", epochs=100, imgsz=32)サンプル画像とアノテーション#
CIFAR-10データセットにはさまざまな物体のカラー画像が含まれており、画像分類タスクに適した、構造化されたデータセットです。以下にデータセットの画像例を示します。
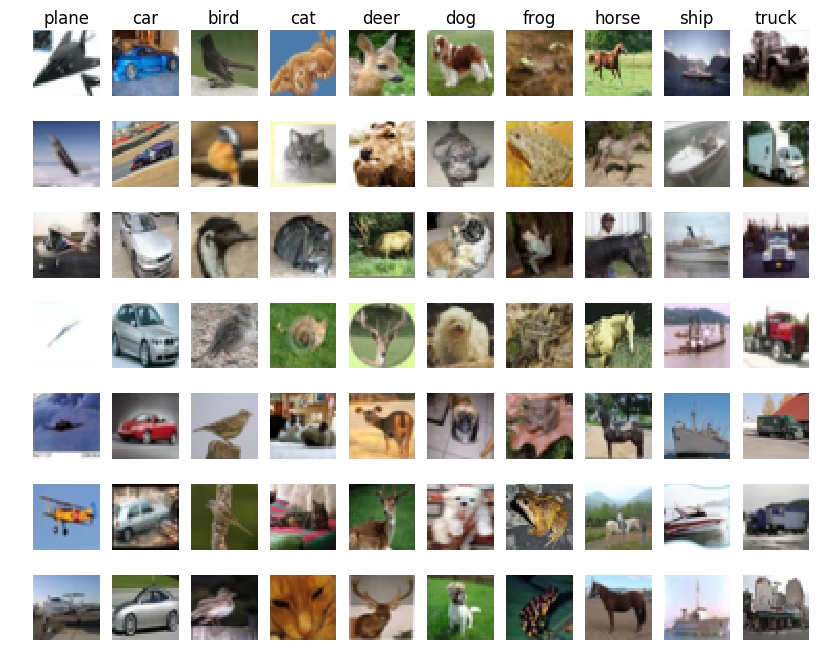
サンプルからは、CIFAR-10データセットに含まれる物体の多様性が分かります。多様なデータセットが、堅牢な画像分類モデルのトレーニングに有用であることを示しています。
引用と謝辞#
研究または開発作業でCIFAR-10データセットを使用する場合は、次の論文を引用してください。
@TECHREPORT{Krizhevsky09learningmultiple,
            author={Alex Krizhevsky},
            title={Learning multiple layers of features from tiny images},
            institution={},
            year={2009}
}CIFAR-10データセットを作成・保守し、機械学習およびコンピュータービジョン研究コミュニティーに貴重なリソースを提供したAlex Krizhevskyに謝意を表します。CIFAR-10データセットとその作成者の詳細については、CIFAR-10データセットのウェブサイトをご覧ください。
FAQ#
CIFAR-10データセットは、画像分類および物体認識モデルのトレーニングとベンチマークに広く使用されています。10クラスに均等に分散された32x32カラー画像が60,000枚含まれており、サイズが小さくクラスのバランスが取れているため、畳み込みニューラルネットワーク(CNNs)やサポートベクターマシン(SVMs)などのアルゴリズムに対する高速で信頼性の高いベンチマークとなります。
CIFAR-10でUltralytics YOLOモデルをトレーニングするには、以下のコードスニペットを使用します。データセットは初回使用時に自動的にダウンロードされます。引数の一覧については、モデルのトレーニングページをご覧ください。
トレーニング例from ultralytics import YOLO # Load a model model = YOLO("yolo26n-cls.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="cifar10", epochs=100, imgsz=32)CIFAR-10には10クラス(航空機、自動車、鳥、猫、鹿、犬、カエル、馬、船、トラック)があり、各クラスに正確に6,000枚、合計60,000枚の画像が含まれています。各クラスは相互に排他的で完全にバランスが取れており、カテゴリ間に重複はありません。
CIFAR-10には、50,000枚のトレーニング画像と10,000枚のテスト画像に分けられた事前定義済みの分割が含まれており、各クラスにはトレーニング画像が正確に5,000枚、テスト画像が1,000枚あります。Ultralyticsが自動的に分割するフォルダーベースの分類データセットとは異なり、CIFAR-10の公式パーティションはそのまま使用され、デフォルトではトレーニング中にテストセットが検証用分割として使用されます。
はい。Ultralytics Platformを使用すると、データセットの管理、画像分類モデルのトレーニング、広範なコーディングなしでのデプロイが可能です。クラウドでCIFAR-10の実験を実行する便利な方法であり、その他のオプションについては分類データセットの概要をご覧ください。