ImageWoofデータセット#
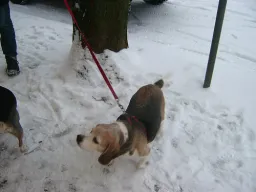
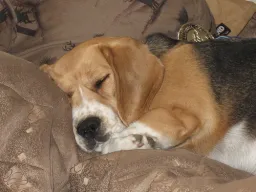
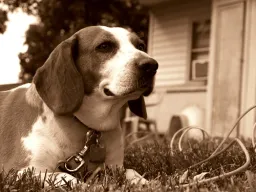
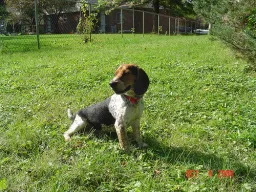
ImageWoofデータセットは、意図的に見分けにくくした10種類の犬種クラスからなるImageNetのサブセットです。fast.aiが、画像分類アルゴリズム向けのより難しい課題として作成しました。ビーグル、シーズー、ゴールデンレトリバーなどの犬種にわたるカラー画像が12,954枚含まれており、トレーニング用が9,025枚、検証用が3,929枚です。モデルには、明らかな物体カテゴリではなく、細かな差異を識別する能力が求められます。
主な機能#
- ImageWoofには、オーストラリアン・テリア、ボーダー・テリア、サモエド、ビーグル、シーズー、イングリッシュ・フォックスハウンド、ローデシアン・リッジバック、ディンゴ、ゴールデンレトリバー、オールド・イングリッシュ・シープドッグの10犬種にわたって12,954枚の画像が含まれています。
- あらかじめトレーニング用9,025枚、検証用3,929枚に分割された画像が用意されており、計算リソースに合わせてさまざまな解像度(フルサイズ、320px、160px)を選択できます。
- ラベルにノイズを含むバージョンも用意されており、ラベルが常に信頼できるとは限らない、より現実的な状況を再現できます。
データセットの構成#
ImageWoofには、あらかじめトレーニング用と検証用に分割されたデータが含まれており、各犬種は個別のフォルダーに格納されています。
| 分割 | 画像 | クラス |
|---|---|---|
| 学習 | 9,025 | 10 |
| 検証 | 3,929 | 10 |
10クラスすべてが犬種で構成されているため、このデータセットの分割は、ImageNet全体の広範な物体認識ではなく、見た目が似たカテゴリを見分ける細粒度分類をテストできるよう設計されています。
用途#
ImageWoofデータセットは、より複雑で互いに似たクラスを対象としたディープラーニングモデルのトレーニングと評価に広く使われています。犬種間の微妙な違いが課題となり、モデルの性能と汎化能力の限界に挑戦できます。特に次の用途で役立ちます。
- 細粒度カテゴリにおける分類性能のベンチマーク
- 見た目が似たクラスに対するモデルの堅牢性テスト
- 微妙な視覚的差異を識別できるアルゴリズムの開発
- 汎用ドメインから特定ドメインへの転移学習の評価
使用方法#
ImageWoofデータセットで画像サイズ224x224を使用し、エポック数100で分類モデルをトレーニングするには、以下のコードスニペットを使用してください。利用可能な引数の一覧については、モデルのトレーニングページを参照してください。
from ultralytics import YOLO

# モデルを読み込む
model = YOLO("yolo26n-cls.pt")  # 事前トレーニング済みモデルを読み込みます(トレーニングにはこちらを推奨します)

# モデルをトレーニングする
results = model.train(data="imagewoof", epochs=100, imgsz=224)データセットのバリエーション#
ImageWoofには、研究上のニーズや計算リソースに応じて選べる3つのサイズがあります。
- フルサイズ(
imagewoof): 元のサイズの画像を含むバージョンで、最終トレーニングや性能ベンチマークに最適です。 - 中サイズ(
imagewoof320): 画像の最大辺を320ピクセルにリサイズしており、モデルの性能を大きく損なわずにトレーニングを高速化できます。 - 小サイズ(
imagewoof160): 画像の最大辺を160ピクセルにリサイズしており、トレーニング速度を優先する迅速なプロトタイピングや実験向けに設計されています。
これらのバリエーションを使用するには、データセット引数のimagewoofをimagewoof320またはimagewoof160に置き換えてください。例を以下に示します。
from ultralytics import YOLO

# モデルを読み込む
model = YOLO("yolo26n-cls.pt")  # 事前トレーニング済みモデルを読み込みます(トレーニングにはこちらを推奨します)

# 中サイズのデータセットの場合
model.train(data="imagewoof320", epochs=100, imgsz=224)

# 小サイズのデータセットの場合
model.train(data="imagewoof160", epochs=100, imgsz=224)画像が小さいと分類の精度が低くなる可能性がありますが、モデル開発の初期段階で迅速に反復するには非常に有効です。Ultralytics Platformを使って、分類データセットを管理し、クラウドでトレーニングを実行することもできます。
サンプル画像とアノテーション#
ImageWoofデータセットには、さまざまな犬種の色鮮やかな画像が含まれており、画像分類タスクにとって難易度の高いデータセットです。データセットに含まれる画像の例を以下に示します。
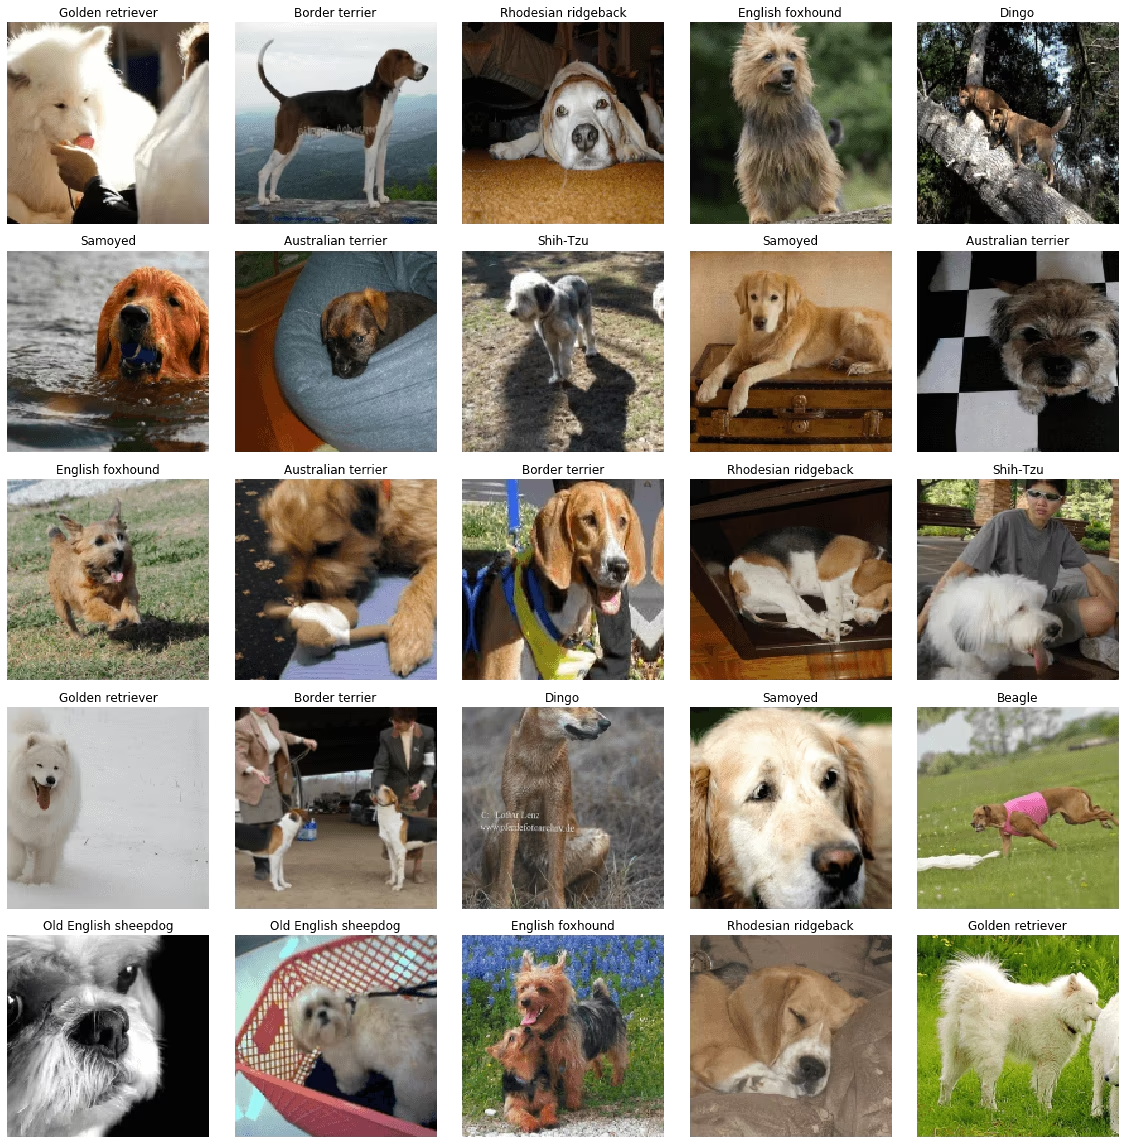
この例では、犬種間の微妙な違いや共通点を示し、分類タスクの複雑さと難しさを紹介しています。
引用と謝辞#
研究または開発でImageWoofデータセットを使用する場合は、公式データセットリポジトリへのリンクを掲載し、作成者に謝意を示してください。
fast.aiチームがImageWoofを作成・維持し、機械学習およびコンピュータービジョン研究コミュニティに貴重なリソースを提供していることに謝意を表します。ImageWoofの詳細については、ImageWoofデータセットのリポジトリをご覧ください。
よくある質問#
ImageWoofには、合計12,954枚の画像(トレーニング用9,025枚、検証用3,929枚)があり、オーストラリアン・テリア、ボーダー・テリア、サモエド、ビーグル、シー・ズー、イングリッシュ・フォックスハウンド、ローデシアン・リッジバック、ディンゴ、ゴールデン・レトリーバー、オールド・イングリッシュ・シープドッグの10種類の犬種が含まれています。各犬種は個別のフォルダーに保存されており、Ultralyticsが想定する標準的な分類用ディレクトリ構成に従っています。
Ultralytics YOLOを使用してImageWoofデータセットで分類モデルをトレーニングするには、画像サイズを224x224、エポック数を100に設定して、次のコードを使用します。
トレーニング例from ultralytics import YOLO model = YOLO("yolo26n-cls.pt") # 事前トレーニング済みモデルを読み込む results = model.train(data="imagewoof", epochs=100, imgsz=224)利用可能なトレーニング引数の詳細については、トレーニングページを参照してください。
ImageWoofデータセットには、次の3つのサイズがあります。
- フルサイズ(
imagewoof): 最終トレーニングやベンチマークに最適で、フルサイズの画像が含まれています。 - 中サイズ(
imagewoof320): 最大辺の長さが320ピクセルにリサイズされた画像で、より高速なトレーニングに適しています。 - 小サイズ(
imagewoof160): 最大辺の長さが160ピクセルにリサイズされた画像で、迅速なプロトタイピングに最適です。
これらのバージョンを使用するには、データセット引数の
imagewoofを適切な値に置き換えてください。画像が小さいと分類精度が低下する可能性がありますが、反復を迅速に行ううえで役立ちます。- フルサイズ(
ImageWoofデータセットのノイズのあるラベルは、ラベルが常に正確とは限らない実環境をシミュレートします。このデータを使ってモデルをトレーニングすると、画像分類タスクにおけるロバスト性と汎化性能の向上に役立ちます。実用的なアプリケーションでよく遭遇する、曖昧なデータや誤ったラベルが付いたデータを効果的に扱えるよう、モデルをトレーニングできます。
ImageWoofの主な課題は、含まれる犬種間の違いがわずかであることです。互いによく似た10種類の犬種を対象としているため、それらを見分けるには、より高度で細かく調整された画像分類モデルが必要です。そのため、ImageWoofはディープラーニングモデルの性能や改善を評価する優れたベンチマークとなります。