コンピュータービジョンプロジェクトの目標を設定する方法
コンピュータービジョンプロジェクトの目標を設定するには、中心的な課題、範囲、関係者、制約を明記した問題定義を作成し、測定可能で期限のある目標を設定します。そのうえで、問題をコンピュータービジョンのタスクに対応付け、モデル、データセット、デプロイに関する判断につなげます。このガイドでは、具体例を交えながら各ステップを説明します。
視聴: コンピュータービジョンプロジェクトの目標を定義する方法 | 問題設定と VisionAI タスクの関連付け 🚀
データ収集からデプロイまでのワークフロー全体の概要については、コンピュータービジョンプロジェクトの主要なステップに関するガイドをご覧ください。
コンピュータービジョンの問題定義を作成する方法#
明確な問題定義は、最も効果的な解決策を見つけるための最初の重要なステップです。問題定義は4つの要素で構成されます。
- 中心的な課題を特定する: コンピュータービジョンプロジェクトが解決を目指す具体的な課題を明確にします。
- 範囲を定める: 問題の境界を定義します。
- エンドユーザーと関係者を検討する: 解決策の影響を受ける人々を特定します。
- プロジェクト要件と制約を分析する: 利用できるリソース(時間、予算、人員)を評価し、技術面または規制面の制約を特定します。
ビジネス上の問題定義の例#
高速道路上の車両の速度を推定するコンピュータービジョンプロジェクトを考えてみましょう。現在の速度監視方法は、旧式のレーダーシステムや手作業により非効率で、エラーも発生しやすいという課題があります。このプロジェクトでは、従来の速度推定システムに代わるリアルタイムのコンピュータービジョンシステムの開発を目指します。
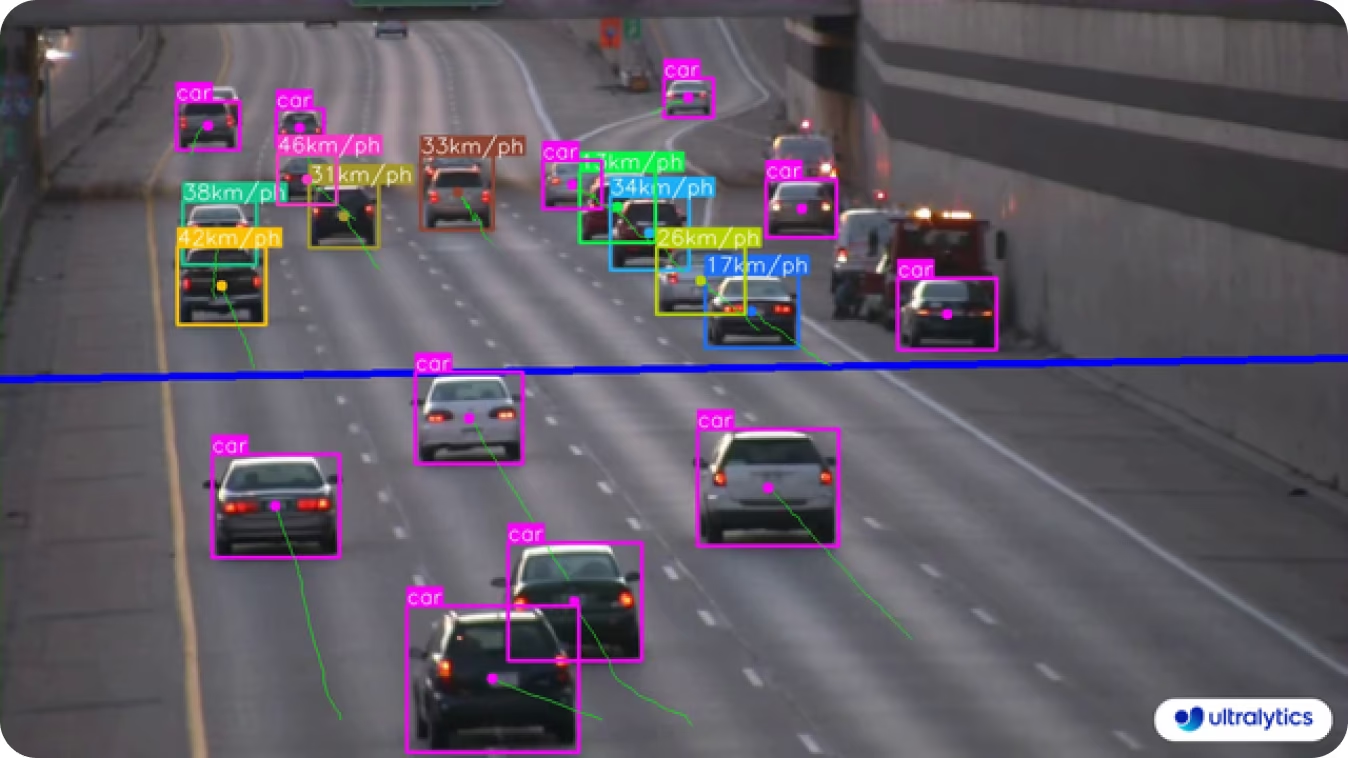
主なユーザーは交通管理当局と法執行機関で、二次的な関係者には高速道路の計画担当者や、道路の安全性向上の恩恵を受ける一般市民が含まれます。主な要件として、予算、期間、人員の評価に加え、高解像度カメラやリアルタイムデータ処理などの技術的ニーズへの対応が挙げられます。また、プライバシーとデータセキュリティに関する規制上の制約も考慮する必要があります。
測定可能な目標の設定#
測定可能な目標を設定することは、コンピュータービジョンプロジェクトの成功に欠かせません。効果的な目標は SMART 基準に従います。
| 基準 | 意味 |
|---|---|
| 具体的 | 明確で詳細な目標を定義します。 |
| 測定可能 | 目標を定量化できるようにします。 |
| 達成可能 | 能力の範囲内で現実的な目標を設定します。 |
| 関連性がある | 目標をプロジェクト全体のゴールに沿わせます。 |
| 期限が明確 | 各目標に期限を設定します。 |
高速道路での速度推定の例では、SMART目標として次のようなものが考えられます。
- 10,000枚の車両画像のデータセットを使用し、6か月以内に速度検出で少なくとも95%の精度を達成します。
- システムは、遅延を最小限に抑えながら、リアルタイムの動画ストリームを毎秒30フレームで処理できる必要があります。
具体的で定量化できる目標を設定すれば、進捗を効果的に追跡し、改善すべき領域を特定して、プロジェクトが計画どおりに進むようにできます。
適切なコンピュータービジョンタスクの選び方#
問題文を作成すると、課題を解決できるコンピュータービジョンタスクを構想しやすくなります。特によく使われるタスクには、画像分類、物体検出、画像セグメンテーションがあります。詳しい比較については、Ultralyticsのタスクページをご覧ください。
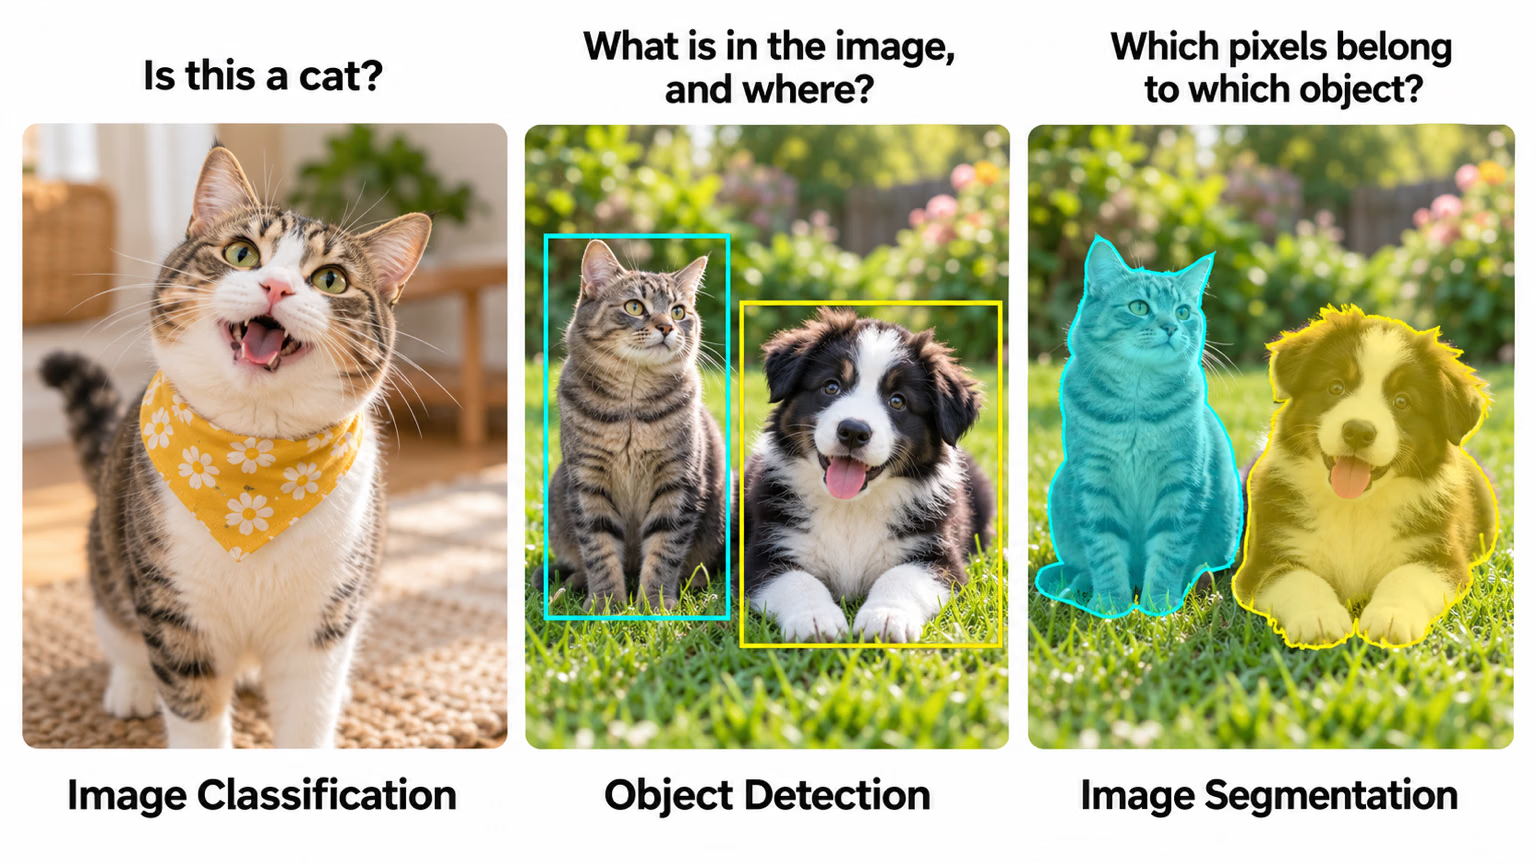
たとえば、高速道路で車両の速度を監視することが課題であれば、物体検出をトラッキングモードで実行するタスクになります。トラッキングでは、検出された各車両に動画フレームをまたいで持続するIDが割り当てられます。これは速度の計算に必要です。
この場合、検出だけでは不十分です。検出は各フレームで車両の位置を特定しますが、フレーム間で各車両のIDを維持しません。IDがなければ、システムは時間の経過に伴う移動を測定できません。トラッキングモードでは、このIDが追加されます。適切なコンピュータービジョンタスクを特定すると、そのタスクがモデルの選択、データセットの準備、モデルのトレーニング方法など、プロジェクトの重要な要素を導く指針となります。
モデル、データ、トレーニング方法のうち、最初に取り組むべきものは何ですか?#
モデルの選択、データセットの準備、トレーニング方法の順序は、プロジェクトの具体的な状況によって異なります。
| 状況 | 最初に取り組む項目 | 例 |
|---|---|---|
| 問題と目標が明確に定義されている | モデルの選択 | 車両の速度を推定する交通監視システムの場合は、トラッキングモードで実行する検出モデルを選び、高速道路の動画を収集してアノテーションを付けた後、リアルタイム動画処理の手法を用いてトレーニングします。 |
| データが独自のもの、または限られている | データセットの準備 | データセットが小規模な顔認識システムでは、まずデータにアノテーションを付けます。次に、転移学習用の事前学習済みモデルなど、限られたデータでも適切に動作するモデルを選び、データセットを拡張するためのデータ拡張を計画します。 |
| 実験が重要(研究) | トレーニング方法 | 製造上の欠陥を検出する新しい手法を探るプロジェクトでは、まず小規模なデータサブセットで実験します。有望な手法が見つかったら、その結果に適したモデルを選び、包括的なデータセットを準備します。 |
データから始める場合、プロジェクトの進展に合わせてデータセットの整理、アノテーション、トレーニングを行う作業をUltralytics Platformで効率化できます。
デプロイオプションがプロジェクトに与える影響#
モデルのデプロイオプションはコンピュータービジョンプロジェクトの性能に大きく影響するため、最初の段階から考慮してください。デプロイ環境は、モデルの計算負荷に対応できる必要があります。
| デプロイオプション | 最適な用途 | テクノロジーの例 |
|---|---|---|
| エッジデバイス | 計算リソースが限られたスマートフォンやIoTデバイス、軽量モデル | LiteRT、ONNX Runtime |
| クラウドサーバー | 高い計算能力が必要な複雑なモデル、プロジェクトに応じて拡張できるハードウェア | AWS、Google Cloud、Azure |
| オンプレミスサーバー | 高いデータプライバシーとセキュリティが必要な場合、データとインフラストラクチャを完全に管理したい場合 | 自社管理のGPUサーバー |
| ハイブリッドソリューション | パフォーマンスとコスト、レイテンシのバランスを取りたい場合。エッジ処理とクラウド分析を組み合わせます | エッジランタイムとクラウドプラットフォームの組み合わせ |
各オプションにはそれぞれ異なるメリットと課題があり、選択はパフォーマンス、コスト、セキュリティなど、プロジェクト固有の要件によって決まります。
結論#
コンピュータービジョンプロジェクトを成功させるには、明確な問題文、SMARTに基づく測定可能な目標、そして目的に合ったコンピュータービジョンタスクが必要です。これらの決定は、モデルの選択からデプロイまで、その後のあらゆる工程を導きます。次のステップとして、データの収集とアノテーションの方法を学ぶか、GitHubやUltralytics Discordサーバーで他の開発者とプロジェクトについて話し合いましょう。
よくある質問#
明確な問題文には、プロジェクトが解決する中核的な課題、その範囲、エンドユーザーとステークホルダー、リソース上および規制上の制約を記載します。この4つの要素を順に整理し、技術的な決定を行う前にステークホルダーと内容を確認してください。詳しい説明と具体例については、コンピュータービジョンの問題文の書き方をご覧ください。
課題で必要な出力と、それを生成するタスクを対応させます。画像ごとに1つのラベルが必要なら画像分類、物体の位置が必要なら物体検出、ピクセル単位の境界が必要なら画像セグメンテーション、動画フレーム間でIDを維持する必要があるなら、同じ検出モデルをトラッキングモードで実行します。たとえば、車両の速度を監視するには、各車両の時間経過に伴う移動から速度を計算するため、トラッキングが必要です。対応するすべてのタスクについては、Ultralyticsのタスクページをご覧ください。
SMARTの基準を使用します。具体的、測定可能、達成可能、関連性がある、期限が明確、の5つです。たとえば、「10,000枚の車両画像データセットを使用し、6か月以内に速度検出で95%の精度を達成する」と設定できます。この方法は進捗の追跡と改善すべき領域の特定に役立ちます。測定可能な目標の設定について、詳しくご覧ください。
いいえ。事前学習済みモデルは、従来の意味でクラスを「記憶」しているわけではありません。大規模なデータセットからパターンを学習し、カスタムトレーニング(ファインチューニング)では、そのパターンを特定のタスクに合わせて調整します。モデルの容量には限りがあり、新しい情報に注力すると過去の学習内容の一部が上書きされる場合があります。これは破滅的忘却と呼ばれる問題です。
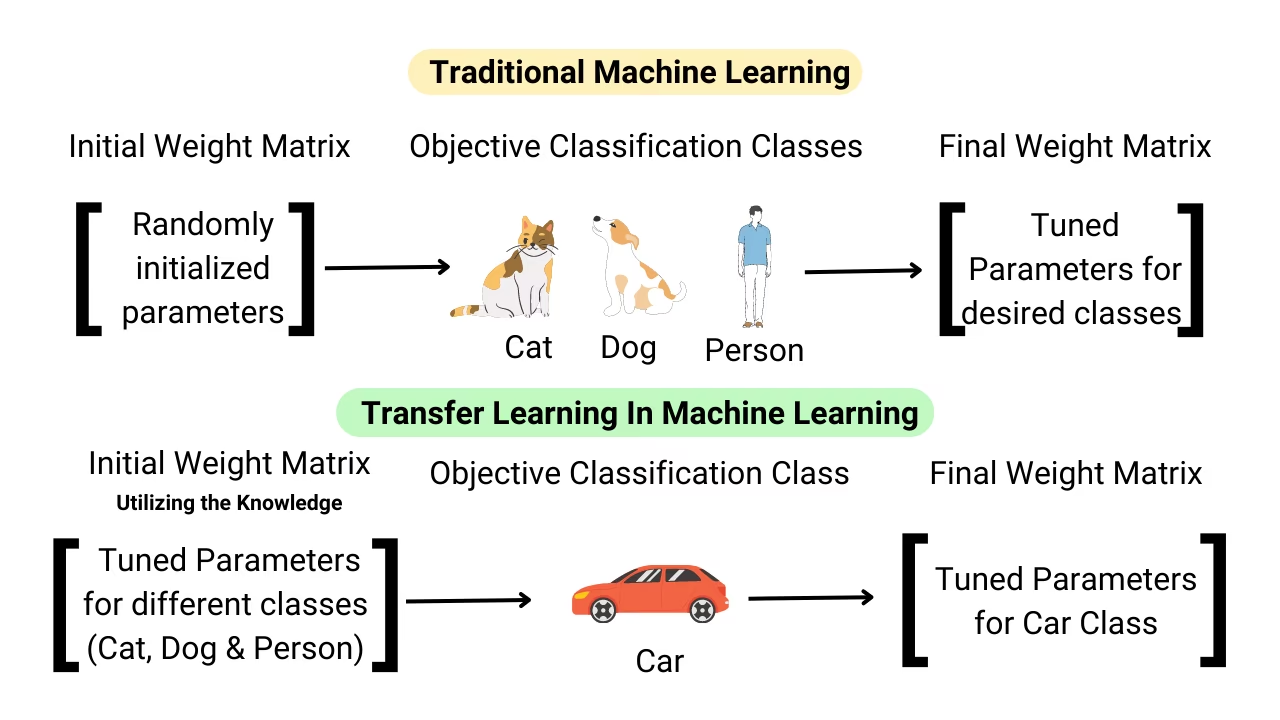
モデルが事前学習で扱ったクラスを使いたい場合は、2つのモデルを使う方法が実用的です。1つは元のパフォーマンスを維持し、もう1つは特定のタスク向けにファインチューニングします。こうすれば、両方のモデルの出力を組み合わせられます。ほかにも、レイヤーの凍結、事前学習済みモデルの特徴抽出器としての使用、タスク固有の分岐といった選択肢がありますが、より複雑で、高度な専門知識が必要です。
デプロイオプションによって利用可能なモデルサイズやフォーマットが決まるため、プロジェクトの初期段階から影響します。エッジデバイスでは、LiteRTやONNX Runtimeなどのフォーマットやランタイムを通じて軽量モデルを提供する必要があります。クラウドサーバーはスケーラブルなハードウェアで複雑なモデルを処理でき、オンプレミスサーバーはプライバシーが重視されるプロジェクトでデータを完全に管理できます。ハイブリッド構成では、両者のバランスを取ります。デプロイオプションの表で比較するか、詳しくはモデルのデプロイオプションガイドをご覧ください。
よくある課題は次のとおりです。
- 問題文が曖昧、または範囲が広すぎる。
- 非現実的な目標。
- ステークホルダー間の認識が一致していない。
- 技術的な制約への理解が不十分。
- 必要なデータ量を過小評価している。
初期段階で十分な調査を行い、ステークホルダーと明確にコミュニケーションを取り、問題文と目標を反復的に見直すことで、これらの課題に対処できます。プロジェクト全体のワークフローについては、コンピュータービジョンプロジェクトの主な手順をご覧ください。


コメント1
質問したり、結果を共有したり、ほかの人をサポートしたりできます。
VeeranjaneyuluToka
Generally i follow the below criteria to select a model -> Have a look into the literature and have a high level understanding (need to spend a couple of days or weeks also if the problem statement is quite new) -> Experiment with a few samples to check how it really performs -> Check if the chosen model can be good fit on the environment that needs to be deployed.
However currently we have a problem where we need to detect very small objects and that to be these objects are almost cluttered with background, i tried to follow the literature but most of the methods mentioned that they are good at small object detection. Would be really great if there are any suggestions on the model selection part on these kind of problem statements. Thanks in advance.