コンピュータービジョンモデルのテスト方法#
はじめに#
モデルテストでは、学習済みモデルが、厳選されたベンチマークではなく、動いている物体、照明が不十分な状況、部分的に隠れた物体など、これまで見ていない実世界のデータでどのように動作するかを確認します。モデル評価ではラベル付きデータセット上のメトリクスを測定する一方、テストでは、デプロイ前にモデルが学習した動作がアプリケーションの目標に合致しているかを検証します。このガイドでは、テストデータの準備、Ultralytics YOLO26モデルのテスト、過学習、学習不足、データリークの検出について説明します。
視聴: 機械学習モデルのテスト方法 | コンピュータービジョンでデータリークを防ぐ 🚀
モデルテストとモデル評価の違い#
モデルテストとモデル評価は、コンピュータービジョンプロジェクトにおける別々のステップです。評価ではラベル付きデータセット上のメトリクスを使ってパフォーマンスを測定します。テストでは、デプロイ時に近い条件でモデルが学習した動作を維持できるかを確認します。
猫と犬を認識するコンピュータービジョンモデルを学習させ、ペットショップで動物を監視するためにデプロイするとします。モデルの評価段階では、ラベル付きデータセットを使って正解率、適合率、再現率などのメトリクスを計算します。たとえば、あるデータセットで猫と犬を区別する正解率が98%になる場合があります。
評価後、ペットショップで撮影した画像を使ってモデルをテストし、より多様で現実的な条件で猫と犬をどれだけ適切に識別できるかを確認します。動いている場合や照明条件が異なる場合、おもちゃや家具などで一部が隠れている場合でも、猫と犬に正しくラベルを付けられるかを確かめます。モデルテストでは、管理された評価環境以外でもモデルが期待どおりに動作するかを確認します。
モデルテストの準備#
コンピュータービジョンのデータセットは、実世界の条件を再現するため、通常は学習用セットとテスト用セットに分割されます。学習データでモデルを学習し、テストデータでモデルが未見のサンプルに対する動作を検証します。Ultralytics Platformではデータセットの整理とアノテーションを一元管理できるため、ラベル付きテストセットの作成に役立ちます。
- 現実的なデータ表現:これまで見ていないテストデータは、デプロイ後にモデルが扱うデータに類似している必要があります。これにより、モデルの能力を現実的に把握できます。
- 十分なデータ量:モデルのパフォーマンスを信頼性高く把握するには、テストデータセットに十分な量のデータが必要です。
YOLO26モデルのテスト方法#
学習済みYOLO26モデルのテストには、相互に補完する2つのワークフローがあります。ラベル付きテスト分割で検証して定量的なメトリクスを取得する方法と、新しい画像に対して予測を実行して定性的に動作を確認する方法です。
ラベル付きテスト分割で検証する#
検証モードでは、モデルの予測と正解ラベルを比較し、物体検出モデルの適合率、再現率、mAP50、mAP50-95を報告します。また、混同行列や適合率-再現率曲線などの視覚的な補助資料も保存されるため、モデルのパフォーマンスが十分でない具体的な領域を特定できます。
from ultralytics import YOLO

# 事前学習済みモデルまたは独自に学習させたチェックポイント(例:"path/to/best.pt")を読み込む
model = YOLO("yolo26n.pt")

# 検証を実行します。データセットYAMLでテスト分割を定義している場合は、split="test"を追加してください
metrics = model.val(data="coco8.yaml")
print(metrics.box.map) # mAP50-95デフォルトでは、検証はデータセットのval分割で実行されます。保留したテストセットでパフォーマンスを測定するには、データセットYAMLでtest:分割を定義し、split="test"を渡します。
新しい画像に対して予測を実行する#
予測モードでは、ラベルを必要とせずに新しい未見データに対してモデルを実行します。パフォーマンスメトリクスは生成されませんが、アノテーション付きの出力を保存することで、たとえばテスト画像のフォルダー全体を一度に処理して、実世界の画像でのモデルの動作を確認できます。
from ultralytics import YOLO

# 事前学習済みモデルまたは独自に学習させたチェックポイント(例:"path/to/best.pt")を読み込む
model = YOLO("yolo26n.pt")

# テスト画像のフォルダーに対して予測を実行し、アノテーション付きの結果を保存する
results = model.predict(source="path/to/test_images", save=True)カスタム学習に取り組む前にYOLO26がアプリケーションに適しているかを確認するには、事前学習済みチェックポイントを使って、自分の画像に対する予測モードを実行します。モデルはCOCOなどのデータセットで事前学習されているため、その結果から特定の状況でのモデルのパフォーマンスをすばやく把握できます。
検証モードと予測モードの違い#
| モード | 用途 | ラベルが必要 | 出力 |
|---|---|---|---|
| 検証 | 正解データに対するパフォーマンスを定量化 | はい | 適合率、再現率、mAP50、mAP50-95、混同行列、PR曲線 |
| 予測 | ラベルのない新しいデータでモデルの動作を確認 | いいえ | アノテーション付き画像と予測結果。メトリクスはありません |
テスト結果の分析方法#
予測結果とメトリクスが得られたら、モデルがどこで、なぜ失敗するのかを詳しく調べます。
- 誤分類された画像:モデルが誤分類した画像を特定して確認し、問題が発生している箇所を理解します。
- エラー分析:エラーの種類(例:偽陽性と偽陰性)やその潜在的な原因を理解するため、詳細なエラー分析を実施します。
- バイアスと公平性:モデルの予測にバイアスがないか確認します。特に人種、性別、年齢などのセンシティブ属性が含まれる場合は、データのさまざまなサブセット間でモデルが同等のパフォーマンスを発揮することを確認してください。
機械学習における過学習と学習不足#
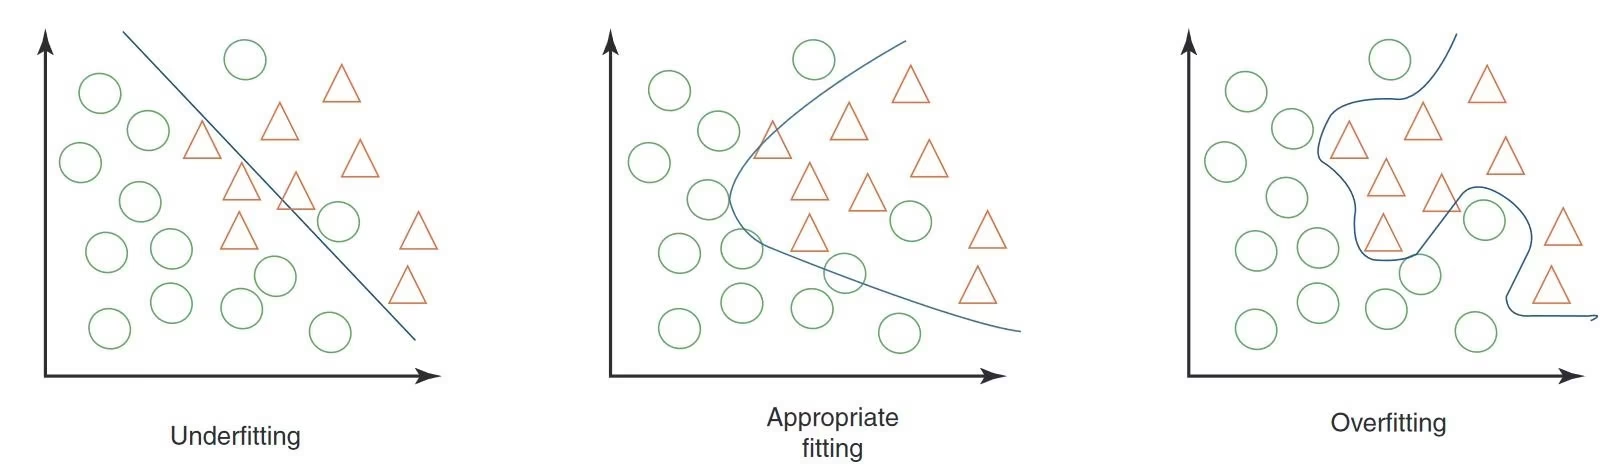
機械学習モデル、特にコンピュータービジョンモデルをテストする際は、過学習と学習不足に注意することが重要です。これらの問題は、新しいデータに対するモデルの性能に大きな影響を与える可能性があります。
| 問題 | よく見られる兆候 | 対処方法 |
|---|---|---|
| 過学習 | 学習時の正解率は高いが検証時の正解率は低い。画像のわずかな変化や無関係な詳細に過敏に反応する | ドロップアウトなどの正則化を適用する、学習データセットを拡大する、モデルアーキテクチャを簡素化する |
| 学習不足 | 学習セットでも正解率が低い。明らかな特徴や物体を安定して認識できない | より複雑なモデルを使用する、関連性の高い特徴を追加する、学習のエポック数を増やす |
重要なのは、学習データセットと検証データセットの両方でモデルが良好に動作するバランスを見つけることです。テスト中にメトリクスを定期的に監視し、予測結果を目視で確認すると、どちらか一方の極端な状態に傾いていないかを把握できます。
コンピュータービジョンにおけるデータリークとその防止方法#
データリークは、学習データセット外の情報が誤ってモデルの学習に使用された場合に発生します。データリークがあると、学習中はモデルの正解率が非常に高く見えても、新しい未見データでは良好に動作しません。
データリークは発見が難しく、学習データ内に潜むバイアスが原因となることがよくあります。
| バイアスの種類 | 発生例 |
|---|---|
| カメラバイアス | 異なるアングル、照明、影、カメラの動きによって、望ましくないパターンが生じる |
| オーバーレイバイアス | 画像内のロゴ、タイムスタンプ、その他のオーバーレイがモデルを誤らせる |
| フォントと物体のバイアス | 特定のクラスに頻繁に現れる特定のフォントや物体によって、モデルの学習が偏る |
| 空間バイアス | 前景と背景の不均衡、バウンディングボックスの分布、物体の位置が学習に影響する |
| ラベルとドメインのバイアス | 誤ったラベルやデータ型のずれは、データリークにつながります |
データリークを検出して回避する方法#
データリークを見つけるには、モデルの結果が不自然なほど良好でないかを確認し、ある特徴量の重要度が他よりはるかに高くないかを調べ、モデルの判断が直感的に妥当かを再確認し、処理を行う前にデータが正しく分割されていたことを検証します。
データリークを防ぐには、異なるカメラや環境で撮影した画像や動画を含む多様なデータセットを使用し、特定の時間帯にすべての陽性サンプルが撮影されているなど、隠れた偏りがないかデータを慎重に確認します。データリークを回避すると、コンピュータービジョンモデルの実環境での信頼性が高まります。
モデルテスト後に行うこと#
モデルをテストした後の次のステップは、結果によって異なります。モデルの性能が良好であれば、実環境にデプロイできます。結果に満足できない場合は、改善が必要です。エラーの分析、データの追加収集、データ品質の向上、ハイパーパラメーターの調整、モデルの再トレーニングなどが考えられます。
結論#
ホールドアウトしたテスト分割での検証、実環境の画像に対する予測、過学習やデータリークの確認といった厳密なモデルテストによって、十分に評価されたモデルを信頼できるモデルにできます。デプロイ前にテストで明らかになった問題に対処すれば、本番環境でモデルが意図どおりに動作する可能性が大幅に高まります。途中で質問が出てきた場合は、Ultralytics GitHubリポジトリまたはUltralytics Discordサーバーでコミュニティに質問してください。
よくある質問#
モデル評価ではラベル付きデータセット上のメトリクスで性能を測定し、モデルテストではデプロイ条件に似た、新しい未見データに対するモデルの挙動を確認します。評価では、統制されたデータセットから適合率やmAPなどの数値を算出します。一方、テストでは、照明、動き、オクルージョンが多様な状況でも学習済みの挙動が維持されるかを明らかにします。具体例については、モデルテストとモデル評価の比較をご覧ください。
予測モードを使用し、フォルダーのパスを
sourceとして渡します。YOLO26はフォルダー内のすべての画像に対して実行され、確認用に注釈付きの結果を保存できます。予測モードではメトリクスは計算されません。ラベル付きセットで性能を定量化するには、代わりに検証モードを使用してください。どちらのワークフローもYOLO26モデルのテスト方法で説明しています。物体検出モデルの検証では、適合率、再現率、mAP50、mAP50-95がレポートされ、混同行列や適合率-再現率曲線などのプロットが保存されます。デフォルトの
val分割ではなく、専用のテスト分割で検証するには、データセットYAMLでtest:を定義し、split="test"を渡します。各メトリクスの解釈については、性能メトリクスガイドをご覧ください。過学習には、ドロップアウトなどの正則化手法を適用する、トレーニングデータセットのサイズを増やす、またはモデルアーキテクチャを簡素化するといった対策があります。未学習には、より複雑なモデルを使用する、関連性の高い特徴量を追加する、またはエポック数を増やしてトレーニングするといった対策があります。それぞれの問題の兆候と対応する解決策は、機械学習における過学習と未学習にまとめられています。
テスト性能が不自然なほど高い、単一の特徴量が予測を支配している、またはモデルの判断が直感的に妥当でない場合は、データリークを疑ってください。異なるカメラや環境の多様なデータセットを使用し、隠れた偏りがないかデータを確認し、処理前にトレーニングデータとテストデータが分割されていたことを検証して、データリークを防ぎます。一般的な偏りの種類については、コンピュータービジョンにおけるデータリークをご覧ください。
結果がプロジェクトの目標を満たしていればモデルをデプロイし、満たしていなければデプロイ前に改善します。エラーの分析、より多様なデータの収集、データ品質の向上、ハイパーパラメーターの調整、再トレーニングなどが考えられます。変更を加えるたびにテストを繰り返し、修正が機能したことを確認してください。