Conjunto de dados MNIST#
O conjunto de dados MNIST (Instituto Nacional de Padrões e Tecnologia Modificado) é uma referência de classificação de imagens composta por 70.000 imagens em escala de cinza de 28x28 pixels de dígitos manuscritos, distribuídas em 10 classes — os dígitos de 0 a 9. Ele vem com uma divisão predefinida de 60.000 imagens de treinamento e 10.000 imagens de teste e há muito tempo serve como referência padrão para avaliar algoritmos de aprendizagem automática e visão computacional. Para uma alternativa mais difícil com imagens de roupas, consulte o conjunto de dados relacionado Fashion-MNIST; para imagens coloridas, consulte CIFAR-10.
Explore o MNIST na Ultralytics Platform para pré-visualizar amostras, examinar estatísticas do conjunto de dados e cloná-lo para treinamento.
Principais funcionalidades#
- O MNIST contém 60.000 imagens de treinamento e 10.000 imagens de teste de dígitos manuscritos, totalizando 70.000 imagens.
- Cada imagem é uma imagem em escala de cinza de 28x28 pixels com um único dígito, normalizada em tamanho e suavizada para caber em uma área de 20x20 pixels e centralizada no quadro de 28x28 pixels.
- As 10 classes abrangem os dígitos de 0 a 9, com uma quantidade aproximadamente equilibrada de imagens por classe.
- O conjunto vem com uma divisão predefinida entre treinamento e teste, portanto, não é necessário fazer a divisão manual ou automática.
- O MNIST é uma referência padrão para pesquisas de classificação de imagens e aprendizagem profunda.
Estrutura do conjunto de dados#
O MNIST vem com uma divisão oficial predefinida, portanto, não é necessário fazer uma partição automática ou manual:
- Classes: 10 (dígitos manuscritos de 0 a 9)
- Total de imagens: 70 000 (28x28 em tons de cinzento)
- Conjunto de treinamento: 60.000 imagens
- Conjunto de teste: 10.000 imagens
O MNIST não tem uma pasta de validação separada, portanto, por padrão, a Ultralytics usa o conjunto de teste de 10.000 imagens como divisão de validação durante o treinamento.
Cada imagem tem um rótulo correspondente ao seu dígito (0–9), o que torna o MNIST um conjunto de dados supervisionado ideal para tarefas de classificação.
Aplicações#
O MNIST é amplamente usado para treinar e avaliar modelos de classificação de imagens, desde as clássicas redes neurais convolucionais (CNNs) e máquinas de vetores de suporte (SVMs) até arquiteturas profundas modernas. Suas pequenas imagens em escala de cinza e suas 10 classes de dígitos fazem dele uma referência rápida e reproduzível para comparação de algoritmos e experimentação em visão computacional.
Algumas aplicações comuns incluem:
- Avaliação comparativa de novos algoritmos de classificação
- Fins educacionais para ensinar conceitos de aprendizagem automática
- Prototipagem de sistemas de reconhecimento de imagens
- Teste de técnicas de otimização de modelos
Uso#
Treine um modelo de classificação YOLO no MNIST por 100 épocas, usando imagens de tamanho 28. O conjunto de dados é baixado e armazenado em cache automaticamente no primeiro uso; se preferir ter controle total sobre o pré-processamento, os arquivos gzip originais também estão disponíveis no banco de dados MNIST. Para ver a lista completa de argumentos disponíveis, consulte a página de Treinamento e o guia da tarefa de classificação de imagens.
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n-cls.pt")  # carregue um modelo pré-treinado (recomendado para treinamento)

# Treinar o modelo
results = model.train(data="mnist", epochs=100, imgsz=28)A Ultralytics também disponibiliza data="mnist160", um recorte de 160 imagens que contém as primeiras oito imagens de cada dígito (0–9) das divisões de treinamento e teste. Ele reproduz a estrutura de diretórios do MNIST, para que você possa trocar de conjunto de dados sem alterar nenhum outro argumento — ideal para pipelines de CI ou verificações rápidas antes de usar o conjunto completo de 70.000 imagens.
yolo classify train data=mnist160 model=yolo26n-cls.pt epochs=5 imgsz=28Imagens de exemplo e anotações#
Exemplos de imagens do conjunto de dados MNIST:
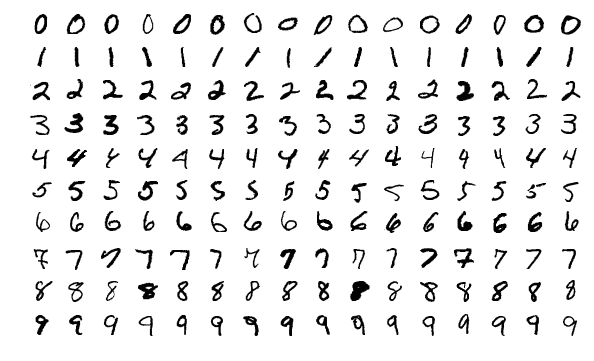
As amostras mostram a variedade de estilos de escrita capturada pelo conjunto de dados nas 10 classes de dígitos.
Citações e agradecimentos#
Se você usar o conjunto de dados MNIST em seu trabalho de pesquisa ou desenvolvimento, cite o seguinte artigo:
@article{lecun2010mnist,
         title={MNIST handwritten digit database},
         author={LeCun, Yann and Cortes, Corinna and Burges, CJ},
         journal={ATT Labs [Online]},
         volume={2},
         year={2010}
}
Gostaríamos de agradecer a Yann LeCun, Corinna Cortes e Christopher J.C. Burges por criarem e manterem o conjunto de dados MNIST como um recurso valioso para a comunidade de pesquisa em aprendizagem automática e visão computacional. Para saber mais sobre o conjunto de dados MNIST e seus criadores, visite o site do conjunto de dados MNIST.
Perguntas frequentes#
O conjunto de dados MNIST é uma referência composta por 70.000 imagens em escala de cinza de 28x28 pixels de dígitos manuscritos, divididas em 60.000 imagens de treinamento e 10.000 imagens de teste entre as 10 classes de 0 a 9. Ele é a referência padrão para avaliar algoritmos de classificação de imagens — seu formato pequeno e uniforme permite que pesquisadores e engenheiros comparem métodos e acompanhem o progresso com configuração mínima, por isso continua sendo uma referência inicial comum em aprendizagem automática.
O MNIST tem 10 classes — os dígitos manuscritos de 0 a 9 — e 70.000 imagens em escala de cinza no total, cada uma com 28x28 pixels. Ele vem com uma divisão predefinida de 60.000 imagens de treinamento e 10.000 imagens de teste, com uma quantidade aproximadamente igual de exemplos por dígito.
Para treinar um modelo Ultralytics YOLO no MNIST, use os trechos de código abaixo. O conjunto de dados é baixado automaticamente no primeiro uso. Para ver uma lista detalhada dos argumentos de treinamento disponíveis, consulte a página de Treinamento.
Exemplo de treinofrom ultralytics import YOLO # Carregar um modelo model = YOLO("yolo26n-cls.pt") # carregue um modelo pré-treinado (recomendado para treinamento) # Treinar o modelo results = model.train(data="mnist", epochs=100, imgsz=28)O MNIST vem com uma divisão predefinida de 60.000 imagens de treinamento e 10.000 imagens de teste. Ao contrário dos conjuntos de dados de classificação baseados em pastas, que a Ultralytics divide automaticamente, a partição oficial do MNIST é usada sem alterações, e, por padrão, o conjunto de teste serve como divisão de validação durante o treinamento.
O conjunto de dados MNIST contém apenas dígitos manuscritos, enquanto o MNIST Estendido (EMNIST) inclui dígitos e letras maiúsculas e minúsculas. O EMNIST foi desenvolvido como sucessor do MNIST e usa o mesmo formato de 28x28 pixels, o que o torna compatível com ferramentas e modelos projetados para o conjunto de dados MNIST original. Essa variedade maior de caracteres torna o EMNIST útil para uma gama mais ampla de aplicações de aprendizagem automática.
Sim. A Ultralytics Platform permite carregar conjuntos de dados, treinar modelos de classificação de imagens e implantá-los sem programação extensa. É uma maneira prática de executar experimentos com MNIST na nuvem — consulte a visão geral dos conjuntos de dados de classificação para ver opções relacionadas.
O MNIST é mais simples do que muitos conjuntos de dados modernos, como CIFAR-10 ou ImageNet, o que o torna ideal para iniciantes e experimentações rápidas. Embora conjuntos de dados mais complexos apresentem desafios maiores, com imagens coloridas e categorias variadas de objetos, o MNIST continua valioso por sua simplicidade, tamanho reduzido dos arquivos e importância histórica no desenvolvimento de algoritmos de aprendizagem automática. Para uma alternativa mais difícil com a mesma estrutura, consulte Fashion-MNIST, que apresenta itens de vestuário em vez de dígitos.