Segmentação de instâncias e rastreamento usando Ultralytics YOLO26
O que é segmentação de instâncias?#
A segmentação de instâncias é uma tarefa de visão computacional que envolve identificar e delinear objetos individuais em uma imagem no nível do pixel. Diferentemente da segmentação semântica, que apenas classifica os pixels por categoria, a segmentação de instâncias atribui rótulos exclusivos e delimita com precisão cada instância de objeto, o que a torna essencial para aplicações que exigem compreensão espacial detalhada, como imagens médicas, direção autônoma e automação industrial.
O Ultralytics YOLO26 delimita os contornos dos objetos com precisão, mantendo a velocidade e a eficiência pelas quais os modelos YOLO são conhecidos.
O pacote Ultralytics oferece dois tipos de rastreamento de segmentação de instâncias:
-
Segmentação de instâncias com objetos de classe: cada objeto de classe recebe uma cor exclusiva para facilitar a distinção visual.
-
Segmentação de instâncias com rastreamento de objetos: cada rastreamento é representado por uma cor distinta, facilitando a identificação e o acompanhamento ao longo dos quadros do vídeo.
Assista: Segmentação de instâncias com rastreamento de objetos usando Ultralytics YOLO26
Amostras#
| Segmentação de instâncias | Segmentação de instâncias + rastreamento de objetos |
|---|---|
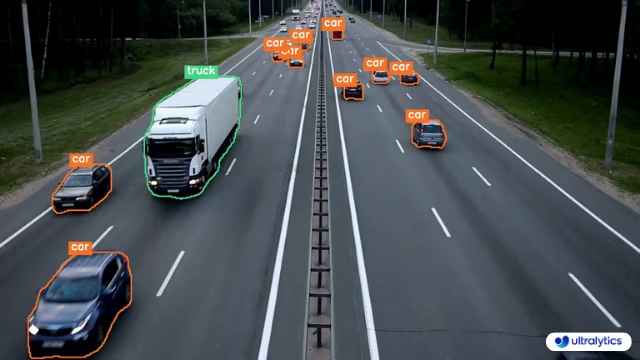 | 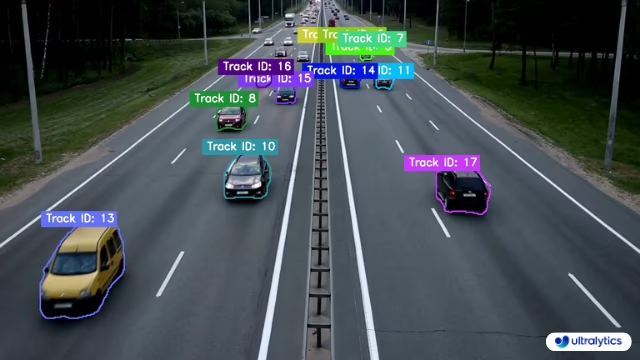 |
| Segmentação de instâncias do Ultralytics | Segmentação de instâncias do Ultralytics com rastreamento de objetos |
Segmente e rastreie com YOLO26#
A solução InstanceSegmentation executa um modelo de segmentação YOLO26 em cada quadro, desenha máscaras para cada objeto e colore cada instância separadamente para que você possa rastrear objetos individuais ao longo de um vídeo. Carregue um modelo -seg, como o YOLO26n-seg, e execute-o na sua fonte com a API Python ou a CLI.
# Instance segmentation using Ultralytics YOLO26
yolo solutions isegment show=True

# Pass a source video
yolo solutions isegment source="path/to/video.mp4"

# Monitor the specific classes
yolo solutions isegment classes="[0, 5]"
Argumentos de InstanceSegmentation#
Aqui está uma tabela com os argumentos de InstanceSegmentation:
| Argumento | Tipo | Padrão | Descrição |
|---|---|---|---|
model | str | None | Caminho para um arquivo de modelo Ultralytics YOLO. |
line_width | int | 2 | Espessura das linhas das caixas, dos pontos-chave e das contagens desenhados pela solução. |
verbose | bool | True | Ativa o registro por quadro da solução, com o formato da entrada, as contagens por classe e a velocidade de processamento. A chamada de rastreamento em si é sempre silenciosa. |
Você também pode usar argumentos track na solução InstanceSegmentation:
| Argumento | Tipo | Padrão | Descrição |
|---|---|---|---|
tracker | str | 'tracktrack.yaml' | Especifica o algoritmo de rastreamento a utilizar. Opções integradas: botsort.yaml, bytetrack.yaml, ocsort.yaml, deepocsort.yaml, fasttrack.yaml, tracktrack.yaml. |
conf | float | 0.25 | Define o limiar de confiança das deteções; valores mais baixos permitem rastrear mais objetos, mas podem incluir falsos positivos. |
iou | float | 0.5 | Define o limiar de interseção sobre união (IoU) para filtrar deteções sobrepostas. |
classes | list | None | Filtra os resultados pelo índice da classe. Por exemplo, classes=[0, 2, 3] rastreia apenas as classes especificadas. |
device | str | None | Especifica o dispositivo para a inferência (por exemplo, cpu, cuda:0 ou 0). Permite escolher entre CPU, uma GPU específica ou outros dispositivos de computação para executar o modelo. |
imgsz | int or tuple | 640 | Tamanho da imagem de destino para a inferência: um número inteiro para uma imagem quadrada ou um par (height, width). As dimensões são ajustadas ao stride do modelo. |
max_det | int | 300 | Número máximo de deteções mantidas por fotograma antes do rastreamento, limitando os objetos que uma solução processa em cenas densas. |
quantize | int or str | None | Precisão de inferência: 16 (FP16) ou 32/unset (FP32) para modelos PyTorch e TorchScript fora da CPU; os outros formatos usam a precisão selecionada pelo artefato e pelo ambiente de execução. Substitui o argumento obsoleto half. |
Além disso, estão disponíveis os seguintes argumentos de visualização:
| Argumento | Tipo | Padrão | Descrição |
|---|---|---|---|
show | bool | False | Se True, exibe as imagens ou os vídeos anotados em uma janela. Útil para obter feedback visual imediato durante o desenvolvimento ou os testes. |
show_conf | bool | True | Exibe a pontuação de confiança de cada detecção junto ao rótulo. Mostra o grau de certeza do modelo em cada detecção. |
show_labels | bool | True | Exibe os rótulos de cada detecção na saída visual. Permite identificar imediatamente os objetos detectados. |
show_boxes | bool | True | Desenha caixas delimitadoras ao redor dos objetos detectados. Essencial para identificar visualmente e localizar objetos em imagens ou quadros de vídeo. |
Aplicações da segmentação de instâncias#
A segmentação de instâncias com YOLO26 tem inúmeras aplicações práticas em diversos setores:
Gestão de resíduos e reciclagem#
O YOLO26 pode ser usado em instalações de gestão de resíduos para identificar e classificar diferentes tipos de materiais. O modelo pode segmentar resíduos plásticos, papelão, metal e outros materiais recicláveis com alta precisão, permitindo que sistemas de classificação automatizados processem resíduos com mais eficiência. Isso é especialmente valioso considerando que apenas cerca de 10% dos 7 bilhões de toneladas de resíduos plásticos gerados no mundo são reciclados.
Veículos autônomos#
Em carros autônomos, a segmentação de instâncias ajuda a identificar e rastrear pedestres, veículos, sinais de trânsito e outros elementos da via ao nível do pixel. Essa compreensão precisa do ambiente é fundamental para decisões de navegação e segurança. O desempenho em tempo real do YOLO26 torna-o adequado para essas aplicações sensíveis ao tempo.
Imagens médicas#
A segmentação de instâncias pode identificar e delinear tumores, órgãos ou estruturas celulares em exames médicos. A capacidade do YOLO26 de delimitar com precisão os contornos dos objetos o torna valioso para o diagnóstico médico e o planejamento do tratamento.
Monitoramento de canteiros de obras#
Em canteiros de obras, a segmentação de instâncias pode rastrear máquinas pesadas, trabalhadores e materiais. Isso ajuda a garantir a segurança ao monitorar as posições dos equipamentos e detectar quando trabalhadores entram em áreas perigosas, além de otimizar o fluxo de trabalho e a alocação de recursos.
Perguntas frequentes#
Para realizar a segmentação de instâncias com o Ultralytics YOLO26, inicialize a solução
InstanceSegmentationcom um modelo de segmentação YOLO26 e processe os quadros de vídeo com ela. Veja um exemplo de código simplificado:import cv2 from ultralytics import solutions cap = cv2.VideoCapture("path/to/video.mp4") assert cap.isOpened(), "Error reading video file" # Gravador de vídeo w, h, fps = (int(cap.get(x)) for x in (cv2.CAP_PROP_FRAME_WIDTH, cv2.CAP_PROP_FRAME_HEIGHT, cv2.CAP_PROP_FPS)) video_writer = cv2.VideoWriter("instance-segmentation.avi", cv2.VideoWriter_fourcc(*"mp4v"), fps, (w, h)) # Inicializar InstanceSegmentation isegment = solutions.InstanceSegmentation( show=True, # # Apresenta o resultado model="yolo26n-seg.pt", # model="yolo26n-seg.pt" para segmentação de objetos usando YOLO26. ) # Processa o vídeo while cap.isOpened(): success, im0 = cap.read() if not success: print("Video frame is empty or processing is complete.") break results = isegment(im0) video_writer.write(results.plot_im) cap.release() video_writer.release() cv2.destroyAllWindows()A segmentação de instâncias identifica e contorna objetos individuais em uma imagem, atribuindo a cada objeto um rótulo e uma máscara únicos. O rastreamento de objetos amplia esse processo ao atribuir IDs consistentes aos objetos em todos os quadros do vídeo, permitindo acompanhar os mesmos objetos continuamente ao longo do tempo. Quando combinados, como na implementação do YOLO26, esses recursos permitem analisar o movimento e o comportamento dos objetos em vídeos, mantendo informações precisas sobre seus contornos.
O Ultralytics YOLO26 oferece desempenho em tempo real, precisão competitiva e facilidade de uso em comparação com modelos de dois estágios, como Mask R-CNN ou Faster R-CNN. O YOLO26 processa imagens em uma única passagem (detecção de estágio único), o que o torna muito mais rápido sem deixar de manter alta precisão. Ele também se integra à Ultralytics Platform para gerenciar modelos, conjuntos de dados e pipelines de treinamento. Para aplicações que precisam de velocidade e precisão, o YOLO26 oferece um equilíbrio sólido.
Sim. A Ultralytics oferece vários conjuntos de dados adequados para treinar modelos YOLO26 para segmentação de instâncias, incluindo COCO-Seg, COCO8-Seg (um subconjunto menor para testes rápidos), Package-Seg e Crack-Seg. Esses conjuntos de dados incluem as anotações no nível do pixel necessárias para tarefas de segmentação de instâncias. Para aplicações mais especializadas, você também pode criar conjuntos de dados personalizados seguindo o formato da Ultralytics. As informações completas sobre os conjuntos de dados e as instruções de uso estão disponíveis na documentação de conjuntos de dados da Ultralytics.


Comentários99
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
CatFatOw
Hello, I am trying to analyze a video and see if features grow/shrink over time. I am currently trying to use instance segmentation with object tracking; however, specifying
save_txt=Trueparameter inmodel.tracksaves every single prediction into a single huge txt file. Trying to count the frames by going through this large txt apparently doesn't work as the class ID are not in order and sorting it would lose all information.Is there any way for Ultralytics to save the txt files by frame number? For example, frame1.txt only contains the predictions of the first frame.
Any help would be greatly appreciated!
1 Glenn JocherUltralytics
For per-frame TXT saving with tracking, you'll need to process results in your video loop and write custom frame-specific files. Here's a minimal adaptation of the Instance Segmentation and Tracking example:
frame_count = 0
while cap.isOpened():
    ret, im0 = cap.read()
    if not ret: break

    results = model.track(im0, persist=True)

    # Save current frame's tracked objects
    with open(f'frame{frame_count}.txt', 'w') as f:
        for box, mask, track_id in zip(results[0].boxes, results[0].masks, results[0].boxes.id.int().cpu().tolist()):
            f.write(f"{track_id} {box.cls.item()} {box.xywhn.tolist()} {mask.xy[0].tolist()}\n")

    frame_count += 1
This creates individual frameX.txt files with tracking IDs, class IDs, normalized boxes, and mask coordinates. The official documentation shows similar frame processing in the Instance Segmentation with Object Tracking examples.
Thank you!
- Glenn JocherUltralytics
For per-frame TXT saving during tracking, you'll need to process each frame individually in your video loop as shown in the Instance Segmentation with Object Tracking example. Here's a minimal adaptation that creates frame-specific files:
frame_count = 0
while cap.isOpened():
    ret, im0 = cap.read()
    if not ret: break

    results = model.track(im0, persist=True)

    with open(f'frame{frame_count}.txt', 'w') as f:
        for box, mask, track_id in zip(results[0].boxes, results[0].masks, results[0].boxes.id.int().cpu().tolist()):
            f.write(f"{track_id} {box.cls.item()} {box.xywhn.tolist()} {mask.xy[0].tolist()}\n")

    frame_count += 1
This creates individual frameX.txt files with tracking IDs, class IDs, normalized boxes, and mask coordinates per frame. The approach mirrors the frame processing shown in our official tracking documentation.
pedmindset
Been trying to figure this out for a while now. I want to ask, can I use object counting in regions with instance sementation and tracking? You want to count vehicles that cross two specific regions, like so Object 001 crossed region A and region B. Is this possible to do
1- Glenn JocherUltralytics
@pedmindset yes, it is possible to combine object counting in regions with instance segmentation and tracking using Ultralytics YOLO11. You can use the
trackmethod to assign consistent IDs to objects across frames and define regions to monitor their crossings. For guidance, refer to the segmentation and tracking examples in the Instance Segmentation and Tracking Guide. Let us know if you need further clarification!
DP1701
Cool, but I can't define an imgsz via solutions.InstanceSegmentation(…). Is there another option for this?
- Glenn JocherUltralytics
solutions.InstanceSegmentationis a higher-level wrapper and doesn’t currently exposeimgszdirectly; if you need to control input size, run segmentation+tracking via the coreYOLO(...).track()API (supportsimgsz) as shown in the Tracking mode docs and keep using the Instance Segmentation and Tracking guide for solution-level usage.from ultralytics import YOLO model = YOLO("yolo26n-seg.pt") results = model.track(source="path/to/video.mp4", imgsz=640, show=True, tracker="botsort.yaml")
Hello, I noticed that when using tracking mode compared to normal segmentation prediction, the number of features predicted decreased by quite a lot for feature dense videos even if I use the same parameters of confidence and maximum detection?
- Glenn JocherUltralytics
@CatFatOw great observation! This is actually expected behavior when using tracking mode compared to plain segmentation. Tracking algorithms apply additional filtering beyond confidence thresholds to maintain stable tracks, which can reduce the total number of detections.
Here are a few things that might help increase detections while maintaining tracking:
# Try adjusting these tracking-specific parameters
results = model.track(
    frame,
    persist=True,
    conf=0.3,  # Lower confidence threshold
    iou=0.5,   # Adjust IoU threshold for NMS
    max_det=1000,  # Increase max detections
    tracker="bytetrack.yaml"  # Try different trackers
)
You can also experiment with different tracking algorithms - ByteTrack tends to be more permissive with new track creation compared to BoTSORT. The trade-off is between detection sensitivity and tracking stability, where tracking prioritizes consistent object IDs over detecting every possible instance.
If you need maximum detection sensitivity, consider running both modes and using tracking results only when you need the temporal consistency.
Ok, thank you for the reply!
Mauricio566
Hello. Please, I need your help. I know exactly what segmenting an object is and how to do it. But I don't know what to do with an already segmented object or pixel mask. You can find a lot of information online about "how to segment a model or fit it to your dataset," but they don't tell you what to do with those masks in real projects. Can you give me some ideas or help, please? for r in results:
if r.masks is not None: mask = r.masks.data[0].cpu().numpy() there is the mask but honestly I don't know what to do. thankse-roe
Hello Glenn, thanks for the example! Actually, I had already figured it out—it was more of a suggestion for the documentation examples. []´s
- Glenn JocherUltralytics
Thank you for the suggestion! We always welcome community contributions to improve our documentation through GitHub Pull Requests. Feel free to submit any specific improvements you'd like to see in the Instance Segmentation with Object Tracking guide.
1
Hello, Wouldn't it be good to have a complete example showing how to extract the track ID, contour points, class, and confidence? These methods that handle everything automatically end up being of little practical use, and finding this information in the documentation is quite challenging—it's often easier to find from third-party sources. []´s
- Glenn JocherUltralytics(editado)
@e-roe thanks for your feedback! You can access track IDs, classes, masks, and confidence scores directly from the results object. Here's a concise example showing how to extract these details:
results = isegment(im0)
for i in range(len(isegment.clss)):
    track_id = isegment.track_ids[i]
    class_name = isegment.names[isegment.clss[i]]
    confidence = isegment.confs[i]
    mask = isegment.masks[i].data[0].numpy()  # Binary mask array
    contours, _ = cv2.findContours(mask.astype(np.uint8), cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
For full implementation details, see the InstanceSegmentation reference in our documentation. Let us know if you need further clarification!
expen6ve
Hi! I tried training a pretrained yolov8m-seg model on our custom 1 class dataset consisting of 1,307 images with 5 augmentations like:
Flip: Horizontal, Vertical Rotation: Between -15° and +15° Saturation: Between -25% and +25% Blur: Up to 1.4px Noise: Up to 1.49% of pixels
with these training configurations:
# Train the model
results = model.train(
    data="data6.yaml",
    epochs=250,
    imgsz=320,
    batch=8,
    workers=4,
    device=device,
    patience=18,
    copy_paste=0.1  # Add this line to enable copy-paste augmentation
)
this is my 16th model training as i tried testing out from 200+ images that and so on. In my val plots, i always get bad results. What can i further do to make a good model? it stopped training at 128 with the results below:
epoch,time,train/box_loss,train/seg_loss,train/cls_loss,train/dfl_loss,metrics/precision(B),metrics/recall(B),metrics/mAP50(B),metrics/mAP50-95(B),metrics/precision(M),metrics/recall(M),metrics/mAP50(M),metrics/mAP50-95(M),val/box_loss,val/seg_loss,val/cls_loss,val/dfl_loss,lr/pg0,lr/pg1,lr/pg2
126,4123.96,0.47628,0.76702,0.30532,0.85667,0.9862,0.96565,0.98972,0.94445,0.9775,0.97566,0.98923,0.83189,0.35178,0.67432,0.26286,0.89191,0.00101,0.00101,0.00101 127,4156.45,0.47613,0.76458,0.30439,0.85872,0.96877,0.98339,0.98913,0.94227,0.98701,0.96962,0.99053,0.83626,0.34228,0.67744,0.25083,0.88958,0.00100208,0.00100208,0.00100208
- Glenn JocherUltralytics(editado)
@expen6ve thank you for sharing your training details. For improved segmentation results with YOLO26, consider these adjustments:
- Dataset Size: 1.3k images may be insufficient for robust segmentation. Aim for ≥5k high-quality annotated images.
- Augmentation Tuning: Reduce rotation range (try ±5°) and remove noise augmentation, which can degrade mask precision.
- Hyperparameters: Increase imgsz to 640 (standard for segmentation tasks) and lower learning rate to 0.0001 with cosine scheduler.
- Model Selection: Try YOLO26s-seg instead of medium-sized models for better generalization on limited data.
For detailed guidance, see the Segmentation Training Tips in our documentation.
ShreyasChhetri
Hi can we implement a Reinforcement Learning function up above the Yolo training function for more accuracy can it happen ?
- Glenn JocherUltralytics
@ShreyasChhetri integrating reinforcement learning (RL) with YOLO training is an interesting idea, but YOLO models are not inherently designed for RL workflows. While it is theoretically possible, it would require substantial custom development outside the scope of the provided Ultralytics framework. You might consider exploring hybrid approaches combining RL and computer vision if your use case demands it. For standard training, refer to the existing YOLO training documentation: https://docs.ultralytics.com/modes/train.
ZhangAiyi
I have a question when run the code for Instance Segmentation with Object Tracking. The pycharm said UnicodeEncodeError: 'gbk' codec can't encode character '\u274c' in position 401: illegal multibyte sequence. Does anyone have the similar question? Thank you.
- Glenn JocherUltralytics
@ZhangAiyi it seems like you're encountering a Unicode encoding issue. You can try setting your environment's encoding to UTF-8 in PyCharm to resolve this. If the problem persists, please check the PyCharm settings or your system's locale configuration.