Práticas recomendadas para implantação de modelos#
Introdução#
A implantação de modelos é a etapa de um projeto de visão computacional que leva um modelo da fase de desenvolvimento para uma aplicação do mundo real. Há várias opções de implantação de modelos: a implantação na nuvem oferece escalabilidade e facilidade de acesso; a implantação na borda reduz a latência ao aproximar o modelo da fonte de dados; e a implantação local garante privacidade e controle. A escolha da estratégia certa depende das necessidades da sua aplicação e exige equilibrar velocidade, segurança e escalabilidade.
Assista: Como otimizar e implantar modelos de IA: práticas recomendadas, solução de problemas e considerações de segurança
Também é importante seguir as práticas recomendadas ao implantar um modelo, pois a implantação pode afetar significativamente a eficácia e a confiabilidade do desempenho do modelo. Neste guia, vamos nos concentrar em como garantir que a implantação do seu modelo seja tranquila, eficiente e segura.
Opções de implantação de modelos#
Muitas vezes, depois que um modelo é treinado, avaliado e testado, ele precisa ser convertido para formatos específicos para ser implantado com eficiência em vários ambientes, como nuvem, borda ou dispositivos locais.
Com o YOLO26, você pode exportar seu modelo para vários formatos, dependendo das suas necessidades de implantação. Por exemplo, exportar o YOLO26 para ONNX é simples e ideal para transferir modelos entre frameworks. Para explorar mais opções de integração e garantir uma implantação tranquila em diferentes ambientes, acesse nosso catálogo de integração de modelos.
Escolher um ambiente de implantação#
A escolha de onde implantar seu modelo de visão computacional depende de vários fatores. Cada ambiente tem benefícios e desafios próprios, por isso é essencial escolher o que melhor atende às suas necessidades.
Implantação na nuvem#
A implantação na nuvem é ideal para aplicações que precisam escalar rapidamente e processar grandes volumes de dados. Plataformas como AWS, Google Cloud e Azure facilitam o gerenciamento dos seus modelos, do treinamento à implantação. Elas oferecem serviços como AWS SageMaker, Google AI Platform e Azure Machine Learning para ajudar você durante todo o processo.
No entanto, usar a nuvem pode ser caro, especialmente com alto uso de dados, e você pode enfrentar problemas de latência se seus usuários estiverem longe dos centros de dados. Para controlar custos e desempenho, é importante otimizar o uso de recursos e garantir a conformidade com as regras de privacidade de dados.
Implantação na borda#
A implantação na borda funciona bem para aplicações que precisam de respostas em tempo real e baixa latência, especialmente em locais com acesso limitado ou sem acesso à internet. Implantar modelos em dispositivos de borda, como smartphones ou dispositivos IoT, garante processamento rápido e mantém os dados localmente, o que aumenta a privacidade. A implantação na borda também economiza largura de banda, pois reduz o volume de dados enviado à nuvem.
No entanto, os dispositivos de borda geralmente têm poder de processamento limitado, então você precisará otimizar seus modelos. Ferramentas como LiteRT e NVIDIA Jetson podem ajudar. Apesar dos benefícios, pode ser difícil manter e atualizar muitos dispositivos.
Implantação local#
A implantação local é a melhor opção quando a privacidade dos dados é fundamental ou quando o acesso à internet é instável ou inexistente. Executar modelos em servidores ou computadores locais dá a você controle total e mantém seus dados seguros. Isso também pode reduzir a latência se o servidor estiver próximo do usuário.
No entanto, pode ser difícil escalar localmente, e a manutenção pode consumir muito tempo. O uso de ferramentas como Docker para conteinerização e Kubernetes para gerenciamento pode ajudar a tornar as implantações locais mais eficientes. Atualizações e manutenção regulares são necessárias para manter tudo funcionando sem problemas.
Conteinerização para simplificar a implantação#
A conteinerização é uma abordagem poderosa que empacota seu modelo e todas as dependências em uma unidade padronizada chamada contêiner. Essa técnica garante desempenho consistente em diferentes ambientes e simplifica o processo de implantação.
Benefícios do uso do Docker para implantação de modelos#
O Docker tornou-se o padrão do setor para conteinerização em implantações de aprendizado de máquina por vários motivos:
- Consistência do ambiente: os contêineres Docker encapsulam seu modelo e todas as dependências, eliminando o problema de "funciona na minha máquina" ao garantir um comportamento consistente nos ambientes de desenvolvimento, teste e produção.
- Isolamento: os contêineres isolam as aplicações umas das outras, evitando conflitos entre diferentes versões de software ou bibliotecas.
- Portabilidade: os contêineres Docker podem ser executados em qualquer sistema compatível com Docker, facilitando a implantação dos seus modelos em diferentes plataformas sem modificações.
- Escalabilidade: os contêineres podem ser facilmente escalados para cima ou para baixo conforme a demanda, e ferramentas de orquestração como Kubernetes podem automatizar esse processo.
- Controle de versões: as imagens Docker podem ser versionadas, permitindo acompanhar as alterações e reverter para versões anteriores quando necessário.
Implementação do Docker para implantação do YOLO26#
Para conteinerizar seu modelo YOLO26, você pode criar um Dockerfile que especifique todas as dependências e configurações necessárias. Veja um exemplo básico:
FROM ultralytics/ultralytics:latest

WORKDIR /app

# Copy your model and any additional files
COPY ./models/yolo26n.pt /app/models/
COPY ./scripts /app/scripts/

# Set up any environment variables
ENV MODEL_PATH=/app/models/yolo26n.pt

# Command to run when the container starts
CMD ["python", "/app/scripts/predict.py"]
Essa abordagem garante que a implantação do seu modelo seja reproduzível e consistente nos ambientes de desenvolvimento, teste e produção.
Técnicas de otimização de modelos#
Otimizar seu modelo de visão computacional ajuda a executá-lo com eficiência, principalmente ao implantá-lo em ambientes com recursos limitados, como dispositivos de borda. Veja algumas técnicas importantes para otimizar seu modelo.
Poda de modelos#
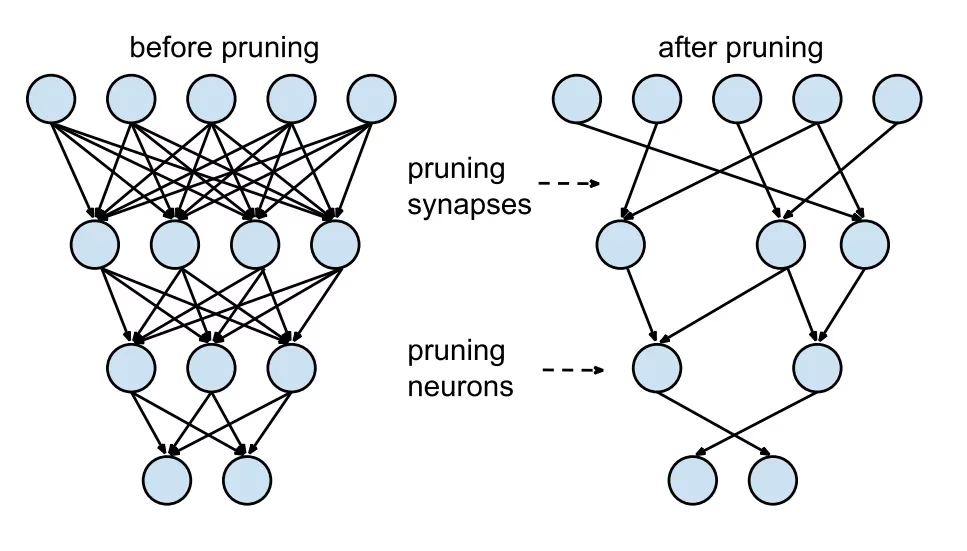
A poda reduz o tamanho do modelo ao remover pesos que pouco contribuem para o resultado final. Ela torna o modelo menor e mais rápido sem afetar significativamente a precisão. A poda envolve identificar e eliminar parâmetros desnecessários, resultando em um modelo mais leve que exige menos poder computacional. Ela é especialmente útil para implantar modelos em dispositivos com recursos limitados.
Quantização de modelos#
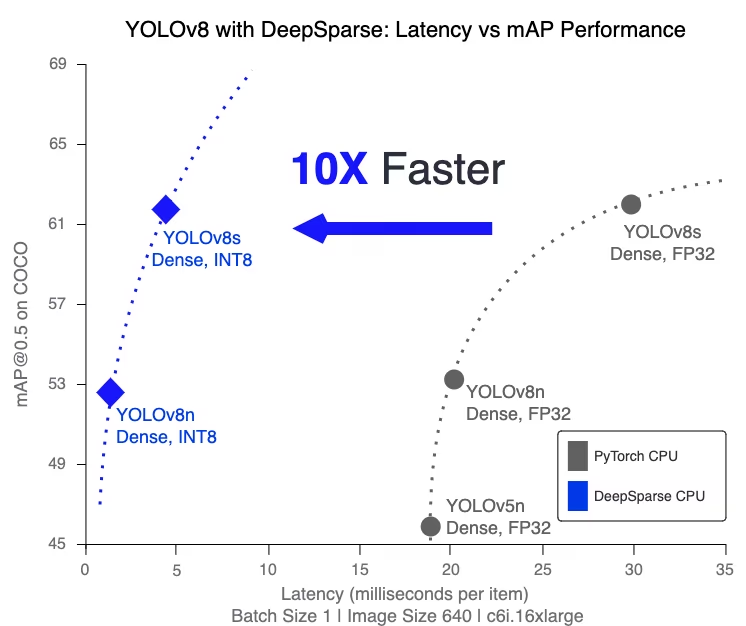
A quantização converte os pesos e as ativações do modelo de precisão alta (como números de ponto flutuante de 32 bits) para uma precisão menor (como inteiros de 8 bits). Ao reduzir o tamanho do modelo, ela acelera a inferência. O treinamento com reconhecimento de quantização (QAT) é um método no qual o modelo é treinado considerando a quantização, preservando melhor a precisão do que a quantização pós-treinamento. Ao lidar com a quantização durante a fase de treinamento, o modelo aprende a se ajustar à precisão menor, mantendo o desempenho e reduzindo as exigências computacionais.
Destilação de conhecimento#
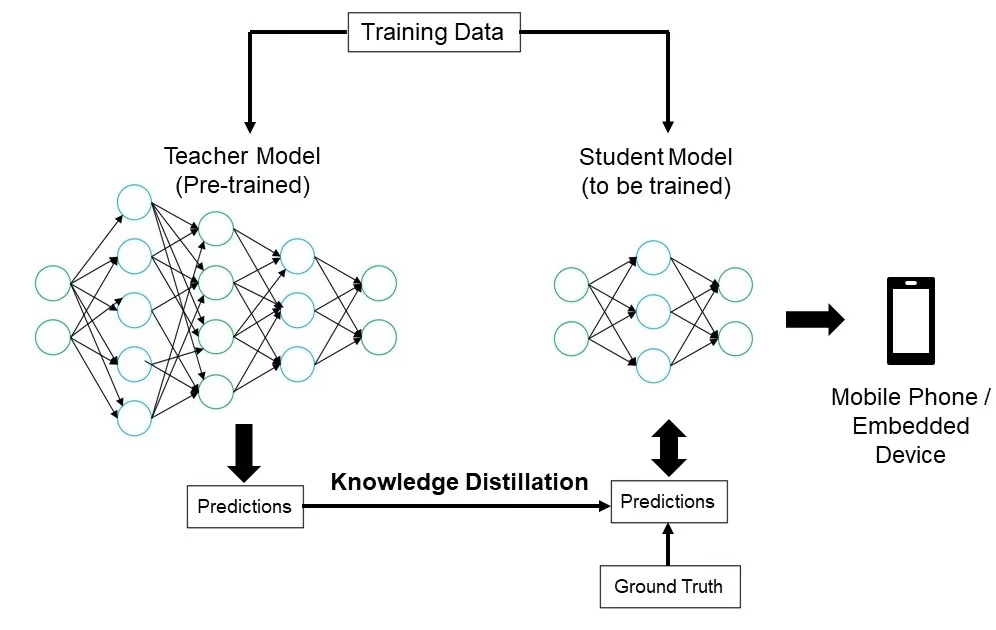
A destilação de conhecimento envolve treinar um modelo menor e mais simples (o aluno) para imitar as saídas de um modelo maior e mais complexo (o professor). O modelo aluno aprende a aproximar as previsões do professor, resultando em um modelo compacto que mantém boa parte da precisão do professor. Essa técnica é útil para criar modelos eficientes, adequados à implantação em dispositivos de borda com recursos limitados.
Solução de problemas de implantação#
Você pode enfrentar desafios ao implantar seus modelos de visão computacional, mas entender os problemas comuns e suas soluções pode tornar o processo mais tranquilo. Aqui estão algumas dicas gerais de solução de problemas e práticas recomendadas para ajudar você a lidar com questões de implantação.
Seu modelo está menos preciso após a implantação#
Perceber uma queda na precisão do seu modelo após a implantação pode ser frustrante. Esse problema pode ter várias causas. Veja algumas etapas para ajudar você a identificar e resolver o problema:
- Verifique a consistência dos dados: confira se os dados processados pelo seu modelo após a implantação são consistentes com os dados usados no treinamento. Diferenças na distribuição, qualidade ou formato dos dados podem afetar significativamente o desempenho.
- Valide as etapas de pré-processamento: verifique se todas as etapas de pré-processamento aplicadas durante o treinamento também são aplicadas de forma consistente durante a implantação. Isso inclui redimensionar imagens, normalizar valores de pixels e outras transformações de dados.
- Avalie o ambiente do modelo: garanta que as configurações de hardware e software usadas durante a implantação correspondam às usadas durante o treinamento. Diferenças nas bibliotecas, versões e capacidades de hardware podem gerar discrepâncias.
- Monitore a inferência do modelo: registre entradas e saídas em várias etapas do pipeline de inferência para detectar anomalias. Isso pode ajudar a identificar problemas como corrupção de dados ou tratamento inadequado das saídas do modelo.
- Revise a exportação e a conversão do modelo: exporte o modelo novamente e verifique se o processo de conversão preserva a integridade dos pesos e da arquitetura do modelo.
- Teste com um conjunto de dados controlado: implante o modelo em um ambiente de teste com um conjunto de dados que você controla e compare os resultados com os da fase de treinamento. Assim, você pode identificar se o problema está no ambiente de implantação ou nos dados.
Ao implantar o YOLO26, vários fatores podem afetar a precisão do modelo. Converter modelos para formatos como TensorRT envolve otimizações como quantização de pesos e fusão de camadas, que podem causar pequenas perdas de precisão. Usar FP16 (precisão de meia precisão) em vez de FP32 (precisão simples) pode acelerar a inferência, mas talvez introduza erros de precisão numérica. Além disso, limitações de hardware, como as do Jetson Nano, com menor quantidade de núcleos CUDA e largura de banda de memória reduzida, podem afetar o desempenho.
As inferências estão demorando mais do que você esperava#
Ao implantar modelos de aprendizado de máquina, é importante que eles sejam executados com eficiência. Se as inferências estiverem demorando mais do que o esperado, isso pode afetar a experiência do usuário e a eficácia da sua aplicação. Veja algumas etapas para ajudar você a identificar e resolver o problema:
- Faça execuções de aquecimento: as execuções iniciais geralmente incluem sobrecarga de configuração, o que pode distorcer as medições de latência. Faça algumas inferências de aquecimento antes de medir a latência. Desconsiderar essas execuções iniciais proporciona uma medição mais precisa do desempenho do modelo.
- Otimize o mecanismo de inferência: confira se o mecanismo de inferência está totalmente otimizado para a arquitetura específica da sua GPU. Use os drivers e as versões de software mais recentes, adequados ao seu hardware, para garantir o máximo de desempenho e compatibilidade.
- Use processamento assíncrono: o processamento assíncrono pode ajudar a gerenciar as cargas de trabalho com mais eficiência. Use técnicas de processamento assíncrono para lidar com várias inferências simultaneamente, o que pode ajudar a distribuir a carga e reduzir o tempo de espera.
- Faça o perfil do pipeline de inferência: identificar gargalos no pipeline de inferência pode ajudar a localizar a origem dos atrasos. Use ferramentas de perfil para analisar cada etapa do processo de inferência, identificando e resolvendo etapas que causem atrasos significativos, como camadas ineficientes ou problemas de transferência de dados.
- Use a precisão adequada: usar uma precisão maior do que o necessário pode tornar as inferências mais lentas. Experimente usar uma precisão menor, como FP16 (precisão de meia precisão), em vez de FP32 (precisão simples). Embora FP16 possa reduzir o tempo de inferência, lembre-se também de que isso pode afetar a precisão do modelo.
Se você estiver enfrentando esse problema ao implantar o YOLO26, considere que o YOLO26 oferece vários tamanhos de modelo, como o YOLO26n (nano), para dispositivos com menor capacidade de memória, e o YOLO26x (extra-large), para GPUs mais potentes. Escolher a variante de modelo adequada ao seu hardware pode ajudar a equilibrar o uso de memória e o tempo de processamento.
Lembre-se também de que o tamanho das imagens de entrada afeta diretamente o uso de memória e o tempo de processamento. Resoluções mais baixas reduzem o uso de memória e aceleram a inferência, enquanto resoluções mais altas melhoram a precisão, mas exigem mais memória e poder de processamento.
Considerações de segurança na implantação de modelos#
Outro aspecto importante da implantação é a segurança. A segurança dos modelos implantados é fundamental para proteger dados confidenciais e propriedade intelectual. Veja algumas práticas recomendadas que você pode seguir para implantar modelos com segurança.
Transmissão segura de dados#
Garantir a segurança dos dados enviados entre clientes e servidores é muito importante para evitar que sejam interceptados ou acessados por pessoas não autorizadas. Você pode usar protocolos de criptografia como TLS (Segurança da Camada de Transporte) para criptografar os dados durante a transmissão. Mesmo que alguém intercepte os dados, não conseguirá lê-los. Você também pode usar criptografia de ponta a ponta, que protege os dados desde a origem até o destino, impedindo que qualquer pessoa no percurso os acesse.
Controles de acesso#
É essencial controlar quem pode acessar seu modelo e os dados associados para evitar o uso não autorizado. Use métodos robustos de autenticação para verificar a identidade de usuários ou sistemas que tentem acessar o modelo e considere adicionar uma camada extra de segurança com autenticação multifator (MFA). Configure o controle de acesso baseado em funções (RBAC) para atribuir permissões de acordo com as funções dos usuários, garantindo que cada pessoa tenha acesso apenas ao que precisa. Mantenha registros de auditoria detalhados para acompanhar todos os acessos e alterações no modelo e nos dados, e revise esses registros regularmente para identificar atividades suspeitas.
Ofuscação do modelo#
Você pode proteger seu modelo contra engenharia reversa ou uso indevido por meio da ofuscação do modelo. Isso envolve criptografar parâmetros do modelo, como pesos e vieses em redes neurais, para dificultar que pessoas não autorizadas entendam ou alterem o modelo. Você também pode ofuscar a arquitetura do modelo renomeando camadas e parâmetros ou adicionando camadas fictícias, dificultando a engenharia reversa por parte de atacantes. Disponibilizar o modelo em um ambiente seguro, como um enclave seguro ou um ambiente de execução confiável (TEE), também pode oferecer uma camada extra de proteção durante a inferência.
Conclusão e próximos passos#
Apresentamos algumas práticas recomendadas para implantar modelos de visão computacional. Ao proteger os dados, controlar o acesso e ofuscar os detalhes do modelo, você pode proteger informações confidenciais e manter seus modelos funcionando sem problemas. Também discutimos como resolver problemas comuns, como redução da precisão e inferências lentas, usando estratégias como execuções de aquecimento, otimização de mecanismos, processamento assíncrono, criação de perfil de pipelines e escolha da precisão adequada.
Após implantar seu modelo, a próxima etapa é monitorar, manter e documentar sua aplicação. O monitoramento regular ajuda a detectar e corrigir problemas rapidamente, a manutenção mantém seus modelos atualizados e funcionais, e uma boa documentação registra todas as alterações e atualizações. Essas etapas ajudarão você a alcançar as metas do seu projeto de visão computacional.
Perguntas frequentes#
Implantar um modelo de aprendizado de máquina, especialmente com o Ultralytics YOLO26, envolve algumas práticas recomendadas para garantir eficiência e confiabilidade. Primeiro, escolha o ambiente de implantação mais adequado às suas necessidades: nuvem, edge ou local. Otimize seu modelo com técnicas como poda, quantização e destilação de conhecimento para implantá-lo com eficiência em ambientes com recursos limitados. Considere usar a conteinerização com Docker para garantir a consistência entre diferentes ambientes. Por fim, garanta a consistência dos dados e alinhe as etapas de pré-processamento com a fase de treinamento para manter o desempenho. Você também pode consultar as opções de implantação de modelos para ver orientações mais detalhadas.
A solução de problemas de implantação pode ser dividida em algumas etapas principais. Se a precisão do seu modelo cair após a implantação, verifique a consistência dos dados, valide as etapas de pré-processamento e garanta que o ambiente de hardware e software corresponda ao usado durante o treinamento. Para reduzir tempos de inferência lentos, faça execuções de aquecimento, otimize o mecanismo de inferência, use processamento assíncrono e faça o perfil do pipeline de inferência. Consulte o guia de solução de problemas de implantação para ver mais detalhes sobre essas práticas recomendadas.
Otimizar modelos Ultralytics YOLO26 para dispositivos edge envolve técnicas como poda para reduzir o tamanho do modelo, quantização para converter os pesos para uma precisão menor e destilação de conhecimento para treinar modelos menores que imitam modelos maiores. Essas técnicas garantem que o modelo seja executado com eficiência em dispositivos com poder computacional limitado. Ferramentas como LiteRT e NVIDIA Jetson são particularmente úteis para essas otimizações. Saiba mais sobre essas técnicas na seção sobre otimização de modelos.
A segurança é fundamental ao implantar modelos de aprendizado de máquina. Garanta a transmissão segura de dados usando protocolos de criptografia como TLS. Implemente controles de acesso robustos, incluindo autenticação forte e controle de acesso baseado em funções (RBAC). Técnicas de ofuscação de modelos, como criptografar parâmetros do modelo e disponibilizar modelos em um ambiente seguro, como um ambiente de execução confiável (TEE), oferecem proteção adicional. Para conhecer práticas detalhadas, consulte as considerações de segurança.
A escolha do ambiente de implantação ideal para seu modelo Ultralytics YOLO26 depende das necessidades específicas da sua aplicação. A implantação na nuvem oferece escalabilidade e facilidade de acesso, sendo ideal para aplicações com grandes volumes de dados. A implantação edge é mais adequada a aplicações de baixa latência que exigem respostas em tempo real, usando ferramentas como LiteRT. A implantação local atende a cenários que exigem privacidade e controle rigorosos dos dados. Para uma visão geral completa de cada ambiente, confira a seção sobre como escolher um ambiente de implantação.