Рекомендации по развёртыванию моделей
Введение#
Развёртывание модели — это этап проекта по компьютерному зрению, на котором модель переносится из среды разработки в реальное приложение. Есть разные варианты развёртывания моделей: облако обеспечивает масштабируемость и удобный доступ, граничное развёртывание уменьшает задержку, приближая модель к источнику данных, а локальное развёртывание обеспечивает конфиденциальность и контроль. Выбор подхода зависит от потребностей приложения и предполагает баланс между скоростью, безопасностью и масштабируемостью.
Смотри: Как оптимизировать и развертывать модели ИИ: рекомендации, устранение неполадок и вопросы безопасности
При развертывании модели также важно соблюдать рекомендации, поскольку развертывание может существенно повлиять на эффективность и надежность работы модели. В этом руководстве мы расскажем, как обеспечить плавное, эффективное и безопасное развертывание модели.
Варианты развертывания модели#
После обучения, оценки и тестирования модели её часто нужно преобразовать в определённые форматы, чтобы эффективно развернуть в разных средах, например в облаке, на граничных устройствах или локальных устройствах.
YOLO26 позволяет экспортировать модель в различные форматы в зависимости от потребностей развертывания. Например, экспорт YOLO26 в ONNX выполняется просто и идеально подходит для переноса моделей между фреймворками. Чтобы изучить другие варианты интеграции и обеспечить плавное развертывание в разных средах, посети наш каталог интеграции моделей.
Выбор среды развертывания#
Выбор места для развертывания модели компьютерного зрения зависит от многих факторов. У разных сред есть свои преимущества и сложности, поэтому важно выбрать вариант, который лучше всего соответствует твоим потребностям.
Облачное развертывание#
Облачное развёртывание подходит приложениям, которым нужно быстро масштабироваться и обрабатывать большие объёмы данных. Такие платформы, как AWS, Google Cloud и Azure, упрощают управление моделями на всех этапах — от обучения до развёртывания. Они предлагают такие сервисы, как Amazon SageMaker, Google Vertex AI и Azure Machine Learning, которые помогают на каждом этапе. Ultralytics Platform также развёртывает модели YOLO на выделенных конечных точках в 42 регионах мира.
Однако использование облака может быть дорогим, особенно при большом объеме данных, а если пользователи находятся далеко от центров обработки данных, возможны проблемы с задержкой. Для управления расходами и производительностью важно оптимизировать использование ресурсов и соблюдать правила защиты данных.
Периферийное развертывание#
Граничное развёртывание подходит приложениям, которым нужны ответы в реальном времени и низкая задержка, особенно в местах с ограниченным доступом к интернету или без него. Развёртывание моделей на граничных устройствах, например смартфонах или устройствах IoT, обеспечивает быструю обработку и хранение данных локально, повышая конфиденциальность. Граничное развёртывание также сокращает расход трафика за счёт уменьшения объёма данных, отправляемых в облако.
Однако вычислительная мощность граничных устройств часто ограничена, поэтому модели придётся оптимизировать. В этом могут помочь среды выполнения и аппаратные платформы, такие как LiteRT и NVIDIA Jetson. Несмотря на преимущества, обслуживать и обновлять множество устройств может быть сложно.
Локальное развертывание#
Локальное развёртывание лучше всего подходит, когда конфиденциальность данных критически важна или интернет работает нестабильно либо недоступен. Запуск моделей на локальных серверах или компьютерах даёт полный контроль и обеспечивает безопасность данных. Он также может снизить задержку, если сервер находится рядом с пользователем.
Однако масштабировать локальное развёртывание бывает непросто, а обслуживание может отнимать много времени. Использование Docker для контейнеризации и Kubernetes для управления поможет повысить эффективность локального развёртывания. Чтобы всё работало стабильно, необходимы регулярные обновления и обслуживание.
Контейнеризация для упрощения развертывания#
Контейнеризация упаковывает модель и все её зависимости в стандартизированный модуль, называемый контейнером. Этот подход обеспечивает стабильную производительность в разных средах и упрощает развёртывание.
Преимущества использования Docker для развертывания моделей#
По нескольким причинам Docker стал отраслевым стандартом контейнеризации при развертывании моделей машинного обучения:
- Единообразие среды: контейнеры Docker включают модель и все ее зависимости, устраняя проблему «на моем компьютере работает» и обеспечивая одинаковое поведение в средах разработки, тестирования и эксплуатации.
- Изоляция: контейнеры изолируют приложения друг от друга и предотвращают конфликты между разными версиями программного обеспечения и библиотек.
- Переносимость: контейнеры Docker работают в любой системе с поддержкой Docker, поэтому модели легко развертывать на разных платформах без изменений.
- Масштабируемость: контейнеры можно легко масштабировать в зависимости от нагрузки, а инструменты оркестрации, например Kubernetes, позволяют автоматизировать этот процесс.
- Контроль версий: для образов Docker можно задавать версии, отслеживать изменения и при необходимости возвращаться к предыдущим версиям.
Развертывание YOLO26 с помощью Docker#
Чтобы контейнеризировать свою модель YOLO26, создай Dockerfile, в котором указаны все необходимые зависимости и настройки. Вот простой пример:
FROM ultralytics/ultralytics:latest

WORKDIR /app

# Copy your model and any additional files
COPY ./models/yolo26n.pt /app/models/
COPY ./scripts /app/scripts/

# Set up any environment variables
ENV MODEL_PATH=/app/models/yolo26n.pt

# Command to run when the container starts
CMD ["python", "/app/scripts/predict.py"]
Этот подход обеспечивает воспроизводимость развертывания модели и ее стабильную работу в средах разработки, тестирования и эксплуатации.
Методы оптимизации модели#
Оптимизация модели компьютерного зрения помогает ей работать эффективнее, особенно при развёртывании в средах с ограниченными ресурсами, например на периферийных устройствах. Вот несколько основных методов оптимизации модели.
Прореживание модели#
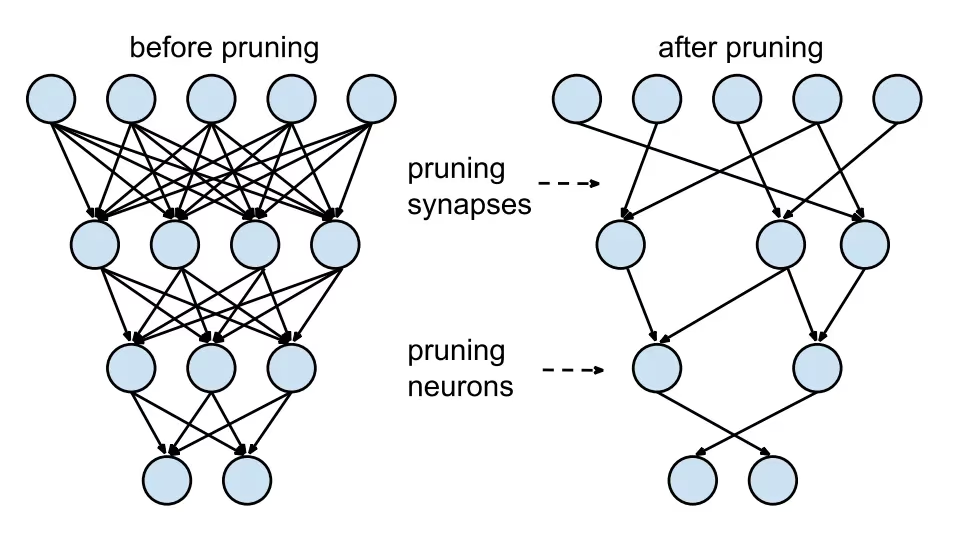
Прореживание уменьшает размер модели, удаляя веса, которые мало влияют на итоговый результат. Модель становится меньше и быстрее, при этом точность существенно не снижается. Прореживание включает выявление и удаление ненужных параметров, в результате чего получается облегчённая модель, требующая меньше вычислительных ресурсов. Этот метод особенно полезен при развёртывании моделей на устройствах с ограниченными ресурсами.
Квантование модели#
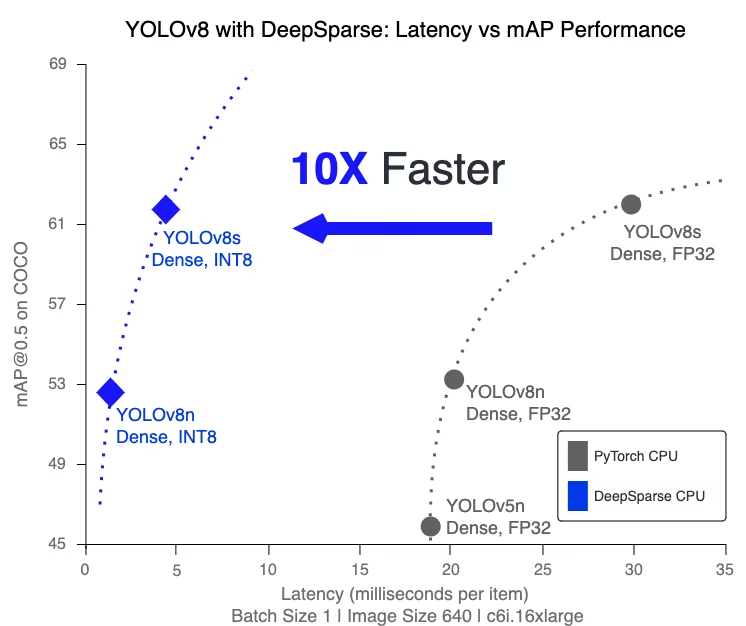
Квантование преобразует веса и активации модели из высокой точности (например, 32-разрядных чисел с плавающей точкой) в более низкую (например, 8-разрядные целые числа). Уменьшение размера модели ускоряет инференс. Обучение с учётом квантования (QAT) — это метод, при котором модель обучается с учётом квантования и лучше сохраняет точность, чем при квантовании после обучения. Обрабатывая квантование на этапе обучения, модель учится адаптироваться к более низкой точности, сохраняя производительность и снижая вычислительные затраты. В Ultralytics YOLO задай quantize=8 при экспорте для квантования INT8 после обучения или во время обучения для QAT.
Дистилляция знаний#
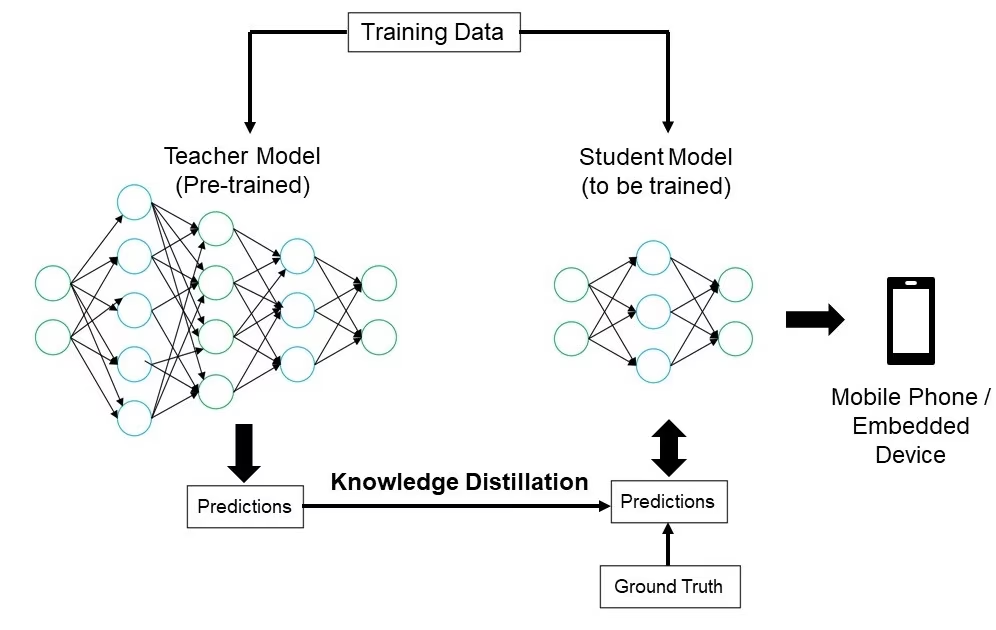
Дистилляция знаний предполагает обучение меньшей и более простой модели (ученика), которая имитирует выходные данные более крупной и сложной модели (учителя). Модель-ученик учится приближать предсказания модели-учителя, в результате чего получается компактная модель, сохраняющая большую часть точности модели-учителя. Этот метод полезен для создания эффективных моделей, подходящих для развёртывания на периферийных устройствах с ограниченными ресурсами. Ultralytics YOLO поддерживает этот метод с помощью аргумента обучения distill_model.
Устранение проблем при развертывании#
При развёртывании моделей компьютерного зрения могут возникнуть сложности, но понимание распространённых проблем и способов их решения поможет упростить этот процесс. Вот несколько общих советов по устранению неполадок и рекомендаций, которые помогут тебе справиться с проблемами развёртывания.
После развёртывания точность модели снизилась#
Снижение точности модели после развёртывания может быть вызвано разными факторами. Вот несколько шагов, которые помогут выявить и устранить проблему:
- Проверь согласованность данных: Убедись, что данные, которые модель обрабатывает после развёртывания, соответствуют данным, на которых она обучалась. Различия в распределении, качестве или формате данных могут существенно повлиять на производительность.
- Проверь этапы предобработки: Убедись, что все этапы предобработки, применявшиеся при обучении, так же последовательно применяются и при развёртывании. Сюда входят изменение размера изображений, нормализация значений пикселей и другие преобразования данных.
- Проверь среду выполнения модели: Убедись, что конфигурации аппаратного и программного обеспечения при развёртывании совпадают с теми, что использовались при обучении. Различия в библиотеках, их версиях и возможностях оборудования могут привести к расхождениям.
- Отслеживай инференс модели: Записывай входные и выходные данные на разных этапах конвейера инференса, чтобы обнаруживать аномалии. Это поможет выявить такие проблемы, как повреждение данных или неправильная обработка выходных данных модели.
- Проверь экспорт и преобразование модели: Экспортируй модель заново и убедись, что в ходе преобразования сохраняются целостность весов и архитектура модели.
- Проверь модель на контролируемом наборе данных: Разверни модель в тестовой среде на наборе данных, который ты контролируешь, и сравни результаты с результатами этапа обучения. Так ты сможешь определить, связана ли проблема со средой развёртывания или с данными.
При развёртывании YOLO26 на точность модели могут влиять несколько факторов. Преобразование моделей в такие форматы, как TensorRT, включает оптимизацию, например квантование весов и объединение слоёв, что может привести к небольшим потерям точности. Использование FP16 (половинной точности) вместо FP32 (полной точности) ускоряет инференс, но может вызывать ошибки численной точности. Кроме того, производительность могут снижать аппаратные ограничения, например у Jetson Nano, где меньше ядер CUDA и ниже пропускная способность памяти.
Инференс занимает больше времени, чем ожидалось#
При развёртывании моделей машинного обучения важно обеспечить их эффективную работу. Если инференс занимает больше времени, чем ожидалось, это может ухудшить пользовательский опыт и снизить эффективность приложения. Вот несколько шагов, которые помогут выявить и устранить проблему:
- Выполняй прогревочные запуски: Первые запуски часто включают накладные расходы на настройку, из-за чего измерения задержки могут быть неточными. Перед измерением задержки выполни несколько прогревочных запусков инференса. Если исключить первые запуски, измерение производительности модели будет точнее.
- Оптимизируй движок инференса: Ещё раз проверь, что движок инференса полностью оптимизирован для архитектуры твоего GPU. Используй последние версии драйверов и программного обеспечения, подходящие для твоего оборудования, чтобы обеспечить максимальную производительность и совместимость.
- Используй асинхронную обработку: Асинхронная обработка помогает эффективнее управлять рабочими нагрузками. Применяй её для одновременного выполнения нескольких операций инференса: это поможет распределить нагрузку и сократить время ожидания.
- Профилируй конвейер инференса: Выявление узких мест в конвейере инференса поможет определить источник задержек. Используй инструменты профилирования для анализа каждого этапа инференса, выявляй и устраняй этапы, вызывающие значительные задержки, например неэффективные слои или проблемы с передачей данных.
- Используй подходящую точность: Точность выше необходимой может замедлить инференс. Попробуй использовать более низкую точность, например FP16 (
quantize=16при экспорте), вместо FP32 (полной точности). Хотя FP16 сокращает время инференса, помни, что он также может повлиять на точность модели.
Если при развёртывании YOLO26 возникла эта проблема, учти, что YOLO26 предлагает модели разных размеров, например YOLO26n (nano) для устройств с небольшим объёмом памяти и YOLO26x (extra-large) для более мощных GPU. Правильный выбор варианта модели для твоего оборудования поможет сбалансировать использование памяти и время обработки.
Также учитывай, что размер входных изображений напрямую влияет на использование памяти и время обработки. Более низкое разрешение уменьшает расход памяти и ускоряет инференс, а более высокое повышает точность, но требует больше памяти и вычислительных ресурсов.
Что важно учитывать при обеспечении безопасности развёрнутых моделей#
Ещё один важный аспект развёртывания — безопасность. Безопасность развёрнутых моделей критически важна для защиты конфиденциальных данных и интеллектуальной собственности. Вот несколько рекомендаций, которым можно следовать для безопасного развёртывания моделей.
Безопасная передача данных#
Защита данных, передаваемых между клиентами и серверами, необходима, чтобы предотвратить их перехват или доступ к ним со стороны посторонних. Для шифрования данных при передаче можно использовать такие протоколы шифрования, как TLS (протокол защиты транспортного уровня). Даже если кто-то перехватит данные, прочитать их не получится. Также можно использовать сквозное шифрование, которое защищает данные от источника до получателя, поэтому никто на промежуточных этапах не сможет получить к ним доступ.
Контроль доступа#
Важно контролировать, кто может получить доступ к модели и её данным, чтобы предотвратить несанкционированное использование. Используй надёжные методы аутентификации для проверки пользователей или систем, запрашивающих доступ к модели, и рассмотри возможность усилить защиту многофакторной аутентификацией (MFA). Настрой ролевую модель управления доступом (RBAC), чтобы назначать разрешения в соответствии с ролями пользователей и предоставлять каждому доступ только к необходимым ресурсам. Веди подробные журналы аудита, чтобы отслеживать весь доступ к модели и её данным, а также все изменения, и регулярно проверяй эти журналы на предмет подозрительной активности.
Обфускация модели#
Защитить модель от обратной разработки и неправомерного использования можно с помощью обфускации. Она предполагает шифрование параметров модели, например весов и смещений в нейронных сетях, чтобы посторонним было сложнее понять устройство модели или изменить её. Можно также обфусцировать архитектуру модели, переименовывая слои и параметры или добавляя фиктивные слои, чтобы усложнить обратную разработку. Размещение модели в защищённой среде, например в защищённом анклаве или доверенной среде выполнения (TEE), также обеспечивает дополнительный уровень защиты во время инференса.
Заключение и следующие шаги#
Мы рассмотрели несколько рекомендаций по развёртыванию моделей компьютерного зрения. Защищая данные, контролируя доступ и скрывая детали модели, ты можешь оберегать конфиденциальную информацию и обеспечивать стабильную работу моделей. Мы также обсудили, как решать распространённые проблемы, такие как снижение точности и медленный инференс, с помощью прогревочных запусков, оптимизации движков, асинхронной обработки, профилирования конвейеров и правильного выбора точности.
После развёртывания модели следующий шаг — мониторинг, обслуживание и документирование приложения. Регулярный мониторинг помогает быстро обнаруживать и устранять проблемы, обслуживание поддерживает актуальность и работоспособность моделей, а качественная документация фиксирует все изменения и обновления. Эти шаги помогут достичь целей проекта компьютерного зрения.
Часто задаваемые вопросы#
Развёртывание модели машинного обучения, особенно с помощью Ultralytics YOLO26, требует соблюдения ряда рекомендаций для обеспечения эффективности и надёжности. Сначала выбери подходящую среду развёртывания — облако, периферийное устройство или локальную среду. Оптимизируй модель с помощью таких методов, как прунинг, квантование и дистилляция знаний, чтобы эффективно развернуть её в средах с ограниченными ресурсами. Для обеспечения согласованности между разными средами рассмотри возможность контейнеризации с помощью Docker. Наконец, проверь согласованность данных и соответствие этапов предобработки этапу обучения — это поможет сохранить производительность. Более подробные рекомендации можно найти в разделе варианты развёртывания моделей.
Устранение проблем при развёртывании можно разделить на несколько основных шагов. Если после развёртывания точность модели снизилась, проверь согласованность данных и этапы предобработки, а также убедись, что аппаратная и программная среда совпадает с той, что использовалась при обучении. Если инференс выполняется медленно, выполни прогревочные запуски, оптимизируй движок инференса, используй асинхронную обработку и профилируй конвейер инференса. Подробное руководство по этим рекомендациям см. в разделе устранение проблем при развёртывании.
Оптимизация моделей Ultralytics YOLO26 для периферийных устройств включает применение таких методов, как прунинг для уменьшения размера модели, квантование для преобразования весов в формат с меньшей точностью и дистилляция знаний для обучения компактных моделей, имитирующих более крупные. Эти методы обеспечивают эффективную работу модели на устройствах с ограниченными вычислительными ресурсами. Для такой оптимизации особенно полезны инструменты LiteRT и NVIDIA Jetson. Подробнее об этих методах читай в разделе оптимизация моделей.
При развёртывании моделей машинного обучения безопасность имеет первостепенное значение. Обеспечь безопасную передачу данных с помощью протоколов шифрования, таких как TLS. Настрой надёжный контроль доступа, включающий сильную аутентификацию и ролевую модель управления доступом (RBAC). Дополнительную защиту обеспечивают методы обфускации модели, например шифрование её параметров и размещение модели в защищённой среде, такой как доверенная среда выполнения (TEE). Подробные рекомендации см. в разделе аспекты безопасности.
Выбор оптимальной среды для развёртывания модели Ultralytics YOLO26 зависит от конкретных потребностей приложения. Облачное развёртывание обеспечивает масштабируемость и простоту доступа, поэтому оно хорошо подходит приложениям с большими объёмами данных. Периферийное развёртывание оптимально для приложений с низкой задержкой, которым нужны ответы в реальном времени; для него можно использовать такие инструменты, как LiteRT. Локальное развёртывание подходит для сценариев, требующих строгой конфиденциальности данных и контроля над ними. Обзор каждой среды см. в разделе выбор среды развёртывания.


Комментарии10
Задай вопрос, поделись результатами или помоги кому-нибудь.
 TaoBenHui
shafa~hahaha
Taufiq-Ahmed
Hi, I Have trained my custom dataset on yolov8s model. Now I want to optimized the model by using pruning and quantization. could you please tell me How I can implement it and what is the python code of it?
 Paula DerrengerUltralytics
@Taufiq-Ahmed to optimize your YOLOv8 model using pruning and quantization, you can follow these steps:
-
Pruning: This involves removing weights that contribute little to the final output, making the model smaller and faster. You can use libraries like TensorFlow Model Optimization Toolkit or PyTorch's pruning methods.
-
Quantization: This converts the model's weights and activations from high precision (e.g., 32-bit floats) to lower precision (e.g., 8-bit integers), reducing model size and speeding up inference. You can use TensorFlow Lite for post-training quantization or PyTorch's quantization tools.
For detailed guidance and code examples, please refer to the Ultralytics documentation on model optimization. This resource provides comprehensive instructions and best practices for deploying and optimizing your models effectively.
-
Thank you so much for your reply. One think I would like to know, is it possible to do pruning and quantization in my YOLOv8 best.pt model with TensorFlow Model Optimization Toolkit or PyTorch's pruning methods. Do do I need to convert it and also need to convert my dataset from YOLO format to any other format?
- Paula DerrengerUltralytics
Yes, you can perform pruning and quantization on your YOLOv8 model using TensorFlow Model Optimization Toolkit or PyTorch's pruning methods. You don't need to convert your dataset format, but you may need to convert your model to a compatible format like ONNX if using TensorFlow tools. For PyTorch, you can directly apply pruning and quantization techniques. For detailed steps, please refer to the Ultralytics documentation on model deployment practices.
Thank you for your reply. could you please give me any git hub repositories or any coding example on how to apply pruning and quantization techniques on the best.pt model on custom dataset. and how will i maintain the accuracy of the model.
- Paula DerrengerUltralytics
@Taufiq-Ahmed for pruning and quantization of your YOLOv8 model, you can use PyTorch's built-in functionalities. You don't need to convert your dataset format. For pruning, you can use
torch.nn.utils.prune, and for quantization, you can usetorch.quantization. If you need specific code examples, please let me know. For more detailed guidance, you can refer to the Ultralytics documentation on model deployment practices. Thank you for your reply. it would be better for me if you share a coding example of how to prune and quantize the model on the custom data to reduce it's size and weights using pytorch and how to ´maintain it's accuracy. do I need to train it again or there is some other way to maintain it's accuracy.
Hi could you please check whether this idea works:
import torch import torch.nn as nn from torch.nn.utils import prune from ultralytics import YOLO
model = YOLO('best.pt')
def gradual_prune_model(model, prune_step=0.05, prune_iterations=10): for i in range(prune_iterations):
    for name, module in model.model.named_modules():
        if isinstance(module, nn.Conv2d):
            prune.l1_unstructured(module, name='weight', amount=prune_step)
            prune.remove(module, 'weight')  # Remove pruning reparameterization

    print(f'Fine-tuning after pruning iteration {i+1}/{prune_iterations}')
    model.train(data='dataset.yaml', epochs=2, lr=1e-4)
gradual_prune_model(model, prune_step=0.05, prune_iterations=10)
print('Final fine-tuning after pruning') model.train(data='/path/to/your/dataset.yaml', epochs=10, lr=1e-5)
model.save('pruned_yolov8.pt')
is this pruned technique works? and after pruning is this the right way to regain it's accuracy?
- Paula DerrengerUltralytics
Your approach to pruning looks good. Gradual pruning followed by fine-tuning can help maintain accuracy. After pruning, fine-tuning with a lower learning rate is essential to regain any lost accuracy. For quantization, you can use PyTorch's quantization tools. Ensure you validate the model's performance after each step. For more detailed guidance, refer to the Ultralytics documentation on model deployment practices.