Các phương pháp tốt nhất khi triển khai model
Giới thiệu#
Triển khai model là bước trong một dự án thị giác máy tính đưa model từ giai đoạn phát triển vào ứng dụng thực tế. Có nhiều tùy chọn triển khai model: triển khai trên cloud mang lại khả năng mở rộng và truy cập dễ dàng, triển khai ở edge giảm độ trễ bằng cách đưa model đến gần nguồn dữ liệu hơn, còn triển khai cục bộ đảm bảo quyền riêng tư và khả năng kiểm soát. Việc chọn chiến lược phù hợp phụ thuộc vào nhu cầu của ứng dụng, đồng thời cần cân bằng tốc độ, bảo mật và khả năng mở rộng.
Xem: Cách tối ưu hóa và triển khai model AI: các phương pháp tốt nhất, khắc phục sự cố và lưu ý về bảo mật
Việc tuân theo các phương pháp tốt nhất khi triển khai model cũng rất quan trọng, vì quá trình triển khai có thể ảnh hưởng đáng kể đến hiệu quả và độ tin cậy của model. Trong hướng dẫn này, chúng tôi sẽ tập trung vào cách đảm bảo quá trình triển khai model diễn ra suôn sẻ, hiệu quả và an toàn.
Các tùy chọn triển khai model#
Thông thường, sau khi model được huấn luyện, đánh giá và kiểm thử, model cần được chuyển đổi sang các định dạng cụ thể để triển khai hiệu quả trong nhiều môi trường như cloud, edge hoặc thiết bị cục bộ.
Với YOLO26, bạn có thể xuất model sang nhiều định dạng tùy theo nhu cầu triển khai. Ví dụ, xuất YOLO26 sang ONNX rất đơn giản và lý tưởng để chuyển model giữa các framework. Để khám phá thêm các tùy chọn tích hợp và đảm bảo triển khai suôn sẻ trên nhiều môi trường, hãy truy cập danh mục tích hợp model của chúng tôi.
Chọn môi trường triển khai#
Việc chọn nơi triển khai model thị giác máy tính phụ thuộc vào nhiều yếu tố. Mỗi môi trường có những lợi ích và thách thức riêng, vì vậy điều cần thiết là chọn môi trường phù hợp nhất với nhu cầu của bạn.
Triển khai trên cloud#
Triển khai trên cloud phù hợp với các ứng dụng cần mở rộng nhanh và xử lý lượng dữ liệu lớn. Các nền tảng như AWS, Google Cloud và Azure giúp quản lý model dễ dàng từ huấn luyện đến triển khai. Các nền tảng này cung cấp những dịch vụ như Amazon SageMaker, Google Vertex AI và Azure Machine Learning để hỗ trợ bạn trong toàn bộ quy trình. Ultralytics Platform cũng triển khai model YOLO lên các endpoint chuyên dụng tại 42 khu vực trên toàn cầu.
Tuy nhiên, sử dụng cloud có thể tốn kém, đặc biệt khi lưu lượng dữ liệu cao; bạn cũng có thể gặp vấn đề về độ trễ nếu người dùng ở xa các trung tâm dữ liệu. Để kiểm soát chi phí và hiệu năng, điều quan trọng là tối ưu hóa việc sử dụng tài nguyên và đảm bảo tuân thủ các quy định về quyền riêng tư dữ liệu.
Triển khai edge#
Triển khai ở edge phù hợp với các ứng dụng cần phản hồi theo thời gian thực và độ trễ thấp, đặc biệt tại những nơi có kết nối Internet hạn chế hoặc không có kết nối. Triển khai model trên các thiết bị edge như điện thoại thông minh hoặc thiết bị IoT giúp xử lý nhanh và giữ dữ liệu tại chỗ, qua đó tăng cường quyền riêng tư. Triển khai ở edge cũng tiết kiệm băng thông do giảm lượng dữ liệu gửi lên cloud.
Tuy nhiên, thiết bị edge thường có năng lực xử lý hạn chế, vì vậy bạn cần tối ưu hóa model. Các runtime và nền tảng phần cứng như LiteRT và NVIDIA Jetson có thể hỗ trợ việc này. Dù có nhiều lợi ích, việc duy trì và cập nhật số lượng lớn thiết bị có thể gặp khó khăn.
Triển khai cục bộ#
Triển khai cục bộ phù hợp nhất khi quyền riêng tư dữ liệu là yếu tố quan trọng hoặc khi kết nối Internet không ổn định hay không có. Chạy model trên máy chủ hoặc máy tính để bàn cục bộ giúp bạn kiểm soát hoàn toàn và bảo vệ dữ liệu. Cách này cũng có thể giảm độ trễ nếu máy chủ ở gần người dùng.
Tuy nhiên, việc mở rộng quy mô triển khai cục bộ có thể khó khăn và công tác bảo trì có thể tốn thời gian. Sử dụng các công cụ như Docker để đóng gói container và Kubernetes để quản lý có thể giúp triển khai cục bộ hiệu quả hơn. Cần cập nhật và bảo trì thường xuyên để mọi thứ vận hành trơn tru.
Đóng gói container để đơn giản hóa triển khai#
Đóng gói container đóng gói model cùng tất cả dependency vào một đơn vị tiêu chuẩn gọi là container. Kỹ thuật này đảm bảo hiệu suất nhất quán trong nhiều môi trường khác nhau và đơn giản hóa quá trình triển khai.
Lợi ích của việc dùng Docker để triển khai model#
Docker đã trở thành tiêu chuẩn ngành cho việc đóng gói container trong triển khai machine learning vì một số lý do sau:
- Tính nhất quán của môi trường: Container Docker đóng gói model cùng tất cả dependency, loại bỏ vấn đề "chạy được trên máy của tôi" bằng cách đảm bảo hành vi nhất quán giữa các môi trường phát triển, kiểm thử và production.
- Cách ly: Container cách ly các ứng dụng với nhau, ngăn xung đột giữa các phiên bản phần mềm hoặc thư viện khác nhau.
- Tính di động: Container Docker có thể chạy trên mọi hệ thống hỗ trợ Docker, giúp bạn dễ dàng triển khai model trên nhiều nền tảng mà không cần sửa đổi.
- Khả năng mở rộng: Có thể dễ dàng tăng hoặc giảm quy mô container theo nhu cầu, đồng thời các công cụ điều phối như Kubernetes có thể tự động hóa quy trình này.
- Kiểm soát phiên bản: Có thể quản lý phiên bản image Docker, cho phép bạn theo dõi thay đổi và quay lại phiên bản trước khi cần.
Triển khai YOLO26 bằng Docker#
Để đóng gói model YOLO26 của bạn vào container, bạn có thể tạo Dockerfile chỉ định tất cả dependency và cấu hình cần thiết. Đây là ví dụ cơ bản:
FROM ultralytics/ultralytics:latest

WORKDIR /app

# Copy your model and any additional files
COPY ./models/yolo26n.pt /app/models/
COPY ./scripts /app/scripts/

# Set up any environment variables
ENV MODEL_PATH=/app/models/yolo26n.pt

# Command to run when the container starts
CMD ["python", "/app/scripts/predict.py"]
Phương pháp này đảm bảo quá trình triển khai model có thể tái lập và nhất quán giữa các môi trường phát triển, kiểm thử và production.
Các kỹ thuật tối ưu hóa model#
Tối ưu model thị giác máy tính giúp model chạy hiệu quả, đặc biệt khi triển khai trong môi trường có tài nguyên hạn chế như thiết bị biên. Sau đây là một số kỹ thuật chính để tối ưu model.
Cắt tỉa model#
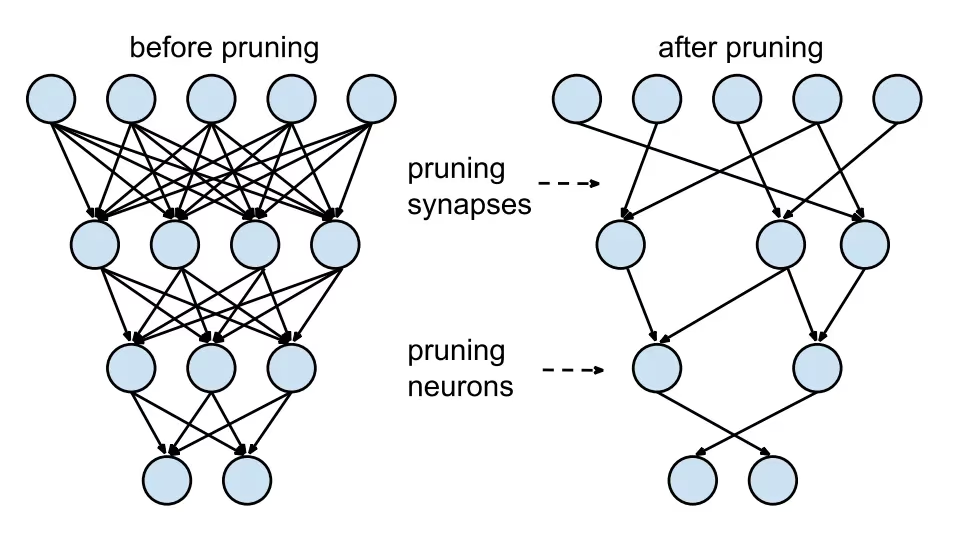
Cắt tỉa làm giảm kích thước model bằng cách loại bỏ các trọng số ít đóng góp vào đầu ra cuối cùng. Phương pháp này giúp model nhỏ hơn và nhanh hơn mà không ảnh hưởng đáng kể đến độ chính xác. Cắt tỉa bao gồm việc xác định và loại bỏ các tham số không cần thiết, tạo ra model gọn nhẹ hơn và cần ít năng lực tính toán hơn. Phương pháp này đặc biệt hữu ích khi triển khai model trên các thiết bị có tài nguyên hạn chế.
Lượng tử hóa model#
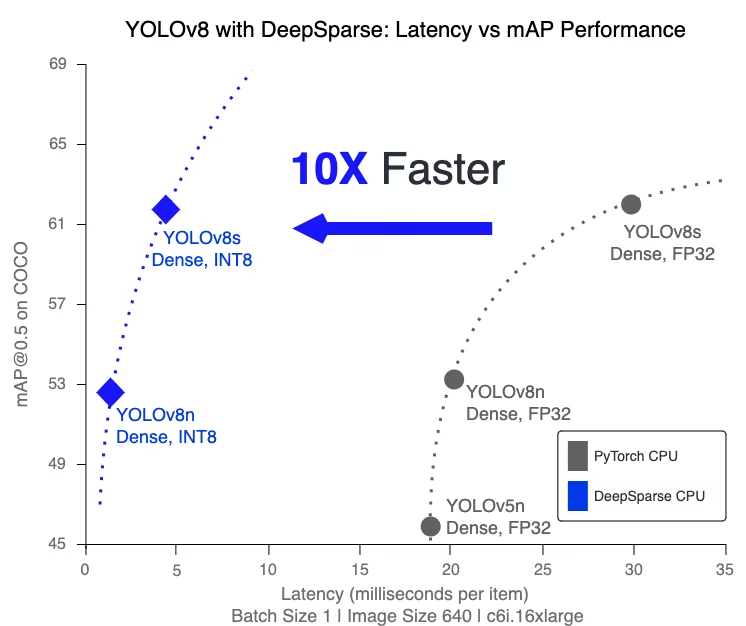
Lượng tử hóa chuyển trọng số và activation của model từ độ chính xác cao (chẳng hạn số thực 32 bit) sang độ chính xác thấp hơn (chẳng hạn số nguyên 8 bit). Bằng cách giảm kích thước model, phương pháp này tăng tốc suy luận. Huấn luyện có nhận biết lượng tử hóa (QAT) là phương pháp huấn luyện model có tính đến lượng tử hóa, giúp bảo toàn độ chính xác tốt hơn so với lượng tử hóa sau huấn luyện. Bằng cách xử lý lượng tử hóa trong giai đoạn huấn luyện, model học cách thích ứng với độ chính xác thấp hơn, duy trì hiệu suất đồng thời giảm nhu cầu tính toán. Trong Ultralytics YOLO, đặt quantize=8 khi export để lượng tử hóa INT8 sau huấn luyện hoặc đặt trong lúc huấn luyện để dùng QAT.
Chưng cất tri thức#
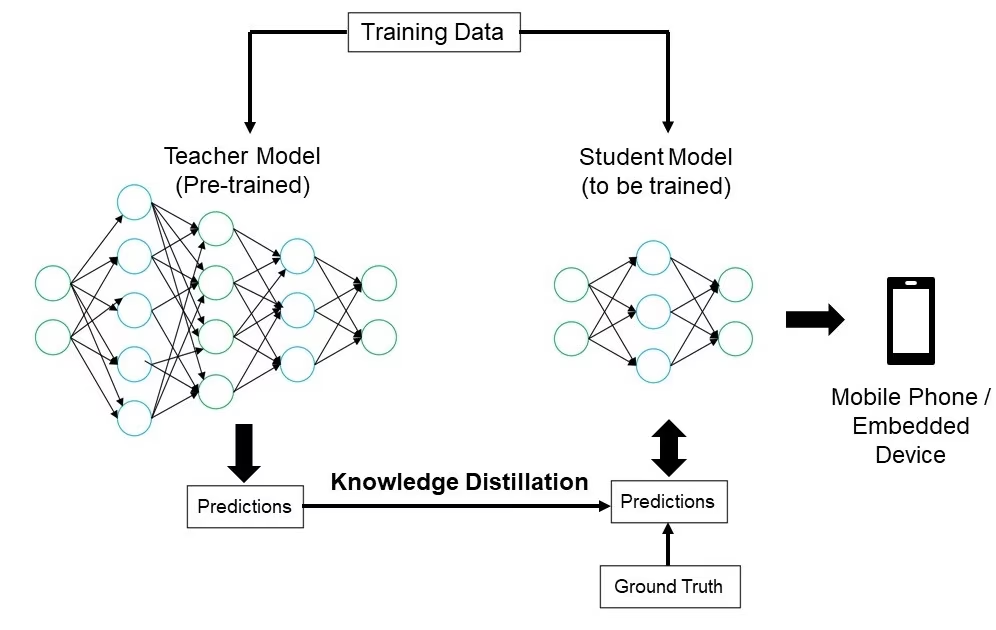
Chưng cất tri thức là quá trình huấn luyện một model nhỏ hơn, đơn giản hơn (model học sinh) để mô phỏng đầu ra của một model lớn hơn, phức tạp hơn (model giáo viên). Model học sinh học cách xấp xỉ các dự đoán của model giáo viên, tạo ra một model gọn nhẹ nhưng vẫn giữ được phần lớn độ chính xác của model giáo viên. Kỹ thuật này hữu ích để tạo ra các model hiệu quả, phù hợp triển khai trên thiết bị biên có tài nguyên hạn chế. Ultralytics YOLO hỗ trợ kỹ thuật này thông qua đối số huấn luyện distill_model.
Khắc phục sự cố triển khai#
Bạn có thể gặp thách thức khi triển khai các model thị giác máy tính, nhưng hiểu rõ những vấn đề thường gặp và giải pháp có thể giúp quá trình này diễn ra suôn sẻ hơn. Sau đây là một số mẹo khắc phục sự cố và thực tiễn tốt nhất để giúp bạn xử lý các vấn đề khi triển khai.
Model của bạn kém chính xác hơn sau khi triển khai#
Độ chính xác của model giảm sau khi triển khai có thể do nhiều yếu tố. Sau đây là một số bước giúp bạn xác định và khắc phục sự cố:
- Kiểm tra tính nhất quán của dữ liệu: Đảm bảo dữ liệu model xử lý sau khi triển khai nhất quán với dữ liệu dùng để huấn luyện model. Sự khác biệt về phân phối, chất lượng hoặc định dạng dữ liệu có thể ảnh hưởng đáng kể đến hiệu suất.
- Xác thực các bước tiền xử lý: Xác minh rằng mọi bước tiền xử lý được áp dụng trong quá trình huấn luyện cũng được áp dụng nhất quán khi triển khai. Những bước này bao gồm thay đổi kích thước ảnh, chuẩn hóa giá trị pixel và các phép biến đổi dữ liệu khác.
- Đánh giá môi trường của model: Bảo đảm cấu hình phần cứng và phần mềm dùng khi triển khai khớp với cấu hình dùng trong quá trình huấn luyện. Khác biệt về thư viện, phiên bản và khả năng phần cứng có thể gây ra sai lệch.
- Giám sát quá trình suy luận của model: Ghi nhật ký đầu vào và đầu ra ở nhiều giai đoạn trong pipeline suy luận để phát hiện bất thường. Việc này có thể giúp xác định các vấn đề như dữ liệu bị hỏng hoặc xử lý đầu ra của model không đúng cách.
- Xem xét việc xuất và chuyển đổi model: Xuất lại model và bảo đảm quá trình chuyển đổi duy trì tính toàn vẹn của trọng số và kiến trúc model.
- Kiểm thử với bộ dữ liệu được kiểm soát: Triển khai model trong môi trường kiểm thử bằng bộ dữ liệu do bạn kiểm soát, rồi so sánh kết quả với giai đoạn huấn luyện. Bạn có thể xác định vấn đề nằm ở môi trường triển khai hay dữ liệu.
Khi triển khai YOLO26, một số yếu tố có thể ảnh hưởng đến độ chính xác của model. Việc chuyển đổi model sang các định dạng như TensorRT bao gồm các bước tối ưu như lượng tử hóa trọng số và hợp nhất layer, có thể gây ra sai số nhỏ về độ chính xác. Dùng FP16 (độ chính xác bán phần) thay vì FP32 (độ chính xác đầy đủ) có thể tăng tốc suy luận nhưng cũng có thể gây ra sai số số học. Ngoài ra, giới hạn phần cứng, chẳng hạn như trên Jetson Nano, với số lượng nhân CUDA ít hơn và băng thông bộ nhớ thấp hơn, có thể ảnh hưởng đến hiệu suất.
Quá trình suy luận mất nhiều thời gian hơn dự kiến#
Khi triển khai các model machine learning, điều quan trọng là chúng phải chạy hiệu quả. Nếu quá trình suy luận mất nhiều thời gian hơn dự kiến, trải nghiệm người dùng và hiệu quả của ứng dụng có thể bị ảnh hưởng. Sau đây là một số bước giúp bạn xác định và giải quyết vấn đề:
- Thực hiện các lượt chạy khởi động: Các lượt chạy ban đầu thường bao gồm chi phí thiết lập, có thể làm sai lệch phép đo độ trễ. Hãy thực hiện một vài lượt suy luận khởi động trước khi đo độ trễ. Loại trừ các lượt chạy ban đầu này giúp đo lường hiệu năng của model chính xác hơn.
- Tối ưu hóa engine suy luận: Kiểm tra kỹ để bảo đảm engine suy luận được tối ưu hóa hoàn toàn cho kiến trúc GPU cụ thể của bạn. Sử dụng driver và phiên bản phần mềm mới nhất phù hợp với phần cứng để bảo đảm hiệu năng và khả năng tương thích tối đa.
- Sử dụng xử lý bất đồng bộ: Xử lý bất đồng bộ có thể giúp quản lý workload hiệu quả hơn. Sử dụng các kỹ thuật xử lý bất đồng bộ để xử lý nhiều tác vụ suy luận đồng thời, qua đó phân bổ tải và giảm thời gian chờ.
- Phân tích hiệu năng pipeline suy luận: Xác định các nút thắt trong pipeline suy luận có thể giúp tìm ra nguyên nhân gây chậm trễ. Sử dụng công cụ profiling để phân tích từng bước trong quy trình suy luận, xác định và xử lý mọi giai đoạn gây chậm trễ đáng kể, chẳng hạn như layer hoạt động kém hiệu quả hoặc vấn đề truyền dữ liệu.
- Dùng độ chính xác phù hợp: Dùng độ chính xác cao hơn mức cần thiết có thể làm chậm thời gian suy luận. Hãy thử dùng độ chính xác thấp hơn, chẳng hạn FP16 (
quantize=16khi export), thay vì FP32 (độ chính xác đầy đủ). FP16 có thể giảm thời gian suy luận, nhưng cũng cần lưu ý rằng độ chính xác của model có thể bị ảnh hưởng.
Nếu gặp vấn đề này khi triển khai YOLO26, hãy cân nhắc rằng YOLO26 có nhiều kích thước model, chẳng hạn YOLO26n (nano) dành cho thiết bị có dung lượng bộ nhớ thấp hơn và YOLO26x (cực lớn) dành cho GPU mạnh hơn. Chọn biến thể model phù hợp với phần cứng có thể giúp cân bằng mức sử dụng bộ nhớ và thời gian xử lý.
Ngoài ra, hãy lưu ý rằng kích thước ảnh đầu vào ảnh hưởng trực tiếp đến mức sử dụng bộ nhớ và thời gian xử lý. Độ phân giải thấp hơn giúp giảm mức sử dụng bộ nhớ và tăng tốc suy luận, trong khi độ phân giải cao hơn cải thiện độ chính xác nhưng đòi hỏi nhiều bộ nhớ và năng lực xử lý hơn.
Các cân nhắc về bảo mật khi triển khai model#
Một khía cạnh quan trọng khác của việc triển khai là bảo mật. Bảo vệ các model đã triển khai là yếu tố thiết yếu để bảo vệ dữ liệu nhạy cảm và tài sản trí tuệ. Sau đây là một số thực tiễn tốt nhất bạn có thể áp dụng để triển khai model an toàn.
Truyền dữ liệu an toàn#
Bảo vệ dữ liệu được gửi giữa client và server là điều cần thiết để ngăn dữ liệu bị chặn bắt hoặc truy cập trái phép. Bạn có thể dùng các giao thức mã hóa như TLS (Bảo mật tầng truyền tải) để mã hóa dữ liệu trong quá trình truyền. Ngay cả khi có người chặn bắt dữ liệu, họ cũng không thể đọc được. Bạn cũng có thể dùng mã hóa đầu cuối để bảo vệ dữ liệu từ nguồn đến đích, ngăn mọi bên trung gian truy cập dữ liệu.
Kiểm soát truy cập#
Việc kiểm soát ai có thể truy cập model và dữ liệu của model là thiết yếu để ngăn chặn việc sử dụng trái phép. Sử dụng các phương thức xác thực mạnh để xác minh danh tính của người dùng hoặc hệ thống đang cố truy cập model, đồng thời cân nhắc bổ sung lớp bảo mật bằng xác thực đa yếu tố (MFA). Thiết lập kiểm soát truy cập dựa trên vai trò (RBAC) để cấp quyền theo vai trò người dùng, nhờ đó mọi người chỉ có quyền truy cập vào những gì họ cần. Duy trì nhật ký kiểm tra chi tiết để theo dõi mọi lượt truy cập và thay đổi đối với model và dữ liệu của model, đồng thời thường xuyên xem lại các nhật ký này để phát hiện hoạt động đáng ngờ.
Làm rối model#
Bạn có thể bảo vệ model khỏi việc bị thiết kế ngược hoặc sử dụng sai mục đích bằng cách làm rối model. Phương pháp này bao gồm mã hóa các tham số của model, chẳng hạn như trọng số và bias trong mạng nơ-ron, để khiến những người không được phép khó hiểu hoặc thay đổi model. Bạn cũng có thể làm rối kiến trúc model bằng cách đổi tên layer và tham số hoặc thêm layer giả, khiến kẻ tấn công khó thiết kế ngược model hơn. Phục vụ model trong một môi trường an toàn, chẳng hạn như vùng bảo mật hoặc môi trường thực thi đáng tin cậy (TEE), cũng có thể tạo thêm một lớp bảo vệ trong quá trình suy luận.
Kết luận và các bước tiếp theo#
Chúng ta đã điểm qua một số thực tiễn tốt nhất cần tuân theo khi triển khai model thị giác máy tính. Bằng cách bảo mật dữ liệu, kiểm soát quyền truy cập và làm rối thông tin chi tiết của model, bạn có thể bảo vệ thông tin nhạy cảm đồng thời duy trì hoạt động ổn định của các model. Chúng ta cũng đã thảo luận cách xử lý các vấn đề thường gặp như giảm độ chính xác và suy luận chậm bằng các chiến lược như chạy khởi động, tối ưu hóa engine, xử lý bất đồng bộ, profiling pipeline và chọn độ chính xác phù hợp.
Sau khi triển khai model, bước tiếp theo là giám sát, bảo trì và lập tài liệu cho ứng dụng. Giám sát thường xuyên giúp nhanh chóng phát hiện và khắc phục sự cố, bảo trì giúp các model luôn được cập nhật và hoạt động ổn định, còn tài liệu đầy đủ ghi lại mọi thay đổi và bản cập nhật. Những bước này sẽ giúp bạn đạt được mục tiêu của dự án thị giác máy tính.
Câu hỏi thường gặp#
Việc triển khai model machine learning, đặc biệt là với Ultralytics YOLO26, cần tuân theo một số thực tiễn tốt nhất để bảo đảm hiệu quả và độ tin cậy. Trước tiên, hãy chọn môi trường triển khai phù hợp với nhu cầu của bạn — cloud, edge hoặc cục bộ. Tối ưu hóa model bằng các kỹ thuật như cắt tỉa, lượng tử hóa và chưng cất tri thức để triển khai hiệu quả trong môi trường có tài nguyên hạn chế. Cân nhắc sử dụng đóng gói bằng Docker để bảo đảm tính nhất quán giữa các môi trường. Cuối cùng, hãy bảo đảm tính nhất quán của dữ liệu và các bước tiền xử lý phù hợp với giai đoạn huấn luyện để duy trì hiệu năng. Bạn cũng có thể tham khảo các tùy chọn triển khai model để xem hướng dẫn chi tiết hơn.
Có thể chia quy trình khắc phục sự cố triển khai thành một vài bước chính. Nếu độ chính xác của model giảm sau khi triển khai, hãy kiểm tra tính nhất quán của dữ liệu, xác thực các bước tiền xử lý và bảo đảm môi trường phần cứng/phần mềm khớp với môi trường dùng trong quá trình huấn luyện. Nếu thời gian suy luận chậm, hãy thực hiện các lượt chạy khởi động, tối ưu hóa engine suy luận, sử dụng xử lý bất đồng bộ và phân tích hiệu năng pipeline suy luận. Tham khảo hướng dẫn khắc phục sự cố triển khai để xem hướng dẫn chi tiết về các thực tiễn tốt nhất này.
Tối ưu hóa model Ultralytics YOLO26 cho thiết bị edge bao gồm các kỹ thuật như cắt tỉa để giảm kích thước model, lượng tử hóa để chuyển trọng số sang độ chính xác thấp hơn và chưng cất tri thức để huấn luyện model nhỏ hơn bắt chước model lớn hơn. Những kỹ thuật này giúp model chạy hiệu quả trên các thiết bị có năng lực tính toán hạn chế. Các công cụ như LiteRT và NVIDIA Jetson đặc biệt hữu ích cho những hoạt động tối ưu hóa này. Tìm hiểu thêm về các kỹ thuật này trong phần tối ưu hóa model của chúng tôi.
Bảo mật là yếu tố tối quan trọng khi triển khai model machine learning. Bảo đảm truyền dữ liệu an toàn bằng các giao thức mã hóa như TLS. Triển khai các biện pháp kiểm soát truy cập mạnh mẽ, bao gồm xác thực mạnh và kiểm soát truy cập dựa trên vai trò (RBAC). Các kỹ thuật làm rối model, chẳng hạn như mã hóa tham số model và phục vụ model trong môi trường an toàn như môi trường thực thi đáng tin cậy (TEE), mang lại khả năng bảo vệ bổ sung. Để xem các thực tiễn chi tiết, hãy tham khảo các cân nhắc về bảo mật.
Việc chọn môi trường triển khai tối ưu cho model Ultralytics YOLO26 phụ thuộc vào nhu cầu cụ thể của ứng dụng. Triển khai trên cloud mang lại khả năng mở rộng và dễ truy cập, phù hợp với các ứng dụng có khối lượng dữ liệu lớn. Triển khai trên edge phù hợp nhất với các ứng dụng có độ trễ thấp cần phản hồi theo thời gian thực, sử dụng các công cụ như LiteRT. Triển khai cục bộ phù hợp với các tình huống cần quyền riêng tư và khả năng kiểm soát dữ liệu nghiêm ngặt. Để có cái nhìn tổng quan đầy đủ về từng môi trường, hãy xem phần chọn môi trường triển khai của chúng tôi.


Bình luận10
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.
 TaoBenHui
shafa~hahaha
Taufiq-Ahmed
Hi, I Have trained my custom dataset on yolov8s model. Now I want to optimized the model by using pruning and quantization. could you please tell me How I can implement it and what is the python code of it?
 Paula DerrengerUltralytics
@Taufiq-Ahmed to optimize your YOLOv8 model using pruning and quantization, you can follow these steps:
-
Pruning: This involves removing weights that contribute little to the final output, making the model smaller and faster. You can use libraries like TensorFlow Model Optimization Toolkit or PyTorch's pruning methods.
-
Quantization: This converts the model's weights and activations from high precision (e.g., 32-bit floats) to lower precision (e.g., 8-bit integers), reducing model size and speeding up inference. You can use TensorFlow Lite for post-training quantization or PyTorch's quantization tools.
For detailed guidance and code examples, please refer to the Ultralytics documentation on model optimization. This resource provides comprehensive instructions and best practices for deploying and optimizing your models effectively.
-
Thank you so much for your reply. One think I would like to know, is it possible to do pruning and quantization in my YOLOv8 best.pt model with TensorFlow Model Optimization Toolkit or PyTorch's pruning methods. Do do I need to convert it and also need to convert my dataset from YOLO format to any other format?
- Paula DerrengerUltralytics
Yes, you can perform pruning and quantization on your YOLOv8 model using TensorFlow Model Optimization Toolkit or PyTorch's pruning methods. You don't need to convert your dataset format, but you may need to convert your model to a compatible format like ONNX if using TensorFlow tools. For PyTorch, you can directly apply pruning and quantization techniques. For detailed steps, please refer to the Ultralytics documentation on model deployment practices.
Thank you for your reply. could you please give me any git hub repositories or any coding example on how to apply pruning and quantization techniques on the best.pt model on custom dataset. and how will i maintain the accuracy of the model.
- Paula DerrengerUltralytics
@Taufiq-Ahmed for pruning and quantization of your YOLOv8 model, you can use PyTorch's built-in functionalities. You don't need to convert your dataset format. For pruning, you can use
torch.nn.utils.prune, and for quantization, you can usetorch.quantization. If you need specific code examples, please let me know. For more detailed guidance, you can refer to the Ultralytics documentation on model deployment practices. Thank you for your reply. it would be better for me if you share a coding example of how to prune and quantize the model on the custom data to reduce it's size and weights using pytorch and how to ´maintain it's accuracy. do I need to train it again or there is some other way to maintain it's accuracy.
Hi could you please check whether this idea works:
import torch import torch.nn as nn from torch.nn.utils import prune from ultralytics import YOLO
model = YOLO('best.pt')
def gradual_prune_model(model, prune_step=0.05, prune_iterations=10): for i in range(prune_iterations):
    for name, module in model.model.named_modules():
        if isinstance(module, nn.Conv2d):
            prune.l1_unstructured(module, name='weight', amount=prune_step)
            prune.remove(module, 'weight')  # Remove pruning reparameterization

    print(f'Fine-tuning after pruning iteration {i+1}/{prune_iterations}')
    model.train(data='dataset.yaml', epochs=2, lr=1e-4)
gradual_prune_model(model, prune_step=0.05, prune_iterations=10)
print('Final fine-tuning after pruning') model.train(data='/path/to/your/dataset.yaml', epochs=10, lr=1e-5)
model.save('pruned_yolov8.pt')
is this pruned technique works? and after pruning is this the right way to regain it's accuracy?
- Paula DerrengerUltralytics
Your approach to pruning looks good. Gradual pruning followed by fine-tuning can help maintain accuracy. After pruning, fine-tuning with a lower learning rate is essential to regain any lost accuracy. For quantization, you can use PyTorch's quantization tools. Ensure you validate the model's performance after each step. For more detailed guidance, refer to the Ultralytics documentation on model deployment practices.