标注后的计算机视觉数据预处理技术#
数据预处理会将原始的已标注图像转换为干净且一致的输入,让计算机视觉模型能够良好训练。使用 Ultralytics YOLO26 时,核心像素操作——RGB 转换、缩放到 [0, 1] 以及调整大小——会在训练流程中自动完成,因此剩下的工作是正确划分数据集、平衡类别并选择增强方式。本指南介绍这些关键技术:调整大小、归一化、数据集划分、数据增强和探索性数据分析(EDA)。
观看: 如何利用数据预处理和增强提升模型在真实场景中的准确率 🚀
这一步在明确项目目标以及收集并标注数据之后进行,是计算机视觉项目工作流程的早期环节。
预处理为何重要#
预处理会将数据转换为合适的格式,从而降低计算负载并提升模型性能。它可以解决原始数据中的三个常见问题:
- 噪声:数据中无关或随机的变化。
- 不一致性:图像尺寸、格式和质量存在差异。
- 类别不平衡:数据集中各类别或类别组的分布不均。
预处理技术#
主要技术包括调整大小、归一化、数据集划分和数据增强。使用 YOLO26 时,前两项会自动完成,而数据集划分和数据增强最需要你做出选择。
调整图像大小#
许多模型要求输入尺寸一致,因此调整大小可以统一图像尺寸并降低计算复杂度。常用的插值方法有两种:
- 双线性插值:对最近的四个像素进行加权平均,以平滑像素值。
- 最近邻插值:直接复制最近像素的值,不进行平均——速度更快,但图像会显得更粗糙。
OpenCV 和 PIL (Pillow) 等库提供这些功能,但使用 YOLO26 时,通常不需要手动调整图像大小。imgsz 参数会处理这项工作。在固定尺寸的正方形路径中,验证和推理会将图像填充调整至 imgsz × imgsz 输入尺寸(例如 640 × 640),同时保持宽高比并填充灰色(值为 114)。较大的图像会缩小以适应尺寸;禁用放大时,较小的图像不会放大。在默认的训练路径中,mosaic=1.0 会将四张图像拼接到较大的画布上,再裁剪回 imgsz;当 close_mosaic 在最后几个 epoch 禁用马赛克增强后,图像会进行填充调整并继续接受随机变换,而不是原样输入。矩形批次(rect=True)和 multi_scale 使用不同的输入形状。
归一化像素值#
归一化会将像素值缩放到标准范围,有助于模型在训练期间更快收敛。常见的方法有两种:
- 最小-最大缩放:将像素值缩放到 0 到 1 的范围。
- Z 分数归一化:根据均值和标准差缩放像素值。
YOLO26 会在预处理流程中自动进行归一化:它会将图像转换为 RGB,并通过除以 255 将像素值缩放到 [0, 1] 范围(最小-最大缩放)。默认情况下,YOLO 不会应用 ImageNet 风格的均值/标准差(Z 分数)归一化,因此无需手动执行归一化。
划分数据集#
将数据划分为训练集、验证集和测试集,可以用未见过的数据评估模型并衡量其泛化能力。常见的划分比例是训练集 70%、验证集 20%、测试集 10%。使用 scikit-learn 或 TensorFlow 等工具就能轻松完成划分。
划分数据时,请牢记以下几点:
- 保持类别分布:确保每个类别在训练集、验证集和测试集中都按比例分布。
- 平衡类别:对于类别不平衡的数据集,可以考虑对少数类过采样,或对多数类欠采样——但仅限训练集。
在应用任何数据增强或其他预处理之前,先划分数据集,并且只对训练集应用这些变换。在划分之前进行数据增强,会让验证集或测试集图像的信息影响训练,导致分数虚高,而模型在真实数据上的表现却会大幅下降。
扩充数据集#
数据增强通过生成现有图像的变体,人为扩充数据集。过拟合并提升泛化能力,并带来多项好处:它有助于减少
- 模型更稳健:改变光照、方向和尺度,可以增强模型应对真实场景失真的能力。
- 经济高效:无需收集和标注新数据,就能扩充训练集。
- 更充分地利用数据:每张已标注图像都可以生成多个训练变体。
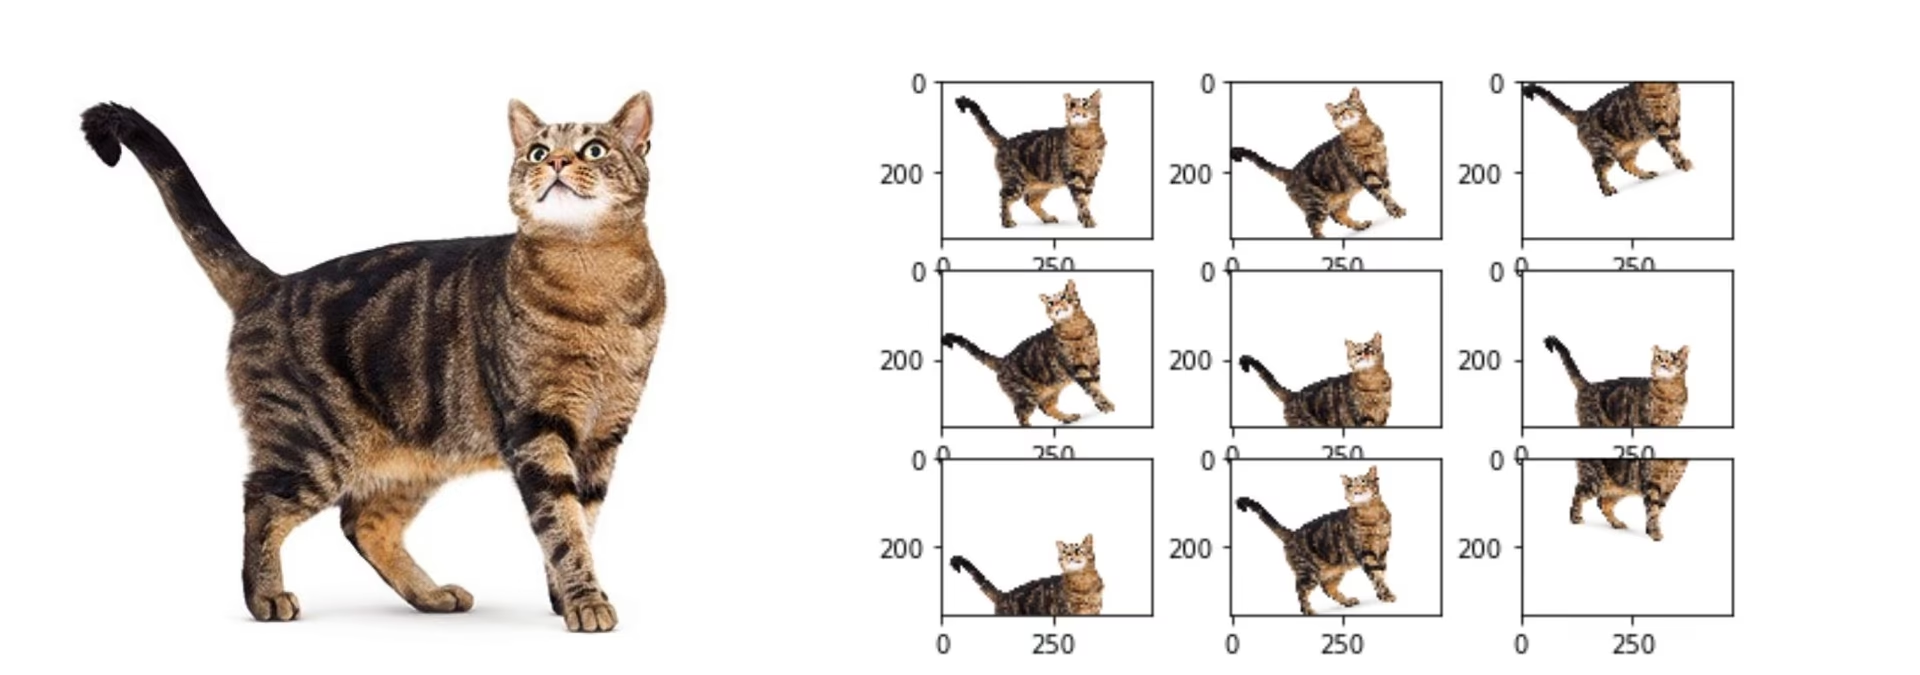
使用 YOLO26 时,通过传递给 model.train() 的训练参数或相应 CLI 标志来控制数据增强强度,而不是编辑数据集 YAML;数据集 YAML 用于定义路径、类别名称和划分等数据集元数据。唯一的例外是 flip_idx:姿态数据集会在数据集 YAML 中声明该键,用于映射左右关键点对;如果缺少该键,YOLO 会完全禁用 fliplr 和 flipud。内置增强包括:
- Mosaic、MixUp 和 CutMix(
mosaic、mixup、cutmix):将多张图像合并为一个训练样本。 - 翻转(
fliplr、flipud):水平或垂直镜像翻转图像。 - 几何变换(
degrees、translate、scale、shear、perspective):旋转、平移、缩放和扭曲图像。 - HSV 颜色抖动(
hsv_h、hsv_s、hsv_v):改变色相、饱和度和亮度。 - 复制粘贴(
copy_paste):粘贴分割对象的额外副本;默认在同一图像中镜像复制,也可以使用copy_paste_mode=mixup从另一张图像中复制。 - 通道交换(
bgr):将 RGB 通道顺序交换为 BGR。 - 分类变换(
auto_augment、erasing):训练分类器时,应用自动增强策略和随机擦除。
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# 数据增强通过训练参数配置,而不是通过数据集 YAML 配置
model.train(data="coco8.yaml", epochs=10, hsv_h=0.015, fliplr=0.5, mosaic=1.0, degrees=10.0)如需查看完整的数据增强参数列表及默认值,请参阅增强设置参考文档和专门的 YOLO 数据增强指南。如果已安装 albumentations 包,YOLO 也会自动启用其内置的、基于 Albumentations 的增强功能。
案例研究:车辆检测的预处理#
假设你要使用 YOLO26 检测并分类交通图像中的车辆,输入图像已标注边界框和标签。以下是各项预处理决策的具体做法:
- 调整大小:无需手动操作——YOLO26 会在训练期间将图像调整为
imgsz。 - 归一化:无需手动操作——YOLO26 会自动将像素值缩放到
[0, 1]。 - 划分数据集:将数据集划分为训练集 70%、验证集 20% 和测试集 10%,并保持各划分中的类别分布一致。
- 数据增强:设置适合交通场景的训练参数——例如,使用
fliplr实现方向不变性,使用hsv_v适应昼夜光照变化,使用mosaic适应不同的对象密度。
完成这些决策后,数据集就可以进行探索性数据分析(EDA)了。
探索性数据分析(EDA)#
EDA 利用统计数据和可视化来揭示数据中的模式和分布,帮助你在训练前发现类别不平衡或离群值等问题。
统计 EDA 技术#
统计 EDA 从均值、中位数、标准差和范围等基本指标入手,并对像素强度分布等属性进行计算。这些指标可以快速概览数据集的质量,并及早揭示异常。
可视化 EDA 技术#
可视化可以揭示汇总统计数据无法体现的模式,例如类别不平衡和离群值。常用工具包括:
- 直方图和箱线图:显示像素值分布,并标出强度或特征分布中的离群值。
- 条形图:比较各类别的样本数量,揭示类别不平衡。
- 散点图:探索图像特征或标注之间的关系。
- 热力图:展示像素强度分布,或标注在图像中的空间分布。
使用 Ultralytics Platform 进行 EDA#
如需无需编写代码即可进行 EDA,请将数据集上传到 Ultralytics Platform。数据集的 Charts 选项卡会自动生成关键的 EDA 可视化图表:数据划分分布、样本数量最多的类别、图像宽度/高度直方图,以及标注位置和图像尺寸的二维热力图。通过 Images 选项卡,你可以使用标注叠加层,以网格、紧凑或表格视图浏览数据,轻松发现标注错误的样本或类别不平衡问题,无需编写任何代码。
结论#
正确划分、归一化和增强数据可以减少噪声并提升泛化能力,将原始图像集合转变为可靠的训练集。完成数据集预处理后,下一步是训练模型。如果过程中遇到问题,可以在 Ultralytics GitHub 仓库或 Ultralytics Discord 服务器向社区提问。
常见问题#
预处理可以确保数据干净、一致,并采用适合训练的格式。通过解决原始数据中的噪声、不一致性和类别不平衡,调整大小、归一化、数据增强和数据集划分等步骤可以降低计算负载并提升模型性能。查看计算机视觉项目步骤,了解预处理如何融入整体工作流程。
通过训练参数配置数据增强,而不是编辑数据集 YAML。将
fliplr、mosaic、hsv_h和degrees等参数传递给model.train()(或使用相应的 CLI 标志),以设置每种变换的概率和强度。这些参数列在增强设置中,并在 YOLO 数据增强指南中有详细说明。姿态数据集是个例外:其flip_idx关键点映射保存在数据集 YAML 中,缺少该映射时会禁用翻转。最常见的两种技术是最小-最大缩放(将像素值重新缩放到 0 到 1 的范围)和 Z 分数归一化(根据均值和标准差重新缩放)。YOLO26 会自动执行最小-最大缩放——将图像转换为 RGB 并将像素值除以 255——因此你无需手动归一化。默认情况下,它不会应用 Z 分数归一化。
常见做法是划分为训练集 70%、验证集 20% 和测试集 10%。确保这三个划分中的类别分布保持一致,并在划分后只对训练集应用数据增强,以避免数据泄漏。使用 scikit-learn 或 TensorFlow 等工具可以高效完成划分。查看数据收集与标注指南,了解前期的数据集准备工作。
可以。
imgsz参数用于控制目标输入尺寸,无需手动操作。在固定尺寸的正方形路径中,验证和推理会在保持宽高比的同时,将图像填充调整到指定形状;较大的图像会缩小以适应尺寸,而禁用放大时较小的图像不会放大。训练期间,默认的马赛克增强会通过拼接四张图像并裁剪来达到目标尺寸。矩形批次(rect=True)和multi_scale使用不同的输入形状。详情请参阅模型训练文档。