了解计算机视觉项目的关键步骤
构建计算机视觉项目意味着要按明确的流程逐步推进:设定目标、收集和标注数据、训练和评估模型,然后将模型部署到生产环境并进行维护。本指南将按顺序介绍每个步骤及其重要性,帮助你自信地规划和执行自己的项目。
计算机视觉是人工智能(AI)的一个分支,旨在帮助计算机像人类一样观察和理解世界。它通过处理和分析图像或视频来提取信息、识别模式,并根据数据做出决策。
观看: 如何开展计算机视觉项目 | 分步指南
目标检测、图像分类和实例分割等计算机视觉技术可应用于多个行业,从自动驾驶到医学影像,帮助人们获得有价值的洞察。
计算机视觉项目概览#
在详细讨论计算机视觉项目涉及的每个步骤之前,先来看看整体流程。如果你今天开始一个计算机视觉项目,需要完成以下步骤:
- 你的首要任务是了解项目需求。
- 然后,收集图像并准确标注,为模型训练做好准备。
- 接下来,清理并增强数据,为模型训练做好准备。
- 完成训练后,全面评估并测试模型,确保模型在不同条件下都能稳定运行。
- 最后,将模型部署到实际环境中,并根据新的见解和反馈对模型进行监控和维护。
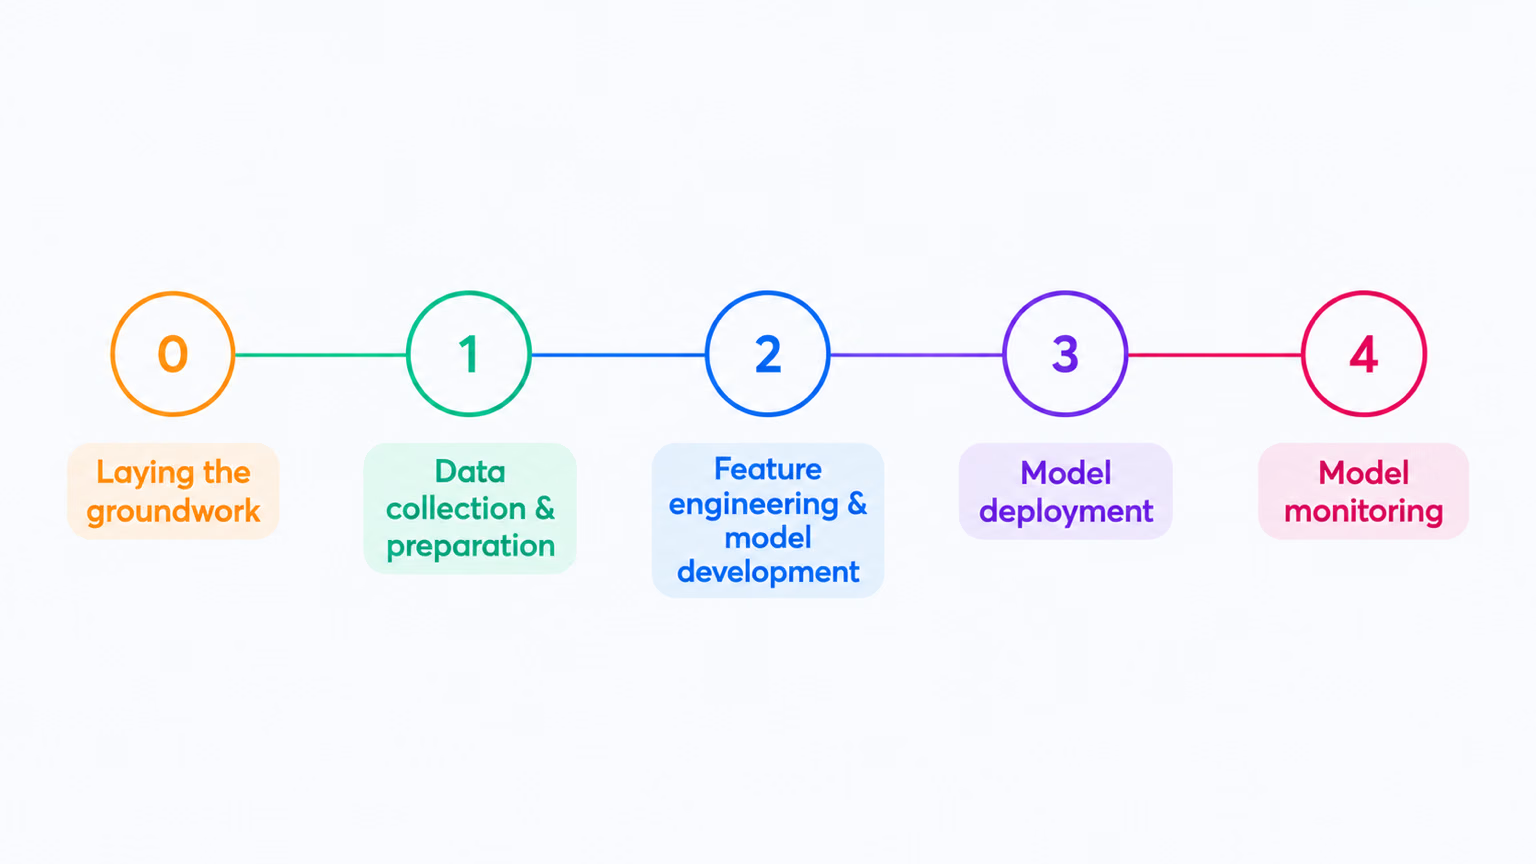
现在你已经了解了需要做什么,下面各部分将详细介绍每个步骤。
步骤 1:明确项目目标#
任何计算机视觉项目的第一步,都是明确你要解决的问题。了解最终目标有助于你着手构建解决方案。对于计算机视觉项目尤其如此,因为项目目标会直接影响你需要重点关注的计算机视觉任务。
以下是一些项目目标及其对应的计算机视觉任务示例:
-
目标:开发一个系统,用于监控和管理高速公路上不同类型车辆的通行情况,从而改善交通管理和安全。
- 计算机视觉任务:目标检测非常适合交通监控,因为它能够高效定位和识别多辆车。与图像分割相比,目标检测的计算需求更低;图像分割会为此任务提供不必要的细节。使用目标检测可确保分析速度更快,并支持实时分析。
-
目标:开发一种工具,通过在医学影像扫描中提供肿瘤的精确像素级轮廓,协助放射科医生。
- 计算机视觉任务:图像分割适用于医学影像,因为它能精确、详细地勾勒肿瘤边界,这对于评估肿瘤大小和形状以及制定治疗方案至关重要。
-
目标:创建一个数字化系统,对各类文档(例如发票、收据、法律文件)进行分类,以提高组织效率并便于检索文档。
- 计算机视觉任务:图像分类非常适合这种场景,因为它一次处理一份文档,无需考虑文档在图像中的位置。这种方法能简化并加快分类流程。
选择合适的模型和训练方法#
了解项目目标和适用的计算机视觉任务后,定义项目目标的关键环节之一就是选择合适的模型和训练方法。
根据目标,你可以先选择模型,也可以在第 2 步了解能够收集到哪些数据后再选择。例如,假设你的项目高度依赖特定类型数据的可用性。在这种情况下,先收集和分析数据,再选择模型可能更实际。另一方面,如果你清楚地了解模型需求,也可以先选择模型,然后收集符合这些规格的数据。
选择从头开始训练还是使用迁移学习,会影响数据准备方式。从头开始训练需要多样化的数据集,以便从零开始构建模型的认知能力。而迁移学习则允许你使用预训练模型,并用规模较小、更具针对性的数据集对其进行适配。此外,选择具体的训练模型后,你需要根据模型的特定要求准备数据,例如调整图像尺寸或添加标注。
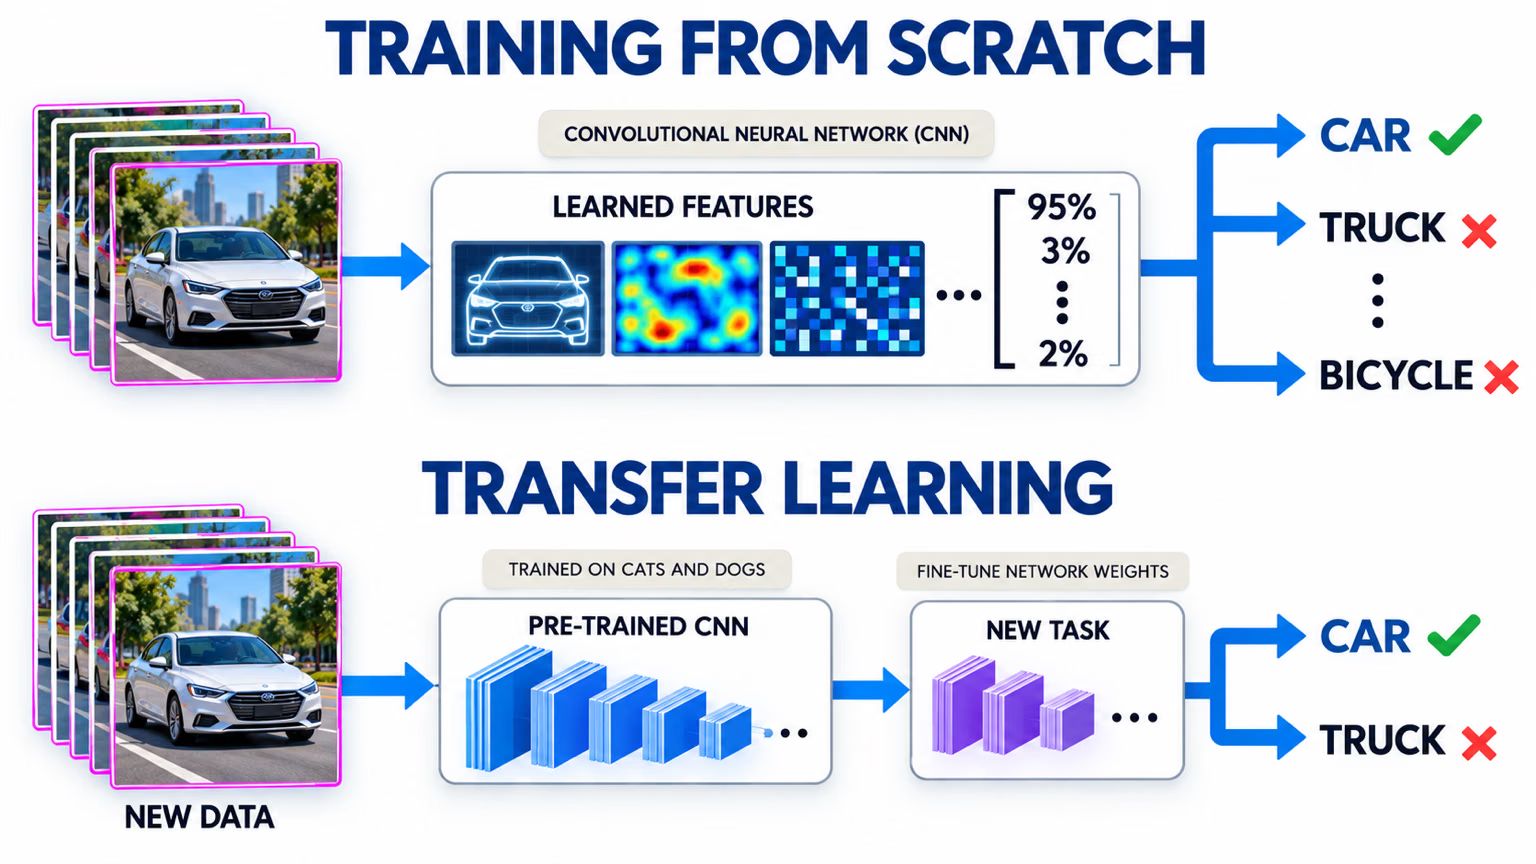
如需了解详情,请阅读我们的定义项目目标并选择合适模型指南。
在开始计算机视觉项目的实践工作之前,务必清楚了解这些细节。进入第 2 步之前,请再次确认你已考虑以下事项:
- 明确界定你要解决的问题。
- 确定项目的最终目标。
- 确定所需的具体计算机视觉任务(例如目标检测、图像分类、图像分割)。
- 决定从头开始训练模型,还是使用迁移学习。
- 根据任务和部署需求选择合适的模型。
第 2 步:数据收集与数据标注#
计算机视觉模型的质量取决于数据集的质量。你可以从互联网收集图像、自行拍摄照片,或使用现有数据集。常见的公开数据集来源包括 Google Dataset Search Engine、UC Irvine Machine Learning Repository 和 Kaggle Datasets。
一些库(例如 Ultralytics)内置了对各种数据集的支持,让你更容易开始使用高质量数据。这些库通常包含下载和加载热门数据集的工具,可在项目初期为你节省大量时间和精力。
不过,如果你选择自行收集图像或拍摄照片,就需要标注数据。数据标注是为数据添加标签、向模型传授信息的过程。你使用的标注类型取决于具体的计算机视觉技术。以下是一些示例:
- 图像分类:你需要将整张图像标记为一个类别。
- 目标检测:你需要在图像中的每个目标周围绘制边界框,并为每个框添加标签。
- 图像分割:你需要根据每个像素所属的目标为图像中的像素添加标签,从而生成详细的目标边界。
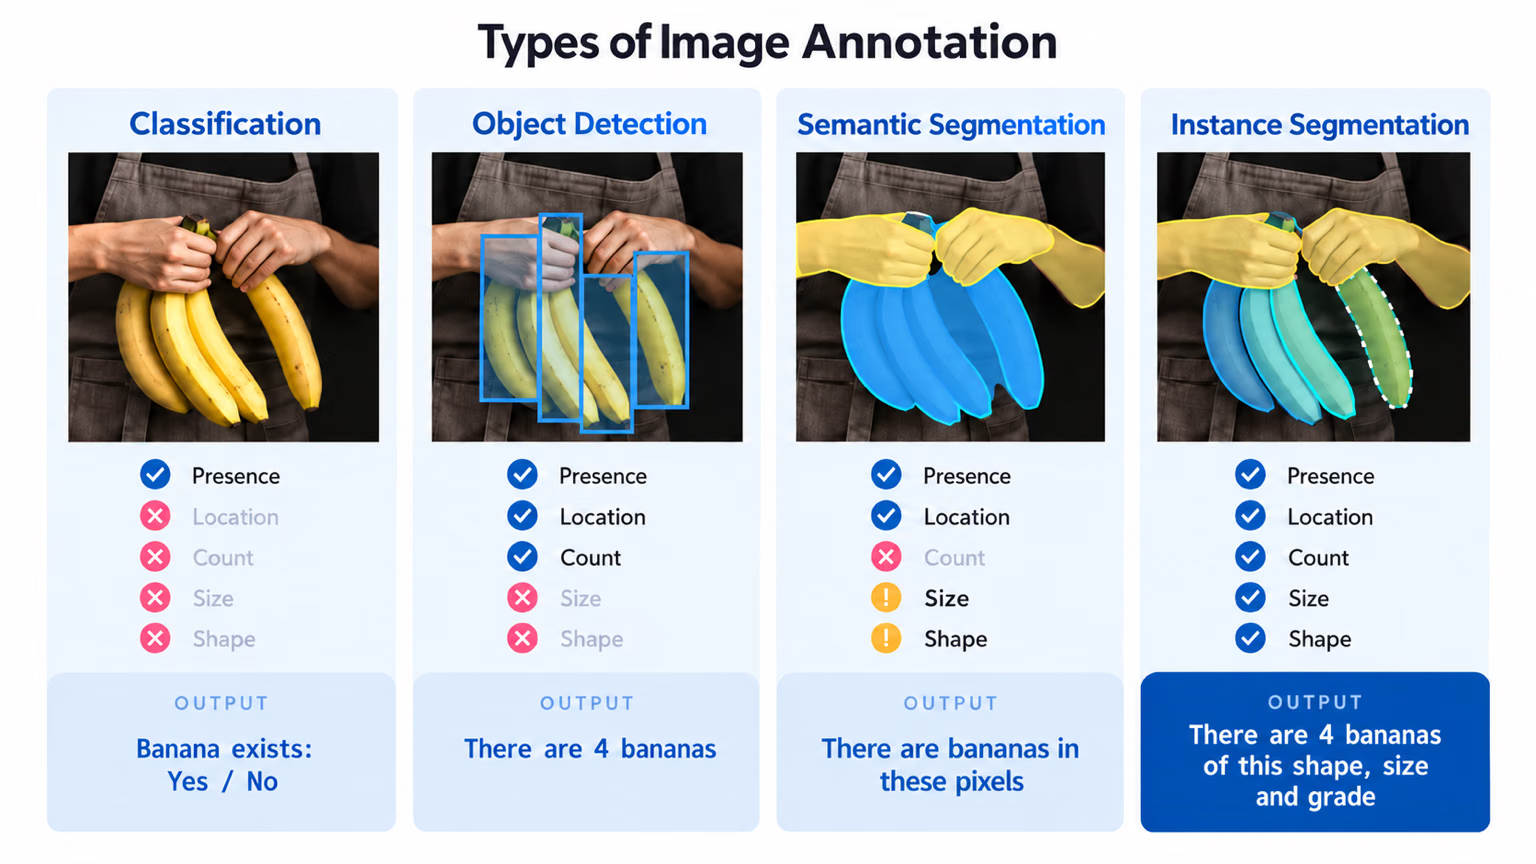
数据收集和标注可能是一项耗时的手动工作。专用标注工具能加快这一流程:Ultralytics Platform提供内置的标注编辑器,支持由 SAM 驱动的智能标注,可用于检测、分割和 OBB 数据,并将标签直接保存为 YOLO 格式。
第 3 步:数据增强与数据集划分#
收集并标注图像数据后,务必先将数据集划分为训练集、验证集和测试集,再进行数据增强。在增强前划分数据集,对于使用原始、未经修改的数据测试和验证模型至关重要。这有助于准确评估模型对新数据和未见数据的泛化能力。
以下是划分数据的方法:
- 训练集:占数据集的最大部分,通常为总数据量的 70-80%,用于训练模型。
- 验证集:通常约占数据的 10-15%;用于调整超参数并在训练期间验证模型,有助于防止过拟合。
- 测试集:剩余的 10-15% 数据留作测试集。在训练完成后,用它评估模型在未见数据上的性能。
划分数据后,你可以通过旋转、缩放和翻转图像等变换进行数据增强,从而人为扩大数据集规模。数据增强能提高模型对各种变化的适应能力,并改善模型在未见图像上的表现。
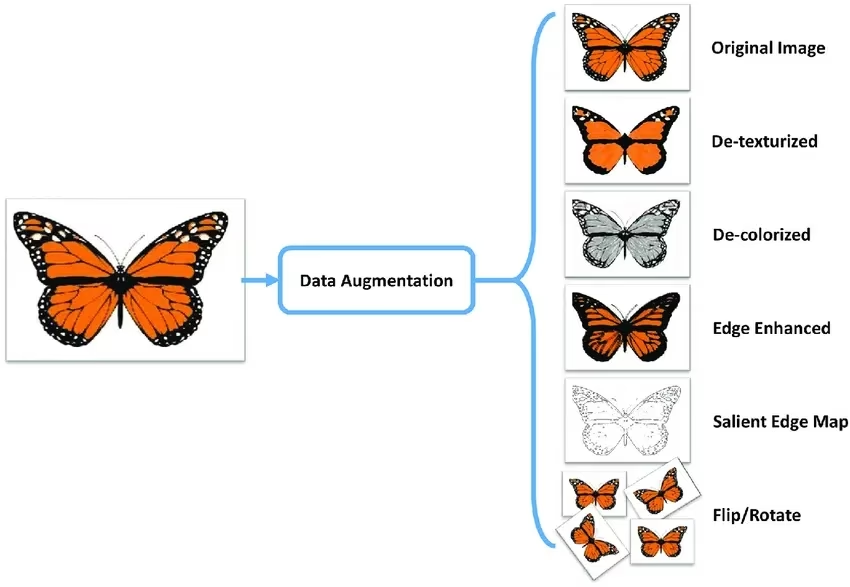
OpenCV、Albumentations 和 TensorFlow 等库提供了灵活的数据增强函数供你使用。此外,一些库(例如 Ultralytics)在模型训练函数中内置了增强设置,简化了整个流程。
为了更好地了解数据,你可以使用 Matplotlib 或 Seaborn 等工具可视化图像,并分析图像的分布和特征。数据可视化有助于发现模式、异常以及数据增强技术的效果。Ultralytics Platform 的 Charts 选项卡无需编写代码即可呈现许多此类洞察:它会自动为每个上传的数据集生成数据集划分分布、类别计数、图像尺寸直方图和标注位置热图。
通过妥善了解、划分和增强数据,你可以开发出经过充分训练、验证和测试,并能在实际应用中表现出色的模型。
第 4 步:模型训练#
数据集准备好用于训练后,你可以着手配置所需环境、管理数据集并训练模型。
首先,你需要确保环境配置正确。通常包括以下内容:
- 安装 TensorFlow、PyTorch或Ultralytics等必要的库和框架。
- 如果使用 GPU,安装 CUDA 和 cuDNN 等库有助于启用 GPU 加速并加快训练过程。
接下来,你可以将训练集和验证集加载到环境中。通过调整尺寸、转换格式或进行数据增强来规范化和预处理数据。选定模型后,配置网络层并指定超参数。通过设置损失函数、优化器和性能指标来编译模型。
Ultralytics 等库能简化训练流程。只需少量代码,将数据输入模型即可开始训练。这些库会自动处理权重调整、反向传播和验证。它们还提供工具,方便你监控进度并调整超参数。训练完成后,只需运行几条命令即可保存模型及其权重。
请记住,妥善管理数据集对于高效训练至关重要。使用数据集版本控制来跟踪更改并确保可复现性。DVC(数据版本控制)等工具可以帮助管理大型数据集。
第 5 步:模型评估与微调#
使用各种指标评估模型性能并进行改进,以提高准确率,这非常重要。评估有助于找出模型表现出色的方面以及可能需要改进的地方。微调可确保模型经过优化,以达到尽可能好的性能。
- 性能指标: 使用准确率、精确率、召回率和 F1 分数等指标评估模型性能。这些指标能够帮助你了解模型预测的效果。
- 超参数调优:调整超参数以优化模型性能。网格搜索或随机搜索等技术可以帮助找到最佳超参数值。
- 微调:对模型架构或训练过程进行小幅调整,以提升性能。这可能包括调整学习率、批次大小或其他模型参数。
如需深入了解模型评估和微调技术,请参阅我们的模型评估洞察指南。
第 6 步:模型测试#
模型测试可确认模型在完全未见过的数据上表现良好,从而验证模型是否已准备好部署。模型测试与模型评估的区别在于:测试侧重于验证最终模型的性能,而不是反复改进模型。
务必彻底测试并调试可能出现的常见问题。使用未参与训练或验证的独立测试数据集测试模型。该数据集应能代表真实场景,以确保模型性能稳定可靠。
此外,还要处理过拟合、欠拟合和数据泄漏等常见问题。使用交叉验证等技术识别这些问题。如需全面的测试策略,请参阅我们的模型测试指南。
第 7 步:模型部署#
模型经过全面测试后,就可以进行部署了。模型部署是指让模型能够在生产环境中使用。以下是部署计算机视觉模型的步骤:
- 设置环境:根据所选部署方式配置所需基础设施,无论是基于云端(AWS、Google Cloud、Azure)还是基于边缘设备(本地设备、IoT)。
- 导出模型:将模型导出为合适的格式(例如,YOLO26 可使用 ONNX、TensorRT、CoreML),以确保与部署平台兼容。
- 部署模型:设置 API 或端点,并将模型集成到应用中,从而完成部署。
- 确保可扩展性:部署负载均衡器、自动扩缩组和监控工具,以管理资源并处理不断增加的数据和用户请求。
Ultralytics Platform 还在全球 42 个区域提供托管式部署端点,默认支持缩容至零,并自动处理基础设施配置。
第 8 步:监控、维护与文档编写#
模型部署后,务必持续监控其性能、妥善维护以处理各种问题,并记录整个流程,以便日后参考和改进。
监控工具可以帮助你跟踪关键绩效指标 (KPI),并检测异常或准确率下降。通过监控模型,你可以及时发现模型漂移,即模型性能因输入数据发生变化而随时间下降的现象。定期使用更新后的数据重新训练模型,以保持准确率和时效性。
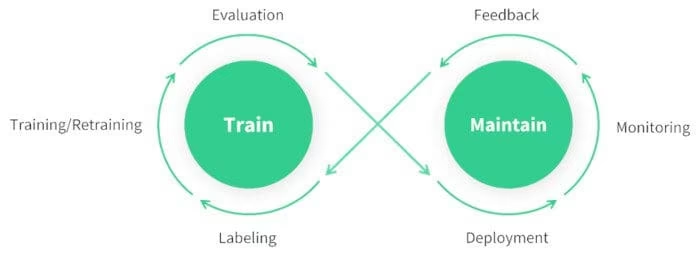
除了监控和维护,文档记录也至关重要。详细记录整个流程,包括模型架构、训练流程、超参数、数据预处理步骤,以及部署和维护期间所做的任何更改。完善的文档有助于确保可复现性,并让后续更新或故障排查更加轻松。通过有效地监控、维护并记录模型,你可以确保模型在整个生命周期内保持准确、可靠且易于管理。
参与社区交流#
与计算机视觉爱好者社区交流,可以帮助你更有信心地解决计算机视觉项目中遇到的问题。以下是一些有效学习、排查问题和建立联系的方法。
社区资源#
- GitHub Issues:访问 YOLO26 GitHub 仓库,并使用 Issues 选项卡提问、报告错误和建议新功能。活跃的社区成员和维护者会帮助你解决具体问题。
- Ultralytics Discord 服务器:加入 Ultralytics Discord 服务器,与其他用户和开发者交流、获取支持并分享见解。
利用这些资源可以帮助你克服挑战,并及时了解计算机视觉社区的最新趋势和最佳实践。
后续步骤#
现在,你已经掌握了计算机视觉项目各个阶段的路线图,从定义目标到监控已部署的模型。你可以通过训练你的第一个 YOLO 模型付诸实践,也可以通过上面链接的指南深入了解任一阶段。若要在不编写代码的情况下运行完整流程,请探索 Ultralytics Platform。
常见问题#
数据标注对于教会模型识别模式至关重要。标注类型因任务而异:
- 图像分类:将整张图像标记为一个类别。
- 目标检测:在目标周围绘制边界框。
- 图像分割:根据每个像素所属的目标为其添加标签。
Ultralytics Platform 内置的标注编辑器可以协助完成这一过程。
在数据增强前划分数据集,有助于使用原始、未经修改的数据验证模型性能。请按以下步骤操作:
- 训练集:占数据的 70-80%。
- 验证集:占数据的 10-15%,用于超参数调优。
- 测试集:剩余的 10-15%,用于最终评估。
划分数据后,应用旋转、缩放和翻转等数据增强技术,以增加数据集的多样性。Albumentations和 OpenCV 等库可以提供帮助。Ultralytics 还提供内置的数据增强设置,让操作更加便捷。
持续监控和维护对于模型的长期成功至关重要。部署工具以跟踪关键绩效指标(KPI)并检测异常。定期使用更新后的数据重新训练模型,以应对模型漂移。记录整个流程,包括模型架构、超参数和所做的更改,以确保可复现性,并方便日后更新。如需了解更多信息,请参阅我们的监控与维护指南。


评论2
提出问题、分享结果,或帮助其他人。
VeeranjaneyuluToka
what is the best way of verifying if the chosen model is right fit for the given dataset or problem statement. Is it just based on evaluation metrics or can we use kind of approach to verify based on the feature maps or heat map visualization if the model is really learning the features that it needs to be learnt.
 Glenn JocherUltralytics
Great question! You're absolutely right that evaluation metrics alone don't tell the whole story. Here are several approaches to verify if your model is truly learning the right features:
Beyond Evaluation Metrics:
- Feature visualization and heat maps (like Grad-CAM, LIME) help you see what regions the model focuses on during predictions
- Activation maps show which features activate at different layers, revealing what the model has learned
- Confusion matrices reveal specific class prediction patterns and potential biases
Practical Verification Approaches:
- Test on edge cases and adversarial examples to understand model robustness
- Cross-validation across different data splits to ensure consistent performance
- Error analysis by examining misclassified samples to identify systematic issues
- Domain adaptation testing on slightly different datasets to check generalization
For YOLO11 specifically:
- Use validation visualizations during training to see bounding box predictions
- Monitor training curves for signs of overfitting or underfitting
- Test inference on diverse real-world scenarios beyond your test set
The key is combining quantitative metrics with qualitative analysis - if your model achieves high accuracy but the heat maps show it's focusing on irrelevant background features instead of the actual objects, that's a red flag even with good metrics.
Would you like specific guidance on implementing any of these visualization techniques with your current project?