如何为计算机视觉项目设定目标
要定义计算机视觉项目,请撰写问题陈述,说明核心问题、范围、利益相关方和限制条件;设定可衡量且有时限的目标;并将问题对应到计算机视觉任务,以确定模型、数据集和部署方案。本指南将通过一个完整示例逐步介绍每个步骤。
观看: 如何明确计算机视觉项目的目标 | 问题陈述与 VisionAI 任务的关联 🚀
如需了解从数据收集到部署的完整工作流程,请参阅我们的计算机视觉项目关键步骤指南。
如何撰写计算机视觉问题陈述#
清晰的问题陈述是找到最有效解决方案的第一步,也是重要的一步。它包含四个部分:
- 确定核心问题:明确你的计算机视觉项目要解决的具体挑战。
- 确定范围:界定问题的边界。
- 考虑最终用户和利益相关方:确定哪些人会受到解决方案的影响。
- 分析项目需求和限制条件:评估可用资源(时间、预算、人员),并确定任何技术或监管限制。
业务问题陈述示例#
假设你有一个计算机视觉项目,目标是估算高速公路上车辆的速度。核心问题是,由于雷达系统老旧且依赖人工流程,现有测速方法效率低下、容易出错。该项目旨在开发一个实时计算机视觉系统,取代传统的速度估算系统。
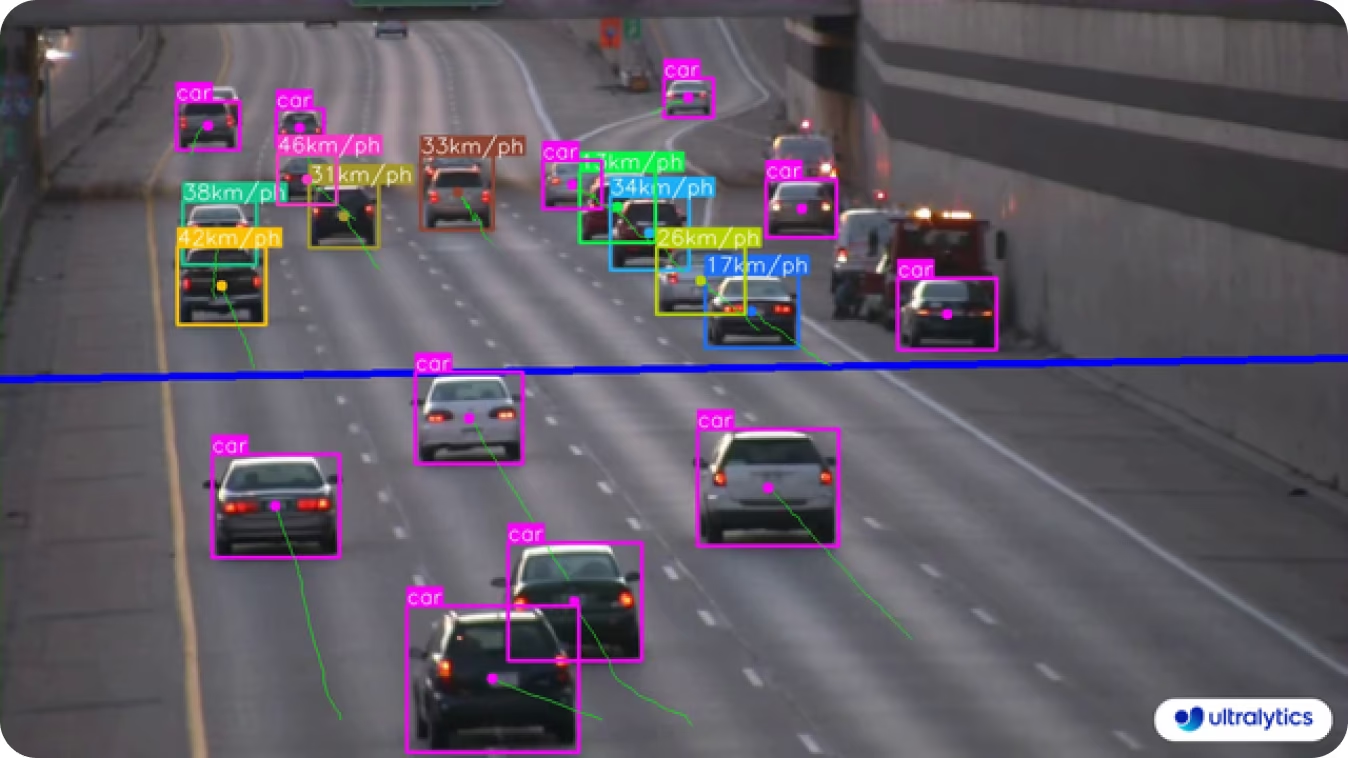
主要用户包括交通管理部门和执法机构,次要利益相关方包括高速公路规划人员,以及能够从更安全道路中受益的公众。关键要求包括评估预算、时间和人员,同时满足使用高分辨率摄像头和实时数据处理等技术需求。此外,还必须考虑隐私和数据安全方面的监管限制。
设定可衡量的目标#
设定可衡量的目标是计算机视觉项目成功的关键。有效的目标应遵循 SMART 标准:
| 标准 | 含义 |
|---|---|
| 具体 | 设定清晰、详细的目标。 |
| 可衡量 | 确保目标可以量化。 |
| 可实现 | 设定符合自身能力的现实目标。 |
| 相关 | 确保目标与你的整体项目目标一致。 |
| 有时限 | 为每个目标设定截止日期。 |
以高速公路车速估算为例,SMART 目标可以是:
- 在六个月内,使用包含 10,000 张车辆图像的数据集,将测速准确率提升至至少 95%。
- 系统应能够以每秒 30 帧的速度处理实时视频流,并将延迟降至最低。
设定具体且可量化的目标,有助于你有效跟踪进度、找出需要改进的方面,并确保项目按计划推进。
如何选择合适的计算机视觉任务#
问题陈述有助于你确定哪种计算机视觉任务能够解决问题。最常见的任务包括图像分类、目标检测和图像分割——如需详细比较,请参阅 Ultralytics 任务页面。
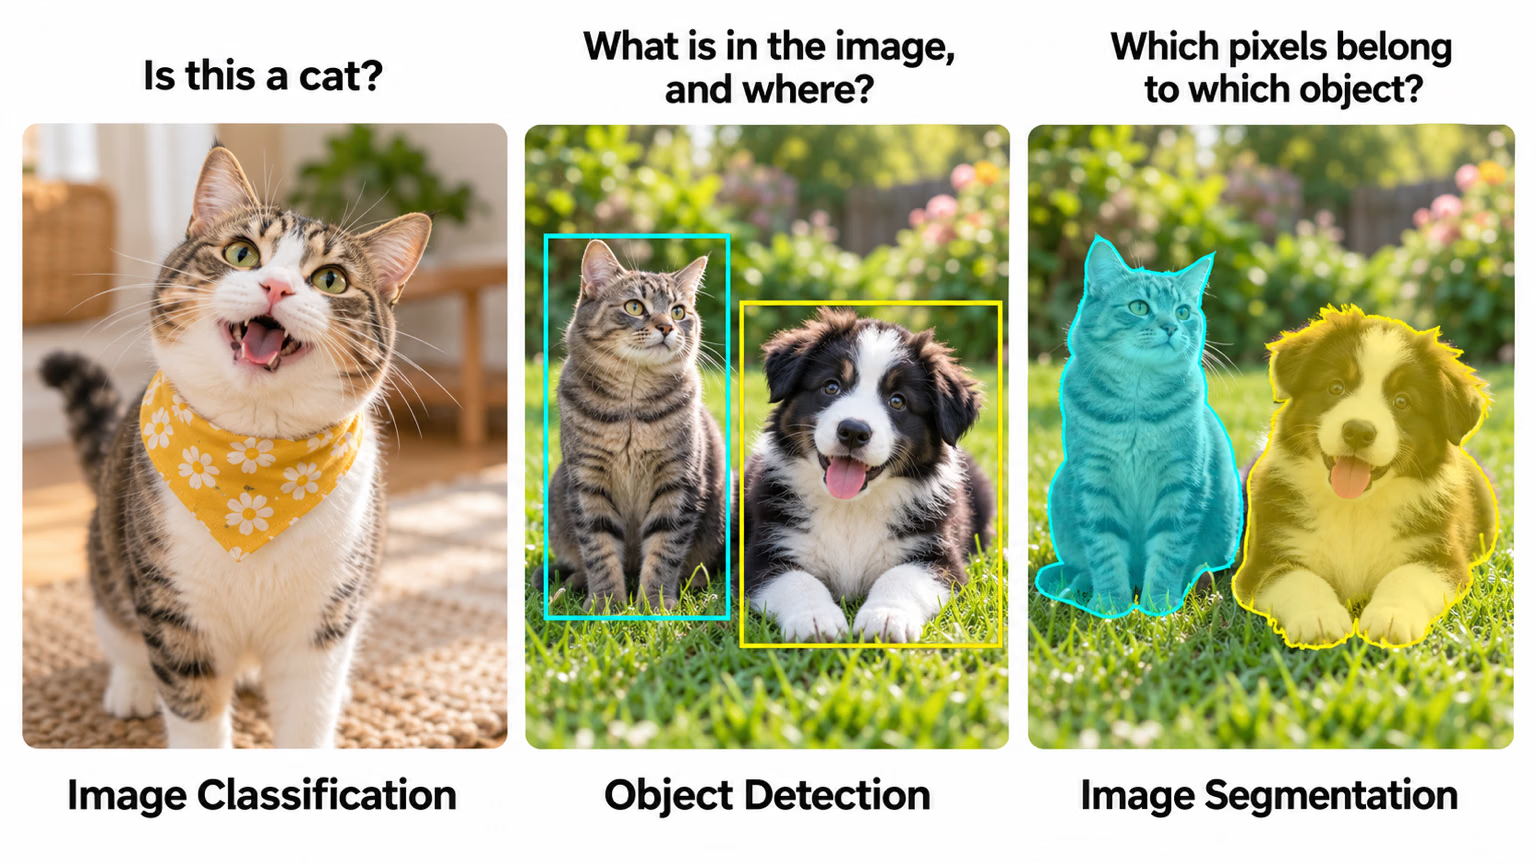
例如,如果你要解决的问题是在高速公路上监测车速,那么需要使用目标检测,并以跟踪模式运行。跟踪会为检测到的每辆车分配一个持久 ID,并在不同视频帧中保持该 ID,这正是计算车速所需要的。
在这种情况下,仅进行检测还不够:检测可以定位每一帧中的车辆,却无法在不同帧之间保持每辆车的身份信息;没有身份信息,系统就无法测量车辆随时间的移动情况。跟踪模式会补上身份信息。确定合适的计算机视觉任务后,你就能据此规划项目的多个关键环节,例如模型选择、数据集准备和模型训练方法。
先做什么:模型、数据还是训练方法?#
模型选择、数据集准备和训练方法的先后顺序取决于项目的具体情况:
| 你的情况 | 从这里开始 | 示例 |
|---|---|---|
| 问题和目标明确 | 选择模型 | 对于需要估算车速的交通监控系统,选择一个以跟踪模式运行的检测模型,收集并标注高速公路视频,然后使用适用于实时视频处理的技术进行训练。 |
| 数据独特或有限 | 准备数据集 | 对于数据集较小的人脸识别系统,先标注数据,然后选择适用于少量数据的模型——例如用于迁移学习的预训练模型——并规划数据增强,以扩充数据集。 |
| 实验至关重要(研究) | 选择训练方法 | 在探索制造缺陷检测新方法的项目中,先用一小部分数据进行实验。找到有前景的技术后,再选择适合这些实验结果的模型,并准备全面的数据集。 |
如果从数据入手,Ultralytics Platform 可随着项目发展简化数据集整理、标注和训练。
部署选项如何影响项目#
模型部署选项会显著影响计算机视觉项目的性能,因此从一开始就要纳入考虑。部署环境必须能够应对模型的计算负载:
| 部署选项 | 适用场景 | 技术示例 |
|---|---|---|
| 边缘设备 | 适用于计算资源有限的智能手机和 IoT 设备;轻量级模型 | LiteRT、ONNX Runtime |
| 云服务器 | 适用于计算需求较高的复杂模型;硬件可随项目需求扩展 | AWS、Google Cloud、Azure |
| 本地部署服务器 | 适用于对数据隐私和安全性要求较高的场景;可全面掌控数据和基础设施 | 自行管理的 GPU 服务器 |
| 混合解决方案 | 兼顾性能、成本和延迟;结合边缘处理与云端分析 | 边缘运行时与云平台的组合 |
每种选项各有优势和挑战,具体选择取决于项目的性能、成本和安全等需求。
结论#
成功的计算机视觉项目始于清晰的问题陈述、可衡量的 SMART 目标,以及适合任务的计算机视觉任务——这些决策会影响后续所有环节,从模型选择到部署。接下来,你可以了解如何收集和标注数据,也可以在 GitHub 和 Ultralytics Discord 服务器上与其他开发者讨论项目。
常见问题#
清晰的问题陈述应说明项目要解决的核心问题、项目范围、最终用户和利益相关者,以及资源和监管方面的限制。按顺序梳理这四个方面,然后在做出技术决策前与利益相关者确认问题陈述。完整拆解和示例请参阅如何撰写计算机视觉问题陈述。
根据问题所需的输出选择能够生成该输出的任务:每张图像对应一个标签时,选择图像分类;需要定位物体时,选择目标检测;需要像素级边界时,选择图像分割;需要在不同视频帧中持续保持身份信息时,则使用同一个检测模型并以跟踪模式运行。例如,监测车速需要跟踪,因为车速是根据每辆车随时间的移动情况计算得出的。所有支持的任务请参阅 Ultralytics 任务页面。
使用 SMART 标准:具体、可衡量、可实现、相关、有时限。例如:“使用包含 10,000 张车辆图像的数据集,在六个月内将测速准确率提升至 95%。”这种方法有助于跟踪进度并找出需要改进的方面。详细了解如何设定可衡量的目标。
不会,预训练模型不会以传统意义上的方式“记住”类别。模型从海量数据集中学习模式,在自定义训练(微调)期间,这些模式会针对你的具体任务进行调整。模型容量有限,专注于新信息可能会覆盖部分先前学到的内容,这种问题称为灾难性遗忘。
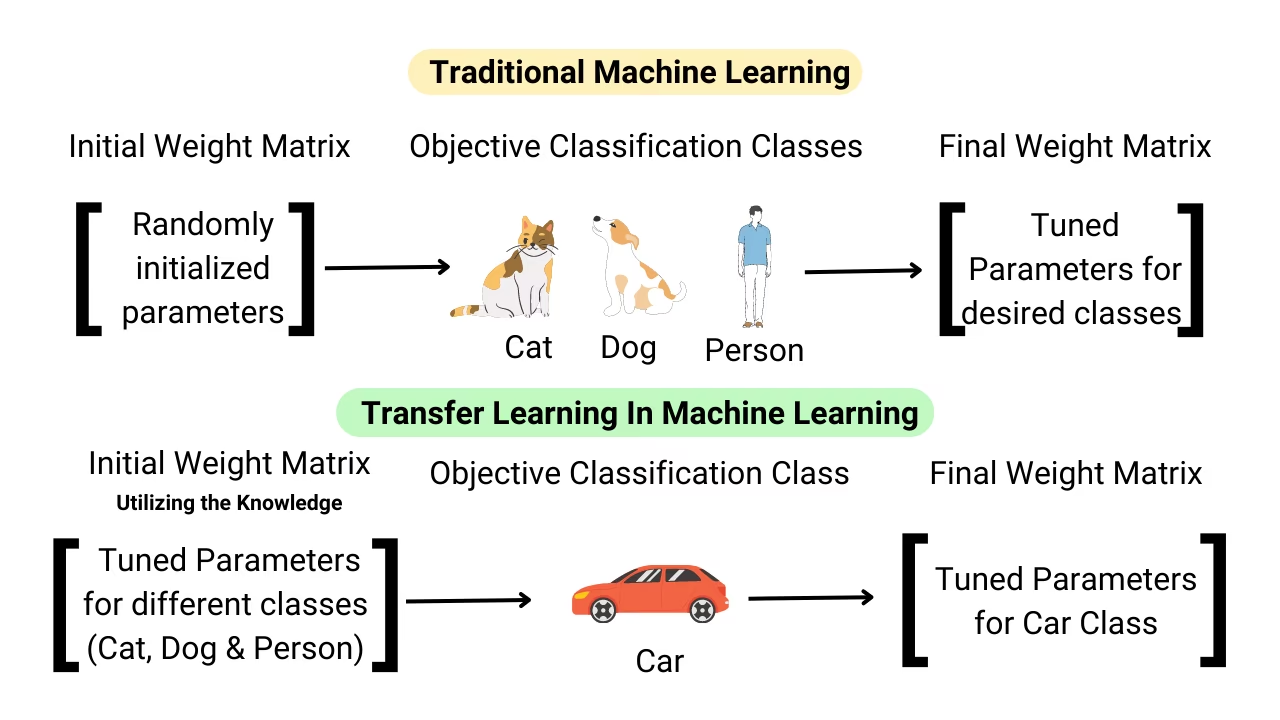
如果你想使用模型预训练时学到的类别,一种实用方法是使用两个模型:一个保留原有性能,另一个针对你的特定任务进行微调。这样,你就可以合并两个模型的输出。其他方案还包括冻结网络层、将预训练模型用作特征提取器,以及采用特定任务分支,但这些方案更复杂,也需要更丰富的专业知识。
部署选项决定哪些模型尺寸和格式可行,因此会从一开始就影响项目。边缘设备需要通过 LiteRT 或 ONNX Runtime 等格式和运行时部署轻量级模型;云服务器可通过可扩展硬件处理复杂模型;本地部署服务器可让注重隐私的项目全面掌控数据;混合部署则能在两者之间取得平衡。你可以在部署选项表中进行比较,或参阅模型部署选项指南了解详情。
常见挑战包括:
- 问题陈述含糊不清或范围过宽。
- 目标不切实际。
- 利益相关者未能达成共识。
- 对技术限制了解不足。
- 低估数据需求。
通过充分的前期研究、与利益相关者清晰沟通,并反复完善问题陈述和目标来应对这些挑战。完整的项目工作流程请参阅计算机视觉项目的关键步骤。


评论1
提出问题、分享结果,或帮助其他人。
VeeranjaneyuluToka
Generally i follow the below criteria to select a model -> Have a look into the literature and have a high level understanding (need to spend a couple of days or weeks also if the problem statement is quite new) -> Experiment with a few samples to check how it really performs -> Check if the chosen model can be good fit on the environment that needs to be deployed.
However currently we have a problem where we need to detect very small objects and that to be these objects are almost cluttered with background, i tried to follow the literature but most of the methods mentioned that they are good at small object detection. Would be really great if there are any suggestions on the model selection part on these kind of problem statements. Thanks in advance.