使用 Neural Magic 的 DeepSparse 引擎优化 YOLO26 推理#
在各种硬件上部署目标检测模型(例如 Ultralytics YOLO26)时,你可能会遇到优化等特殊问题。YOLO26 与 Neural Magic 的 DeepSparse 引擎集成,正是为了解决这类问题。这种集成改变了 YOLO26 模型的执行方式,让 CPU 直接实现 GPU 级别的性能。
本指南将介绍如何使用 Neural Magic 的 DeepSparse 部署 YOLO26、运行推理,以及如何对性能进行基准测试以确保模型得到优化。
Neural Magic 于 2025 年 1 月被 Red Hat 收购,并将弃用其 deepsparse、sparseml、sparsezoo 和 sparsify 库的社区版本。如需了解更多信息,请查看其 sparsify GitHub 仓库中的自述文件所发布的公告。
Neural Magic 的 DeepSparse#
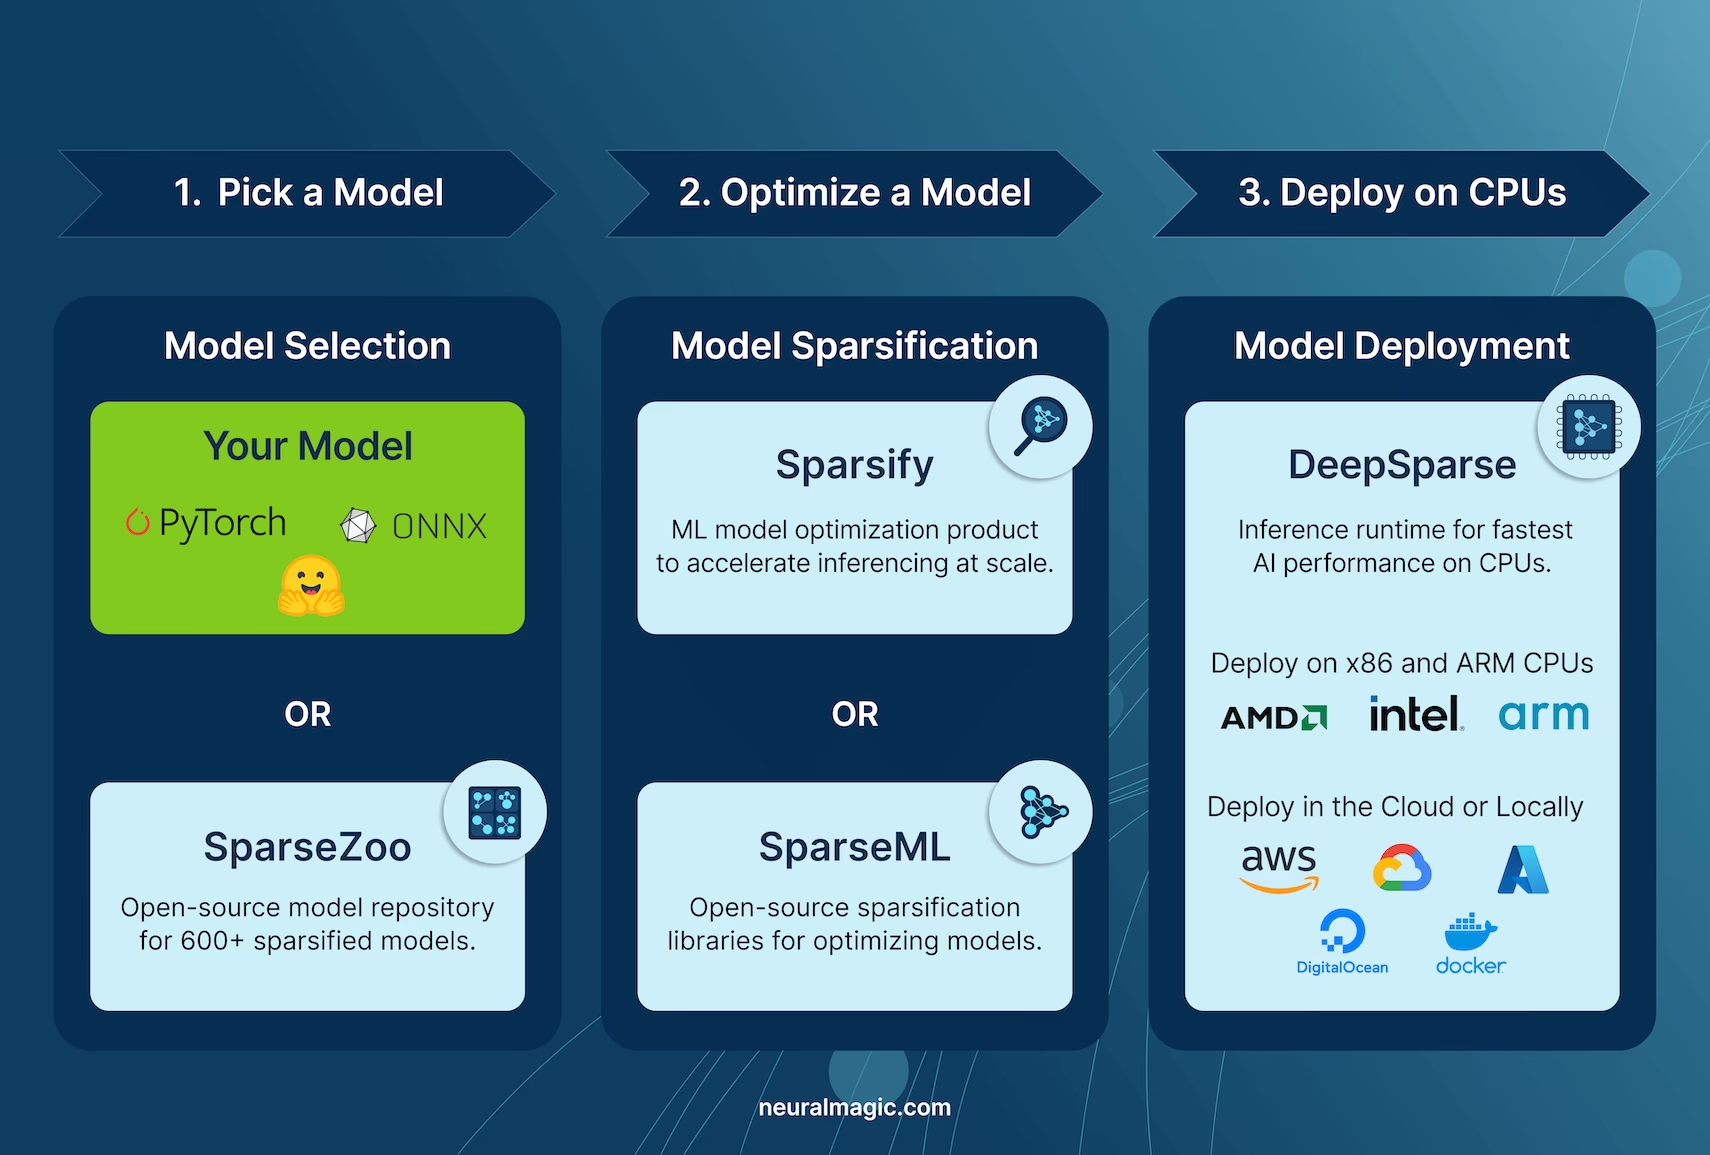
Neural Magic 的 DeepSparse 是一款推理运行时,旨在优化神经网络在 CPU 上的执行。它采用稀疏化、剪枝和量化等先进技术,在保持准确率的同时大幅降低计算需求。DeepSparse 为各种设备上的高效、可扩展神经网络执行提供了灵活的解决方案。
将 Neural Magic 的 DeepSparse 与 YOLO26 集成的优势#
在深入了解如何使用 DeepSparse 部署 YOLO26 之前,我们先来了解使用 DeepSparse 的优势。主要优势包括:
- 提升推理速度:在 YOLOv8n 上最高可达 525 FPS,与传统方法相比,显著提升 YOLO 的推理能力。
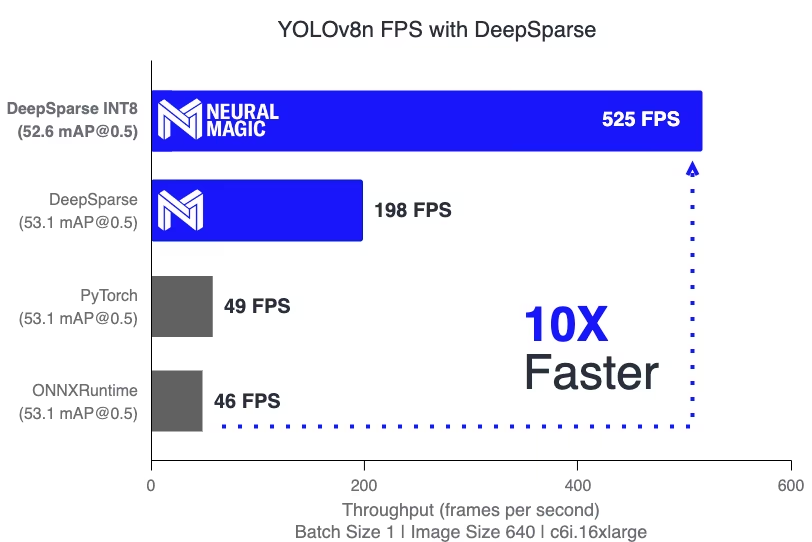
- 优化模型效率:利用剪枝和量化提升 YOLO26 的效率,在保持准确率的同时缩小模型体积并降低计算需求。
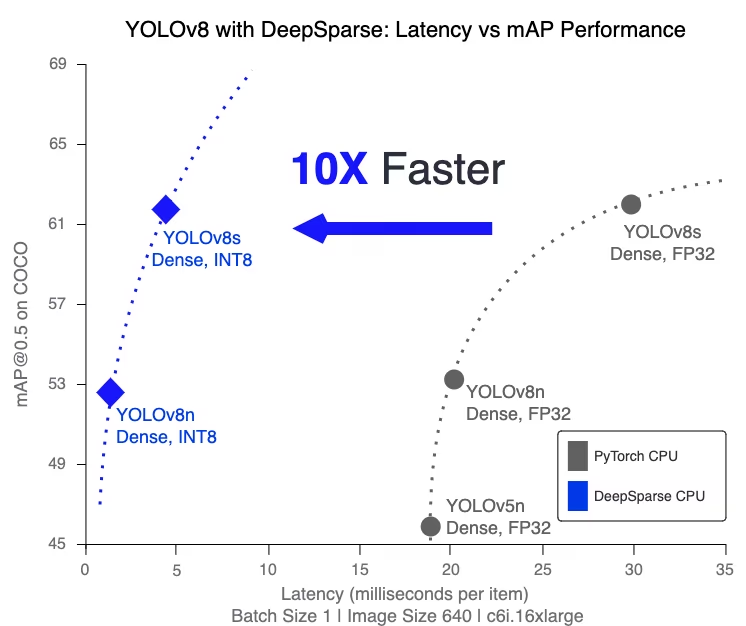
-
标准 CPU 上的高性能:在 CPU 上实现类似 GPU 的性能,为各种应用提供更易用且更经济高效的选择。
-
简化集成和部署:提供易于使用的工具,方便将 YOLO26 集成到应用中,并支持图像和视频标注功能。
-
支持多种模型类型:兼容标准 YOLO 模型和经过稀疏化优化的 YOLO 模型,提升部署灵活性。
-
经济高效且可扩展的解决方案:降低运营开支,并支持可扩展地部署先进的目标检测模型。
Neural Magic 的 DeepSparse 技术如何运作?#
Neural Magic 的 DeepSparse 技术借鉴了人脑在神经网络计算方面的高效性,采用了大脑的以下两项关键原理:
-
稀疏化:深度学习网络的稀疏化过程涉及剪除冗余信息,从而在不影响准确率的情况下生成更小、更快的模型。这种技术能显著缩小网络规模并降低计算需求。
-
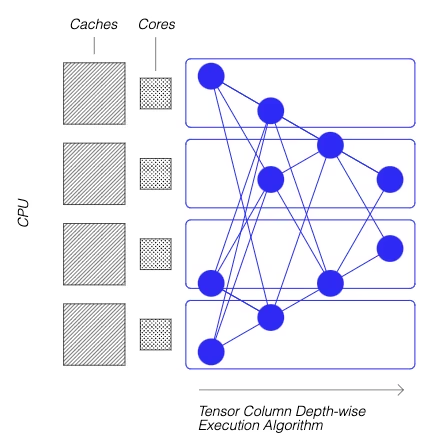
引用局部性:DeepSparse 使用一种独特的执行方式,将网络拆分为 Tensor Column。这些列按深度执行,并完全驻留在 CPU 缓存中。这种方法模拟了大脑的高效性,最大限度地减少数据移动并充分利用 CPU 缓存。
创建基于自定义数据集训练的 YOLO26 稀疏版本#
Neural Magic 的开源模型仓库 SparseZoo 提供一系列预先稀疏化的 YOLOv8 模型检查点。借助与 Ultralytics 无缝集成的 SparseML,用户可以通过简单的命令行界面,轻松地在自己的特定数据集上微调这些稀疏检查点。
如需了解更多详情,请参阅 Neural Magic 的 SparseML YOLOv8 文档。
用法:使用 DeepSparse 部署 YOLO26#
使用 Neural Magic 的 DeepSparse 部署 YOLO26 只需几个简单步骤。在阅读使用说明之前,别忘了查看 Ultralytics 提供的 YOLO26 模型。这有助于你根据项目需求选择最合适的模型。下面介绍如何开始。
步骤 1:安装#
运行以下命令安装所需的软件包:
# Install the required packages
pip install deepsparse[yolov8]
步骤 2:将 YOLO26 导出为 ONNX 格式#
DeepSparse 引擎要求 YOLO26 模型采用 ONNX 格式。将模型导出为此格式对于确保与 DeepSparse 兼容至关重要。使用以下命令导出 YOLO26 模型:
# Export YOLO26 model to ONNX format
yolo detect export model=yolo26n.pt format=onnx opset=13
此命令会将 yolo26n.onnx 模型保存到你的磁盘。
第 3 步:部署并运行推理#
有了 ONNX 格式的 YOLO26 模型后,你可以使用 DeepSparse 部署模型并运行推理。借助其直观易用的 Python API,操作非常简单:
from deepsparse import Pipeline

# 指定 YOLO26 ONNX 模型的路径
model_path = "path/to/yolo26n.onnx"

# 设置 DeepSparse Pipeline
yolo_pipeline = Pipeline.create(task="yolov8", model_path=model_path)

# 在图像上运行模型
images = ["path/to/image.jpg"]
pipeline_outputs = yolo_pipeline(images=images)
第 4 步:性能基准测试#
请务必检查 YOLO26 模型在 DeepSparse 上是否达到最佳性能。你可以对模型进行基准测试,分析吞吐量和延迟:
# Benchmark performance
deepsparse.benchmark model_path="path/to/yolo26n.onnx" --scenario=sync --input_shapes="[1,3,640,640]"
第 5 步:其他功能#
DeepSparse 还提供了其他功能,便于在应用中实际集成 YOLO26,例如图像标注和数据集评估。
# For image annotation
deepsparse.yolov8.annotate --source "path/to/image.jpg" --model_filepath "path/to/yolo26n.onnx"

# For evaluating model performance on a dataset
deepsparse.yolov8.eval --model_path "path/to/yolo26n.onnx"
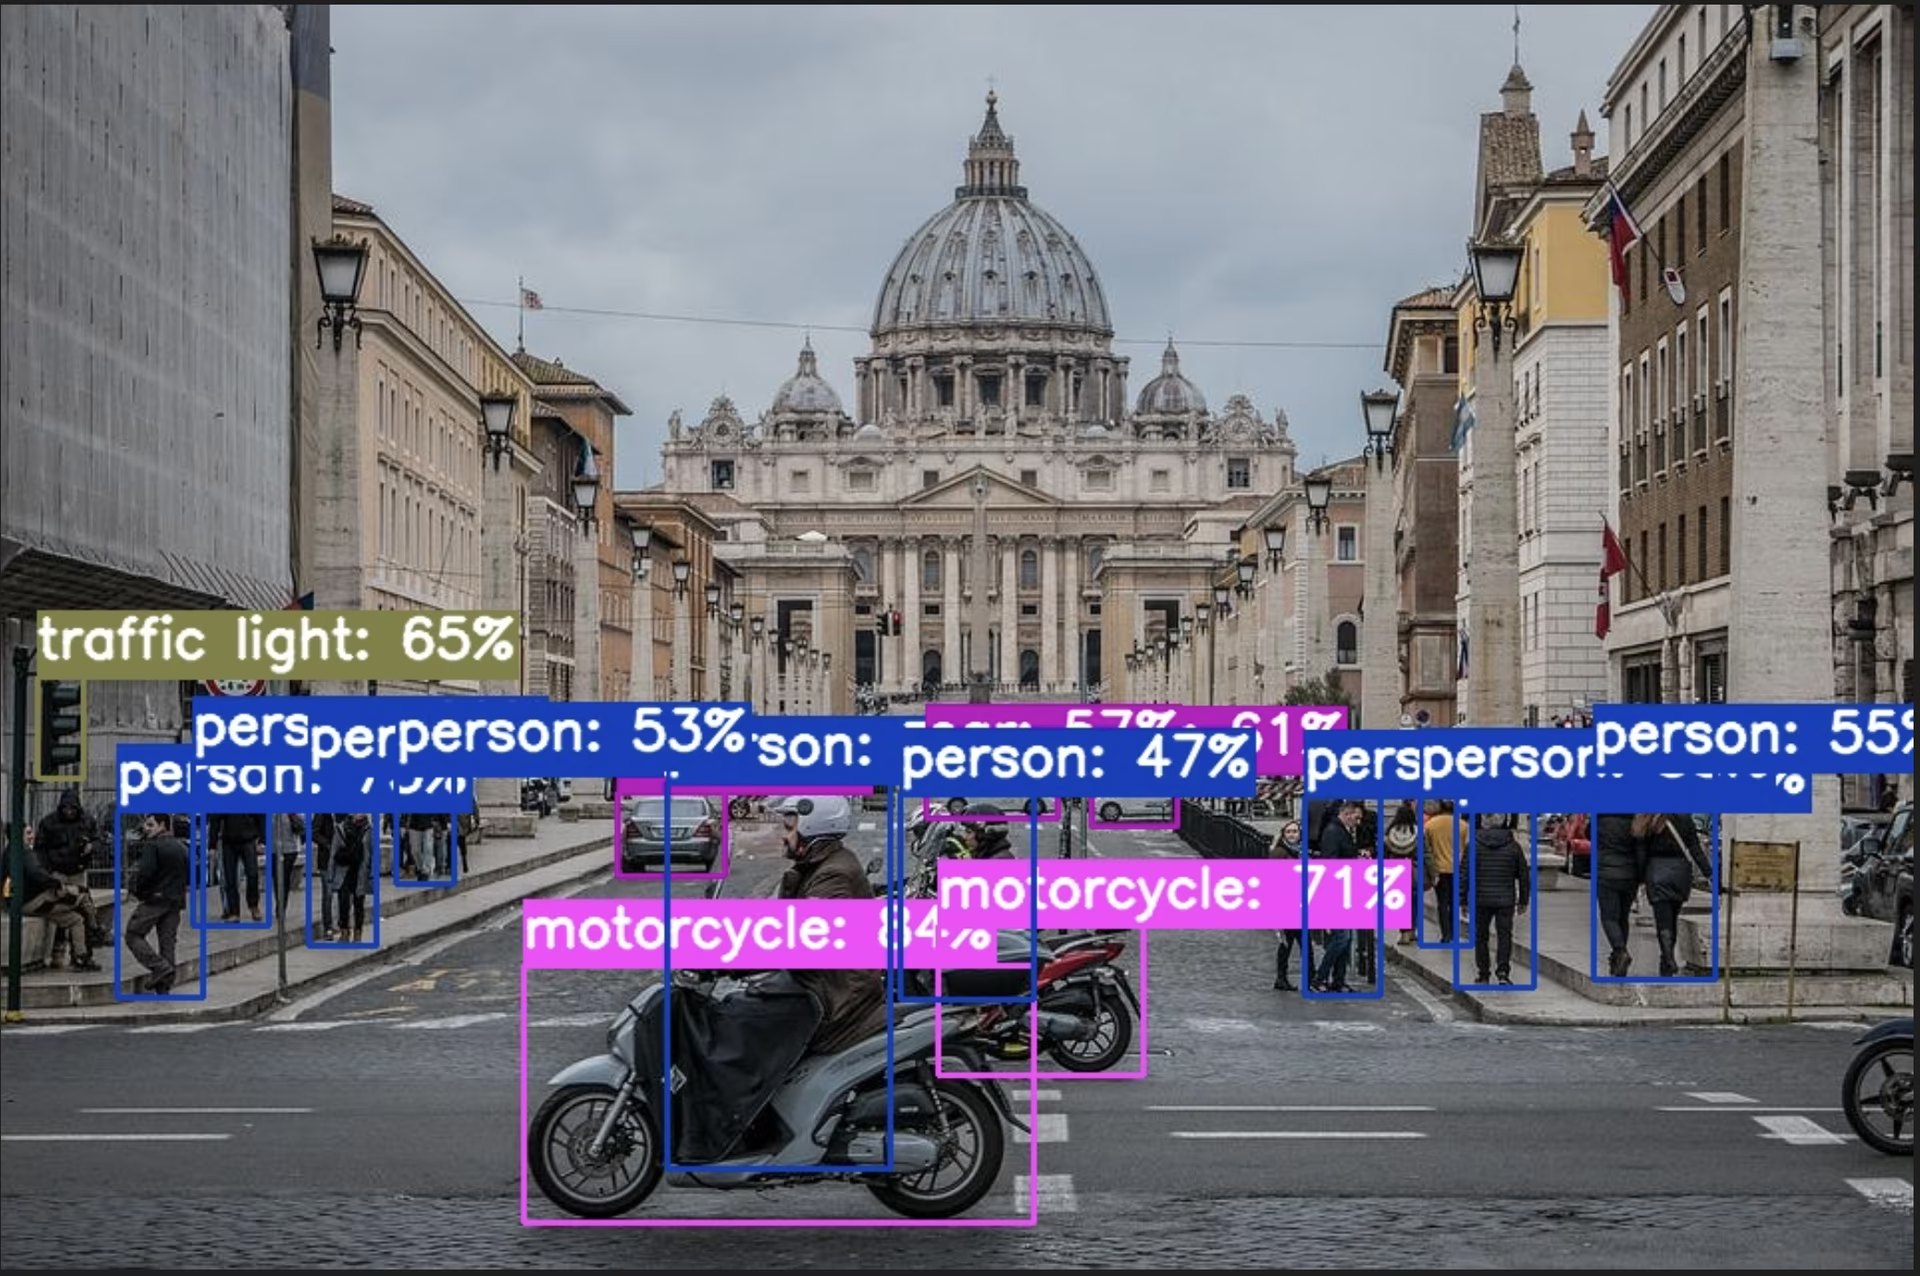
运行 annotate 命令会处理你指定的图像、检测对象,并保存带有边界框和分类结果的标注图像。标注后的图像会保存在 annotation-results 文件夹中。这有助于直观展示模型的检测能力。
运行 eval 命令后,你会收到详细的输出指标,例如精确率、召回率和mAP(平均精度均值)。这些指标全面展示了模型在数据集上的性能,对于针对特定用例微调和优化 YOLO26 模型尤为有用,有助于确保高准确率和效率。
总结#
本指南介绍了如何将 Ultralytics 的 YOLO26 与 Neural Magic 的 DeepSparse Engine 集成。指南重点说明了这种集成如何提升 YOLO26 在 CPU 平台上的性能,实现媲美 GPU 的效率,并运用先进的神经网络稀疏化技术。
如需了解更多详情和高级用法,请访问 Neural Magic 的 DeepSparse 代码库。你还可以查看 YOLOv8 集成指南,并观看 YouTube 上的演示讲解。
此外,如需全面了解各种 YOLO26 集成方案,请访问 Ultralytics 集成指南页面,了解其他多种值得探索的集成方式。
常见问题#
Neural Magic 的 DeepSparse Engine 是一种推理运行时,通过稀疏化、剪枝和量化等先进技术,优化神经网络在 CPU 上的执行。将 DeepSparse 与 YOLO26 集成后,你可以在标准 CPU 上实现媲美 GPU 的性能,大幅提升推理速度、模型效率和整体性能,同时保持准确率。更多详情请查看 Neural Magic 的 DeepSparse 章节。
安装使用 Neural Magic 的 DeepSparse 部署 YOLO26 所需的软件包非常简单。你可以通过 CLI 轻松安装。运行以下命令即可:
pip install deepsparse[yolov8]安装完成后,按照安装章节中的步骤设置环境,并开始使用 DeepSparse 部署 YOLO26。
要将 YOLO26 模型转换为 ONNX 格式(这是与 DeepSparse 兼容所必需的),可以使用以下 CLI 命令:
yolo detect export model=yolo26n.pt format=onnx opset=13此命令会将 YOLO26 模型(
yolo26n.pt)导出为 DeepSparse Engine 可使用的格式(yolo26n.onnx)。有关模型导出的更多信息,请参阅模型导出章节。在 DeepSparse 上对 YOLO26 的性能进行基准测试,有助于分析吞吐量和延迟,确保模型得到优化。你可以使用以下 CLI 命令运行基准测试:
deepsparse.benchmark model_path="path/to/yolo26n.onnx" --scenario=sync --input_shapes="[1,3,640,640]"此命令会提供关键性能指标。更多详情请参阅性能基准测试章节。
将 Neural Magic 的 DeepSparse 与 YOLO26 集成有以下几项优势:
- 提升推理速度:速度最高可达 525 FPS(使用 YOLOv8n),充分展现了 DeepSparse 的优化能力。
- 优化模型效率:利用稀疏化、剪枝和量化技术,在保持准确率的同时减少模型大小和计算需求。
- 标准 CPU 上的高性能:在经济实惠的 CPU 硬件上实现媲美 GPU 的性能。
- 简化集成流程:提供易于使用的工具,方便部署和集成。
- 灵活性:支持标准 YOLO 模型和经过稀疏化优化的 YOLO 模型。
- 经济高效:通过高效利用资源降低运营成本。
如需深入了解这些优势,请参阅将 Neural Magic 的 DeepSparse 与 YOLO26 集成的优势章节。