Ultralytics YOLO26 على NVIDIA Jetson باستخدام DeepStream SDK وTensorRT#
شاهد: كيفية استخدام نماذج Ultralytics YOLO26 مع NVIDIA Deepstream على Jetson Orin NX 🚀
يقدم هذا الدليل الشامل شرحًا تفصيليًا لنشر Ultralytics YOLO26 على أجهزة NVIDIA Jetson باستخدام DeepStream SDK وTensorRT. نستخدم هنا TensorRT لتحقيق أقصى أداء للاستدلال على منصة Jetson.
يشرح هذا الدليل خطوات إعداد DeepStream لـ YOLO26، ومعايرة INT8، وإعداد تدفقات متعددة، ونتائج الاختبارات المعيارية.
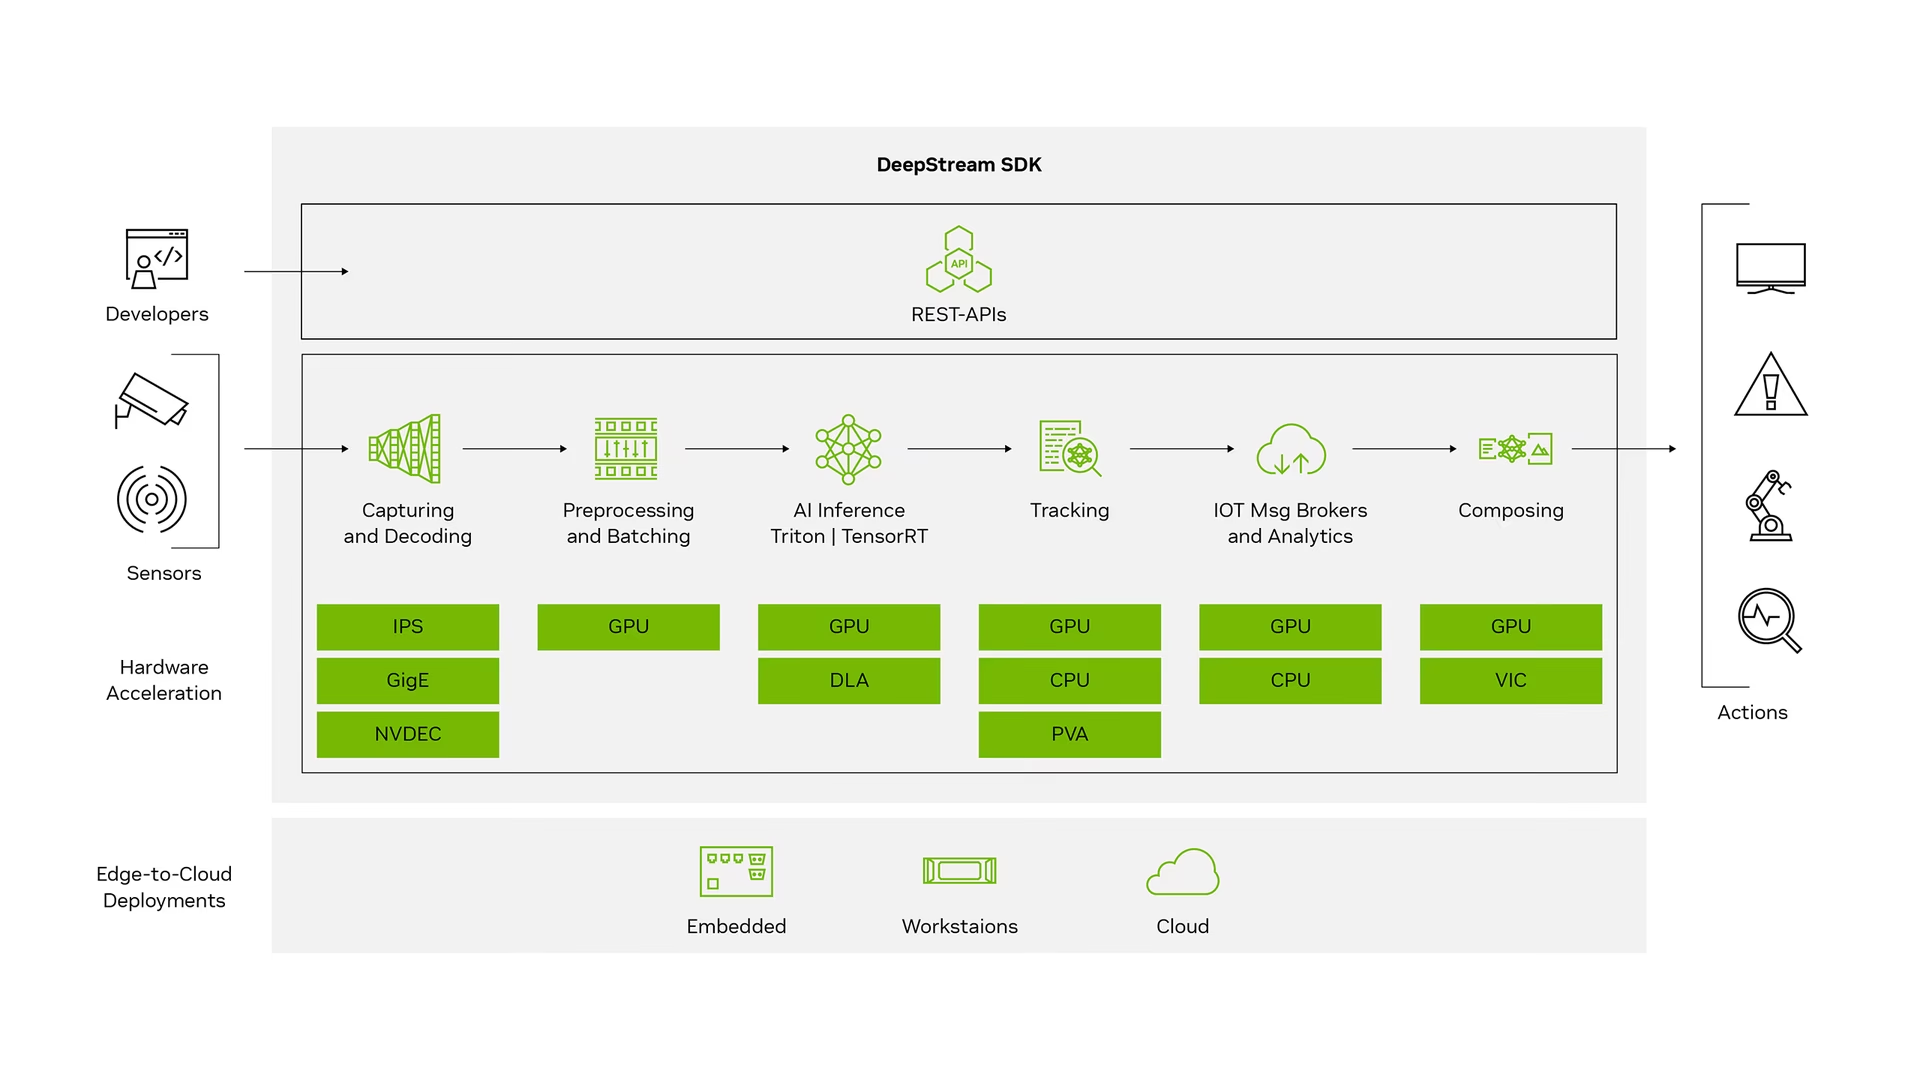
اختُبر هذا الدليل على NVIDIA Jetson Orin Nano Super Developer Kit الذي يعمل بإصدار JetPack من JP6.1، وعلى Seeed Studio reComputer J4012، المستند إلى NVIDIA Jetson Orin NX بسعة 16GB والذي يعمل بإصدار JetPack من JP5.1.3، وعلى Seeed Studio reComputer J1020 v2، المستند إلى NVIDIA Jetson Nano بسعة 4GB والذي يعمل بإصدار JetPack من JP4.6.4. ومن المتوقع أن يعمل على جميع أجهزة NVIDIA Jetson، بما في ذلك أحدث الأجهزة والإصدارات القديمة.
ما هو NVIDIA DeepStream؟#
إن DeepStream SDK من NVIDIA مجموعة أدوات متكاملة لتحليلات التدفق، مبنية على GStreamer لمعالجة عدة مستشعرات بالذكاء الاصطناعي وفهم الفيديو والصوت والصور. وهي مثالية لمطوري الذكاء الاصطناعي البصري وشركاء البرمجيات والشركات الناشئة ومصنعي المعدات الأصلية الذين يطورون تطبيقات وخدمات IVA (تحليلات الفيديو الذكية). ويمكنك الآن إنشاء مسارات معالجة للتدفق تدمج الشبكات العصبية ومهام المعالجة المعقدة الأخرى، مثل التتبع وترميز الفيديو وفك ترميزه وعرضه. تتيح هذه المسارات إجراء تحليلات آنية لبيانات الفيديو والصور والمستشعرات. ويوفر دعم DeepStream للمنصات المتعددة طريقة أسرع وأسهل لتطوير تطبيقات وخدمات الذكاء الاصطناعي البصري محليًا، وعلى الحافة، وفي السحابة.
المتطلبات الأساسية#
قبل البدء باتباع هذا الدليل:
- زر وثائقنا، دليل البدء السريع: NVIDIA Jetson مع Ultralytics YOLO26، لإعداد جهاز NVIDIA Jetson باستخدام Ultralytics YOLO26
- ثبّت DeepStream SDK وفقًا لإصدار JetPack
- بالنسبة إلى JetPack 4.6.4، ثبّت DeepStream 6.0.1
- بالنسبة إلى JetPack 5.1.3، ثبّت DeepStream 6.3
- بالنسبة إلى JetPack 6.1، ثبّت DeepStream 7.1
- بالنسبة إلى JetPack 7.1، ثبّت DeepStream 9.0
استخدمنا في هذا الدليل طريقة حزم Debian لتثبيت DeepStream SDK على جهاز Jetson. يمكنك أيضًا زيارة DeepStream SDK على Jetson (مؤرشف) للوصول إلى الإصدارات القديمة من DeepStream.
إعداد DeepStream لـ YOLO26#
نستخدم هنا مستودع GitHub marcoslucianops/DeepStream-Yolo، الذي يتضمن دعم NVIDIA DeepStream SDK لنماذج YOLO. ونقدّر جهود marcoslucianops ومساهماته!
-
ثبّت Ultralytics مع التبعيات اللازمة
pip install ultralytics onnx onnxslim -
استنسخ مستودع DeepStream-Yolo
cd ~ git clone https://github.com/marcoslucianops/DeepStream-Yolo -
نزّل نموذج كشف Ultralytics YOLO26 (.pt) الذي تختاره من مشروع YOLO26. نستخدم هنا yolo26s.pt.
wget https://github.com/ultralytics/assets/releases/download/v8.4.0/yolo26s.pt
يمكنك أيضًا استخدام نموذج YOLO26 مُدرَّب خصيصًا.
-
حوّل النموذج إلى ONNX وأنشئ الملف
labels.txtالذي يقرأ DeepStream منه أسماء الفئاتfrom ultralytics import YOLO model = YOLO("yolo26s.pt") model.export(format="onnx", nms=False, agnostic_nms=True) # ينشئ 'yolo26s.onnx' with open("labels.txt", "w") as f: f.write("\n".join(model.names.values()))
يصدّر nms=False رأسًا خاليًا من NMS، ويُبقي agnostic_nms=True فئة واحدة لكل عملية كشف، كي لا يرسم cluster-mode=4 (من دون تجميع) في إعداد DeepStream مربعًا مرتين. أضف imgsz=1280 لتغيير حجم الاستدلال (الافتراضي: 640)، وbatch=4 لتحديد حجم دفعة قدره 4 (حجم الدفعة المُصدَّرة ثابت، لذا يجب أن يطابق batch-size في إعداد DeepStream)، وopset=12 لاستخدام TensorRT 8.2 أو إصدار أقدم (DeepStream 6.0.1 والإصدارات الأقدم). راجع وسيطات التصدير للاطلاع على القائمة الكاملة.
-
انسخ ملف النموذج المُنشأ
.onnxوالملفlabels.txtإلى المجلدDeepStream-Yolocp yolo26s.onnx labels.txt ~/DeepStream-Yolo cd ~/DeepStream-Yolo -
اضبط إصدار CUDA وفقًا لإصدار JetPack المثبّت
بالنسبة إلى JetPack 4.6.4:
export CUDA_VER=10.2بالنسبة إلى JetPack 5.1.3:
export CUDA_VER=11.4بالنسبة إلى JetPack 6.1:
export CUDA_VER=12.6بالنسبة إلى JetPack 7.1:
export CUDA_VER=13.0 -
جمّع المكتبة
make -C nvdsinfer_custom_impl_Yolo clean && make -C nvdsinfer_custom_impl_Yolo -
عدّل الملف
config_infer_primary_yolo26.txtوفقًا لنموذجك (لـ YOLO26s ذي 80 فئة)[property] ... onnx-file=yolo26s.onnx ... num-detected-classes=80 ... parse-bbox-func-name=NvDsInferParseYolo ...
يغيّر YOLO26 حجم الإدخال باستخدام الحشو من المنتصف، ويعمل من دون NMS. لتحقيق أفضل دقة، أضف ما يلي إلى قسم [property] في config_infer_primary_yolo26.txt:
[property]
...
maintain-aspect-ratio=1
symmetric-padding=1
cluster-mode=4
...-
عدّل الملف
deepstream_app_config... [primary-gie] ... config-file=config_infer_primary_yolo26.txt -
يمكنك أيضًا تغيير مصدر الفيديو في الملف
deepstream_app_config. يُحمّل هنا ملف فيديو افتراضي... [source0] ... uri=file:///opt/nvidia/deepstream/deepstream/samples/streams/sample_1080p_h264.mp4
تشغيل الاستدلال#
deepstream-app -c deepstream_app_config.txtسيستغرق إنشاء ملف محرك TensorRT وقتًا طويلًا قبل بدء الاستدلال. لذا يُرجى التحلي بالصبر.
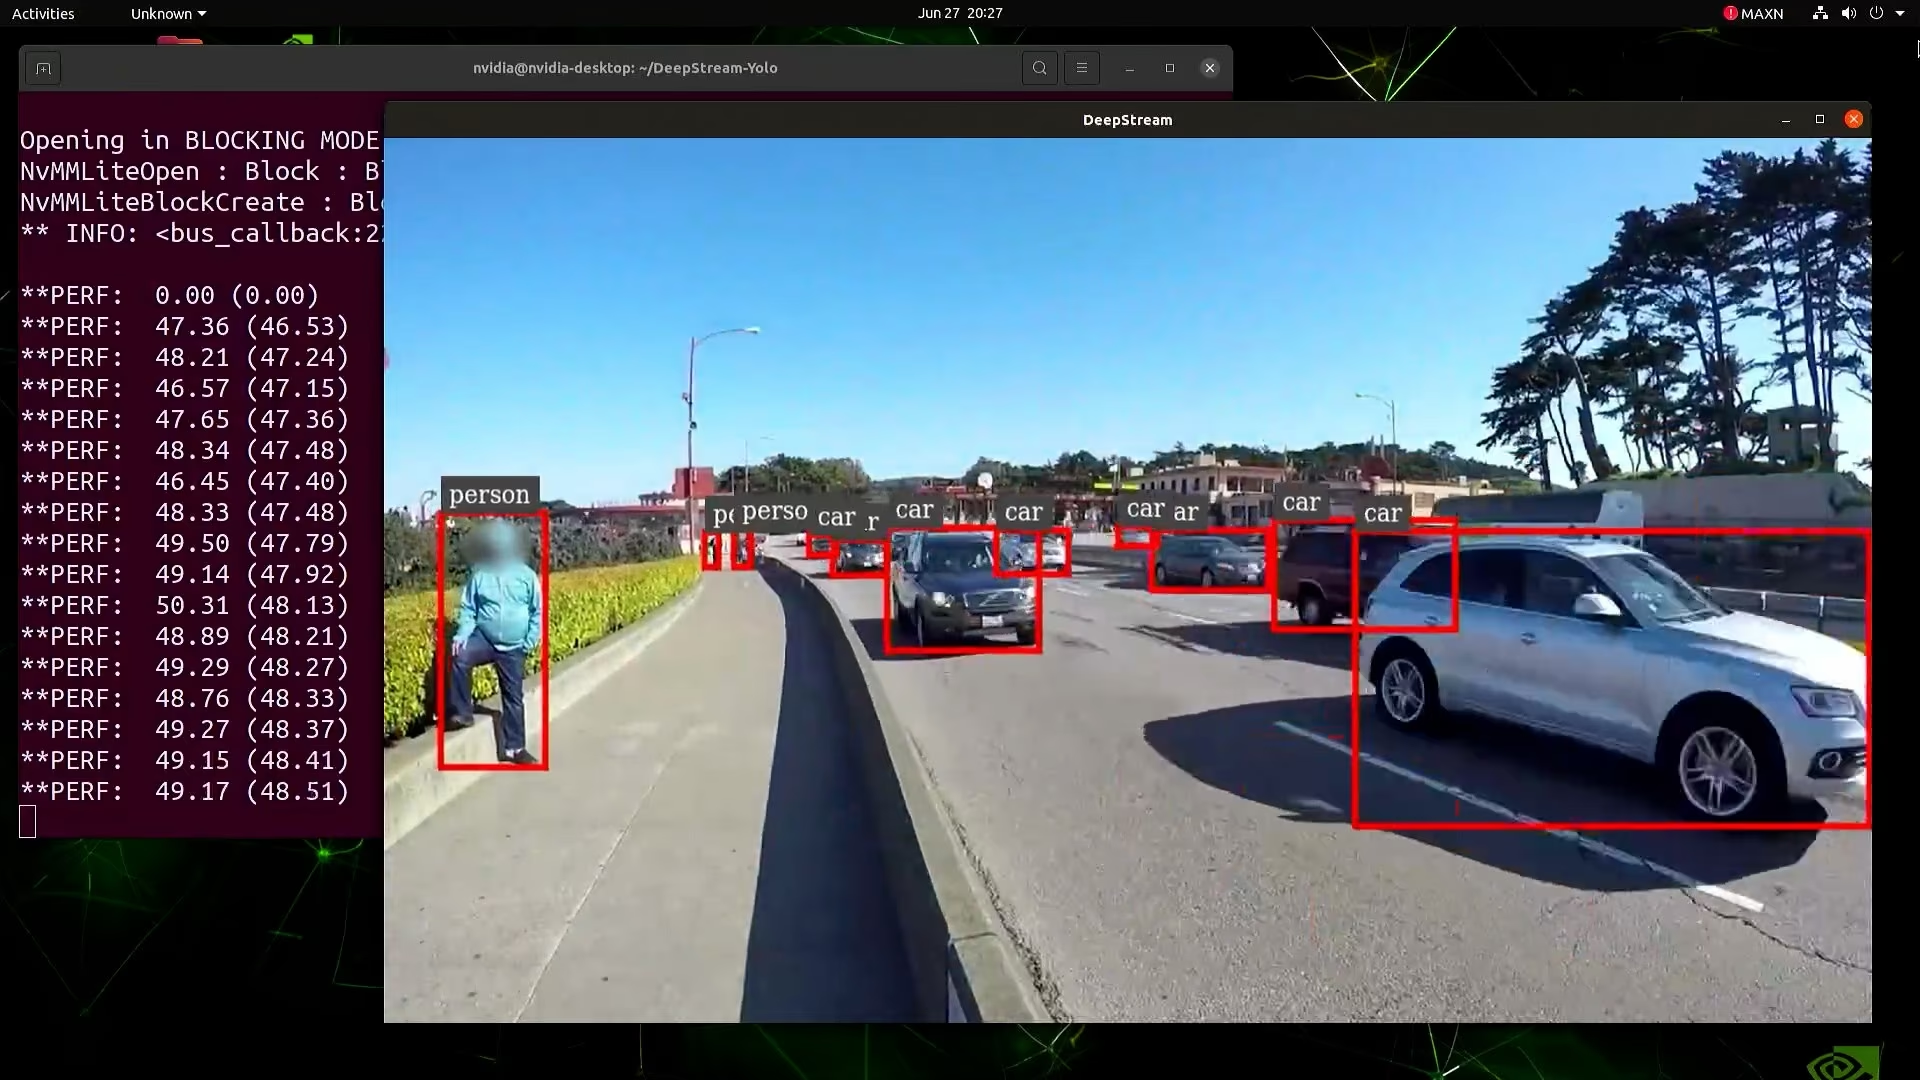
إذا أردت تحويل النموذج إلى دقة FP16، فما عليك سوى ضبط model-engine-file=model_b1_gpu0_fp16.engine وnetwork-mode=2 داخل config_infer_primary_yolo26.txt
معايرة INT8#
إذا أردت استخدام دقة INT8 للاستدلال، فاتبع الخطوات التالية:
لا يعمل INT8 حاليًا مع TensorRT 10.x. اختُبر هذا القسم من الدليل باستخدام TensorRT 8.x، ومن المتوقع أن يعمل.
-
اضبط متغير البيئة
OPENCVexport OPENCV=1 -
جمّع المكتبة
make -C nvdsinfer_custom_impl_Yolo clean && make -C nvdsinfer_custom_impl_Yolo -
لمجموعة بيانات COCO، نزّل val2017، وفك ضغطه، وانقله إلى المجلد
DeepStream-Yolo -
أنشئ دليلًا جديدًا لصور المعايرة
mkdir calibration -
نفّذ الأمر التالي لاختيار 1000 صورة عشوائية من مجموعة بيانات COCO لإجراء المعايرة
for jpg in $(ls -1 val2017/*.jpg | sort -R | head -1000); do
  cp ${jpg} calibration/
done
توصي NVIDIA باستخدام 500 صورة على الأقل لتحقيق دقة جيدة. في هذا المثال، اختيرت 1000 صورة لتحسين الدقة (كلما زاد عدد الصور، زادت الدقة). يمكنك تحديد العدد باستخدام head -1000. فعلى سبيل المثال، لاختيار 2000 صورة، استخدم head -2000. قد تستغرق هذه العملية وقتًا طويلًا.
-
أنشئ الملف
calibration.txtمتضمنًا جميع الصور المحددةrealpath calibration/*jpg > calibration.txt -
اضبط متغيرات البيئة
export INT8_CALIB_IMG_PATH=calibration.txt
export INT8_CALIB_BATCH_SIZE=1
تؤدي القيم الأعلى لـ INT8_CALIB_BATCH_SIZE إلى دقة أكبر وسرعة معايرة أعلى. اضبط القيمة وفقًا لذاكرة GPU لديك.
-
حدّث الملف
config_infer_primary_yolo26.txtمن
...
model-engine-file=model_b1_gpu0_fp32.engine
#int8-calib-file=calib.table
...
network-mode=0
...
إلى
...
model-engine-file=model_b1_gpu0_int8.engine
int8-calib-file=calib.table
...
network-mode=1
...
تشغيل استدلال INT8#
نفّذ الأمر نفسه لإنشاء محرك INT8 وبدء الاستدلال:
deepstream-app -c deepstream_app_config.txtإعداد تدفقات متعددة#
شاهد: كيفية تنفيذ الاستدلال متعدد التدفقات باستخدام Ultralytics YOLO26 وNVIDIA DeepStream على Jetson Orin 🚀
لإعداد عدة تدفقات ضمن تطبيق DeepStream واحد، أجرِ التغييرات التالية على الملف deepstream_app_config.txt:
-
غيّر عدد الصفوف والأعمدة لإنشاء عرض شبكي يتناسب مع عدد التدفقات المطلوبة. على سبيل المثال، لإضافة 4 تدفقات، يمكننا إضافة صفين وعمودين.
[tiled-display] rows=2 columns=2 -
أضف مجموعة
[sourceN]منفصلة لكل تدفق، معuriوnum-sources=1خاصين به.[source0] enable=1 type=3 uri=file:///path/to/video1.mp4 num-sources=1 [source1] enable=1 type=3 uri=file:///path/to/video2.mp4 num-sources=1 [source2] enable=1 type=3 uri=file:///path/to/video3.mp4 num-sources=1 [source3] enable=1 type=3 uri=file:///path/to/video4.mp4 num-sources=1
تشغيل الاستدلال متعدد التدفقات#
نفّذ الأمر نفسه لتشغيل جميع التدفقات في العرض الشبكي:
deepstream-app -c deepstream_app_config.txt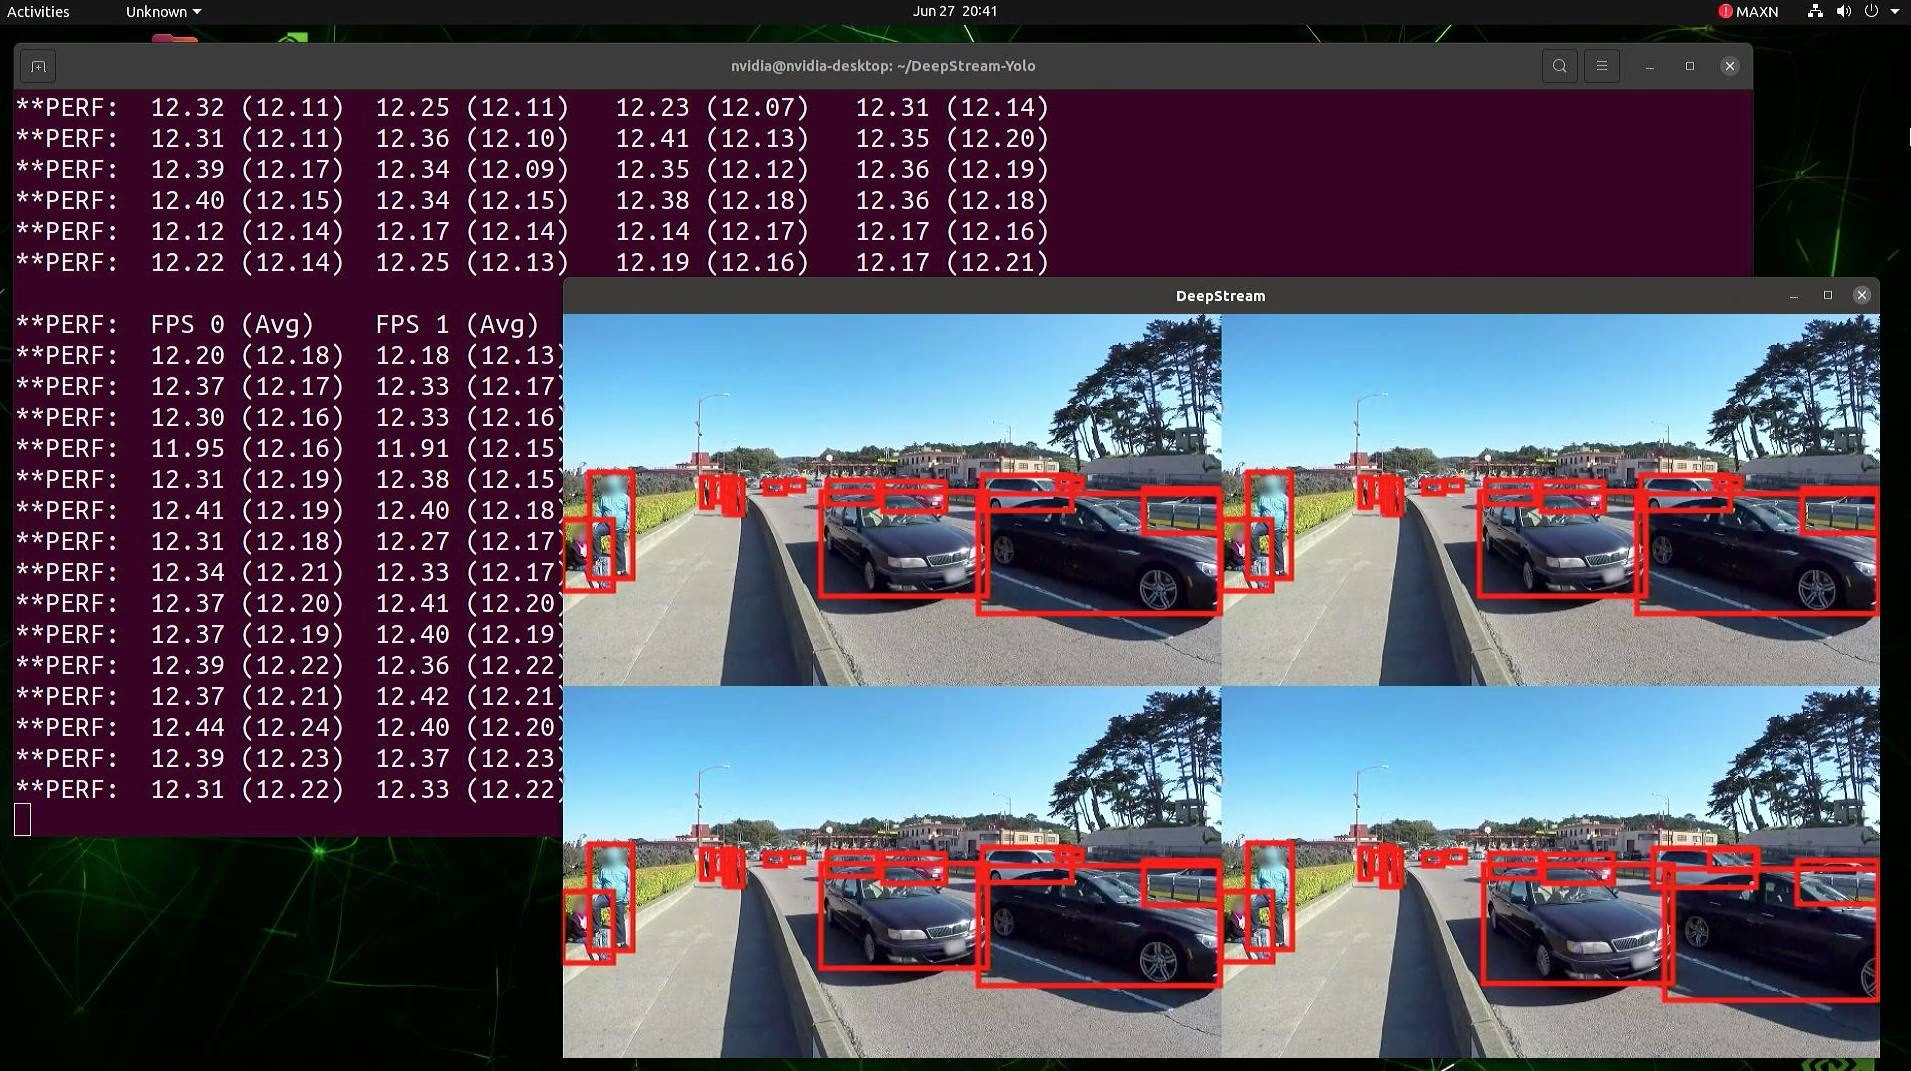
نتائج الاختبارات المعيارية#
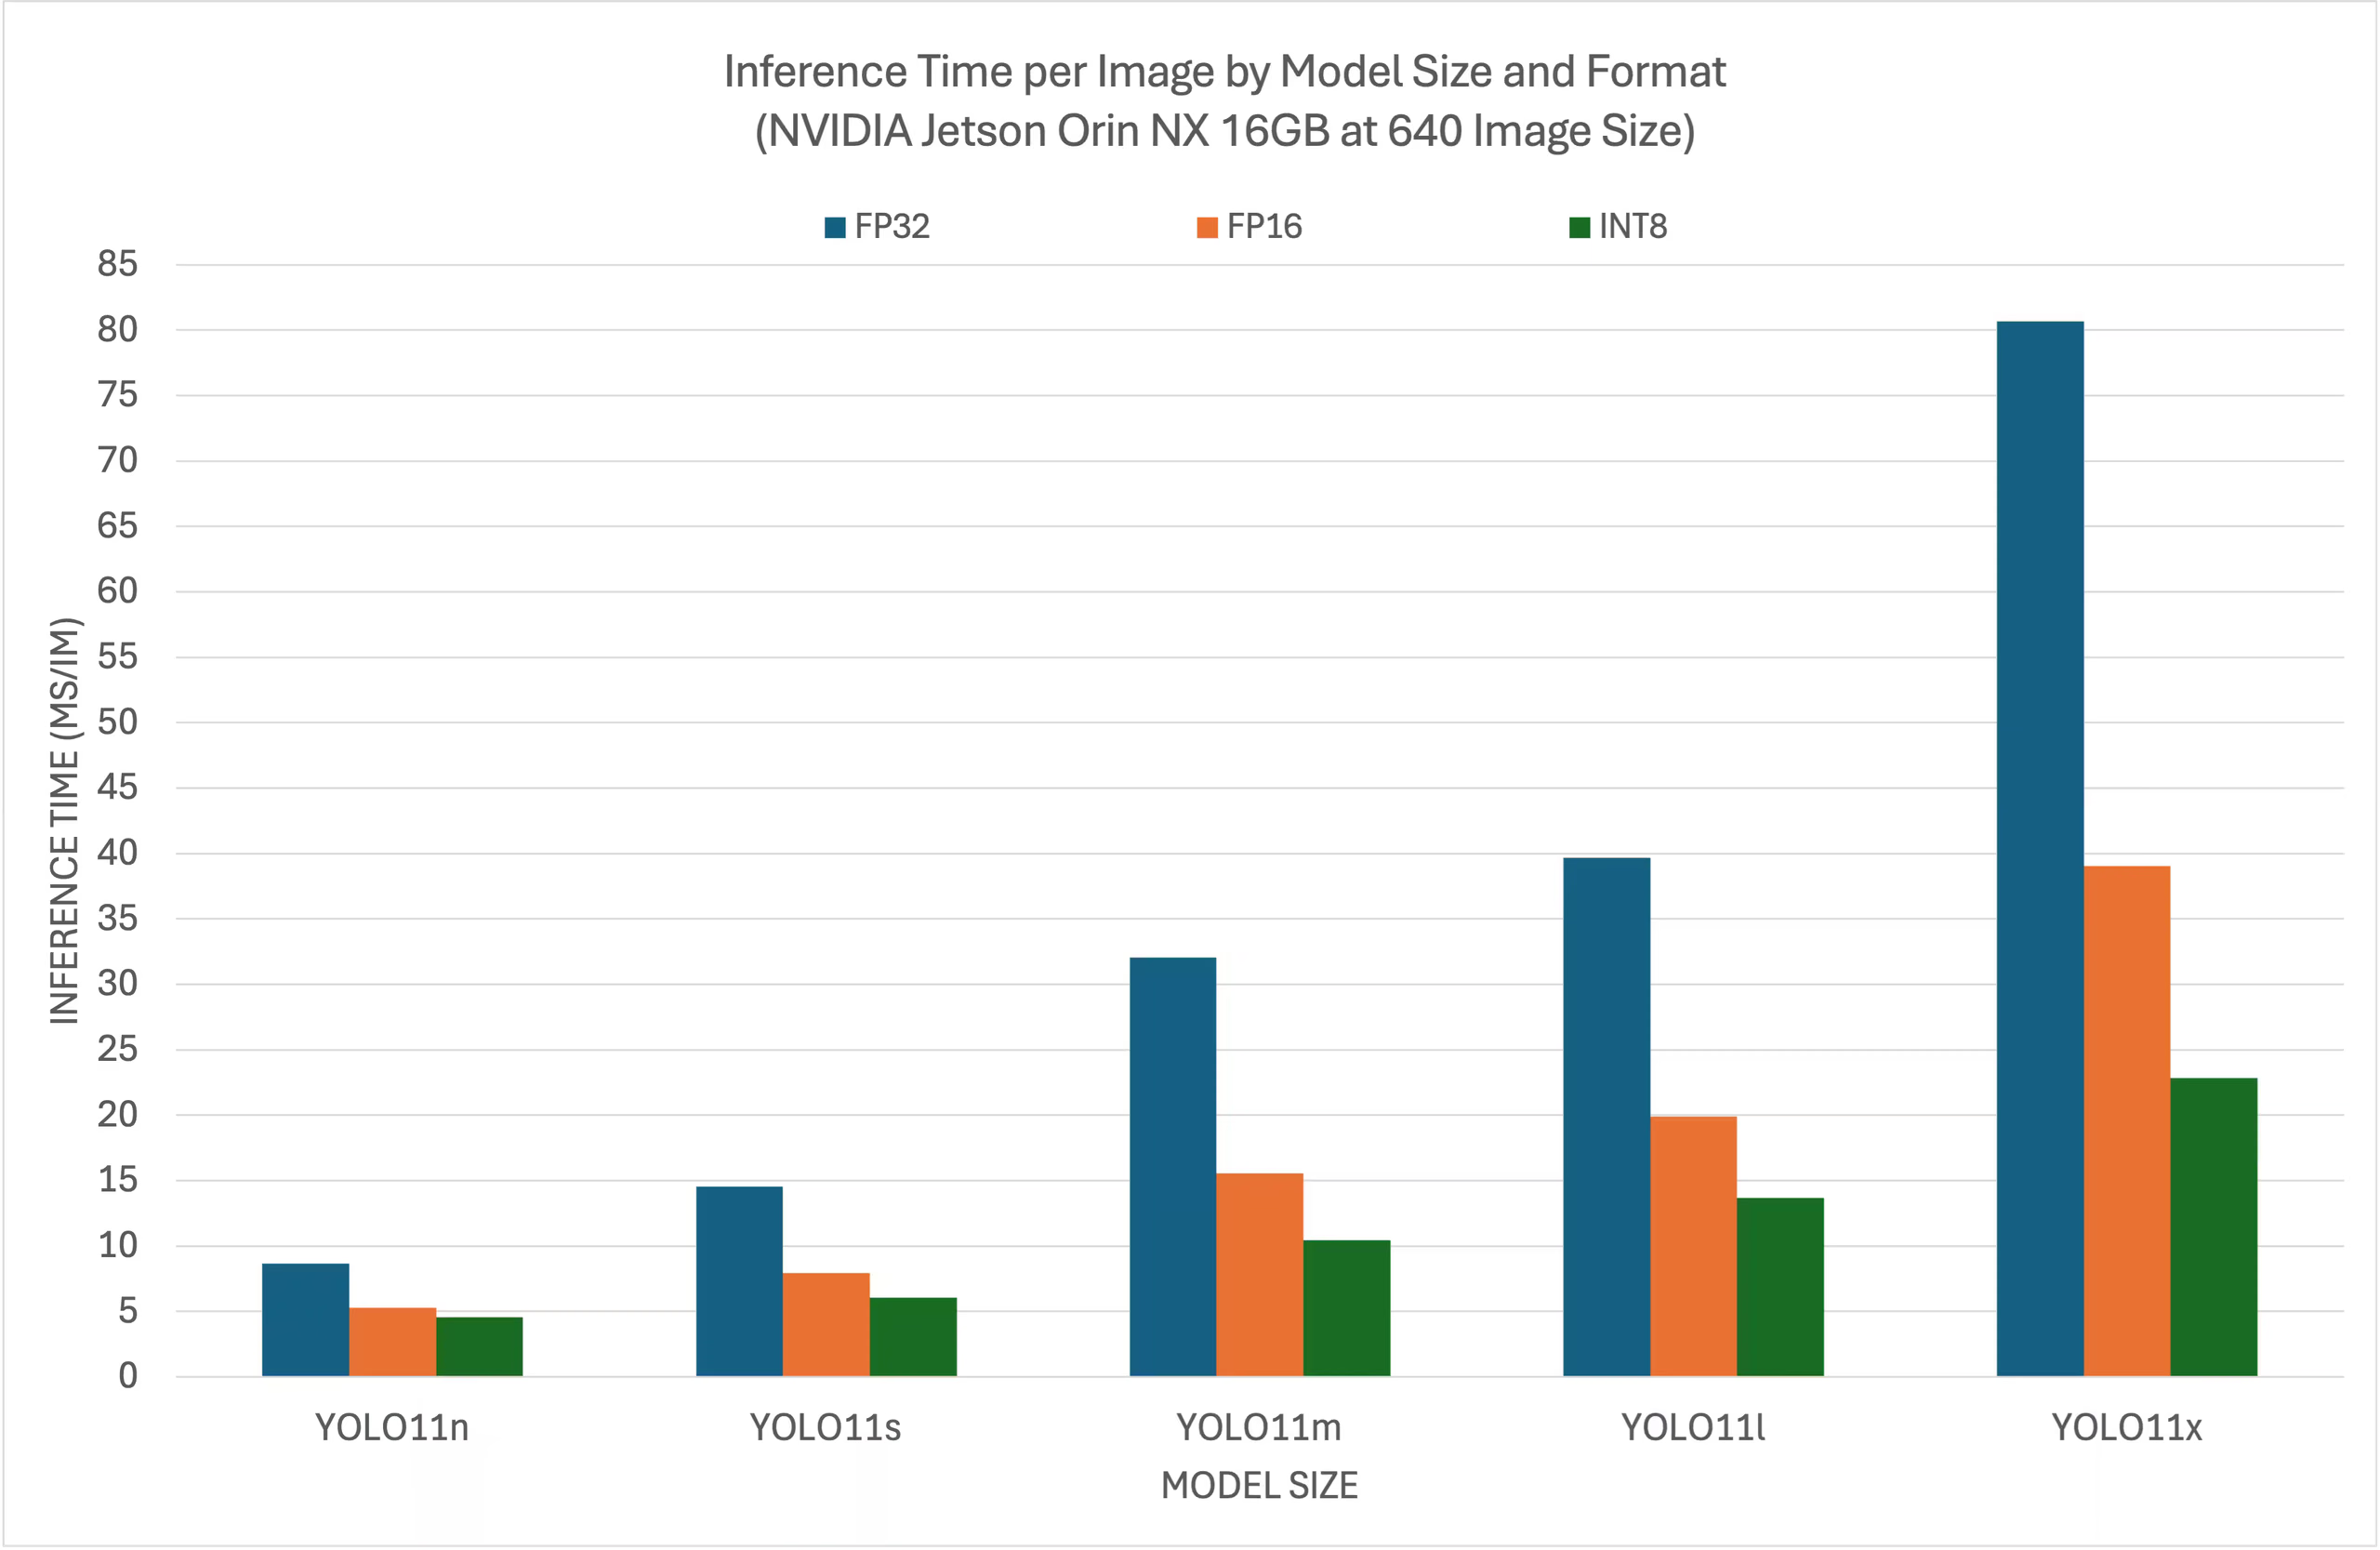
تلخص الاختبارات المعيارية التالية أداء نماذج YOLO11 بمستويات دقة TensorRT المختلفة، مع حجم إدخال 640x640 على NVIDIA Jetson Orin NX بسعة 16GB. يستخدم YOLO26 سير عمل التصدير والاستدلال في DeepStream نفسه الموضح أعلاه.
رسم بياني للمقارنة#
جدول مقارنة مفصل#
| التنسيق | الحالة | وقت الاستدلال (ms/im) |
|---|---|---|
| TensorRT (FP32) | ✅ | 8.64 |
| TensorRT (FP16) | ✅ | 5.27 |
| TensorRT (INT8) | ✅ | 4.54 |
شكر وتقدير#
أُعدّ هذا الدليل في البداية بمساهمة صديقينا Lakshantha وElaine من Seeed Studio.
الأسئلة الشائعة#
لإعداد Ultralytics YOLO26 على جهاز NVIDIA Jetson، عليك أولًا تثبيت DeepStream SDK المتوافق مع إصدار JetPack لديك. اتبع الخطوات الواردة في دليل البدء السريع لإعداد NVIDIA Jetson لنشر YOLO26.
يُحسّن استخدام TensorRT مع YOLO26 النموذج للاستدلال، مما يقلل زمن الاستجابة بدرجة كبيرة ويزيد معدل الإنتاجية على أجهزة NVIDIA Jetson. ويوفر TensorRT استدلال التعلم العميق عالي الأداء ومنخفض زمن الاستجابة من خلال دمج الطبقات ومعايرة الدقة والضبط التلقائي للنوى. وينتج عن ذلك تنفيذ أسرع وأكثر كفاءة، وهو مفيد خصوصًا للتطبيقات الآنية مثل تحليلات الفيديو والآلات ذاتية التشغيل.
نعم، يتوافق دليل نشر Ultralytics YOLO26 باستخدام DeepStream SDK وTensorRT مع جميع أجهزة NVIDIA Jetson. ويشمل ذلك أجهزة مثل Jetson Orin NX بسعة 16GB مع JetPack 5.1.3، وJetson Nano بسعة 4GB مع JetPack 4.6.4. راجع قسم إعداد DeepStream لـ YOLO26 للاطلاع على الخطوات التفصيلية.
صدّر النموذج باستخدام مُصدِّر Ultralytics مع رأس خالٍ من NMS، وأنشئ الملف
labels.txtالذي يقرأ DeepStream منه أسماء الفئات:from ultralytics import YOLO model = YOLO("yolo26s.pt") model.export(format="onnx", nms=False, agnostic_nms=True) # ينشئ 'yolo26s.onnx' with open("labels.txt", "w") as f: f.write("\n".join(model.names.values()))أضف
opset=12لاستخدام TensorRT 8.2 أو إصدار أقدم (DeepStream 6.0.1 والإصدارات الأقدم). لمزيد من التفاصيل حول تحويل النماذج، راجع قسم تصدير النماذج.لتشغيل استدلال INT8، عاير النموذج باستخدام مجموعة صور ممثلة، وبدّل إعداد DeepStream إلى وضع INT8. نزّل صور COCO val2017، واختر نحو 1000 صورة للمعايرة، واضبط متغيري البيئة
INT8_CALIB_IMG_PATHوINT8_CALIB_BATCH_SIZE، ثم حدّثconfig_infer_primary_yolo26.txtباستخدامmodel-engine-file=model_b1_gpu0_int8.engineوint8-calib-file=calib.tableوnetwork-mode=1. راجع قسم معايرة INT8 للاطلاع على الخطوات كاملة. يتطلب INT8 حاليًا TensorRT 8.x.لمعالجة عدة تدفقات في تطبيق DeepStream واحد، عدّل الملف
deepstream_app_config.txtلإضافة شبكة عرض متجانبة وإدراج URI لكل مصدر. اضبطrowsوcolumnsضمن[tiled-display]لإنشاء الشبكة، وأضف مجموعة[sourceN]منفصلة لكل تدفق، معuriوnum-sources=1خاصين بها، ثم اضبط الشبكة لتناسب عدد التدفقات. راجع قسم إعداد تدفقات متعددة للاطلاع على مثال كامل.يختلف أداء نماذج YOLO11 على NVIDIA Jetson Orin NX بسعة 16GB بحسب مستويات دقة TensorRT. فعلى سبيل المثال، تحقق نماذج YOLO11s ما يلي:
- دقة FP32: 14.53 ms/im، و68.8 FPS
- دقة FP16: 7.91 ms/im، و126 FPS
- دقة INT8: 6.05 ms/im، و165 FPS
تؤكد هذه الاختبارات المعيارية كفاءة وقدرات استخدام نماذج YOLO11 المحسّنة باستخدام TensorRT على أجهزة NVIDIA Jetson. لمزيد من التفاصيل، راجع قسم نتائج الاختبارات المعيارية.