Strategien zur Datenerfassung und Annotation für Computer Vision#
Datenerfassung und Annotation sind die beiden grundlegenden Schritte jedes Computer-Vision-Projekts: Du sammelst repräsentative Bilder oder Videos und beschriftest sie anschließend, damit ein Modell daraus lernen kann. Die Qualität dieser Daten bestimmt unmittelbar die Modellleistung. Deshalb sind die Definition der Klassen, eine unverzerrte Datenauswahl und eine einheitliche Annotation wichtig, bevor das Training beginnt.
Ansehen: So entwickelst du wirksame Strategien zur Datenerfassung und Annotation für Computer Vision 🚀
Dieser Leitfaden behandelt das Einrichten von Klassen und das Sammeln von Daten, die Bedeutung der Datenannotation sowie die verfügbaren Annotationstypen und -formate und effiziente Beschriftungsstrategien — jede Entscheidung orientiert sich an den Zielen deines Projekts.
Klassen einrichten und Daten sammeln#
Beim Sammeln von Bildern und Videos für ein Computer-Vision-Projekt musst du drei Entscheidungen treffen: wie viele Klassen du definierst, aus welchen Quellen du die Daten beziehst und wie du den Datensatz frei von Verzerrungen hältst.
Die passenden Klassen für dein Projekt auswählen#
Eine der ersten Fragen beim Start eines Computer-Vision-Projekts ist, wie viele Klassen aufgenommen werden sollen. Du musst festlegen, welche Objekte zu welcher Klasse gehören. Dazu gehören die verschiedenen Kategorien oder Bezeichnungen, die dein Modell erkennen und unterscheiden soll. Die Anzahl der Klassen richtet sich nach den konkreten Zielen deines Projekts.
Wenn du zum Beispiel den Verkehr überwachen möchtest, könnten deine Klassen „Auto“, „Lkw“, „Bus“, „Motorrad“ und „Fahrrad“ umfassen. Wenn du dagegen Artikel in einem Geschäft nachverfolgen möchtest, könnten deine Klassen „Obst“, „Gemüse“, „Getränke“ und „Snacks“ lauten. Wenn du die Klassen anhand deiner Projektziele definierst, bleibt dein Datensatz relevant und fokussiert.
Bei der Definition deiner Klassen musst du außerdem entscheiden, ob du eine grobe oder eine feine Klasseneinteilung wählst. „Anzahl“ bezieht sich auf die Zahl der unterschiedlichen Klassen, die dich interessieren. Diese Entscheidung beeinflusst die Granularität deiner Daten und die Komplexität deines Modells. Für beide Ansätze gibt es folgende Überlegungen:
- Grobe Klasseneinteilung: Das sind breitere, umfassendere Kategorien wie „Fahrzeug“ und „kein Fahrzeug“. Sie vereinfachen die Annotation und benötigen weniger Rechenressourcen, liefern aber weniger detaillierte Informationen und können dadurch die Wirksamkeit des Modells in komplexen Szenarien einschränken.
- Feine Klasseneinteilung: Dabei gibt es mehr Kategorien mit genaueren Unterscheidungen, zum Beispiel „Limousine“, „SUV“, „Pickup“ und „Motorrad“. So werden detailliertere Informationen erfasst, was die Genauigkeit und Leistung des Modells verbessert. Die Annotation ist jedoch zeitaufwendiger und arbeitsintensiver und erfordert mehr Rechenressourcen.
Mit spezifischeren Klassen zu beginnen, kann sehr hilfreich sein, insbesondere bei komplexen Projekten, in denen Details wichtig sind. Spezifischere Klassen ermöglichen es dir, detailliertere Daten zu sammeln, tiefere Einblicke zu gewinnen und Kategorien klarer voneinander abzugrenzen. Das verbessert nicht nur die Genauigkeit des Modells, sondern erleichtert auch spätere Anpassungen und spart Zeit und Ressourcen.
Datenquellen#
Du kannst öffentliche Datensätze verwenden oder eigene Daten erfassen. Öffentliche Datensätze, etwa auf Kaggle und in der Google-Suche für Datensätze, bieten gut annotierte, standardisierte Daten und eignen sich daher gut als Ausgangspunkt für das Training und die Validierung von Modellen.
Mit eigenen Daten kannst du deinen Datensatz dagegen genau auf deine Anforderungen zuschneiden. Du kannst Bilder und Videos mit Kameras oder Drohnen aufnehmen, im Web nach Bildern suchen oder bereits vorhandene interne Daten deiner Organisation verwenden. Eigene Daten geben dir mehr Kontrolle über deren Qualität und Relevanz. Durch die Kombination öffentlicher und eigener Datenquellen entsteht ein vielfältiger und umfassender Datensatz.
Verzerrungen bei der Datenerfassung vermeiden#
Eine Verzerrung liegt vor, wenn bestimmte Gruppen oder Szenarien in deinem Datensatz unter- oder überrepräsentiert sind. Dadurch entsteht ein Modell, das mit manchen Daten gut und mit anderen schlecht funktioniert. Es ist wichtig, Verzerrungen in KI zu vermeiden, damit dein Computer-Vision-Modell in unterschiedlichsten Szenarien zuverlässig arbeitet.
So kannst du Verzerrungen bei der Datenerfassung vermeiden:
- Vielfältige Quellen: Sammle Daten aus vielen Quellen, um unterschiedliche Perspektiven und Szenarien abzudecken.
- Ausgewogene Repräsentation: Berücksichtige alle relevanten Gruppen ausgewogen. Achte zum Beispiel auf unterschiedliche Altersgruppen, Geschlechter und ethnische Zugehörigkeiten.
- Kontinuierliche Überprüfung: Überprüfe und aktualisiere deinen Datensatz regelmäßig, um neu auftretende Verzerrungen zu erkennen und zu beheben.
- Verfahren zur Verringerung von Verzerrungen: Verwende Methoden wie das Überabtasten unterrepräsentierter Klassen, Datenerweiterung und Algorithmen, die Fairness berücksichtigen.
Mit diesen Vorgehensweisen entsteht ein robusteres und faireres Modell, das sich gut auf reale Anwendungen übertragen lässt.
Was ist Datenannotation?#
Datenannotation ist das Beschriften von Daten, damit sie zum Trainieren von Modellen des maschinellen Lernens verwendet werden können. Bei Computer Vision bedeutet das, Bilder oder Videos mit den Informationen zu versehen, die ein Modell zum Lernen benötigt. Ohne korrekt annotierte Daten können Modelle die Zusammenhänge zwischen Eingaben und Ausgaben nicht präzise erlernen.
Arten der Datenannotation#
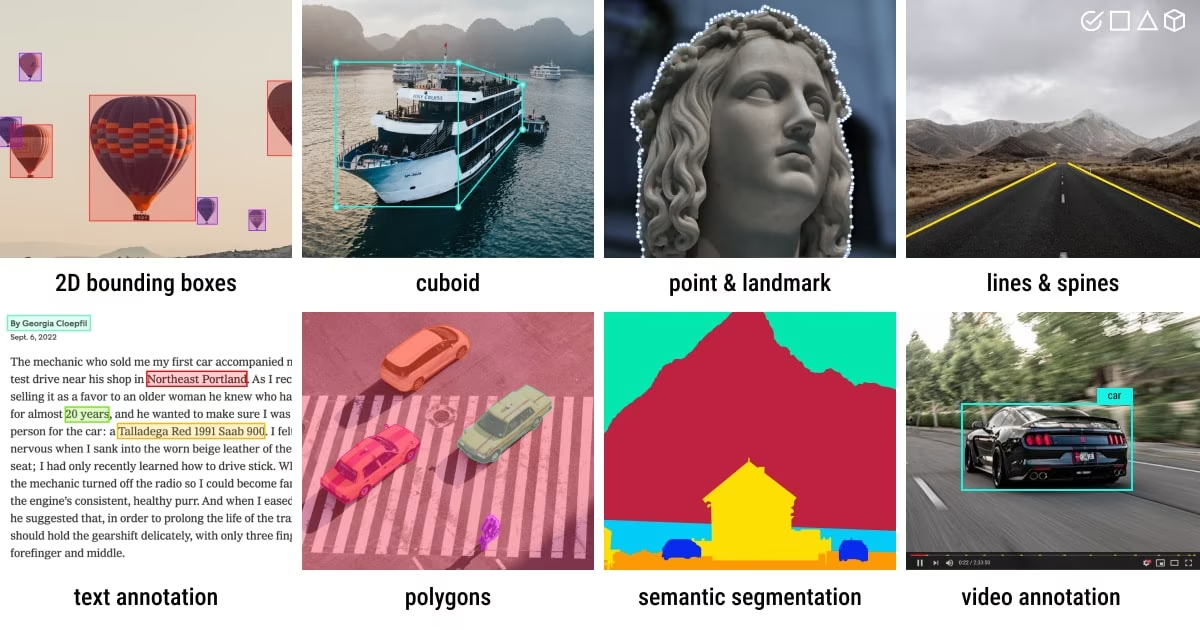
Je nach den konkreten Anforderungen einer Computer-Vision-Aufgabe kommen verschiedene Arten der Datenannotation infrage. Hier sind einige Beispiele:
- Bounding Boxes: Rechtecke, die um Objekte in einem Bild gezeichnet werden und hauptsächlich bei Aufgaben zur Objekterkennung zum Einsatz kommen. Diese Boxen werden durch ihre Koordinaten oben links und unten rechts definiert.
- Polygone: Detaillierte Umrisse von Objekten, die eine genauere Annotation als Bounding Boxes ermöglichen. Polygone kommen bei Aufgaben wie der Instanzsegmentierung zum Einsatz, bei denen die Form des Objekts wichtig ist.
- Masken: Binäre Masken, bei denen jedes Pixel entweder zum Objekt oder zum Hintergrund gehört. Masken liefern bei Aufgaben zur semantischen Segmentierung Details auf Pixelebene.
- Keypoints: Bestimmte Punkte in einem Bild, die Positionen von Interesse kennzeichnen. Keypoints werden bei Aufgaben wie der Posenschätzung und der Erkennung von Gesichtsmarken verwendet.
- Orientierte Bounding Boxes: Rechtecke mit einem Rotationswinkel, die bei OBB-Aufgaben verwendet werden, wenn Objekte in beliebiger Ausrichtung erscheinen, zum Beispiel in Luftbildern.
Gängige Annotationsformate#
Nachdem du einen Annotationstyp ausgewählt hast, solltest du das passende Format zum Speichern und Teilen der Annotationen wählen. Die gängigsten Formate sind:
| Format | Dateistruktur | Typische Verwendung |
|---|---|---|
| COCO | Eine einzelne JSON-Datei | Objekterkennung, Instanzsegmentierung, Keypoint-Erkennung, Stuff- und panoptische Segmentierung, Bildbeschriftung |
| Pascal VOC | Eine XML-Datei pro Bild | Objekterkennung |
| YOLO | Eine .txt-Datei pro Bild | Objekterkennung, Segmentierung, Pose und orientierte Boxen |
Das YOLO-Format speichert eine Zeile pro Objekt, wobei die Klassenindizes bei 0 beginnen. Bei der Objekterkennung hat die Zeile das Format class x_center y_center width height mit auf 0–1 normierten Koordinaten. In einer Segmentierungszeile wird die Box durch die normierten Polygonpunkte des Objekts ersetzt, während eine Posenzeile die Box beibehält und dahinter die Keypoint-Koordinaten anfügt. Wenn der Datensatz kpt_shape: [n, 3] deklariert, wird für jeden Keypoint außerdem ein Sichtbarkeitsflag angegeben. Eine OBB-Zeile speichert class x1 y1 x2 y2 x3 y3 x4 y4 anhand normierter Eckpunktkoordinaten.
Wenn dein Annotationswerkzeug COCO-JSON exportiert, kannst du es entweder in YOLO-Labels im Format .txt umwandeln oder direkt mit dem JSON trainieren, indem du eine eigene Dataset-Klasse verwendest.
Annotationsrichtlinien festlegen#
Nachdem du Annotationstyp und Format ausgewählt hast, solltest du als Nächstes klare und objektive Beschriftungsregeln festlegen. Diese Regeln sorgen während des gesamten Annotationsprozesses für Einheitlichkeit und Genauigkeit. Dazu gehören insbesondere:
- Klarheit und Detailgenauigkeit: Achte auf klare Anweisungen. Zeige anhand von Beispielen und Abbildungen, was erwartet wird.
- Einheitlichkeit: Halte deine Annotationen einheitlich. Lege einheitliche Kriterien für die Annotation verschiedener Datentypen fest, damit alle Annotationen denselben Regeln folgen.
- Verzerrungen verringern: Bleib neutral. Übe, objektiv zu arbeiten und persönliche Verzerrungen zu minimieren, damit die Annotationen fair sind.
- Effizienz: Arbeite effizient statt unnötig aufwendig. Nutze Werkzeuge und Arbeitsabläufe, die wiederkehrende Aufgaben automatisieren und den Annotationsprozess beschleunigen und effizienter machen.
Wenn du deine Beschriftungsregeln regelmäßig überprüfst und aktualisierst, bleiben deine Annotationen genau und einheitlich und stimmen mit den Zielen deines Projekts überein.
Annotationswerkzeuge#
Mit einem guten Annotationswerkzeug kannst du alle für deine Aufgabe benötigten Typen beschriften, einheitliche Richtlinien durchsetzen und Labels in einem trainingsfertigen Format exportieren. Die Ultralytics Platform bietet einen integrierten Annotationseditor für Erkennung, Instanzsegmentierung, semantische Segmentierung, Klassifizierung, Pose und OBB. Die intelligente Annotation mit SAM wandelt einen einzelnen Klick in eine Maske für Aufgaben zur Erkennung, Instanzsegmentierung, semantischen Segmentierung und OBB um. Da die Annotationen im jeweils erwarteten Layout gespeichert werden — als YOLO-Zeilen im Format .txt für räumliche Aufgaben und als Klassenordner für die Klassifizierung — kann dein beschrifteter Datensatz ohne Konvertierung direkt für das Training verwendet werden.
Annotationsqualität: Genauigkeit, Präzision und Ausreißer#
Bevor du mit der Annotation großer Datenmengen beginnst, solltest du Genauigkeit, Präzision, Ausreißer und Qualitätskontrolle verstehen, damit du deine Daten nicht auf kontraproduktive Weise beschriftest.
Genauigkeit und Präzision verstehen#
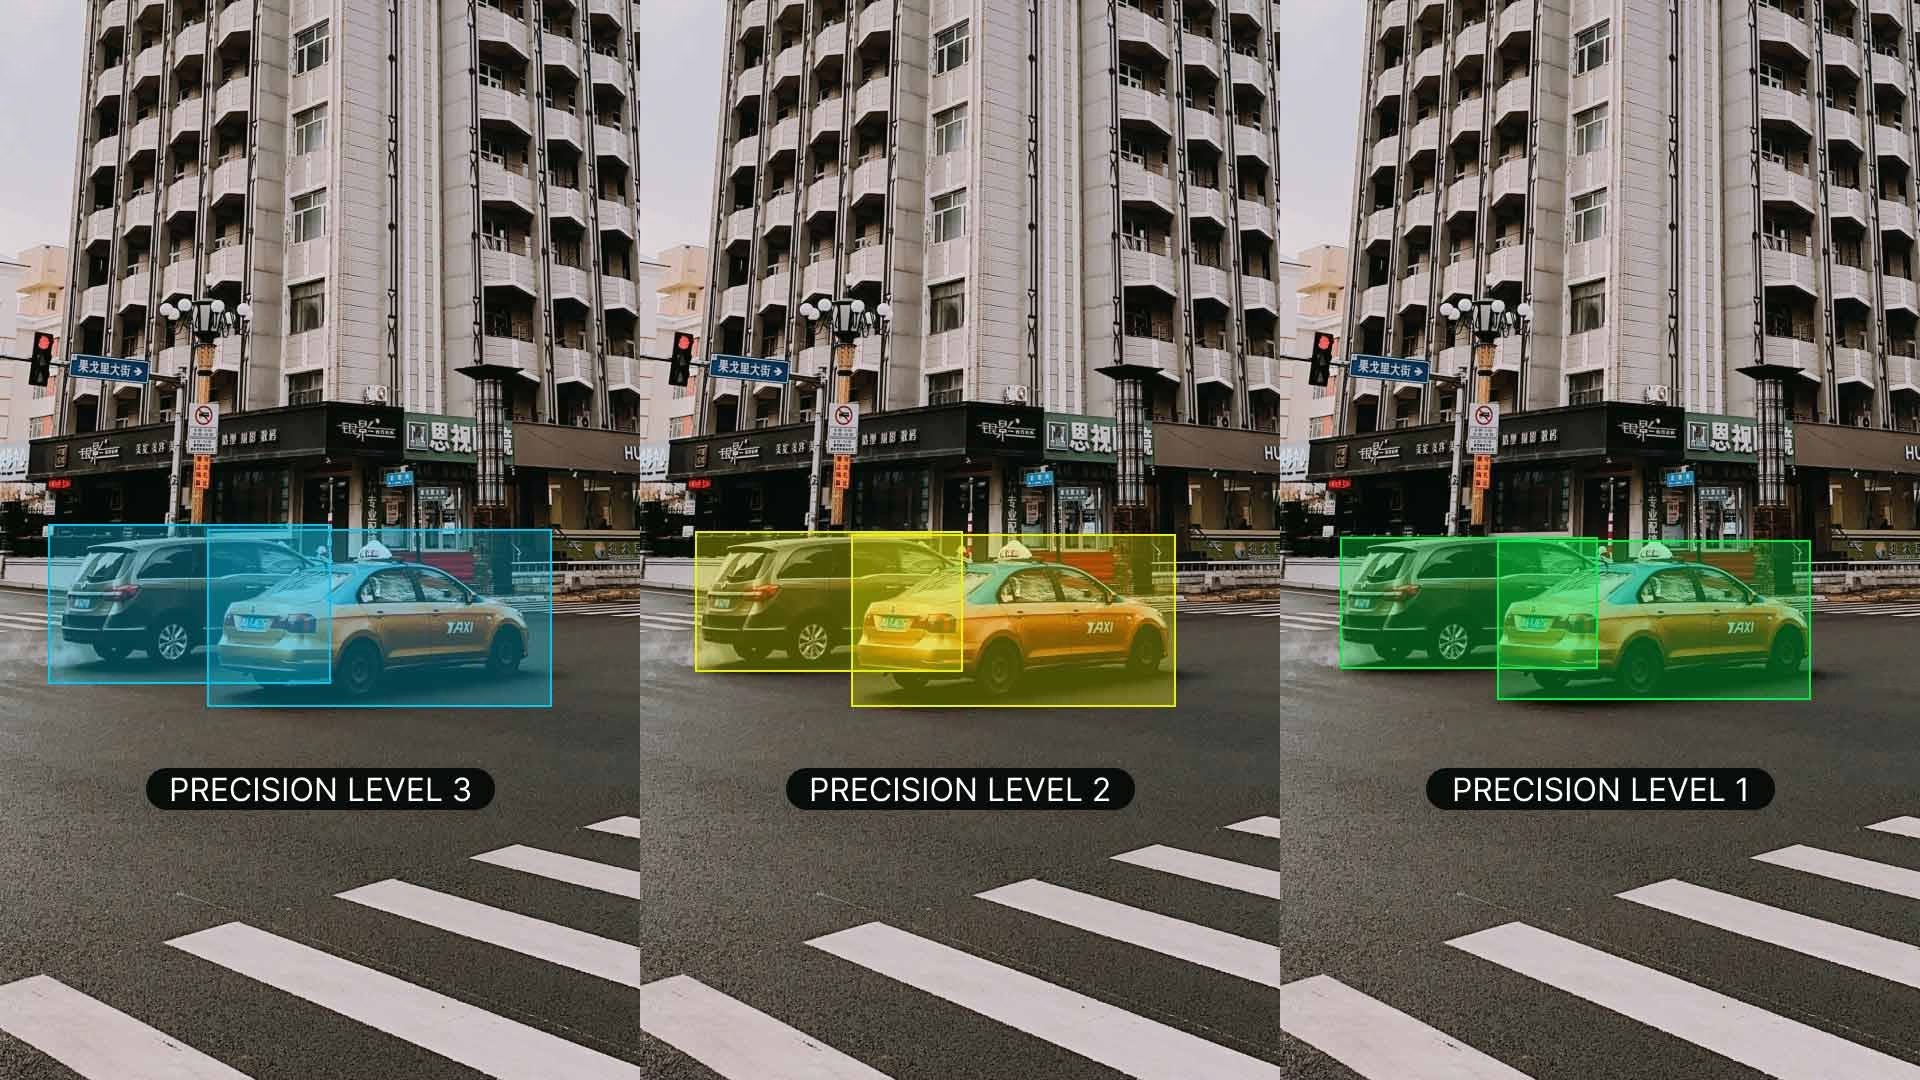
Es ist wichtig, den Unterschied zwischen Genauigkeit und Präzision und ihre Bedeutung für die Annotation zu verstehen. Genauigkeit beschreibt, wie nahe die annotierten Daten an den tatsächlichen Werten liegen. Sie hilft uns zu messen, wie genau die Labels reale Szenarien widerspiegeln. Präzision gibt an, wie einheitlich die Annotationen sind. Sie zeigt, ob du dasselbe Objekt oder Merkmal im gesamten Datensatz stets gleich beschriftest. Hohe Genauigkeit und Präzision führen zu besser trainierten Modellen, da sie das Rauschen verringern und die Fähigkeit des Modells verbessern, aus den Trainingsdaten zu generalisieren.
Ausreißer erkennen#
Ausreißer sind Datenpunkte, die deutlich von den übrigen Beobachtungen im Datensatz abweichen. Bei Annotationen kann ein Ausreißer ein falsch beschriftetes Bild oder eine Annotation sein, die nicht zum Rest des Datensatzes passt. Ausreißer sind problematisch, weil sie den Lernprozess des Modells verzerren und zu ungenauen Vorhersagen und schlechter Generalisierung führen können.
Mit verschiedenen Methoden kannst du Ausreißer erkennen und korrigieren:
- Statistische Verfahren: Um Ausreißer in numerischen Merkmalen wie Pixelwerten, Bounding-Box-Koordinaten oder Objektgrößen zu erkennen, kannst du Verfahren wie Boxplots, Histogramme oder Z-Werte verwenden.
- Visuelle Verfahren: Um Auffälligkeiten in kategorialen Merkmalen wie Objektklassen, Farben oder Formen zu erkennen, kannst du Bilder, Labels oder Heatmaps grafisch darstellen.
- Algorithmische Verfahren: Nutze Werkzeuge wie Clustering, zum Beispiel K-Means-Clustering und DBSCAN, sowie Algorithmen zur Anomalieerkennung, um anhand von Mustern in der Datenverteilung Ausreißer zu erkennen.
Qualitätskontrolle annotierter Daten#
Wie bei anderen technischen Projekten ist die Qualitätskontrolle auch bei annotierten Daten unverzichtbar. Es empfiehlt sich, Annotationen regelmäßig auf Genauigkeit und Einheitlichkeit zu prüfen. Dafür gibt es verschiedene Möglichkeiten:
- Stichproben annotierter Daten überprüfen
- Automatisierte Werkzeuge verwenden, um häufige Fehler zu erkennen
- Eine weitere Person bitten, die Annotationen gegenzuprüfen
Wenn du mit mehreren Personen arbeitest, ist die Einheitlichkeit zwischen den einzelnen Annotatoren wichtig. Eine gute Übereinstimmung zwischen Annotatoren zeigt, dass die Richtlinien klar sind und alle sie gleich anwenden. So sind alle auf dem gleichen Stand und die Annotationen bleiben einheitlich.
Wenn du bei der Überprüfung Fehler findest, korrigiere sie und aktualisiere die Richtlinien, damit sie künftig nicht wieder auftreten. Gib den Annotatoren Feedback und biete regelmäßig Schulungen an, um Fehler zu verringern. Ein klar geregelter Umgang mit Fehlern trägt dazu bei, dass dein Datensatz genau und zuverlässig bleibt.
Effiziente Strategien zur Datenannotation#
Damit die Datenannotation reibungsloser und effektiver abläuft, kannst du folgende Strategien umsetzen:
- Klare Annotationsrichtlinien: Gib detaillierte Anweisungen mit Beispielen, damit alle Annotierenden die Aufgaben einheitlich interpretieren. Lege beispielsweise bei der Annotation von Vögeln fest, ob der ganze Vogel oder nur bestimmte Teile erfasst werden sollen.
- Regelmäßige Qualitätsprüfungen: Lege Richtwerte fest und überprüfe die Arbeit anhand konkreter Kennzahlen. Halte durch kontinuierliches Feedback hohe Qualitätsstandards ein.
- Tools für Vorannotationen nutzen: Viele moderne Annotationsplattformen bieten KI-gestützte Funktionen für Vorannotationen. Sie können den Prozess erheblich beschleunigen, indem sie automatisch erste Annotationen erstellen, die anschließend von Menschen verfeinert werden.
- Aktives Lernen einsetzen: Bei diesem Ansatz werden zuerst die aussagekräftigsten Beispiele annotiert. So lässt sich die Gesamtzahl der erforderlichen Annotationen verringern, ohne die Modellleistung zu beeinträchtigen.
- Stapelverarbeitung: Gruppiere ähnliche Bilder für die Annotation, um Einheitlichkeit zu gewährleisten und die Effizienz zu steigern.
Mit diesen Strategien kannst du hochwertige Annotationen sicherstellen und zugleich den Zeit- und Ressourcenaufwand für die Datenannotation verringern.
Fazit#
Vielfältige, unverzerrte Daten zu sammeln und sie mit den passenden Tools einheitlich zu annotieren, bildet die Grundlage für ein zuverlässiges Computer-Vision-Modell. Sobald du deinen Datensatz zusammengestellt und annotiert hast, kannst du mit dem Leitfaden zu den Schritten eines Computer-Vision-Projekts mit Training und Evaluierung fortfahren. Wenn unterwegs Fragen auftauchen, wende dich an die Community im Ultralytics GitHub-Repository oder auf dem Ultralytics Discord-Server.
Häufig gestellte Fragen#
Um Verzerrungen zu minimieren, sammelst du Daten aus vielfältigen Quellen und sorgst für eine ausgewogene Repräsentation aller relevanten Gruppen, etwa verschiedener Altersgruppen, Geschlechter und ethnischer Zugehörigkeiten. Überprüfe und aktualisiere deinen Datensatz regelmäßig, um neu auftretende Verzerrungen zu erkennen, und wende Gegenmaßnahmen wie das Überabtasten unterrepräsentierter Klassen, Datenerweiterung und fairnessbewusste Algorithmen an. So bleibt die Leistung deines Computer-Vision-Modells in unterschiedlichen realen Anwendungsszenarien hoch und seine Generalisierungsfähigkeit verbessert sich.
Erstelle klare, objektive Annotationsrichtlinien mit detaillierten Anweisungen, Beispielen und Abbildungen und wende sie einheitlich auf alle Datentypen an, damit für jede Annotation dieselben Regeln gelten. Schule die Annotierenden darin, neutral zu bleiben und persönliche Verzerrungen zu verringern. Überprüfe und aktualisiere die Richtlinien regelmäßig und nutze automatisierte Konsistenzprüfungen sowie Feedback zwischen den Annotierenden, um eine hohe Genauigkeit und die Übereinstimmung mit deinen Projektzielen sicherzustellen.
Ein paar hundert annotierte Objekte pro Klasse reichen aus, um mit Transfer Learning zu experimentieren. Für zuverlässige Leistung in der Praxis empfiehlt Ultralytics jedoch mindestens 1.500 Bilder und 10.000 annotierte Instanzen pro Klasse. Kombiniere einen ausreichend großen Datensatz mit einem angemessenen Trainingsplan – etwa 300 Epochen sind ein üblicher Ausgangspunkt; reduziere die Zahl, wenn das Modell früh überangepasst wird – und achte darauf, sorgfältig zu annotieren und die Annotationen an den konkreten Zielen deines Projekts auszurichten. Weitere Trainingsstrategien findest du im YOLO26-Trainingsleitfaden.
Ja. Die Ultralytics Platform enthält einen integrierten Annotationseditor, der Begrenzungsrahmen, Polygone, Keypoints, gedrehte Begrenzungsrahmen und Klassifikationslabels in einem einzigen Arbeitsbereich unterstützt. Die intelligente, durch SAM unterstützte Annotation beschleunigt die Annotation für Objekterkennung, Instanzsegmentierung, semantische Segmentierung und OBB-Aufgaben, indem sie mit einem einzigen Klick Masken erstellt. Für Pose-Datensätze können YOLO-Pose-Modelle zur intelligenten Annotation verwendet werden; Klassifikationen werden manuell annotiert. Die Annotationen werden im für die jeweilige Aufgabe erforderlichen Format gespeichert – YOLO-
.txt-Zeilen für räumliche Aufgaben und Klassenordner für Klassifikationen – und sind dann bereit fürs Training.Wähle den Annotationstyp passend zu der Aufgabe, für die du trainieren möchtest. Begrenzungsrahmen lassen sich am schnellsten zeichnen und reichen für die Objekterkennung aus. Polygone und Masken kosten pro Objekt deutlich mehr Zeit, sind aber für die Instanzsegmentierung erforderlich, wenn es auf die genaue Form eines Objekts ankommt. Keypoints eignen sich für die Posenschätzung und die Landmarkenerkennung. Gedrehte Begrenzungsrahmen sind für OBB-Aufgaben wie Luftbildaufnahmen geeignet, bei denen ein achsenparalleles Rechteck zu viel Hintergrund einschließen würde. Wenn du für die anspruchsvollste tatsächlich benötigte Aufgabe annotierst, bleibt der Aufwand im Verhältnis zum Ergebnis.