Die wichtigsten Schritte eines Computer-Vision-Projekts verstehen
Ein Computer-Vision-Projekt umfasst eine klare Abfolge von Phasen: Ziele festlegen, Daten sammeln und annotieren, ein Modell trainieren und evaluieren sowie es in der Produktion bereitstellen und warten. Dieser Leitfaden führt dich Schritt für Schritt durch den Ablauf und erklärt, warum jeder Schritt wichtig ist, damit du dein eigenes Projekt sicher planen und umsetzen kannst.
Computer Vision ist ein Teilgebiet der künstlichen Intelligenz (AI), das Computern hilft, die Welt wie Menschen zu sehen und zu verstehen. Dabei werden Bilder oder Videos verarbeitet und analysiert, um Informationen zu extrahieren, Muster zu erkennen und auf Grundlage dieser Daten Entscheidungen zu treffen.
Ansehen: So setzt du Computer-Vision-Projekte um | Eine Schritt-für-Schritt-Anleitung
Computer-Vision-Verfahren wie Objekterkennung, Bildklassifizierung und Instanzsegmentierung lassen sich in vielen Branchen einsetzen – vom autonomen Fahren bis zur medizinischen Bildgebung –, um wertvolle Erkenntnisse zu gewinnen.
Ein Überblick über ein Computer-Vision-Projekt#
Bevor wir die einzelnen Schritte eines Computer-Vision-Projekts genauer betrachten, sehen wir uns zunächst den gesamten Ablauf an. Wenn du heute ein Computer-Vision-Projekt startest, gehst du folgendermaßen vor:
- Deine erste Priorität ist es, die Anforderungen deines Projekts zu verstehen.
- Dann sammelst und beschriftest du sorgfältig die Bilder, mit denen du dein Modell trainierst.
- Als Nächstes bereinigst und erweiterst du deine Daten, um sie für das Modelltraining vorzubereiten.
- Nach dem Training evaluierst und testest du dein Modell gründlich, um sicherzustellen, dass es unter verschiedenen Bedingungen zuverlässig funktioniert.
- Zum Schluss stellst du dein Modell in der Praxis bereit und überwachst und wartest es anhand neuer Erkenntnisse und Rückmeldungen.
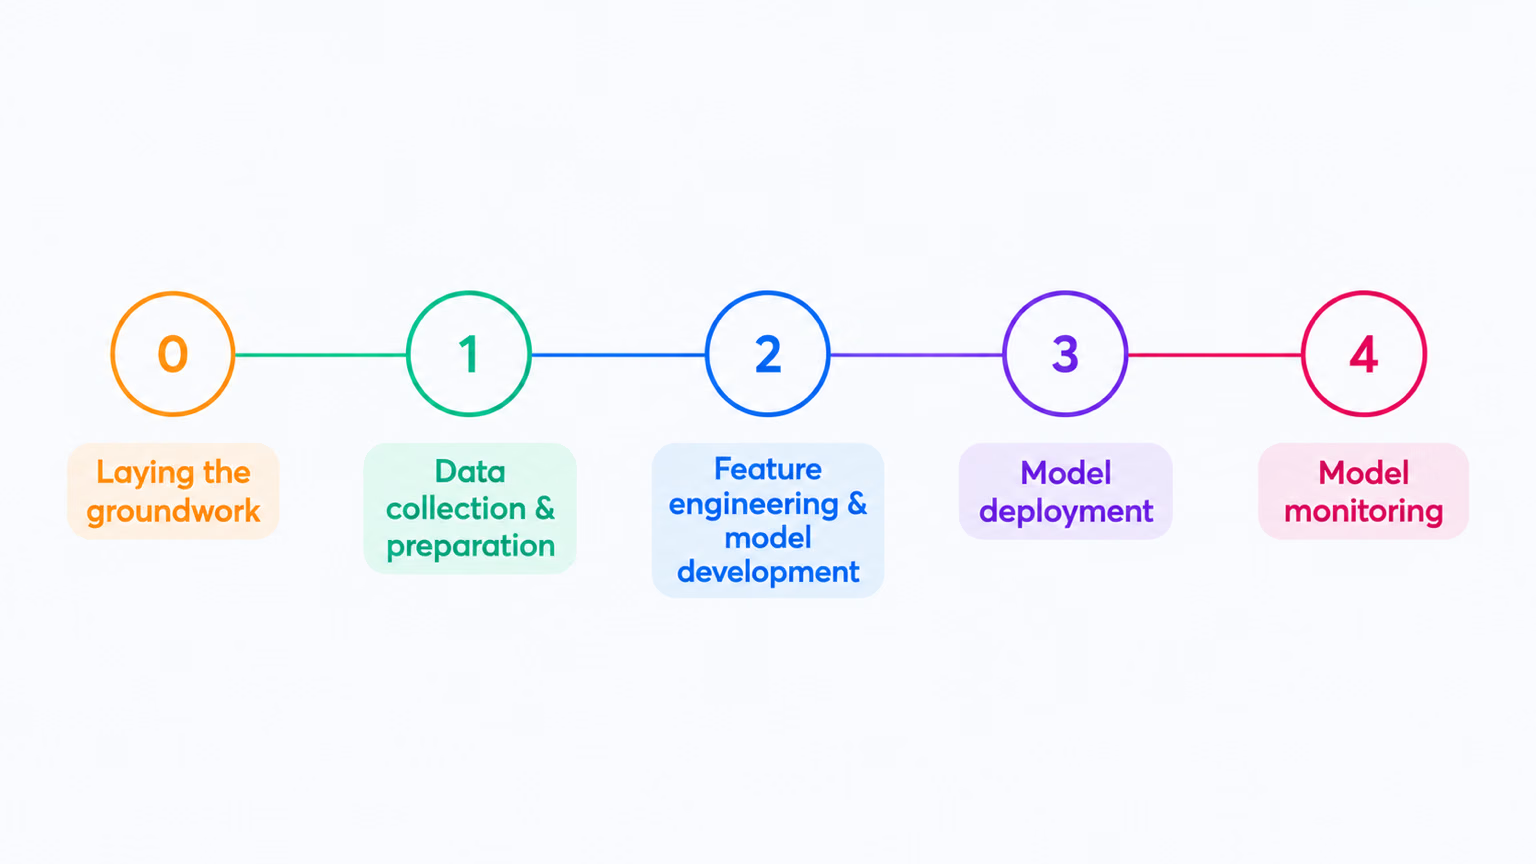
Nachdem du nun weißt, was dich erwartet, werden die folgenden Abschnitte jeden Schritt ausführlich behandeln.
Schritt 1: Projektziele festlegen#
Der erste Schritt jedes Computer-Vision-Projekts ist eine klare Definition des zu lösenden Problems. Wenn du das Endziel kennst, kannst du mit der Entwicklung einer Lösung beginnen. Das gilt besonders für Computer Vision, denn das Ziel deines Projekts wirkt sich unmittelbar darauf aus, auf welche Computer-Vision-Aufgabe du dich konzentrieren musst.
Hier sind einige Beispiele für Projektziele und Computer-Vision-Aufgaben, mit denen du diese Ziele erreichen kannst:
-
Ziel: Entwicklung eines Systems zur Überwachung und Steuerung des Verkehrsflusses verschiedener Fahrzeugtypen auf Autobahnen, um Verkehrsmanagement und Sicherheit zu verbessern.
- Computer-Vision-Aufgabe: Objekterkennung eignet sich ideal für die Verkehrsüberwachung, da sie mehrere Fahrzeuge effizient lokalisiert und identifiziert. Sie benötigt weniger Rechenleistung als die Bildsegmentierung, die für diese Aufgabe unnötige Details liefert, und ermöglicht dadurch eine schnellere Analyse in Echtzeit.
-
Ziel: Entwicklung eines Werkzeugs, das Radiologinnen und Radiologen unterstützt, indem es präzise, pixelgenaue Konturen von Tumoren in medizinischen Bildaufnahmen bereitstellt.
- Computer-Vision-Aufgabe: Die Bildsegmentierung eignet sich für die medizinische Bildgebung, da sie genaue und detaillierte Tumorgrenzen liefert, die für die Beurteilung von Größe und Form sowie die Behandlungsplanung entscheidend sind.
-
Ziel: Ein digitales System entwickeln, das verschiedene Dokumente (z. B. Rechnungen, Quittungen und juristische Unterlagen) kategorisiert, um die organisatorische Effizienz und das Auffinden von Dokumenten zu verbessern.
- Computer-Vision-Aufgabe: Die Bildklassifizierung ist hier ideal, da sie jeweils ein Dokument verarbeitet, ohne dessen Position im Bild berücksichtigen zu müssen. Dieser Ansatz vereinfacht und beschleunigt den Sortiervorgang.
Das richtige Modell und den passenden Trainingsansatz auswählen#
Nachdem du das Projektziel und die geeigneten Computer-Vision-Aufgaben verstanden hast, gehört die Auswahl des richtigen Modells und Trainingsansatzes zu den wesentlichen Schritten bei der Festlegung des Projektziels.
Je nach Ziel kannst du das Modell zuerst auswählen oder erst, nachdem du in Schritt 2 gesehen hast, welche Daten du erfassen kannst. Angenommen, dein Projekt hängt stark davon ab, ob bestimmte Datentypen verfügbar sind. Dann kann es sinnvoller sein, zuerst die Daten zu sammeln und zu analysieren und erst danach ein Modell auszuwählen. Wenn du hingegen genau weißt, welche Anforderungen das Modell erfüllen muss, kannst du zuerst das Modell auswählen und anschließend passende Daten erfassen.
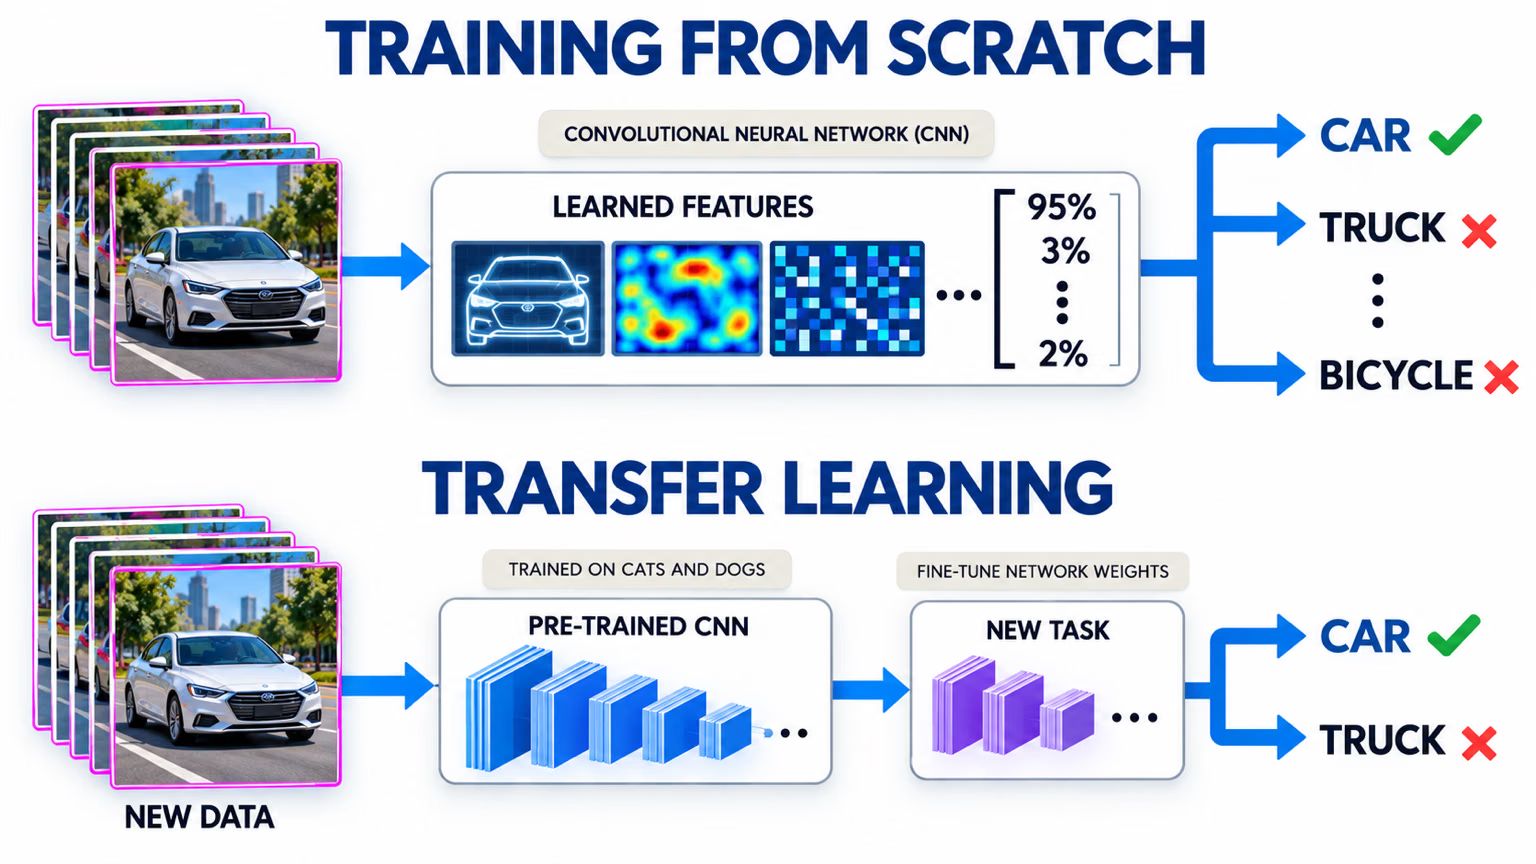
Die Entscheidung zwischen einem Training von Grund auf und Transfer Learning beeinflusst die Vorbereitung deiner Daten. Für ein Training von Grund auf benötigst du einen vielfältigen Datensatz, damit das Modell sein Wissen von Grund auf aufbauen kann. Transfer Learning ermöglicht es dir dagegen, ein vortrainiertes Modell zu verwenden und es mit einem kleineren, spezifischeren Datensatz anzupassen. Auch die Auswahl eines bestimmten Modells für das Training legt fest, wie du deine Daten gemäß den jeweiligen Anforderungen des Modells vorbereiten musst, etwa durch die Größenänderung von Bildern oder das Hinzufügen von Anmerkungen.
Berücksichtige das Bereitstellungsziel eines Modells, um Kompatibilität und Leistung sicherzustellen. Leichtgewichtige Modelle eignen sich beispielsweise dank ihrer Effizienz auf Geräten mit begrenzten Ressourcen ideal für das Edge Computing.
Weitere Informationen findest du in unserem Leitfaden zum Festlegen der Projektziele und Auswählen des richtigen Modells.
Bevor du mit der praktischen Arbeit an einem Computer-Vision-Projekt beginnst, solltest du diese Details genau verstehen. Prüfe vor dem Übergang zu Schritt 2 noch einmal, ob du Folgendes berücksichtigt hast:
- Definiere klar das Problem, das du lösen möchtest.
- Lege das endgültige Ziel deines Projekts fest.
- Bestimme die benötigte Computer-Vision-Aufgabe (z. B. Objekterkennung, Bildklassifizierung oder Bildsegmentierung).
- Entscheide, ob du ein Modell von Grund auf trainierst oder Transfer Learning verwendest.
- Wähle das passende Modell für deine Aufgabe und deine Bereitstellungsanforderungen aus.
Schritt 2: Datenerfassung und Datenannotation#
Die Qualität deiner Computer-Vision-Modelle hängt von der Qualität deines Datensatzes ab. Du kannst Bilder aus dem Internet sammeln, selbst fotografieren oder vorhandene Datensätze verwenden. Nützliche Quellen für öffentliche Datensätze sind die Google Dataset Search Engine, das UC Irvine Machine Learning Repository und Kaggle Datasets.
Einige Bibliotheken wie Ultralytics bieten integrierte Unterstützung für verschiedene Datensätze, wodurch du leichter mit hochwertigen Daten loslegen kannst. Diese Bibliotheken enthalten oft Hilfsfunktionen zum Herunterladen und Laden beliebter Datensätze, die dir in den ersten Projektphasen viel Zeit und Aufwand ersparen können.
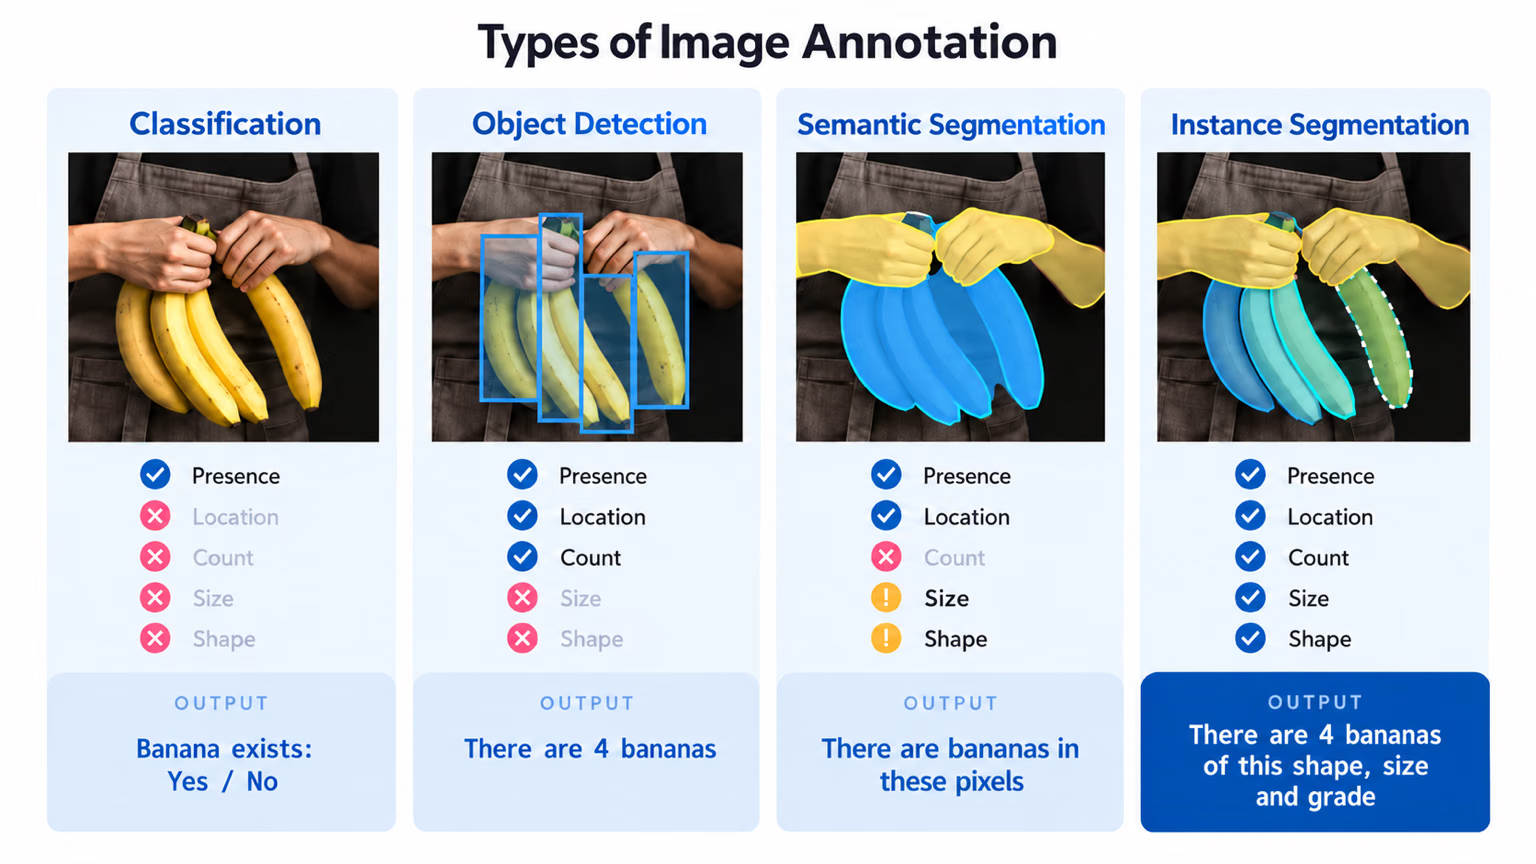
Wenn du jedoch selbst Bilder sammelst oder aufnimmst, musst du deine Daten annotieren. Bei der Datenannotation werden deine Daten beschriftet, damit dein Modell daraus lernen kann. Welche Art der Datenannotation du verwendest, hängt von deiner konkreten Computer-Vision-Methode ab. Hier sind einige Beispiele:
- Bildklassifizierung: Du ordnest dem gesamten Bild eine einzelne Klasse zu.
- Objekterkennung: Du zeichnest um jedes Objekt im Bild einen Begrenzungsrahmen und beschriftest jeden Rahmen.
- Bildsegmentierung: Du ordnest jedes Pixel im Bild dem Objekt zu, zu dem es gehört, und erstellst so detaillierte Objektgrenzen.
Datenerfassung und Annotation können viel manuelle Arbeit und Zeit in Anspruch nehmen. Ein spezielles Annotationswerkzeug beschleunigt den Prozess: Die Ultralytics Platform bietet einen integrierten Annotationseditor mit intelligenter, von SAM unterstützter Annotation für Erkennungs-, Segmentierungs- und OBB-Daten und speichert die Beschriftungen direkt im YOLO-Format.
Schritt 3: Datenerweiterung und Aufteilung deines Datensatzes#
Nachdem du deine Bilddaten gesammelt und annotiert hast, solltest du deinen Datensatz zunächst in Trainings-, Validierungs- und Testdaten aufteilen, bevor du eine Datenerweiterung durchführst. Die Aufteilung vor der Datenerweiterung ist entscheidend, damit du dein Modell mit unveränderten Originaldaten testen und validieren kannst. So lässt sich genau beurteilen, wie gut das Modell auf neue, bisher unbekannte Daten generalisiert.
So teilst du deine Daten auf:
- Trainingsdaten: Sie machen den größten Teil deiner Daten aus, in der Regel 70–80 %, und dienen zum Trainieren deines Modells.
- Validierungsdaten: Dieser Teil umfasst üblicherweise etwa 10–15 % deiner Daten. Er dient dazu, Hyperparameter anzupassen und das Modell während des Trainings zu validieren, wodurch Overfitting verhindert werden kann.
- Testdaten: Die verbleibenden 10–15 % deiner Daten bilden die Testdaten. Sie dienen dazu, die Leistung des Modells nach Abschluss des Trainings mit unbekannten Daten zu bewerten.
Nachdem du deine Daten aufgeteilt hast, kannst du sie durch Transformationen wie Drehen, Skalieren und Spiegeln der Bilder erweitern und so deinen Datensatz künstlich vergrößern. Die Datenerweiterung macht dein Modell robuster gegenüber Abweichungen und verbessert seine Leistung bei unbekannten Bildern.
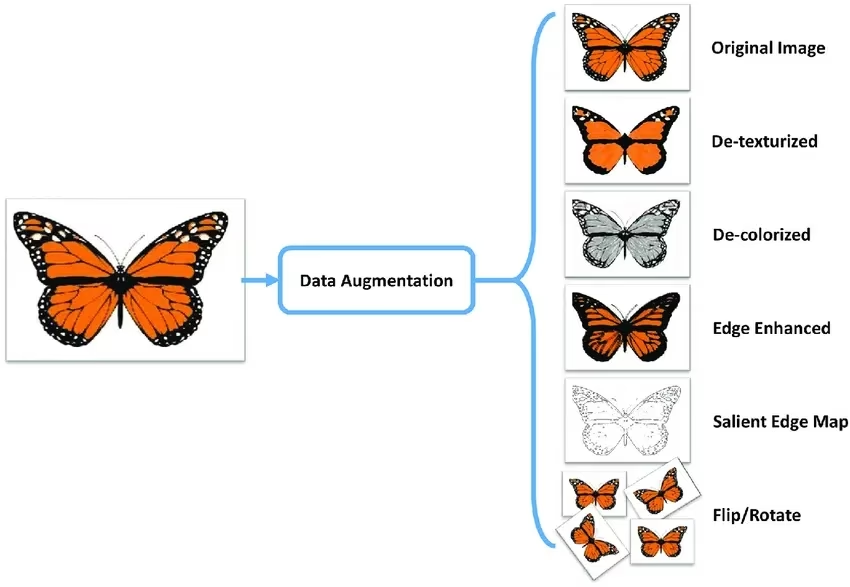
Bibliotheken wie OpenCV, Albumentations und TensorFlow bieten flexible Augmentierungsfunktionen, die du verwenden kannst. Einige Bibliotheken wie Ultralytics verfügen außerdem über integrierte Augmentierungseinstellungen, die direkt in der Modelltrainingsfunktion verfügbar sind und den Prozess vereinfachen.
Um deine Daten besser zu verstehen, kannst du Tools wie Matplotlib oder Seaborn verwenden, um Bilder zu visualisieren und ihre Verteilung und Eigenschaften zu analysieren. Die Visualisierung deiner Daten hilft dir, Muster, Anomalien und die Wirksamkeit deiner Augmentierungstechniken zu erkennen. Der Tab Charts der Ultralytics-Plattform kann viele dieser Erkenntnisse ohne Code sichtbar machen, indem er für jeden hochgeladenen Datensatz automatisch die Verteilung der Aufteilungen, Klassenanzahlen, Histogramme der Bildabmessungen und Heatmaps der Annotationspositionen erstellt.
Wenn du deine Daten richtig verstehst, aufteilst und erweiterst, kannst du ein gut trainiertes, validiertes und getestetes Modell entwickeln, das in realen Anwendungen gute Ergebnisse erzielt.
Schritt 4: Modelltraining#
Sobald dein Datensatz für das Training bereit ist, kannst du dich auf die Einrichtung der benötigten Umgebung, die Verwaltung deiner Datensätze und das Training deines Modells konzentrieren.
Zuerst musst du sicherstellen, dass deine Umgebung korrekt konfiguriert ist. Dazu gehört in der Regel Folgendes:
- Installiere wichtige Bibliotheken und Frameworks wie TensorFlow, PyTorch oder Ultralytics.
- Wenn du eine GPU verwendest, kannst du mit Bibliotheken wie CUDA und cuDNN die GPU-Beschleunigung aktivieren und den Trainingsprozess beschleunigen.
Anschließend kannst du deine Trainings- und Validierungsdatensätze in deine Umgebung laden. Normalisiere und verarbeite die Daten vor, indem du sie in der Größe anpasst, das Format umwandelst oder sie erweiterst. Wähle dein Modell aus und konfiguriere seine Schichten und Hyperparameter. Kompiliere das Modell, indem du die Verlustfunktion, den Optimierer und die Leistungsmetriken festlegst.
Bibliotheken wie Ultralytics vereinfachen den Trainingsprozess. Du kannst das Training mit minimalem Code starten, indem du dem Modell Daten zuführst. Diese Bibliotheken übernehmen automatisch die Anpassung der Gewichte, die Rückpropagation und die Validierung. Außerdem bieten sie Werkzeuge, mit denen du den Fortschritt überwachen und Hyperparameter einfach anpassen kannst. Nach dem Training kannst du das Modell und seine Gewichte mit wenigen Befehlen speichern.
Denk daran, dass eine sorgfältige Verwaltung der Datensätze für ein effizientes Training entscheidend ist. Verwende Versionskontrolle für Datensätze, um Änderungen nachzuverfolgen und die Reproduzierbarkeit sicherzustellen. Werkzeuge wie DVC (Data Version Control) können dir bei der Verwaltung großer Datensätze helfen.
Schritt 5: Modellbewertung und Feinabstimmung#
Es ist wichtig, die Leistung deines Modells anhand verschiedener Metriken zu bewerten und es zu verbessern, um seine Genauigkeit zu steigern. Die Bewertung hilft dabei, Bereiche zu erkennen, in denen das Modell gute Ergebnisse erzielt und in denen es verbessert werden muss. Durch Feinabstimmung wird sichergestellt, dass das Modell für eine bestmögliche Leistung optimiert ist.
- Leistungskennzahlen: Verwende Kennzahlen wie Genauigkeit, Präzision, Trefferquote und F1-Wert, um die Leistung deines Modells zu bewerten. Diese Kennzahlen zeigen, wie gut dein Modell Vorhersagen trifft.
- Hyperparameteroptimierung: Passe Hyperparameter an, um die Leistung des Modells zu optimieren. Methoden wie die Gittersuche oder die Zufallssuche können dabei helfen, die besten Hyperparameterwerte zu finden.
- Feinabstimmung: Nimm kleine Anpassungen an der Modellarchitektur oder am Trainingsprozess vor, um die Leistung zu verbessern. Dazu kann gehören, Lernraten, Batchgrößen oder andere Modellparameter anzupassen.
Weitere Informationen zu Modellbewertung und Feinabstimmung findest du in unserem Leitfaden mit Einblicken in die Modellbewertung.
Schritt 6: Modelltests#
Modelltests bestätigen, dass dein Modell mit vollständig unbekannten Daten gute Ergebnisse erzielt, und prüfen, ob es für die Bereitstellung bereit ist. Der Unterschied zwischen Modelltests und Modellbewertung besteht darin, dass die Tests die Leistung des endgültigen Modells überprüfen, statt es fortlaufend zu verbessern.
Es ist wichtig, gründlich zu testen und häufig auftretende Probleme zu beheben. Teste dein Modell mit einem separaten Testdatensatz, der weder beim Training noch bei der Validierung verwendet wurde. Dieser Datensatz sollte reale Szenarien abbilden, damit die Leistung des Modells konsistent und zuverlässig ist.
Behandle auch häufige Probleme wie Overfitting, Underfitting und Datenleckage. Nutze Verfahren wie die Kreuzvalidierung, um diese Probleme zu erkennen. Umfassende Teststrategien findest du in unserem Leitfaden zum Testen von Modellen.
Schritt 7: Modellbereitstellung#
Nachdem du dein Modell gründlich getestet hast, ist es an der Zeit, es bereitzustellen. Bei der Modellbereitstellung machst du dein Modell in einer Produktionsumgebung verfügbar. Hier sind die Schritte zur Bereitstellung eines Computer-Vision-Modells:
- Umgebung einrichten: Konfiguriere die erforderliche Infrastruktur für die gewählte Bereitstellungsoption, unabhängig davon, ob sie cloudbasiert (AWS, Google Cloud, Azure) oder Edge-basiert (lokale Geräte, IoT) ist.
- Modell exportieren: Exportiere dein Modell in ein geeignetes Format (z. B. ONNX, TensorRT oder CoreML für YOLO26), damit es mit deiner Bereitstellungsplattform kompatibel ist.
- Modell bereitstellen: Stelle das Modell bereit, indem du APIs oder Endpunkte einrichtest und es in deine Anwendung integrierst.
- Skalierbarkeit sicherstellen: Richte Load Balancer, Gruppen für die automatische Skalierung und Überwachungswerkzeuge ein, um Ressourcen zu verwalten und ein wachsendes Datenaufkommen sowie mehr Nutzeranfragen zu bewältigen.
Die Ultralytics Platform bietet außerdem verwaltete Bereitstellungsendpunkte in 42 Regionen weltweit. Sie skalieren standardmäßig auf null und übernehmen die Einrichtung der Infrastruktur automatisch.
Schritt 8: Überwachung, Wartung und Dokumentation#
Nach der Bereitstellung deines Modells ist es wichtig, seine Leistung kontinuierlich zu überwachen, es zu warten, um auftretende Probleme zu beheben, und den gesamten Prozess für spätere Nachschlagezwecke und Verbesserungen zu dokumentieren.
Mit Überwachungstools kannst du wichtige Leistungskennzahlen (KPIs) verfolgen und Anomalien oder Genauigkeitsverluste erkennen. Durch die Modellüberwachung kannst du Modellverschiebungen erkennen, bei denen die Modellleistung im Laufe der Zeit aufgrund von Änderungen der Eingabedaten nachlässt. Trainiere das Modell regelmäßig mit aktualisierten Daten neu, um Genauigkeit und Relevanz zu erhalten.
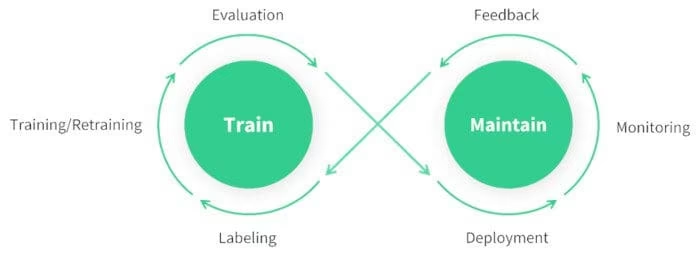
Neben Überwachung und Wartung ist auch die Dokumentation wichtig. Dokumentiere den gesamten Prozess gründlich, einschließlich der Modellarchitektur, der Trainingsverfahren, der Hyperparameter, der Schritte zur Datenvorverarbeitung sowie aller Änderungen, die während der Bereitstellung und Wartung vorgenommen wurden. Eine gute Dokumentation gewährleistet die Reproduzierbarkeit und erleichtert spätere Aktualisierungen und die Fehlerbehebung. Wenn du dein Modell wirksam überwachst, wartest und dokumentierst, bleibt es über seinen gesamten Lebenszyklus hinweg genau, zuverlässig und einfach zu verwalten.
Mit der Community in Kontakt treten#
Der Austausch mit einer Community von Computer-Vision-Begeisterten kann dir dabei helfen, Probleme bei der Arbeit an deinem Computer-Vision-Projekt selbstbewusst zu bewältigen. Hier sind einige Möglichkeiten, wie du dich informieren, Fehler beheben und Kontakte knüpfen kannst.
Ressourcen aus der Community#
- GitHub-Issues: Besuche das YOLO26-GitHub-Repository und stelle im Tab „Issues“ Fragen, melde Fehler und schlage neue Funktionen vor. Die aktive Community und die Maintainer helfen dir bei konkreten Problemen.
- Ultralytics-Discord-Server: Tritt dem Ultralytics-Discord-Server bei, um dich mit anderen Nutzern und Entwicklern auszutauschen, Unterstützung zu erhalten und Erkenntnisse zu teilen.
Mit diesen Ressourcen kannst du Herausforderungen bewältigen und bleibst über die neuesten Trends und bewährten Methoden in der Computer-Vision-Community auf dem Laufenden.
Nächste Schritte#
Du hast jetzt einen Fahrplan für alle Phasen eines Computer-Vision-Projekts – von der Festlegung der Ziele bis zur Überwachung eines bereitgestellten Modells. Setze ihn in die Praxis um, indem du dein erstes YOLO-Modell trainierst, oder vertiefe dich mithilfe der oben verlinkten Anleitungen in eine einzelne Phase. Wenn du die gesamte Pipeline ohne Programmierung ausführen möchtest, sieh dir die Ultralytics Platform an.
Häufig gestellte Fragen#
Welche Computer-Vision-Aufgabe die richtige ist, hängt vom Ziel deines Projekts ab. Wenn du beispielsweise den Verkehr überwachen möchtest, eignet sich die Objekterkennung, da sie verschiedene Fahrzeugtypen in Echtzeit lokalisieren und identifizieren kann. Für medizinische Bildgebung ist die Bildsegmentierung ideal, um Tumore detailliert abzugrenzen und so Diagnose und Behandlungsplanung zu unterstützen.
Datenannotation ist wichtig, damit dein Modell lernt, Muster zu erkennen. Die Art der Annotation hängt von der Aufgabe ab:
- Bildklassifizierung: Das gesamte Bild wird einer einzelnen Klasse zugeordnet.
- Objekterkennung: Um die Objekte werden Begrenzungsrahmen gezeichnet.
- Bildsegmentierung: Jedes Pixel wird dem Objekt zugeordnet, zu dem es gehört.
Der integrierte Annotationseditor in der Ultralytics Platform kann dich dabei unterstützen.
Wenn du deinen Datensatz vor der Erweiterung aufteilst, kannst du die Modellleistung anhand unveränderter Originaldaten validieren. Befolge diese Schritte:
- Trainingsdaten: 70–80 % deiner Daten.
- Validierungsdaten: 10–15 % für die Hyperparameteroptimierung.
- Testdaten: Die verbleibenden 10–15 % für die abschließende Bewertung.
Wende nach der Aufteilung Methoden zur Datenerweiterung wie Drehen, Skalieren und Spiegeln an, um die Vielfalt deines Datensatzes zu erhöhen. Bibliotheken wie Albumentations und OpenCV können dabei helfen. Ultralytics bietet außerdem integrierte Einstellungen zur Datenerweiterung, die den Vorgang vereinfachen.
Exportiere dein trainiertes Modell mit der Methode
exportund wähle ein Format, das zu deinem Bereitstellungsziel passt. Ultralytics unterstützt verschiedene Formate, darunter ONNX, TensorRT und CoreML. Gehe zum Exportieren deines YOLO26-Modells wie folgt vor:- Verwende die Methode
exportmit dem gewünschten Formatparameter. - Stelle sicher, dass das exportierte Modell den Spezifikationen deiner Bereitstellungsumgebung entspricht (z. B. Edge-Geräte oder Cloud).
Weitere Informationen findest du in unserem Leitfaden zum Modellexport.
- Verwende die Methode
Kontinuierliche Überwachung und Wartung sind entscheidend für den langfristigen Erfolg eines Modells. Richte Werkzeuge ein, um wichtige Leistungskennzahlen (KPIs) nachzuverfolgen und Anomalien zu erkennen. Trainiere das Modell regelmäßig mit aktualisierten Daten neu, um einer Modellverschiebung entgegenzuwirken. Dokumentiere den gesamten Prozess einschließlich der Modellarchitektur, der Hyperparameter und aller Änderungen, um die Reproduzierbarkeit sicherzustellen und künftige Aktualisierungen zu erleichtern. Weitere Informationen findest du in unserem Leitfaden zu Überwachung und Wartung.


Kommentare2
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.
VeeranjaneyuluToka
what is the best way of verifying if the chosen model is right fit for the given dataset or problem statement. Is it just based on evaluation metrics or can we use kind of approach to verify based on the feature maps or heat map visualization if the model is really learning the features that it needs to be learnt.
 Glenn JocherUltralytics
Great question! You're absolutely right that evaluation metrics alone don't tell the whole story. Here are several approaches to verify if your model is truly learning the right features:
Beyond Evaluation Metrics:
- Feature visualization and heat maps (like Grad-CAM, LIME) help you see what regions the model focuses on during predictions
- Activation maps show which features activate at different layers, revealing what the model has learned
- Confusion matrices reveal specific class prediction patterns and potential biases
Practical Verification Approaches:
- Test on edge cases and adversarial examples to understand model robustness
- Cross-validation across different data splits to ensure consistent performance
- Error analysis by examining misclassified samples to identify systematic issues
- Domain adaptation testing on slightly different datasets to check generalization
For YOLO11 specifically:
- Use validation visualizations during training to see bounding box predictions
- Monitor training curves for signs of overfitting or underfitting
- Test inference on diverse real-world scenarios beyond your test set
The key is combining quantitative metrics with qualitative analysis - if your model achieves high accuracy but the heat maps show it's focusing on irrelevant background features instead of the actual objects, that's a red flag even with good metrics.
Would you like specific guidance on implementing any of these visualization techniques with your current project?