Datenaufbereitung
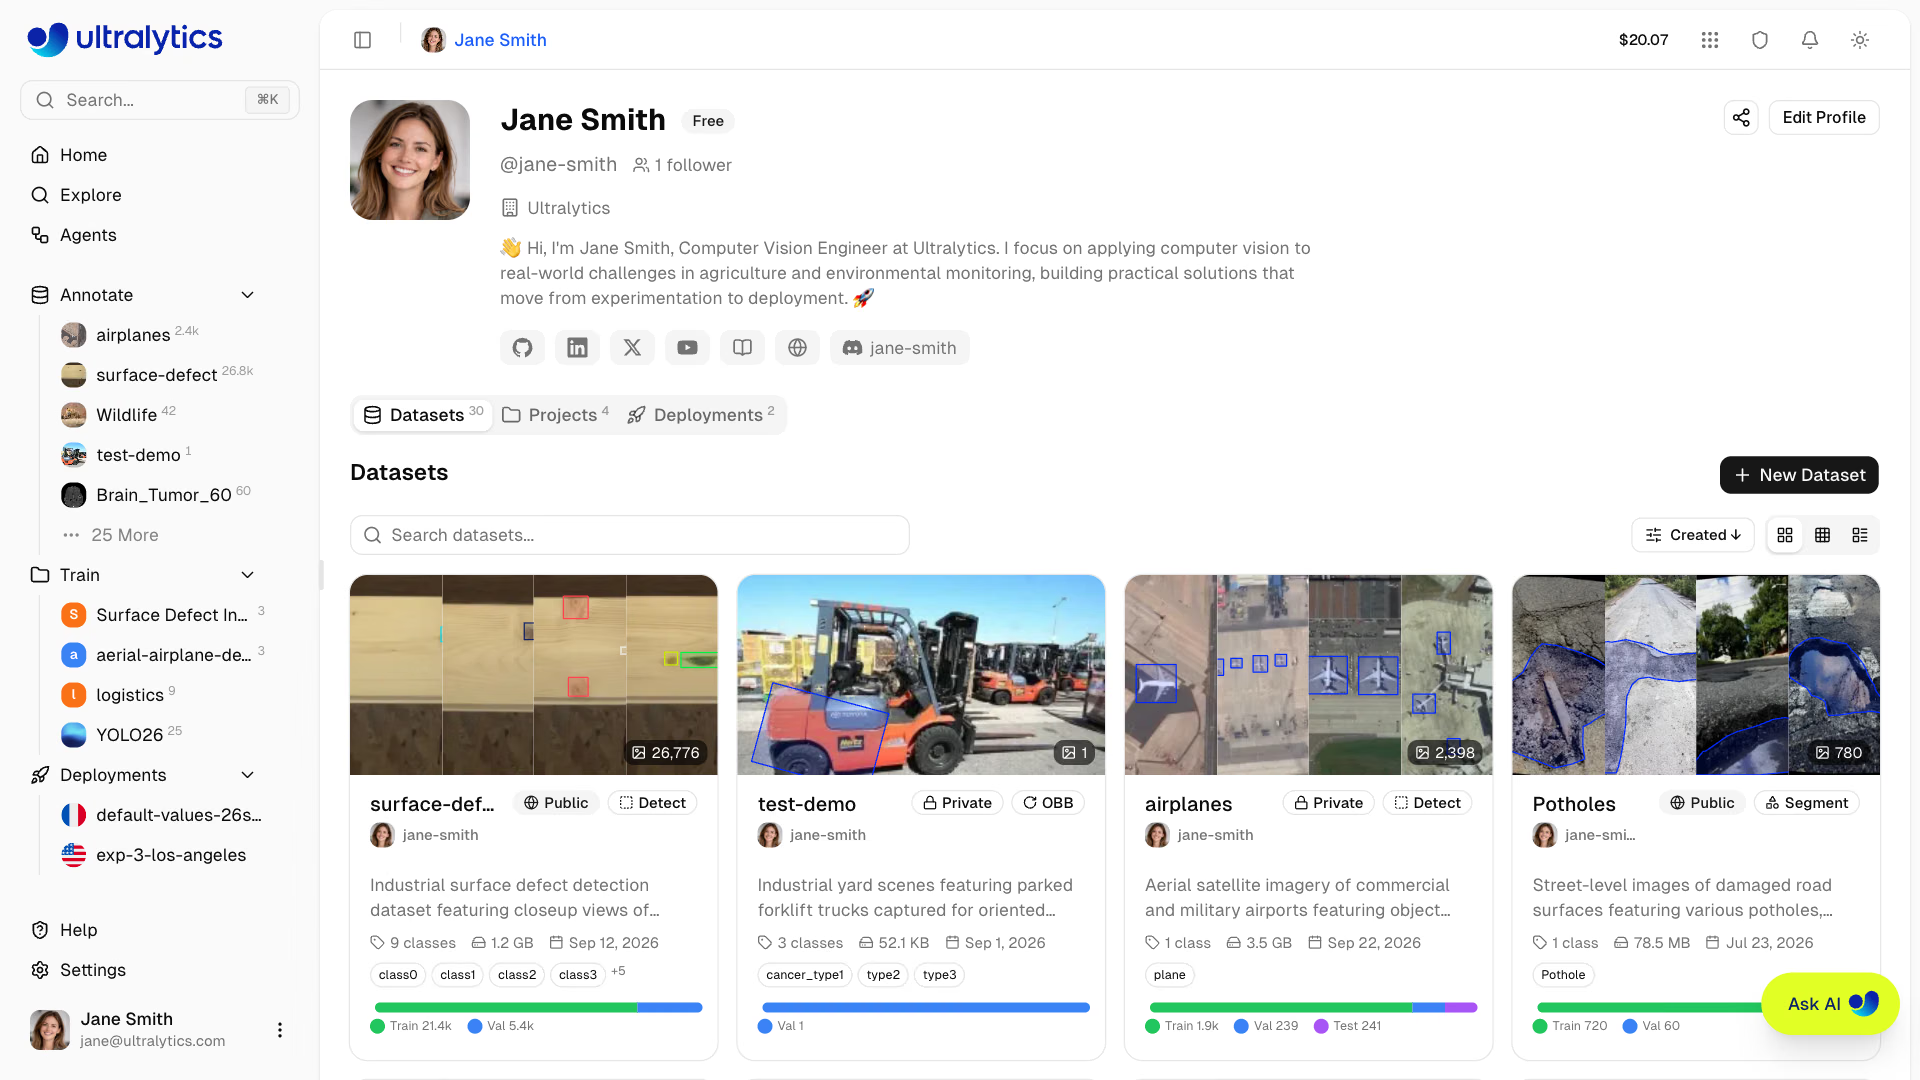
Datenaufbereitung ist die Grundlage erfolgreicher Computer-Vision-Modelle. Die Ultralytics Platform bietet Tools zur Verwaltung deiner Trainingsdaten – vom Hochladen über die Annotation bis zur Analyse.
Ansehen: Starte mit der Ultralytics Platform – Daten
Übersicht#
Der Bereich „Data“ der Ultralytics Platform unterstützt dich dabei:
- Hochladen von Bildern, Videos und Dataset-Dateien (ZIP, TAR einschließlich
.tar.gz/.tgz, NDJSON) - Aus einer URL importieren: Füge einen direkten Link zu einem Archiv oder NDJSON-Export ein oder importiere aus Roboflow und gehostetem Label Studio
- Verbinden mit Google Cloud Storage, Amazon S3 oder Azure Blob Storage und Verwenden deiner Daten direkt dort, ohne eine Kopie hochzuladen
- Pixel lokal speichern mit CPU-/GPU-Arbeitern für den Unternehmenseinsatz auf On Premise
- Annotiere mit manuellen Zeichenwerkzeugen und intelligenter Annotation mit SAM (SAM 2.1, SAM 3 oder dem standardmäßig ausgewählten SAM 3.1), YOLO-Modellen oder klassenabfragegesteuerten Modellen – gehosteten Open-Source-Modellen oder kostenpflichtigen Anbietermodellen – auf Erkennungsdatensätzen mit 1–200 Klassen
- Klassen verwalten, indem du sie im gesamten Dataset umbenennst, ihre Farben änderst, sie zusammenführst oder löschst
- Datasets erweitern mit Find Similar Images oder Generate Similar Images und anschließend die Bilder annotieren, die du behalten möchtest
- Gesichter unkenntlich machen in vorhandenen Bildern oder zukünftigen Uploads
- Analysiere deine Daten mit Statistiken, Visualisierungen und Clustering auf Basis von Bild-Embeddings.
- Exportieren im NDJSON-Format für lokales Training
Workflow#
| Stufe | Beschreibung |
|---|---|
| Hochladen | Bilder, Videos oder Archive mit automatischer Verarbeitung importieren |
| Annotieren | Daten mit manuellen Werkzeugen beschriften oder intelligente Annotation mit SAM (Erkennung, Segmentierung, semantische Segmentierung und OBB), YOLO oder klassenbasiert angeleiteten Modellen verwenden – gehostete Open-Source-Modelle oder kostenpflichtige Anbietermodelle – für Erkennungsdatensätze mit 1–200 Klassen |
| Analysieren | Klassenverteilungen, räumliche Heatmaps, Dimensionsstatistiken und Einbettungscluster anzeigen |
| Exportieren | Für die Offline-Nutzung im NDJSON-Format herunterladen |
Unterstützte Aufgaben#
Datasets in der Ultralytics Platform unterstützen alle 7 YOLO-Aufgabentypen:
| Aufgabe | Beschreibung | Annotationstool |
|---|---|---|
| Erkennen | Objekterkennung mit Begrenzungsrahmen | Rechteckwerkzeug |
| Segmentieren | Instanzsegmentierung mit Pixelmasken | Polygonwerkzeug |
| Semantisch | Semantische Segmentierung mit Pixelbereichen pro Klasse | Polygonwerkzeug |
| Tiefe | Metrische Tiefenkarten pro Pixel | Importierte Zielwerte |
| Klassifizieren | Klassifizierung auf Bildebene | Klassenauswahl |
| Pose | Keypoint-Schätzung mit integrierten und benutzerdefinierten Skelettvorlagen | Keypoint-Werkzeug |
| OBB | Orientierte Begrenzungsrahmen für gedrehte Objekte | Werkzeug für orientierte Begrenzungsrahmen |
Der Aufgabentyp wird beim Erstellen eines Datasets festgelegt und bestimmt, welche Annotationstools verfügbar sind. Du kannst ihn später über die Aufgabenty-Auswahl in der Dataset-Kopfzeile ändern. Nach dem Wechsel werden jedoch inkompatible Annotationen nicht mehr angezeigt. Ein Wechsel zu oder von der Tiefenaufgabe ist nur möglich, solange das Dataset leer ist – siehe Dataset bearbeiten.
Wichtige Funktionen#
Intelligente Speicherung#
Die Ultralytics Platform verwaltet den Speicherplatz effizient:
- Deduplizierung: Identische Bilder in derselben Datenregion werden nur einmal gespeichert
- Integrität: Uploads werden auf Datenintegrität geprüft
- Effizienz: Klone verwenden bereits gespeicherte Bilder erneut, statt sie zu kopieren; sie werden aber weiterhin auf das Speicherkontingent des Zielarbeitsbereichs angerechnet
Dataset-URIs#
Verweise auf Datasets im URI-Format ul:// (siehe Datasets der Platform verwenden):
yolo train model=yolo26n.pt data=ul://username/datasets/my-datasetSo kannst du mit den Datasets der Platform auf jedem Computer trainieren, auf dem dein API-Schlüssel eingerichtet ist.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(data="ul://username/datasets/my-dataset", epochs=100)Dataset-Versionierung#
Erstelle unveränderliche NDJSON-Momentaufnahmen deines Datasets für reproduzierbares Training. Jede Version enthält die Anzahl der Bilder, Klassen und Annotationen zum Zeitpunkt ihrer Erstellung. Einzelheiten findest du unter Versions-Tab.
Dataset-Tabs#
Je nach Zustand des Datensatzes und deinen Berechtigungen können auf Datensatzseiten bis zu sieben Tabs angezeigt werden:
| Tab | Beschreibung |
|---|---|
| Bilder | Bilder in der Raster-, Kompakt- oder Tabellenansicht mit Annotationseinblendungen durchsuchen |
| Klassen | Klassen anzeigen, umbenennen, umfärben, zusammenführen und löschen; einschließlich der Anzahl der Labels pro Klasse |
| Diagramme | Automatische Statistiken: Split-Verteilung, Klassenanzahl, Heatmaps |
| Modelle | Modelle, die mit diesem Dataset trainiert wurden, mit Kennzahlen und Status |
| Kommentare | Diskussions-Thread |
| Versionen | Unveränderliche NDJSON-Momentaufnahmen erstellen, vergleichen, herunterladen und wiederherstellen |
| Fehler | Bilder, deren Verarbeitung fehlgeschlagen ist, mit Fehlerdetails und Hinweisen zur Behebung |
Classes wird angezeigt, wenn der Datensatz Bilder enthält und seine Aufgabe Klassen hat, während Charts immer dann angezeigt wird, wenn der Datensatz Bilder enthält. Comments wird bei öffentlichen Datensätzen angezeigt. Errors wird nur angezeigt, wenn Verarbeitungsfehler vorliegen. Versions wird angezeigt, wenn du Bearbeitungszugriff hast oder wenn du dich im Nur-Lese-Modus befindest und bereits Versionen vorhanden sind.
Clustering#
Erkunde dein Dataset als interaktives 2D-Streudiagramm, in dem visuell ähnliche Bilder nahe beieinanderliegen. So lassen sich Cluster, Duplikate und Ausreißer leichter erkennen und die Verteilung von Splits oder Klassen in deinen Daten untersuchen. Um die Galerie auf bestimmte Bilder zu filtern, ziehe mit dem Lasso einen Bereich auf oder klicke auf einen Punkt. Für die Analyse sind 20 bis 200.000 Bilder ohne Verarbeitungsfehler erforderlich. Mithilfe derselben Einbettungen kannst du in öffentlichen Datasets sowie in deinen eigenen und Team-Datasets ähnliche Bilder finden und zu deinem Dataset hinzufügen. Einzelheiten findest du unter Clustering.
Statistiken und Visualisierung#
Der Tab Charts bietet automatische Analysen, darunter:
- Split-Verteilung: Ringdiagramm mit der Anzahl der Bilder in Train-, Val- und Test-Splits
- Häufigste Klassen: Ringdiagramm der 10 häufigsten Annotationsklassen
- Bildabmessungen: Histogramm der Verteilung von Bildbreite und -höhe (in Pixeln)
- Bildabmessungen 2D: 2D-Heatmap von Breite und Höhe mit Hilfslinien für das Seitenverhältnis
- Positionen der Annotationen: 2D-Heatmap der Mittelpunkte der Begrenzungsrahmen
- Punkte pro Instanz: Verteilung der Anzahl von Polygon-Eckpunkten oder Keypoints (Segmentierungs-/Pose-Datensätze)
Die vollständige Liste findest du im Tab Diagramme.
Schnellzugriffe#
- Datensätze: Lade deine Trainingsdaten hoch, verwalte und exportiere sie
- Annotation: Beschrifte Daten mit manuellen und KI-gestützten Werkzeugen
- Cloud-Training: Trainiere Modelle mit deinen annotierten Datensätzen
- Datensatz-URI: Verwende
ul://-URIs, um von überall aus zu trainieren
Häufig gestellte Fragen#
Ultralytics Platform unterstützt:
Bilder: JPEG, PNG, WebP, BMP, TIFF, HEIC, AVIF, JP2, DNG, MPO (max. 50 MB pro Datei)
Videos: MP4, WebM, MOV, MKV, M4V (max. 1 GB, Bilder werden mit 1 FPS extrahiert, max. 100 Bilder)
Datensatzdateien: ZIP- oder TAR-Archive mit
.tar.gzund.tgz(max. 10 GB im Free-Tarif, 20 GB im Pro-Tarif, 50 GB im Enterprise-Tarif). Sie enthalten Bilder mit optionalen Labels im YOLO-Format, als COCO JSON oder LabelMe JSON, semantischen PNG-Masken oder Tiefenkarten, sowie Ultralytics NDJSON- oder Labelbox-NDJSON-ExporteDu kannst Archive und NDJSON-Dateien in diesen Formaten auch importieren, indem du im Tab
URLdes DialogfeldsNew Dataseteinen direkten HTTP(S)-Link einfügst. Pascal-VOC-XML-Labels werden erkannt, aber nicht importiert.Die Speicherlimits hängen von deinem Tarif ab:
Tarif Speicherlimit Free 100 GB Pro 500 GB Enterprise Unbegrenzt Limits für einzelne Dateien: Bilder 50 MB, Videos 1 GB, Datensätze 10 GB im Free-Tarif / 20 GB im Pro-Tarif / 50 GB im Enterprise-Tarif
Ja. Verwende zum lokalen Training das URI-Format für Datensätze:
export ULTRALYTICS_API_KEY="YOUR_API_KEY"
yolo train model=yolo26n.pt data=ul://username/datasets/my-dataset epochs=100
Oder exportiere deinen Datensatz im NDJSON-Format, um Metadaten, Aufteilungen, Annotationen und signierte Bild-URLs zu übertragen.


Kommentare
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.