Integración con Azure Blob Storage#
La integración con Azure Blob Storage conecta los contenedores de tu cuenta de almacenamiento con Ultralytics Platform. Tus imágenes permanecen en tus contenedores: Platform las indexa allí mismo para que puedas explorarlas, anotarlas y entrenar modelos YOLO sin subir una copia.
Los conjuntos de datos de Azure Blob Storage requieren un plan Pro o Enterprise. En los espacios de trabajo gratuitos se muestra la integración y se solicita la actualización al conectarse. Si finaliza una suscripción, los conjuntos de datos existentes de Azure Blob Storage siguen siendo totalmente accesibles; solo las conexiones e importaciones nuevas requieren Pro.
Obtén una cadena de conexión#
Platform solo lee tu almacenamiento: nunca escribe, modifica ni elimina tus blobs. La integración actual requiere una cadena de conexión con una clave de acceso de cuenta, que concede privilegios para toda la cuenta, aunque Platform solo realiza operaciones de lectura y listado:
- En el portal de Azure, abre tu cuenta de almacenamiento.
- Ve a Seguridad y redes > Claves de acceso.
- Copia una cadena de conexión.
La cadena debe incluir AccountName, AccountKey y HTTPS como protocolo, tal como aparece en el formulario que Azure te ofrece en Claves de acceso. Se rechazan las cadenas de conexión con tokens SAS, que contienen SharedAccessSignature en lugar de AccountKey.
Las conexiones utilizan el punto de conexión estándar blob.core.windows.net. No se admiten las nubes soberanas (Azure China y Azure Government) ni los puntos de conexión de blobs personalizados.
Conectar con Platform#
- Ve a Configuración > Integraciones y selecciona Azure Blob Storage en la lista de integraciones.
- Pega la cadena de conexión.
- Haz clic en Buscar contenedores disponibles y selecciona los contenedores que quieras conectar. También puedes introducir manualmente el nombre de un contenedor.
- Haz clic en Conectar. Platform comprueba que puede enumerar y leer cada contenedor seleccionado antes de guardar nada.
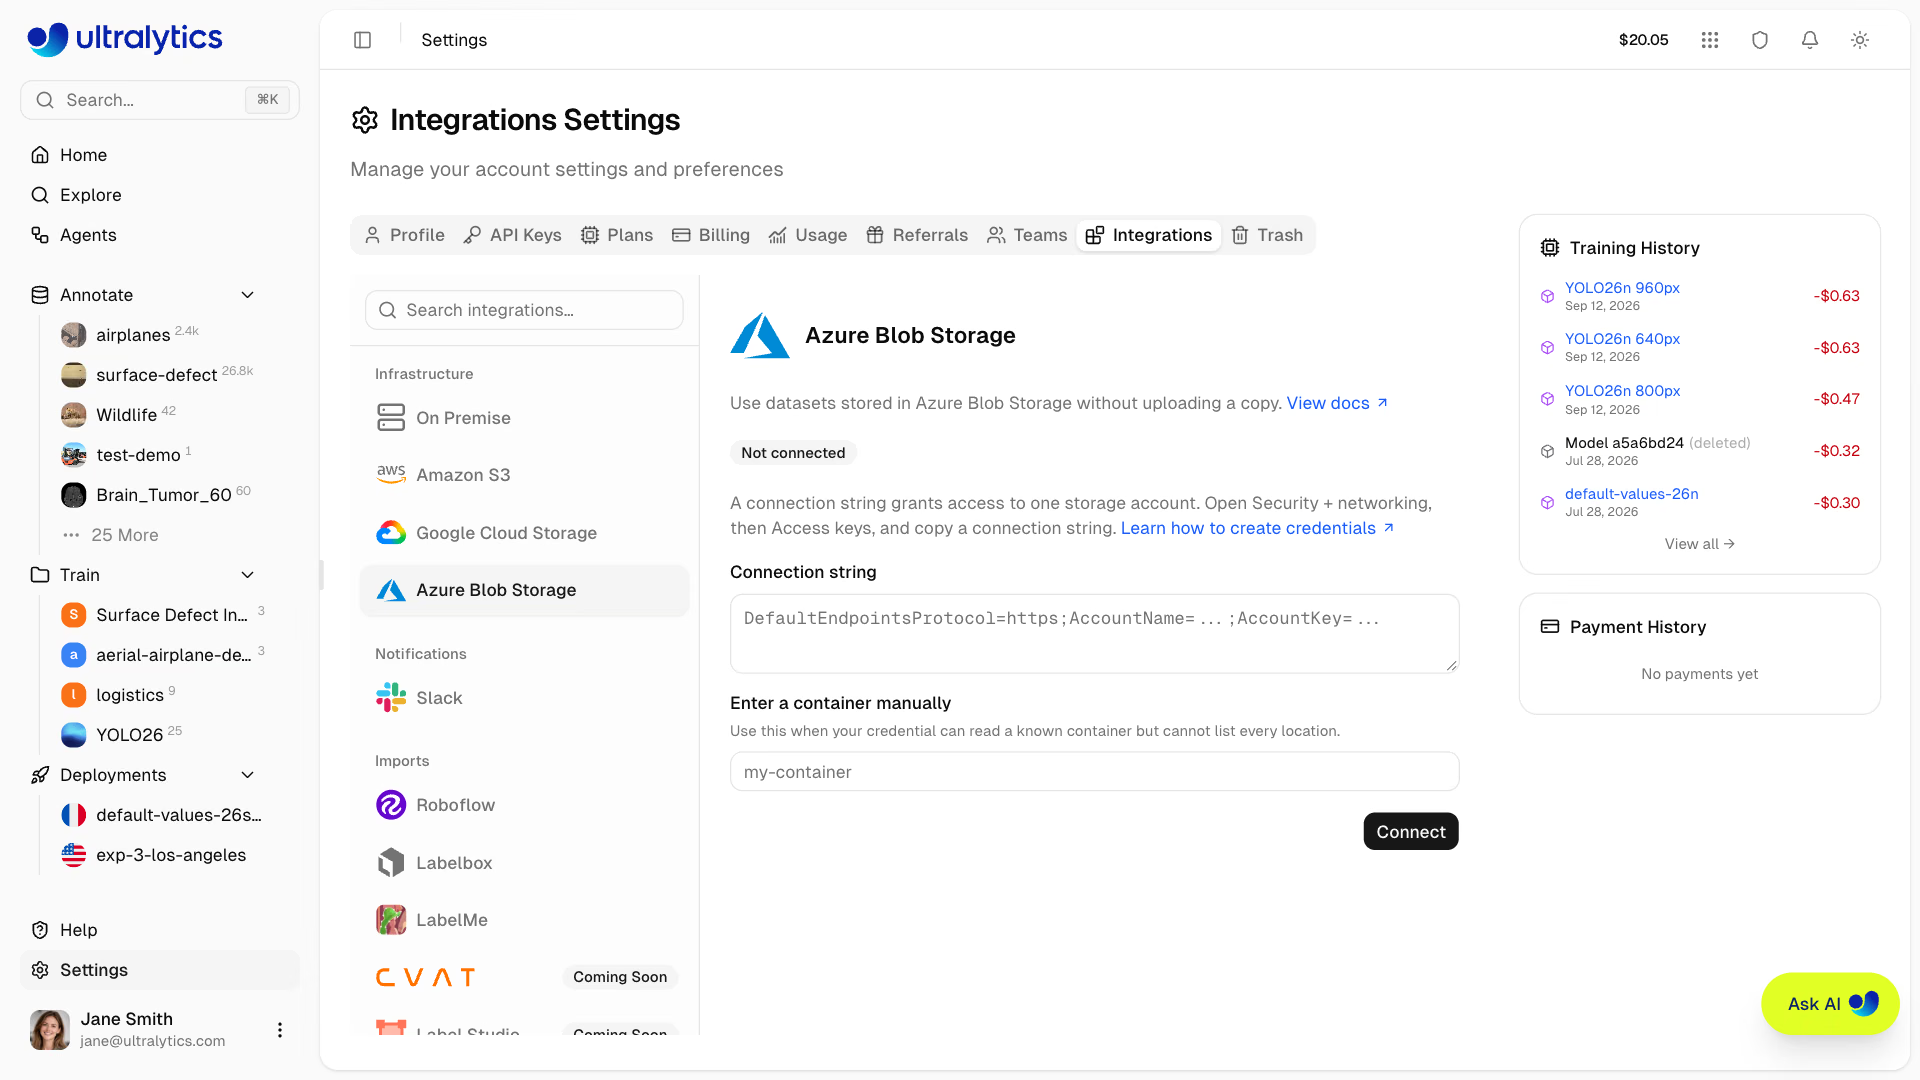
Necesitas el rol de administrador o propietario del espacio de trabajo para conectar el almacenamiento en la nube. Puedes añadir hasta 50 contenedores a la vez; la detección muestra hasta 300 contenedores de la cuenta de almacenamiento.
Si más adelante vuelves a conectar la misma cuenta de almacenamiento, se añadirán nuevos contenedores a la integración existente. Una credencial guardada solo se reemplaza si la nueva credencial puede seguir leyendo todos los contenedores que ya has conectado. Si no se puede leer algún contenedor, el error indica cuál, incluidos los conectados anteriormente con la misma cuenta de almacenamiento.
Una clave de cuenta puede autorizar operaciones de escritura y eliminación, o crear tokens SAS si se expone fuera de Platform. Las credenciales se cifran en reposo con AES-256-GCM, nunca se devuelven al navegador ni se exponen a las cargas de trabajo de entrenamiento. Siempre que sea posible, usa una cuenta de almacenamiento dedicada. Para revocar el acceso, cambia las claves de acceso de la cuenta de almacenamiento en Azure.
Crea un conjunto de datos a partir de un contenedor de blobs#
- Haz clic en Nuevo conjunto de datos y abre la pestaña Nube.
- Elige un contenedor conectado y ve a la carpeta que contiene tus datos.
- Confirma la carpeta, ajusta el nombre del conjunto de datos y créalo.
Platform enumera la carpeta una vez e indexa lo que encuentra:
- Imágenes — Los blobs
.jpg,.jpeg,.png,.webpy.avifse indexan; sus dimensiones se leen mediante solicitudes acotadas. Platform no guarda una segunda copia de la imagen de origen. - Etiquetas — Los archivos auxiliares
.txtde YOLO se analizan y se convierten en anotaciones de Platform, asociadas mediante la estructura estándarimages/→labels/o como archivos hermanos en la misma carpeta. - Metadatos — Un archivo YAML proporciona los nombres de las clases y la estructura de los puntos clave de pose, igual que una carga de archivo. Se prefieren
data.yamlydata.ymlcuando la carpeta contiene varios archivos. - Tarea — Una muestra de los archivos de etiquetas determina la tarea, por lo que las carpetas de segmentación, pose y OBB se reconocen por la estructura de sus etiquetas, no por la tarea que hayas seleccionado en el cuadro de diálogo.
- Divisiones — Los nombres de carpeta
train,valytesten la ruta del blob asignan automáticamente las divisiones.
Después, el conjunto de datos funciona como cualquier otro: explóralo y anótalo, configúralo como público o privado, compártelo con tu equipo y entrena con él mediante el entrenamiento gestionado. Los originales se transmiten cuando se necesitan y las imágenes indexadas no consumen tu cuota de almacenamiento de Platform.
Una sola importación indexa hasta 500 000 blobs, y archivos de etiquetas o YAML de hasta 1 MB cada uno. Los contenedores más grandes deben dividirse en varios conjuntos de datos.
Cada imagen indexada queda vinculada al ETag de su blob, y Platform falla de forma segura si el blob cambia mientras está vinculado. Añade blobs nuevos en lugar de sobrescribir los existentes.
Importaciones fallidas#
Si falla una importación —por una carpeta vacía, un error tipográfico en la ruta o permisos revocados—, el conjunto de datos muestra el error en su página. Los editores pueden hacer clic en Reintentar importación para reiniciarla con el contenedor y la carpeta guardados, o crear un conjunto de datos nuevo que apunte a la ruta corregida.
Al reintentar, se vuelve a listar la carpeta en lugar de reanudar la importación: se incluyen los blobs añadidos desde el primer intento y se descartan del conjunto de datos los que ya no están.
Entrenamiento#
El entrenamiento gestionado funciona con el flujo de entrenamiento habitual. Durante la ejecución, el entrenamiento utiliza las propias copias de las imágenes vinculadas de Platform, y tus credenciales de Azure nunca se exponen a las cargas de trabajo de entrenamiento.
Desconectar una conexión#
Al desconectar, se elimina la cadena de conexión guardada sin modificar nada en Azure. Los conjuntos de datos creados a partir de esos contenedores permanecen en tu espacio de trabajo con sus clases, etiquetas y anotaciones, pero sus imágenes no se pueden cargar, previsualizar ni utilizar para entrenar hasta que vuelvas a conectar la misma cuenta de almacenamiento. Aunque estén desconectados, puedes cambiarles el nombre, editar sus etiquetas o eliminarlos.
Para desconectar, ve a Configuración > Integraciones, selecciona Azure Blob Storage, haz clic en Desconectar junto a la credencial y confirma. Al abrir uno de sus conjuntos de datos, aparecerá Azure Blob Storage desconectado con un enlace a esta configuración; el conjunto de datos volverá a estar disponible automáticamente cuando te conectes de nuevo.
También puedes desconectar mediante la API REST, usando el ID de integración que devuelve GET /api/integrations/buckets:
curl -X DELETE \
  -H "Authorization: Bearer YOUR_API_KEY" \
  https://platform.ultralytics.com/api/integrations/buckets/INTEGRATION_ID
from ultralytics_platform import Platform
client = Platform() # reads ULTRALYTICS_API_KEY
integrations = client.storage_integrations.list()
client.storage_integrations.delete("INTEGRATION_ID")Para revocar el acceso directamente en el origen, cambia las claves de acceso de la cuenta de almacenamiento en Azure.
Limitaciones actuales#
Los conjuntos de datos vinculados a Azure no incluyen actualmente las funciones que requieren copias de tus imágenes propiedad de Platform: anotación automática, análisis de agrupamiento, clonación de conjuntos de datos y instantáneas de versiones inmutables.
Al eliminar un conjunto de datos respaldado por Azure, o imágenes concretas del conjunto, Platform solo elimina sus referencias: nunca toca tus blobs.
Consulta también las integraciones de Google Cloud Storage y Amazon S3.
Preguntas frecuentes#
No. Platform muestra el contenedor una sola vez e indexa las dimensiones de las imágenes y las etiquetas que encuentra. Los originales se transmiten bajo demanda para explorarlos y anotarlos, y el entrenamiento gestionado utiliza únicamente copias propias de Platform de las imágenes fijadas mientras dura la ejecución. Las imágenes indexadas no cuentan para tu cuota de almacenamiento.
Un conjunto de datos se indexa una sola vez, al crearlo. Los objetos nuevos no se detectan hasta que creas un conjunto de datos nuevo o reintentas una importación fallida. Además, cada imagen indexada queda vinculada a su versión, por lo que, si sobrescribes un objeto, Platform falla de forma segura para esa imagen. Añade objetos nuevos en lugar de reemplazar los existentes.
Desconecta la integración en Settings > Integrations para eliminar las credenciales almacenadas, o cambia las claves de acceso de la cuenta de almacenamiento en Azure. Ninguna de las dos acciones afecta a los datos de tus contenedores.