Integración con Google Cloud Storage
La integración con Google Cloud Storage conecta tus buckets de GCS con Ultralytics Platform. Tus imágenes permanecen en tus buckets: Platform las indexa allí mismo para que puedas explorarlas, anotarlas y entrenar modelos YOLO sin subir una copia. Si tienes activadas las funciones de IA, Platform también puede usarlas para la anotación inteligente, la anotación automática, la búsqueda de imágenes similares y el entrenamiento en la nube.
Los conjuntos de datos de Google Cloud Storage requieren un plan Pro o Enterprise. Los espacios de trabajo gratuitos pueden ver la integración y reciben una solicitud para cambiar de plan al conectarse. Los conjuntos de datos de Google Cloud Storage existentes siguen siendo totalmente accesibles si termina la suscripción; solo las conexiones e importaciones nuevas requieren Pro.
Crea una cuenta de servicio#
El acceso de lectura cubre todo excepto la generación de imágenes, que también crea objetos. Platform nunca modifica ni elimina tus objetos. Crea una cuenta de servicio específica:
- En la consola de Google Cloud, ve a IAM y administración > Cuentas de servicio y crea una cuenta de servicio.
- Asígnale el rol Storage Object Viewer (
roles/storage.objectViewer) en los buckets que quieras conectar. Para la generación de imágenes, asígnale también Storage Object Creator (roles/storage.objectCreator), que crea objetos, pero no puede sobrescribirlos ni eliminarlos. - Abre la cuenta de servicio, selecciona Claves > Añadir clave > Crear clave nueva, elige JSON y descarga el archivo de clave.
roles/storage.objectViewer cubre todo lo que Platform hace con tus datos, pero no permite enumerar los buckets de un proyecto. Añade un rol que incluya storage.buckets.list si quieres que Platform encuentre tus buckets; de lo contrario, escribe manualmente el nombre de cada bucket al conectarlo.
Conectar con Platform#
- Ve a Configuración > Integraciones y selecciona Google Cloud Storage en la lista de integraciones.
- Pega el contenido de la clave JSON de la cuenta de servicio.
- Haz clic en Buscar buckets disponibles y selecciona los buckets que quieras conectar. Si la cuenta de servicio no puede enumerar los buckets, escribe manualmente el nombre de un bucket que conozcas.
- Haz clic en Connect. Platform comprueba que puede listar y leer cada bucket seleccionado antes de guardar nada, y pregunta a Google Cloud si la cuenta de servicio también puede crear objetos. No se escribe nada.
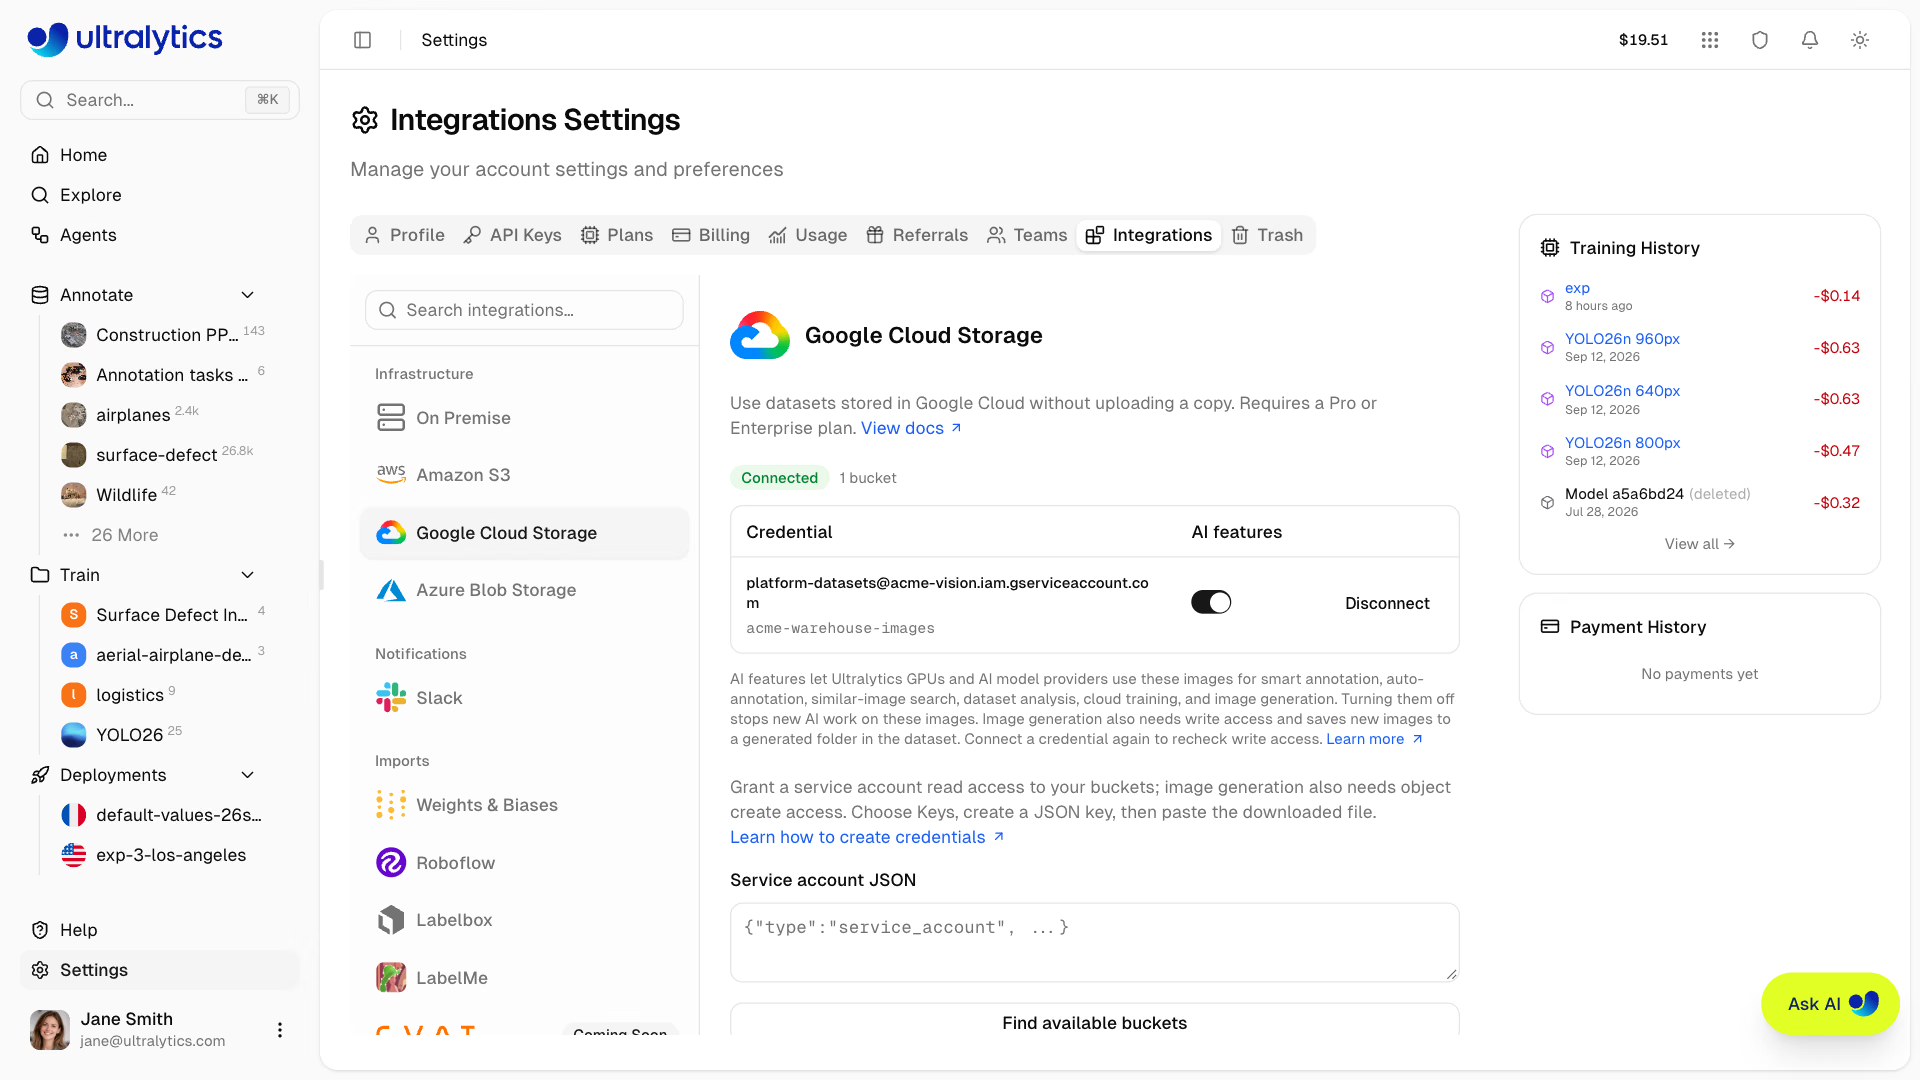
Cada credencial conectada tiene un interruptor de funciones de IA. Después de cambiar sus roles, vuelve a conectar la misma cuenta de servicio para comprobar de nuevo el acceso de escritura.
Necesitas el rol de administrador o propietario del espacio de trabajo para conectar el almacenamiento en la nube. Puedes añadir hasta 50 buckets a la vez y el descubrimiento muestra hasta 300 de los buckets visibles para la cuenta de servicio.
Tu navegador lee el archivo de clave pegado y envía solo los tres campos que necesita Platform: client_email, private_key y project_id. El resto del JSON nunca sale de la página.
Si vuelves a conectar más adelante la misma cuenta de servicio, se añadirán nuevos buckets a la integración existente. Una credencial guardada solo se sustituye si la nueva puede seguir leyendo todos los buckets que ya has conectado. Si no se puede leer algún bucket, el error lo indica, incluidos los buckets conectados anteriormente con la misma cuenta de servicio.
Las credenciales se cifran en reposo con AES-256-GCM, nunca se devuelven al navegador y nunca se exponen a las cargas de trabajo de entrenamiento. Para revocar el acceso, elimina la clave de la cuenta de servicio en Google Cloud.
Funciones de IA#
Cada credencial conectada tiene un interruptor de funciones de IA en Settings > Integrations, activado de forma predeterminada. Mientras está activado, las GPU de Ultralytics y los proveedores de modelos de IA pueden usar las imágenes de esa credencial para:
- Anotación inteligente con SAM, y anotación automática de imágenes individuales y por lotes
- Búsqueda de imágenes similares y análisis de agrupamiento
- Entrenamiento en la nube
- Generación de imágenes, en buckets con acceso de escritura
Los proveedores de modelos de IA solo intervienen en la generación de imágenes, para la que Google Gemini planifica las indicaciones a partir de la imagen de origen, y en los modelos de anotación de pago, que se ejecutan con la clave del proveedor de tu propio espacio de trabajo. Platform no conserva copias de tus imágenes: las funciones las leen cuando las necesitan, el entrenamiento en la nube usa copias temporales durante la ejecución y la búsqueda de imágenes similares guarda una incrustación de cada imagen, que se elimina cuando la imagen sale de Platform.
Desactiva el interruptor para que las imágenes no pasen por las GPU de Ultralytics ni por los proveedores de modelos de IA. Al desactivarlo se detienen los nuevos trabajos de IA; los que ya están en curso se completan. Los conjuntos de datos de esa credencial mostrarán funciones de IA desactivadas, con un enlace a estos ajustes, y cada función no disponible explicará el motivo. La anotación manual, el uso compartido y el entrenamiento local seguirán funcionando, y se conservarán las etiquetas, los modelos y los resultados de búsqueda que ya hayas creado.
Necesitas el rol de administrador o propietario del espacio de trabajo para cambiar el interruptor. También puedes configurarlo con la REST API, usando el ID de integración devuelto por GET /api/integrations/buckets:
curl -X PATCH \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"processing": false}' \
  https://platform.ultralytics.com/api/integrations/buckets/INTEGRATION_ID
Generación de imágenes#
Generar imágenes similares funciona con conjuntos de datos de Google Cloud Storage cuyo bucket permita escribir a la cuenta de servicio, siempre que las funciones de IA estén activadas. Las imágenes que añadas se escriben en una carpeta generated/ dentro de la carpeta del conjunto de datos y, después, se añaden al conjunto de datos como cualquier otra imagen indexada. Platform solo crea objetos nuevos allí y nunca sobrescribe ni elimina los existentes. Si la acción indica que necesita acceso de escritura, concédelo si es necesario y vuelve a conectar la misma cuenta de servicio en Settings > Integrations.
Crear un conjunto de datos desde un bucket de GCS#
- Haz clic en Nuevo conjunto de datos y abre la pestaña Nube.
- Elige un bucket conectado y busca la carpeta que contiene tus datos.
- Confirma la carpeta, ajusta el nombre del conjunto de datos y créalo.
Platform enumera la carpeta una vez e indexa lo que encuentra:
- Imágenes — Se indexan los objetos
.jpg,.jpeg,.png,.webpy.avif; las dimensiones se leen mediante solicitudes acotadas. Platform no guarda una segunda copia de la imagen original. - Etiquetas — Los archivos auxiliares
.txtde YOLO se analizan y se convierten en anotaciones de Platform, asociadas mediante la estructura estándarimages/→labels/o como archivos hermanos en la misma carpeta. - Metadatos — Un archivo YAML proporciona los nombres de las clases y la estructura de los puntos clave de pose, igual que una carga de archivo. Se prefieren
data.yamlydata.ymlcuando la carpeta contiene varios archivos. - Tarea — Una muestra de los archivos de etiquetas determina la tarea, por lo que las carpetas de segmentación, pose y OBB se reconocen por la estructura de sus etiquetas, no por la tarea que hayas seleccionado en el cuadro de diálogo.
- Divisiones — Los nombres de carpeta
train,valytesten la ruta del objeto asignan automáticamente las divisiones.
Después, el conjunto de datos funciona como cualquier otro: explóralo y anótalo, configúralo como público o privado, compártelo con tu equipo y entrena con él mediante el entrenamiento gestionado. Los originales se transmiten cuando se necesitan y las imágenes indexadas no consumen tu cuota de almacenamiento de Platform.
Una sola importación indexa hasta 500 000 objetos, y archivos de etiquetas o YAML de hasta 1 MB cada uno. Los contenedores más grandes deben dividirse en varios conjuntos de datos.
Cada imagen indexada queda vinculada a la generación de su objeto GCS, y Platform falla de forma segura si el objeto cambia mientras está vinculado. Añade objetos nuevos en lugar de sobrescribir los existentes.
Importaciones fallidas#
Si falla una importación —por una carpeta vacía, un error tipográfico en la ruta o permisos revocados—, el conjunto de datos muestra el error en su página. Los editores pueden hacer clic en Reintentar importación para reiniciarla con el contenedor y la carpeta guardados, o crear un conjunto de datos nuevo que apunte a la ruta corregida.
Al reintentar, se vuelve a listar la carpeta en lugar de reanudar la importación: se incluyen los objetos añadidos desde el primer intento y se descartan del conjunto de datos los que ya no están.
Entrenamiento#
El entrenamiento gestionado funciona con el flujo de entrenamiento habitual mientras estén activadas las funciones de IA. Durante la ejecución, el entrenamiento utiliza las copias propias de Platform de las imágenes fijadas, y tus credenciales de Google Cloud nunca se exponen a las cargas de trabajo de entrenamiento. Si las funciones de IA están desactivadas, el cuadro de diálogo de entrenamiento explica por qué no está disponible el entrenamiento en la nube y ofrece la opción de entrenamiento local.
Desconectar una conexión#
Al desconectar, se eliminan las credenciales guardadas sin modificar nada en Google Cloud. Los conjuntos de datos creados a partir de esos contenedores permanecen en tu espacio de trabajo con sus clases, etiquetas y anotaciones, pero sus imágenes no se pueden cargar, previsualizar ni utilizar para entrenar hasta que vuelvas a conectar la misma cuenta de servicio. Aunque estén desconectados, puedes cambiarles el nombre, editar sus etiquetas o eliminarlos.
Para desconectar, ve a Configuración > Integraciones, selecciona Google Cloud Storage, haz clic en Desconectar junto a la credencial y confirma. Al abrir uno de sus conjuntos de datos, aparecerá Google Cloud Storage desconectado con un enlace a esta configuración; el conjunto de datos volverá a estar disponible automáticamente cuando te conectes de nuevo.
También puedes desconectar mediante la API REST, usando el ID de integración que devuelve GET /api/integrations/buckets:
curl -X DELETE \
  -H "Authorization: Bearer YOUR_API_KEY" \
  https://platform.ultralytics.com/api/integrations/buckets/INTEGRATION_ID
from ultralytics_platform import Platform
client = Platform() # reads ULTRALYTICS_API_KEY
integrations = client.storage_integrations.list()
client.storage_integrations.delete("INTEGRATION_ID")Para revocar el acceso directamente en el origen, elimina la clave de la cuenta de servicio en Google Cloud.
Limitaciones actuales#
Los conjuntos de datos respaldados por GCS no admiten las funciones que necesitan copias de tus imágenes propiedad de Platform: la clonación de conjuntos de datos, las instantáneas de versiones inmutables, el desenfoque de caras y el pegado de imágenes de otros conjuntos de datos. La anotación inteligente, la anotación automática, la búsqueda de imágenes similares, el agrupamiento, el entrenamiento en la nube y la generación de imágenes requieren tener activadas las funciones de IA.
Al eliminar un conjunto de datos vinculado a GCS o imágenes individuales de este, solo se eliminan las referencias de Platform; tus objetos no se modifican.
Consulta también las integraciones de Amazon S3 y Azure Blob Storage.
Preguntas frecuentes#
No. Platform lista el bucket una vez e indexa las dimensiones y las etiquetas de las imágenes que encuentra. Los originales se transmiten cuando se necesitan para explorarlos y anotarlos. Si las funciones de IA están activadas, las GPU de Ultralytics leen las imágenes cuando las necesitan, el entrenamiento gestionado usa copias temporales durante cada ejecución y la búsqueda de imágenes similares conserva un embedding de cada imagen, que se elimina junto con esta. Los únicos objetos que Platform escribe son las imágenes generadas que añades, en
generated/. Las imágenes indexadas no cuentan para tu cuota de almacenamiento.Un conjunto de datos se indexa una sola vez, al crearlo. Los objetos nuevos no se detectan hasta que creas un conjunto de datos nuevo o reintentas una importación fallida. Además, cada imagen indexada queda vinculada a su versión, por lo que, si sobrescribes un objeto, Platform falla de forma segura para esa imagen. Añade objetos nuevos en lugar de reemplazar los existentes.
Solo para la generación de imágenes, y únicamente si la cuenta de servicio puede crear objetos y las funciones de IA están activadas. Platform crea objetos nuevos en
generated/, dentro de la carpeta del conjunto de datos, y nunca sobrescribe ni elimina los existentes.Desconecta la integración en Settings > Integrations para eliminar las credenciales guardadas, o elimina la clave de la cuenta de servicio en Google Cloud. Ninguna de las dos acciones afecta a los datos de tus buckets. Para evitar que las imágenes pasen por las GPU de Ultralytics sin desconectar la integración, desactiva las funciones de IA.


Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.