Bonnes pratiques et conseils de machine learning pour l’entraînement des modèles#
Introduction#
L’une des étapes les plus importantes d’un projet de vision par ordinateur est l’entraînement du modèle. Avant d’y arriver, tu dois définir tes objectifs et collecter et annoter tes données. Après avoir prétraité les données pour garantir leur propreté et leur cohérence, tu peux passer à l’entraînement de ton modèle.
L’entraînement d’un modèle consiste à lui apprendre à reconnaître des motifs visuels et à effectuer des prédictions à partir de tes données ; il détermine directement la précision de ton application. Ce guide présente les bonnes pratiques, les techniques d’optimisation et les conseils de dépannage qui t’aideront à entraîner efficacement tes modèles de vision par ordinateur.
À regarder : Conseils pour l’entraînement des modèles | Comment gérer les grands jeux de données | Taille des lots, utilisation du GPU et précision mixte
Comment entraîner un modèle de machine learning#
Un modèle de vision par ordinateur est entraîné en ajustant ses paramètres internes afin de réduire les erreurs. Au départ, le modèle reçoit un grand ensemble d’images annotées. Il prédit ce que représentent ces images, puis ses prédictions sont comparées aux annotations réelles ou au contenu réel pour calculer les erreurs. Ces erreurs indiquent l’écart entre les prédictions du modèle et les valeurs réelles.
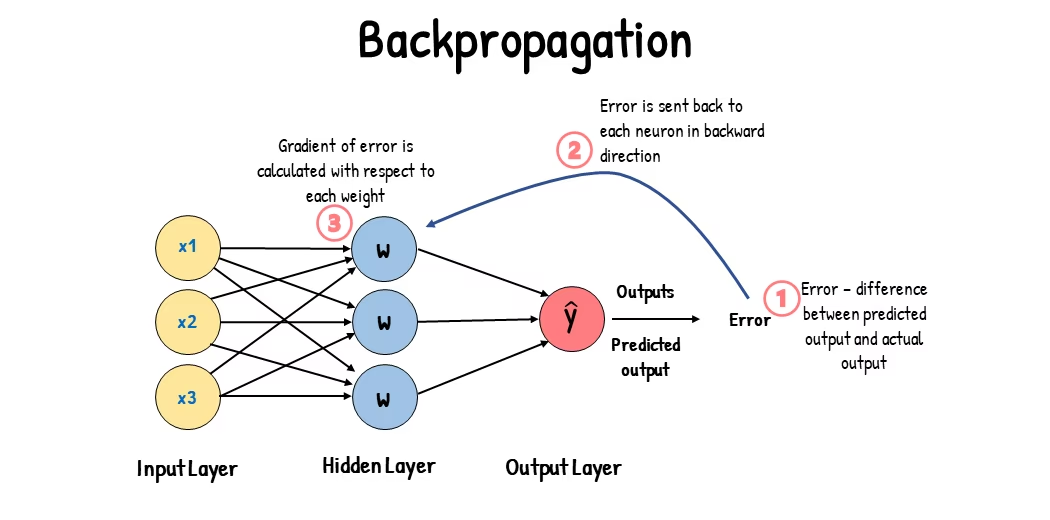
Pendant l’entraînement, le modèle effectue des prédictions de manière itérative, calcule les erreurs et met à jour ses paramètres au moyen d’un processus appelé rétropropagation. Le modèle ajuste alors ses paramètres internes (poids et biais) pour réduire les erreurs. En répétant ce cycle de nombreuses fois, il améliore progressivement sa précision. Avec le temps, il apprend à reconnaître des motifs complexes tels que les formes, les couleurs et les textures.
Ce processus d’apprentissage permet au modèle de vision par ordinateur d’effectuer diverses tâches, notamment la détection d’objets, la segmentation d’instances, la segmentation sémantique et la classification d’images. L’objectif ultime est de créer un modèle capable de généraliser son apprentissage à de nouvelles images jamais vues auparavant, afin de comprendre avec précision les données visuelles dans des applications du monde réel.
Maintenant que nous savons ce qui se passe en coulisses pendant l’entraînement d’un modèle, examinons les points à prendre en compte.
Entraînement sur de grands jeux de données#
Plusieurs aspects sont à prendre en compte si tu prévois d’utiliser un grand jeu de données pour entraîner un modèle. Tu peux, par exemple, ajuster la taille des lots, contrôler l’utilisation du GPU ou choisir l’entraînement mult échelle. Examinons chacune de ces options en détail.
Taille des lots et utilisation du GPU#
Pour entraîner des modèles sur de grands jeux de données, il est essentiel d’utiliser efficacement ton GPU. La taille des lots est un facteur important : elle correspond au nombre d’échantillons de données traités par un modèle de machine learning au cours d’une seule itération d’entraînement. En utilisant la taille de lot maximale prise en charge par ton GPU, tu peux tirer pleinement parti de ses capacités et réduire la durée de l’entraînement. Évite toutefois de saturer la mémoire du GPU. Si tu rencontres des erreurs de mémoire, réduis progressivement la taille des lots jusqu’à ce que l’entraînement se déroule sans problème.
À regarder : Comment utiliser l’inférence par lots avec Ultralytics YOLO26 | Accélérer la détection d’objets en Python 🎉
Avec YOLO26, tu peux définir le paramètre batch dans les arguments du mode Train en fonction de la capacité de ton GPU. Sur un seul accélérateur, batch=-1 évalue le modèle et choisit une taille de lot visant environ 60 % d’utilisation de la mémoire ; une fraction telle que batch=0.70 vise une autre proportion. Les entraînements sur plusieurs GPU nécessitent une taille de lot globale explicite, multiple du nombre d’appareils. Sur CPU et sur les puces Apple, AutoBatch émet un avertissement et revient à batch=16.
Entraînement sur un sous-ensemble#
L’entraînement sur un sous-ensemble est une stratégie efficace qui consiste à entraîner ton modèle sur un petit ensemble de données représentatif du jeu de données complet. Cela permet d’économiser du temps et des ressources, notamment pendant les premières phases de développement et de test du modèle. Si tu manques de temps ou que tu testes différentes configurations, l’entraînement sur un sous-ensemble est une bonne option.
Avec YOLO26, tu peux facilement entraîner un sous-ensemble à l’aide du paramètre fraction. Utilise une proportion telle que fraction=0.1 pour sélectionner 10 % des données d’entraînement, un entier tel que fraction=300 pour sélectionner exactement 300 images d’entraînement, ou une liste [train, val, test] telle que fraction=[300, 100, 0] pour limiter chaque division et ignorer les images de test. Les listes de deux éléments telles que [300, 100] conservent la division de test complète. Les jeux de données NDJSON sélectionnent des enregistrements régulièrement espacés avant de les télécharger ; les exécutions répétées réutilisent donc exactement le même sous-ensemble. Cette technique permet d’effectuer rapidement des itérations et des réglages avant de passer au jeu de données complet.
Entraînement mult échelle#
L’entraînement mult échelle améliore la capacité de généralisation de ton modèle en l’entraînant sur des images de tailles variables. Ton modèle peut ainsi apprendre à détecter des objets à différentes échelles et distances, et devenir plus robuste.
Par exemple, pour entraîner YOLO26, tu peux activer l’augmentation d’échelle en définissant le paramètre scale. Ce paramètre ajuste la taille des images d’entraînement selon un facteur donné, simulant des objets situés à différentes distances. Par exemple, la valeur scale=0.5 applique aléatoirement aux images d’entraînement un zoom compris entre 0,5 et 1,5. Ce paramètre permet à ton modèle de voir différentes échelles d’image et d’améliorer ses capacités de détection pour des objets et des scénarios variés.
Ultralytics prend également en charge l’entraînement mult échelle selon la taille des images, au moyen du paramètre multi_scale. Contrairement à scale, qui effectue un zoom sur les images, puis les complète ou les recadre pour revenir à imgsz, multi_scale modifie directement imgsz à chaque lot (avec un arrondi selon le pas du modèle). Par exemple, avec imgsz=640 et multi_scale=0.25, la taille d’entraînement est choisie entre 480 et 800, par pas correspondant au pas du modèle (par exemple, 480, 512, 544, ..., 800), tandis que multi_scale=0.0 conserve une taille fixe.
Mise en cache#
La mise en cache est une technique importante pour améliorer l’efficacité de l’entraînement des modèles de machine learning. En stockant les images prétraitées en mémoire, elle réduit le temps pendant lequel le GPU attend le chargement des données depuis le disque. Le modèle peut ainsi recevoir des données en continu, sans délai dû aux opérations d’E/S sur le disque.
Tu peux contrôler la mise en cache lors de l’entraînement de YOLO26 à l’aide du paramètre cache :
cache=True: stocke les images du jeu de données en RAM, ce qui offre l’accès le plus rapide au prix d’une consommation de mémoire accrue.cache='disk': stocke les images sur le disque ; cette option est plus lente que la RAM, mais plus rapide que le chargement de nouvelles données à chaque fois.cache=False: désactive la mise en cache et repose entièrement sur les E/S disque, ce qui constitue l’option la plus lente.
Entraînement en précision mixte#
L’entraînement en précision mixte utilise des nombres à virgule flottante sur 16 bits (FP16) et 32 bits (FP32). Il tire parti des avantages des deux formats : FP16 accélère les calculs, tandis que FP32 préserve la précision lorsque c’est nécessaire. La plupart des opérations du réseau neuronal sont effectuées en FP16 pour accélérer les calculs et réduire l’utilisation de la mémoire. Toutefois, une copie maîtresse des poids du modèle est conservée en FP32 pour garantir la précision lors des mises à jour des poids. Tu peux ainsi gérer des modèles ou des tailles de lots plus importants sans dépasser les capacités du matériel.
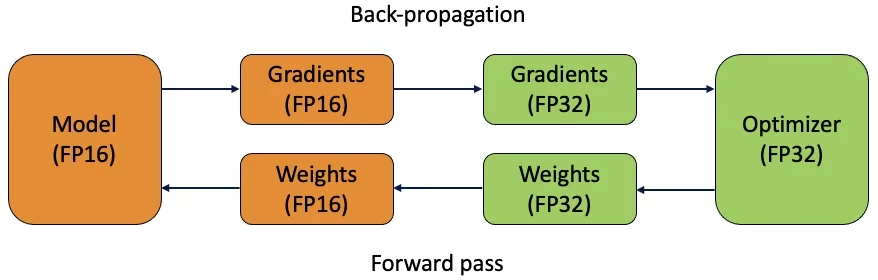
Pour mettre en œuvre l’entraînement en précision mixte, tu dois modifier tes scripts d’entraînement et vérifier que ton matériel (comme les GPU) le prend en charge. De nombreux frameworks modernes de deep learning, notamment PyTorch et TensorFlow, intègrent la prise en charge de la précision mixte.
L’entraînement en précision mixte est simple avec YOLO26 : AMP est activé par défaut (amp=True). Sur un GPU CUDA, YOLO effectue un contrôle ponctuel des capacités au début de l’entraînement et repasse entièrement en FP32 si ce contrôle échoue ; sur CPU et sur les puces Apple, AMP est entièrement désactivé. Définis amp=False pour forcer le mode FP32.
Poids préentraînés#
L’utilisation de poids préentraînés est un moyen efficace d’accélérer l’entraînement de ton modèle. Ces poids proviennent de modèles déjà entraînés sur de grands jeux de données et donnent ainsi une longueur d’avance à ton modèle. L’apprentissage par transfert adapte les modèles préentraînés à de nouvelles tâches apparentées. Pour affiner un modèle préentraîné, commence avec ces poids, puis poursuis l’entraînement sur ton propre jeu de données. Cette méthode accélère l’entraînement et améliore souvent les performances, car le modèle connaît déjà les caractéristiques de base.
Les poids préentraînés proviennent de l’argument model ; model=yolo26n.pt utilise donc déjà les poids COCO au départ. Le paramètre pretrained détermine si ces poids sont conservés (True, valeur par défaut), supprimés (False) ou remplacés par un autre point de contrôle (pretrained=path/to/best.pt). Définir pretrained=True sur un modèle *.yaml ne récupère pas de poids à lui seul. Consulte Comment affiner YOLO sur un jeu de données personnalisé pour découvrir le processus complet d’apprentissage par transfert.
Autres techniques à envisager pour gérer un grand jeu de données#
Voici quelques autres techniques à envisager pour gérer un grand jeu de données :
- Planificateurs de taux d’apprentissage : ils ajustent dynamiquement le taux d’apprentissage pendant l’entraînement. Un taux d’apprentissage bien réglé peut éviter que le modèle ne dépasse les minima et améliorer sa stabilité. Lors de l’entraînement de YOLO26, le paramètre
lrfgère la planification du taux d’apprentissage en définissant le taux final comme une fraction du taux initial. Pour les comportements qui ne sont accessibles par aucun argument, comme les taux d’apprentissage par couche ou l’écrêtage des gradients, crée une sous-classe du trainer. - Entraînement distribué : pour gérer de grands jeux de données, l’entraînement distribué peut changer la donne. Tu peux réduire la durée de l’entraînement en répartissant la charge de travail entre plusieurs GPU ou machines. Cette approche est particulièrement utile pour les projets à l’échelle des entreprises disposant d’importantes ressources de calcul.
- Format mémoire channels-last : l’entraînement CUDA utilise automatiquement la disposition mémoire NHWC, plus rapide, avec PyTorch 1.11 et les versions ultérieures, sauf sous Windows, où les mesures indiquent un ralentissement. Définis
channels_last=Truepour l’imposer ouchannels_last=Falsepour conserver NCHW ; PyTorch 1.10 et les versions antérieures, le CPU et MPS utilisent NCHW par défaut.
Nombre d’époques d’entraînement#
Lors de l’entraînement d’un modèle, une époque correspond à un passage complet sur l’ensemble du jeu de données d’entraînement. Au cours d’une époque, le modèle traite chaque exemple du jeu d’entraînement une fois et met à jour ses paramètres selon l’algorithme d’apprentissage. Plusieurs époques sont généralement nécessaires pour permettre au modèle d’apprendre et d’affiner progressivement ses paramètres.
Une question revient souvent : comment déterminer le nombre d’époques d’entraînement ? Un bon point de départ est de 300 époques. Si le modèle surapprend tôt, tu peux réduire le nombre d’époques. Si le surapprentissage ne se manifeste pas après 300 époques, tu peux prolonger l’entraînement jusqu’à 600, 1 200 époques ou davantage.
Toutefois, le nombre idéal d’époques peut varier selon la taille de ton jeu de données et les objectifs du projet. Les grands jeux de données peuvent nécessiter davantage d’époques pour que le modèle apprenne efficacement, tandis que les petits jeux de données peuvent en nécessiter moins pour éviter le surapprentissage. Avec YOLO26, tu peux définir le paramètre epochs dans ton script d’entraînement.
Arrêt anticipé#
L’arrêt anticipé est une technique utile pour optimiser l’entraînement d’un modèle. En surveillant les performances de validation, tu peux interrompre l’entraînement lorsque le modèle cesse de s’améliorer. Tu économises ainsi des ressources de calcul et préviens le surapprentissage.
Cette méthode consiste à définir un paramètre de patience qui détermine le nombre d’époques à attendre une amélioration des métriques de validation avant d’interrompre l’entraînement. Si les performances du modèle ne s’améliorent pas pendant ce nombre d’époques, l’entraînement s’arrête pour éviter de gaspiller du temps et des ressources.
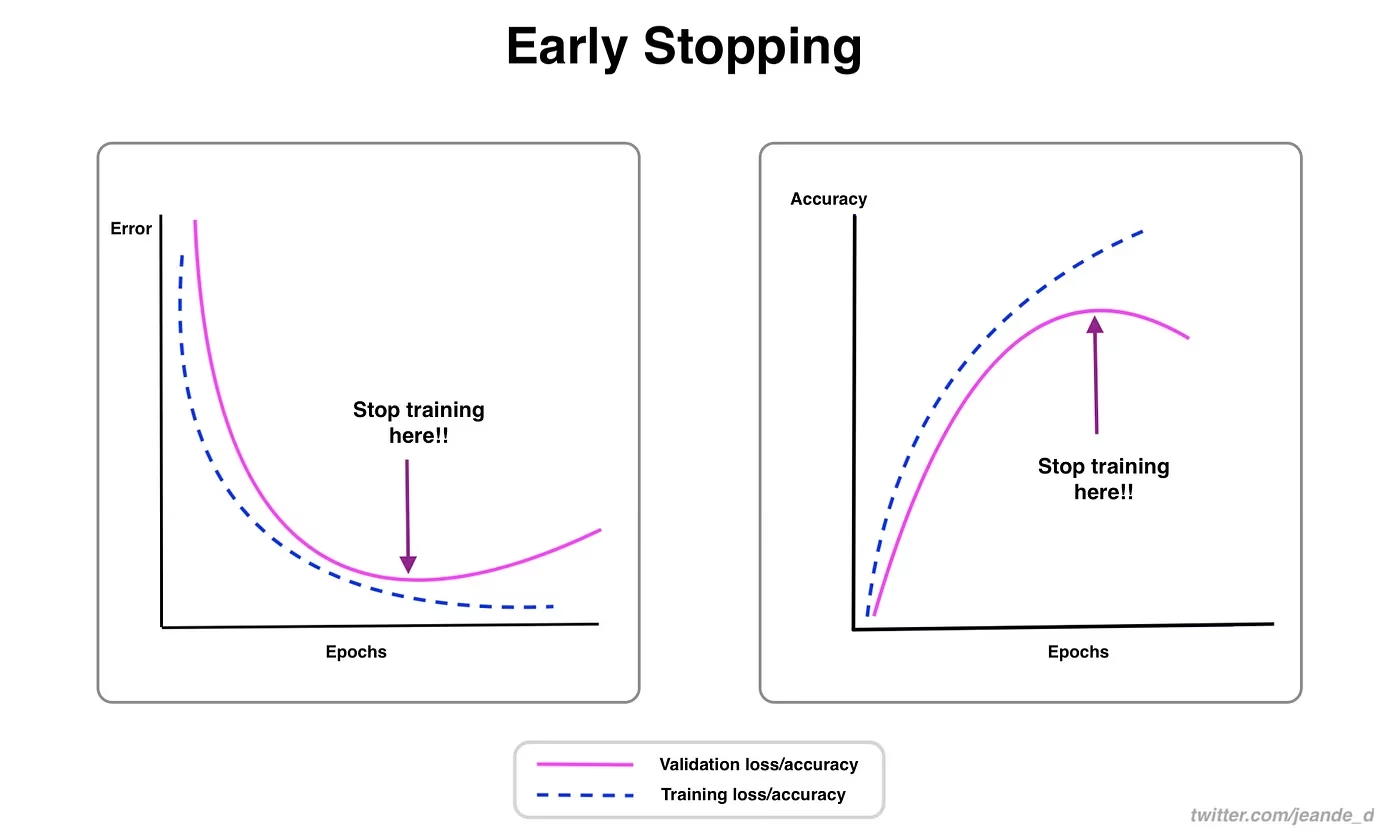
Avec YOLO26, tu peux activer l’arrêt anticipé en définissant le paramètre de patience dans ta configuration d’entraînement. Par exemple, patience=5 signifie que l’entraînement s’arrêtera si les métriques de validation ne s’améliorent pas pendant 5 époques consécutives. Cette méthode garantit un entraînement efficace et des performances optimales sans calculs excessifs.
Choisir entre l’entraînement dans le cloud et l’entraînement local#
Tu as deux options pour entraîner ton modèle : l’entraînement dans le cloud et l’entraînement local.
L’entraînement dans le cloud offre évolutivité et matériel puissant, et convient parfaitement aux grands jeux de données et aux modèles complexes. Des plateformes comme Google Cloud, AWS et Azure donnent un accès à la demande à des GPU et TPU hautes performances, accélérant l’entraînement et permettant d’expérimenter avec des modèles plus grands. Cependant, l’entraînement dans le cloud peut coûter cher, surtout sur de longues périodes, et le transfert des données peut augmenter les coûts et la latence.
L’entraînement local offre davantage de contrôle et de possibilités de personnalisation : tu peux adapter ton environnement à des besoins spécifiques et éviter les coûts récurrents du cloud. Il peut être plus économique pour les projets de longue durée et, comme tes données restent sur site, il est plus sécurisé. Cependant, le matériel local peut être limité en ressources et nécessiter de la maintenance, ce qui peut allonger l’entraînement des grands modèles.
Choisir un optimiseur#
Un optimiseur est un algorithme qui ajuste les poids de ton réseau neuronal afin de minimiser la fonction de perte, laquelle mesure les performances du modèle. En termes plus simples, l’optimiseur aide le modèle à apprendre en ajustant ses paramètres pour réduire les erreurs. Le choix du bon optimiseur influe directement sur la rapidité et la précision avec lesquelles le modèle apprend.
Tu peux aussi affiner les paramètres de l’optimiseur pour améliorer les performances du modèle. Ajuster le taux d’apprentissage détermine la taille des pas effectués lors de la mise à jour des paramètres. Pour assurer la stabilité, tu peux commencer par un taux d’apprentissage modéré, puis le diminuer progressivement afin d’améliorer l’apprentissage à long terme. De plus, le réglage du momentum détermine l’influence des mises à jour précédentes sur les mises à jour actuelles. Une valeur courante pour le momentum est d’environ 0,9. Elle offre généralement un bon équilibre.
Optimiseurs courants#
Les différents optimiseurs ont des points forts et des faiblesses variés. Voici un aperçu de quelques optimiseurs courants.
-
SGD (descente de gradient stochastique) :
- Met à jour les paramètres du modèle à l’aide du gradient de la fonction de perte par rapport aux paramètres.
- Simple et efficace, mais peut converger lentement et rester bloqué dans des minima locaux.
-
Adam (estimation adaptative des moments) :
- Combine les avantages du SGD avec momentum et de RMSProp.
- Ajuste le taux d’apprentissage de chaque paramètre en fonction d’estimations des premier et deuxième moments des gradients.
- Convient bien aux données bruitées et aux gradients clairsemés.
- Efficace et nécessite généralement moins de réglages. Pour les entraînements courts,
optimizer=autode YOLO26 sélectionne AdamW, étroitement apparenté, plutôt qu’Adam lui-même.
-
RMSProp (propagation de la moyenne quadratique) :
- Ajuste le taux d’apprentissage de chaque paramètre en divisant le gradient par une moyenne glissante des amplitudes des gradients récents.
- Aide à gérer le problème de disparition du gradient et se révèle efficace pour les réseaux neuronaux récurrents.
-
MuSGD (hybride Muon + SGD) :
- Combine des mises à jour de type SGD à un comportement inspiré de Muon pour améliorer la stabilité des entraînements à grande échelle.
- Un bon choix si tu veux une capacité de généralisation semblable à celle de SGD, mais une convergence plus régulière que celle de SGD classique.
- Particulièrement pertinent pour les recettes d’entraînement YOLO26 ; si tu hésites, commence avec
optimizer=autoet compare-le à MuSGD sur ton jeu de données.
Pour YOLO26, le paramètre optimizer te permet de choisir parmi divers optimiseurs, notamment SGD, MuSGD, Adam, Adamax, AdamW, NAdam, RAdam et RMSProp. Tu peux aussi le définir sur auto pour sélectionner automatiquement l’optimiseur en fonction du nombre d’itérations d’entraînement.
yolo train model=yolo26n.pt data=coco8.yaml optimizer=MuSGDRejoindre la communauté#
Faire partie d’une communauté de passionnés de vision par ordinateur peut t’aider à résoudre des problèmes et à apprendre plus rapidement. Voici quelques façons d’échanger, d’obtenir de l’aide et de partager tes idées.
Ressources communautaires#
- Problèmes GitHub : rends-toi sur le dépôt GitHub de YOLO26 et utilise l’onglet Issues pour poser des questions, signaler des bugs et suggérer de nouvelles fonctionnalités. La communauté et les responsables du projet sont très actifs et prêts à t’aider.
- Serveur Discord d’Ultralytics : rejoins le serveur Discord d’Ultralytics pour discuter avec d’autres utilisateurs et développeurs, obtenir de l’aide et partager tes expériences.
Documentation officielle#
- Documentation Ultralytics YOLO26 : consulte la documentation officielle de YOLO26 pour trouver des guides détaillés et des conseils pratiques sur divers projets de vision par ordinateur.
Ces ressources t’aideront à relever les défis et à rester au fait des dernières tendances et pratiques de la communauté de la vision par ordinateur.
Points essentiels à retenir#
L’entraînement de modèles de vision par ordinateur implique de suivre de bonnes pratiques, d’optimiser tes stratégies et de résoudre les problèmes au fur et à mesure. Des techniques comme l’ajustement de la taille des lots, l’entraînement en précision mixte et le démarrage à partir de poids préentraînés peuvent améliorer les performances de tes modèles et accélérer leur entraînement. Des méthodes comme l’entraînement sur un sous-ensemble et l’arrêt anticipé t’aident à économiser du temps et des ressources. Rester en contact avec la communauté et suivre les nouvelles tendances t’aidera à améliorer continuellement tes compétences en entraînement de modèles.
FAQ#
Pour améliorer l’utilisation du GPU, règle le paramètre
batchsur la taille maximale prise en charge par ton GPU. Sur un seul accélérateur,batch=-1profile le modèle et vise environ 60 % d’utilisation de la mémoire. Il se rabat surbatch=16sur CPU et sur les puces Apple, tandis que les exécutions multi-GPU nécessitent une taille de lot globale explicite, multiple du nombre de périphériques. Pour en savoir plus, consulte les arguments du mode Train.L’entraînement en précision mixte utilise des types à virgule flottante de 16 bits (FP16) et de 32 bits (FP32) afin d’équilibrer vitesse de calcul et précision. Dans YOLO26, cette fonctionnalité est activée par défaut via
amp=True; définisamp=Falsepour imposer FP32. AMP n’est pas utilisé sur CPU ni sur les puces Apple. Pour en savoir plus, consulte les arguments du mode Train.L’entraînement mult échelle améliore les performances du modèle en l’entraînant sur des images de différentes tailles, ce qui lui permet de mieux généraliser à différentes échelles et distances. YOLO26 propose deux paramètres distincts à cet effet.
scale=0.5échantillonne un facteur de zoom entre 0,5 et 1,5, puis ajoute du remplissage ou recadre l’image pour revenir à uneimgszfixe, tandis quemulti_scale=0.25fait varierimgszlui-même à chaque lot, par pas de stride. Pour connaître les réglages et en savoir plus, consulte la documentation du mode Train.L’utilisation de poids préentraînés peut considérablement accélérer l’entraînement et améliorer la précision du modèle en tirant parti d’un modèle déjà familiarisé avec les caractéristiques visuelles fondamentales. Charge-les via l’argument
model, comme dansmodel=yolo26n.pt;pretraineddétermine ensuite si ces poids sont conservés (True, valeur par défaut), supprimés (False) ou remplacés par un autre point de contrôle (pretrained=path/to/best.pt, la méthode pour transférer des poids vers une versionmodel=*.yaml). Pour en savoir plus, consulte la documentation du mode Train.Le nombre d’époques correspond aux passages complets sur le jeu de données d’entraînement pendant l’entraînement du modèle. Un point de départ courant est de 300 époques. Si ton modèle surapprend rapidement, tu peux réduire ce nombre. À l’inverse, si tu n’observes pas de surapprentissage, tu peux prolonger l’entraînement à 600, 1 200 époques, voire davantage. Pour définir ce nombre dans YOLO26, utilise le paramètre
epochsdans ton script d’entraînement. Pour obtenir des conseils supplémentaires sur la détermination du nombre idéal d’époques, consulte cette section sur le nombre d’époques.