Ultralytics YOLO26 su NVIDIA Jetson con DeepStream SDK e TensorRT#
Guarda: Come usare i modelli Ultralytics YOLO26 con NVIDIA DeepStream su Jetson Orin NX 🚀
Questa guida completa illustra nel dettaglio come distribuire Ultralytics YOLO26 sui dispositivi NVIDIA Jetson usando DeepStream SDK e TensorRT. Qui usiamo TensorRT per massimizzare le prestazioni di inferenza sulla piattaforma Jetson.
Questa guida illustra la configurazione di DeepStream per YOLO26, la calibrazione INT8, la configurazione multi-stream e i risultati dei benchmark.
Questa guida è stata testata con NVIDIA Jetson Orin Nano Super Developer Kit con la versione JetPack JP6.1, Seeed Studio reComputer J4012, basato su NVIDIA Jetson Orin NX 16GB con la versione JetPack JP5.1.3, e Seeed Studio reComputer J1020 v2, basato su NVIDIA Jetson Nano 4GB con la versione JetPack JP4.6.4. È previsto che funzioni con tutta la gamma di hardware NVIDIA Jetson, inclusi i modelli più recenti e quelli meno recenti.
Che cos'è NVIDIA DeepStream?#
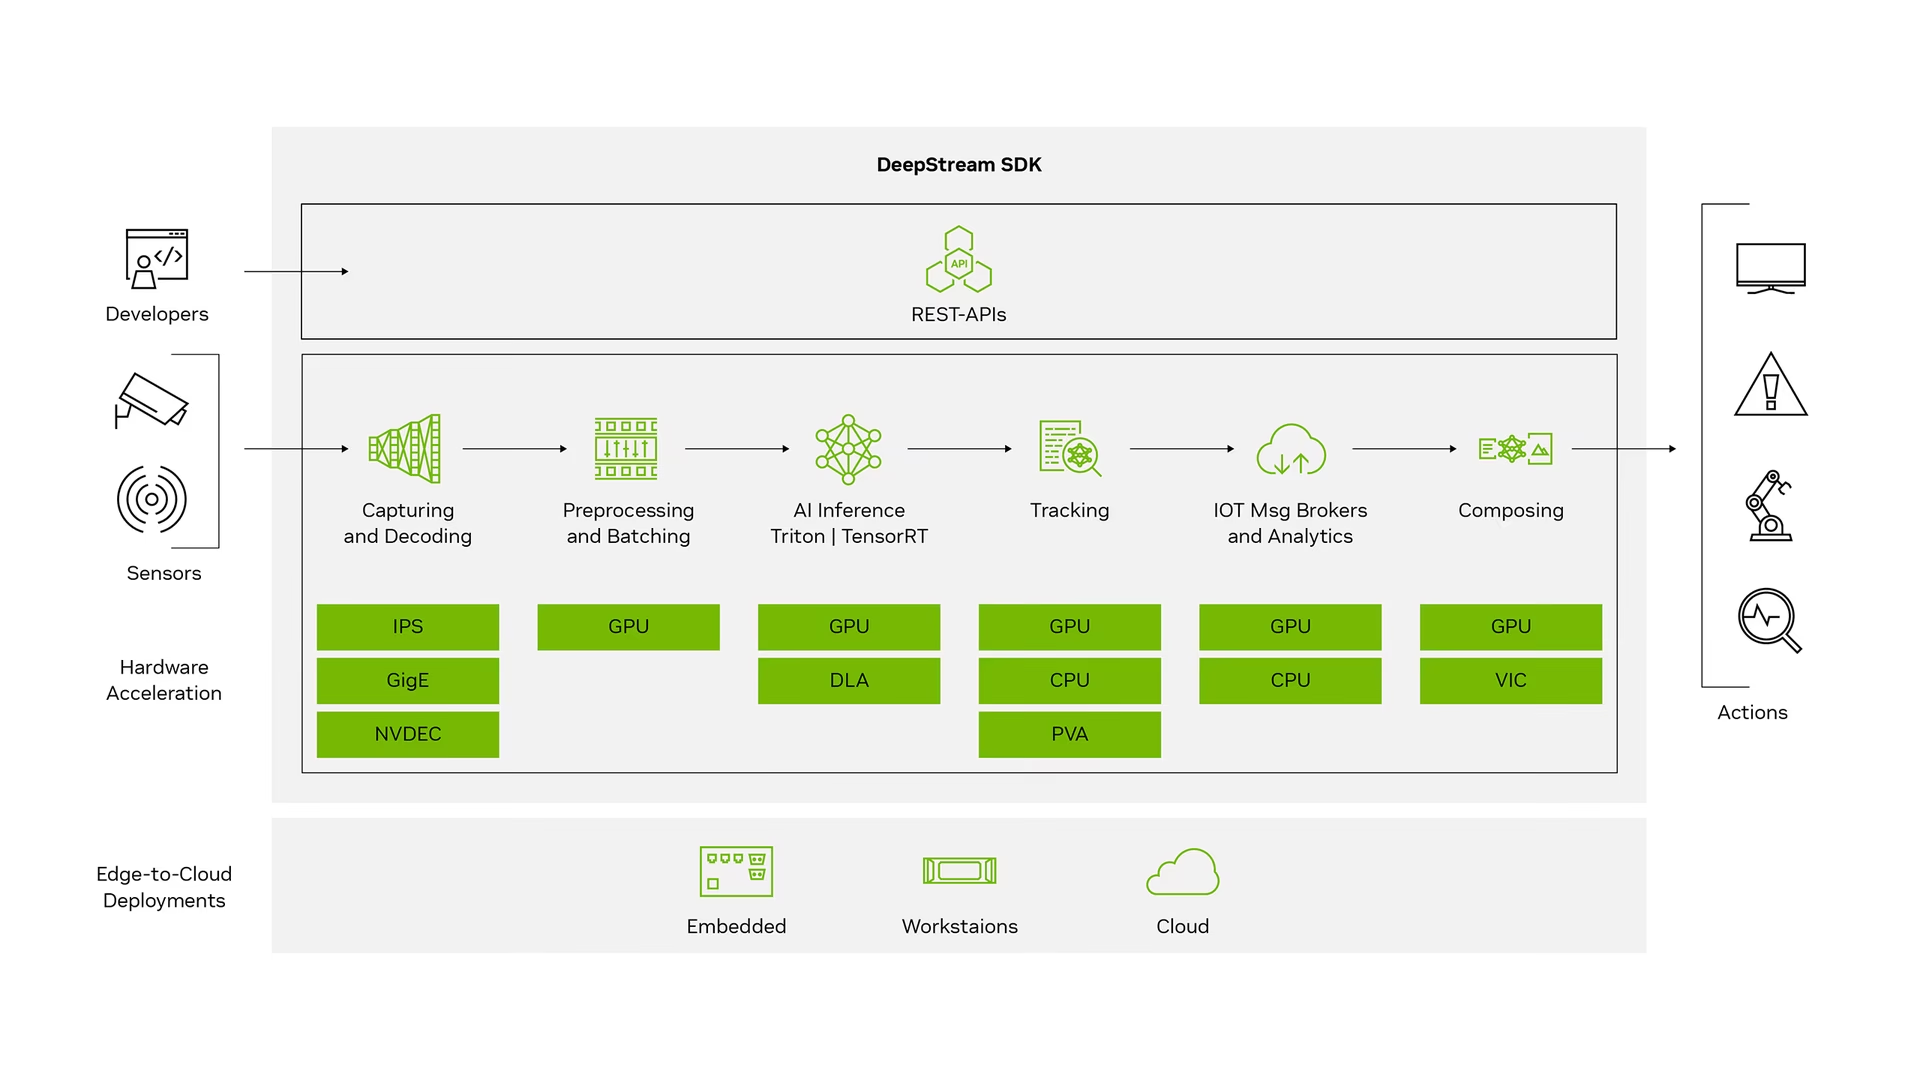
DeepStream SDK di NVIDIA è un toolkit completo per l'analisi di stream basato su GStreamer, per l'elaborazione multisensore basata su AI e la comprensione di video, audio e immagini. È ideale per sviluppatori di AI per la visione, partner software, startup e OEM che realizzano app e servizi IVA (analisi video intelligente). Ora puoi creare pipeline di elaborazione degli stream che integrano reti neurali e altre attività di elaborazione complesse, come il tracciamento, la codifica/decodifica video e il rendering video. Queste pipeline consentono l'analisi in tempo reale di video, immagini e dati dei sensori. Il supporto multipiattaforma di DeepStream ti offre un modo più rapido e semplice per sviluppare applicazioni e servizi di AI per la visione on-premise, all'edge e nel cloud.
Prerequisiti#
Prima di iniziare a seguire questa guida:
- Consulta la nostra documentazione, Guida introduttiva: NVIDIA Jetson con Ultralytics YOLO26, per configurare il tuo dispositivo NVIDIA Jetson con Ultralytics YOLO26
- Installa DeepStream SDK in base alla versione di JetPack
- Per JetPack 4.6.4, installa DeepStream 6.0.1
- Per JetPack 5.1.3, installa DeepStream 6.3
- Per JetPack 6.1, installa DeepStream 7.1
- Per JetPack 7.1, installa DeepStream 9.0
In questa guida abbiamo usato il metodo del pacchetto Debian per installare DeepStream SDK sul dispositivo Jetson. Puoi anche visitare DeepStream SDK su Jetson (archiviato) per accedere alle versioni precedenti di DeepStream.
Configurazione di DeepStream per YOLO26#
Qui usiamo il repository GitHub marcoslucianops/DeepStream-Yolo, che include il supporto di NVIDIA DeepStream SDK per i modelli YOLO. Apprezziamo il lavoro di marcoslucianops e il suo contributo!
-
Installa Ultralytics con le dipendenze necessarie
pip install ultralytics onnx onnxslim -
Clona il repository DeepStream-Yolo
cd ~ git clone https://github.com/marcoslucianops/DeepStream-Yolo -
Scarica il modello di rilevamento Ultralytics YOLO26 (.pt) che preferisci dal progetto YOLO26. Qui usiamo yolo26s.pt.
wget https://github.com/ultralytics/assets/releases/download/v8.4.0/yolo26s.pt
Puoi anche usare un modello YOLO26 addestrato su dati personalizzati.
-
Converti il modello in ONNX e scrivi il file
labels.txtda cui DeepStream legge i nomi delle classifrom ultralytics import YOLO model = YOLO("yolo26s.pt") model.export(format="onnx", nms=False, agnostic_nms=True) # crea 'yolo26s.onnx' with open("labels.txt", "w") as f: f.write("\n".join(model.names.values()))
nms=False esporta la head senza NMS, mentre agnostic_nms=True mantiene una sola classe per rilevamento, così cluster-mode=4 (no clustering) nella configurazione di DeepStream non disegna due volte lo stesso riquadro. Aggiungi imgsz=1280 per modificare la dimensione di inferenza (predefinita: 640), batch=4 per una dimensione del batch pari a 4 (il batch esportato è statico, quindi deve corrispondere a batch-size nella configurazione di DeepStream) e opset=12 per TensorRT 8.2 o versioni precedenti (DeepStream 6.0.1 e precedenti). Consulta gli argomenti di esportazione per l'elenco completo.
-
Copia il file del modello generato
.onnxe il filelabels.txtnella cartellaDeepStream-Yolocp yolo26s.onnx labels.txt ~/DeepStream-Yolo cd ~/DeepStream-Yolo -
Imposta la versione di CUDA in base alla versione di JetPack installata
Per JetPack 4.6.4:
export CUDA_VER=10.2Per JetPack 5.1.3:
export CUDA_VER=11.4Per JetPack 6.1:
export CUDA_VER=12.6Per JetPack 7.1:
export CUDA_VER=13.0 -
Compila la libreria
make -C nvdsinfer_custom_impl_Yolo clean && make -C nvdsinfer_custom_impl_Yolo -
Modifica il file
config_infer_primary_yolo26.txtin base al tuo modello (per YOLO26s con 80 classi)[property] ... onnx-file=yolo26s.onnx ... num-detected-classes=80 ... parse-bbox-func-name=NvDsInferParseYolo ...
YOLO26 ridimensiona l'input con padding centrato ed esegue l'inferenza senza NMS. Per ottenere la migliore accuratezza, aggiungi quanto segue alla sezione [property] di config_infer_primary_yolo26.txt:
[property]
...
maintain-aspect-ratio=1
symmetric-padding=1
cluster-mode=4
...-
Modifica il file
deepstream_app_config... [primary-gie] ... config-file=config_infer_primary_yolo26.txt -
Puoi anche cambiare la sorgente video nel file
deepstream_app_config. Qui viene caricato un file video predefinito... [source0] ... uri=file:///opt/nvidia/deepstream/deepstream/samples/streams/sample_1080p_h264.mp4
Esegui l'inferenza#
deepstream-app -c deepstream_app_config.txtLa generazione del file del motore TensorRT richiederà molto tempo prima dell'avvio dell'inferenza. Abbi pazienza.
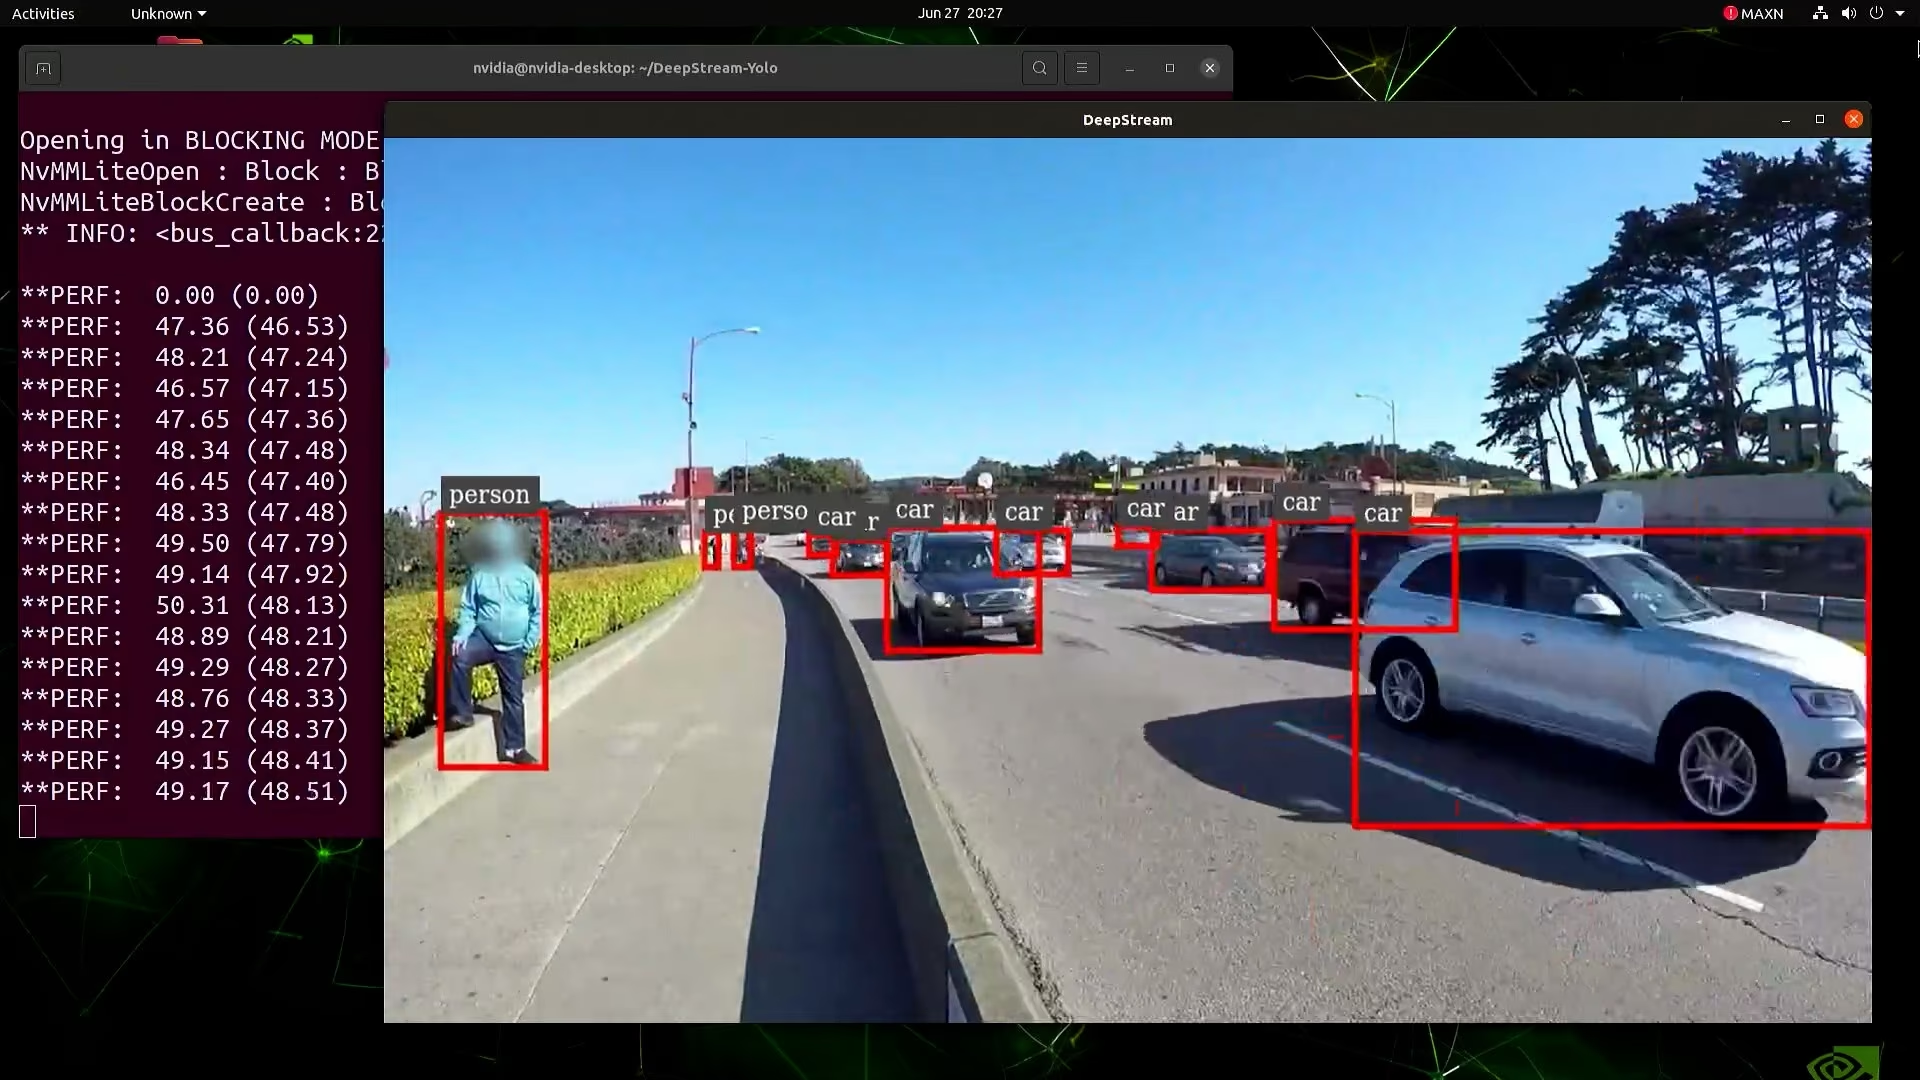
Se vuoi convertire il modello con precisione FP16, imposta semplicemente model-engine-file=model_b1_gpu0_fp16.engine e network-mode=2 all'interno di config_infer_primary_yolo26.txt
Calibrazione INT8#
Se vuoi usare la precisione INT8 per l'inferenza, segui i passaggi seguenti:
Al momento INT8 non funziona con TensorRT 10.x. Questa sezione della guida è stata testata con TensorRT 8.x, con cui dovrebbe funzionare.
-
Imposta la variabile d'ambiente
OPENCVexport OPENCV=1 -
Compila la libreria
make -C nvdsinfer_custom_impl_Yolo clean && make -C nvdsinfer_custom_impl_Yolo -
Per il dataset COCO, scarica val2017, estrailo e spostalo nella cartella
DeepStream-Yolo -
Crea una nuova directory per le immagini di calibrazione
mkdir calibration -
Esegui il comando seguente per selezionare 1000 immagini casuali dal dataset COCO da usare per la calibrazione
for jpg in $(ls -1 val2017/*.jpg | sort -R | head -1000); do
  cp ${jpg} calibration/
done
NVIDIA consiglia almeno 500 immagini per ottenere una buona accuratezza. In questo esempio vengono scelte 1000 immagini per ottenere una maggiore accuratezza (più immagini = maggiore accuratezza). Puoi impostare il valore con head -1000. Per esempio, per 2000 immagini, usa head -2000. Questo processo può richiedere molto tempo.
-
Crea il file
calibration.txtcon tutte le immagini selezionaterealpath calibration/*jpg > calibration.txt -
Imposta le variabili d'ambiente
export INT8_CALIB_IMG_PATH=calibration.txt
export INT8_CALIB_BATCH_SIZE=1
Valori più elevati di INT8_CALIB_BATCH_SIZE consentono di ottenere maggiore accuratezza e una calibrazione più rapida. Imposta il valore in base alla memoria della tua GPU.
-
Aggiorna il file
config_infer_primary_yolo26.txtDa
...
model-engine-file=model_b1_gpu0_fp32.engine
#int8-calib-file=calib.table
...
network-mode=0
...
A
...
model-engine-file=model_b1_gpu0_int8.engine
int8-calib-file=calib.table
...
network-mode=1
...
Esegui l'inferenza INT8#
Esegui lo stesso comando per compilare il motore INT8 e avviare l'inferenza:
deepstream-app -c deepstream_app_config.txtConfigurazione MultiStream#
Guarda: Come eseguire inferenze multi-stream con Ultralytics YOLO26 usando NVIDIA DeepStream su Jetson Orin 🚀
Per configurare più stream in una singola applicazione DeepStream, apporta le modifiche seguenti al file deepstream_app_config.txt:
-
Modifica il numero di righe e colonne per creare una griglia in base al numero di stream che vuoi usare. Per esempio, per 4 stream, puoi aggiungere 2 righe e 2 colonne.
[tiled-display] rows=2 columns=2 -
Aggiungi un gruppo
[sourceN]separato per ogni stream, ciascuno con i propriurienum-sources=1.[source0] enable=1 type=3 uri=file:///path/to/video1.mp4 num-sources=1 [source1] enable=1 type=3 uri=file:///path/to/video2.mp4 num-sources=1 [source2] enable=1 type=3 uri=file:///path/to/video3.mp4 num-sources=1 [source3] enable=1 type=3 uri=file:///path/to/video4.mp4 num-sources=1
Esegui l'inferenza multi-stream#
Esegui lo stesso comando per avviare tutti gli stream nella visualizzazione a mosaico:
deepstream-app -c deepstream_app_config.txt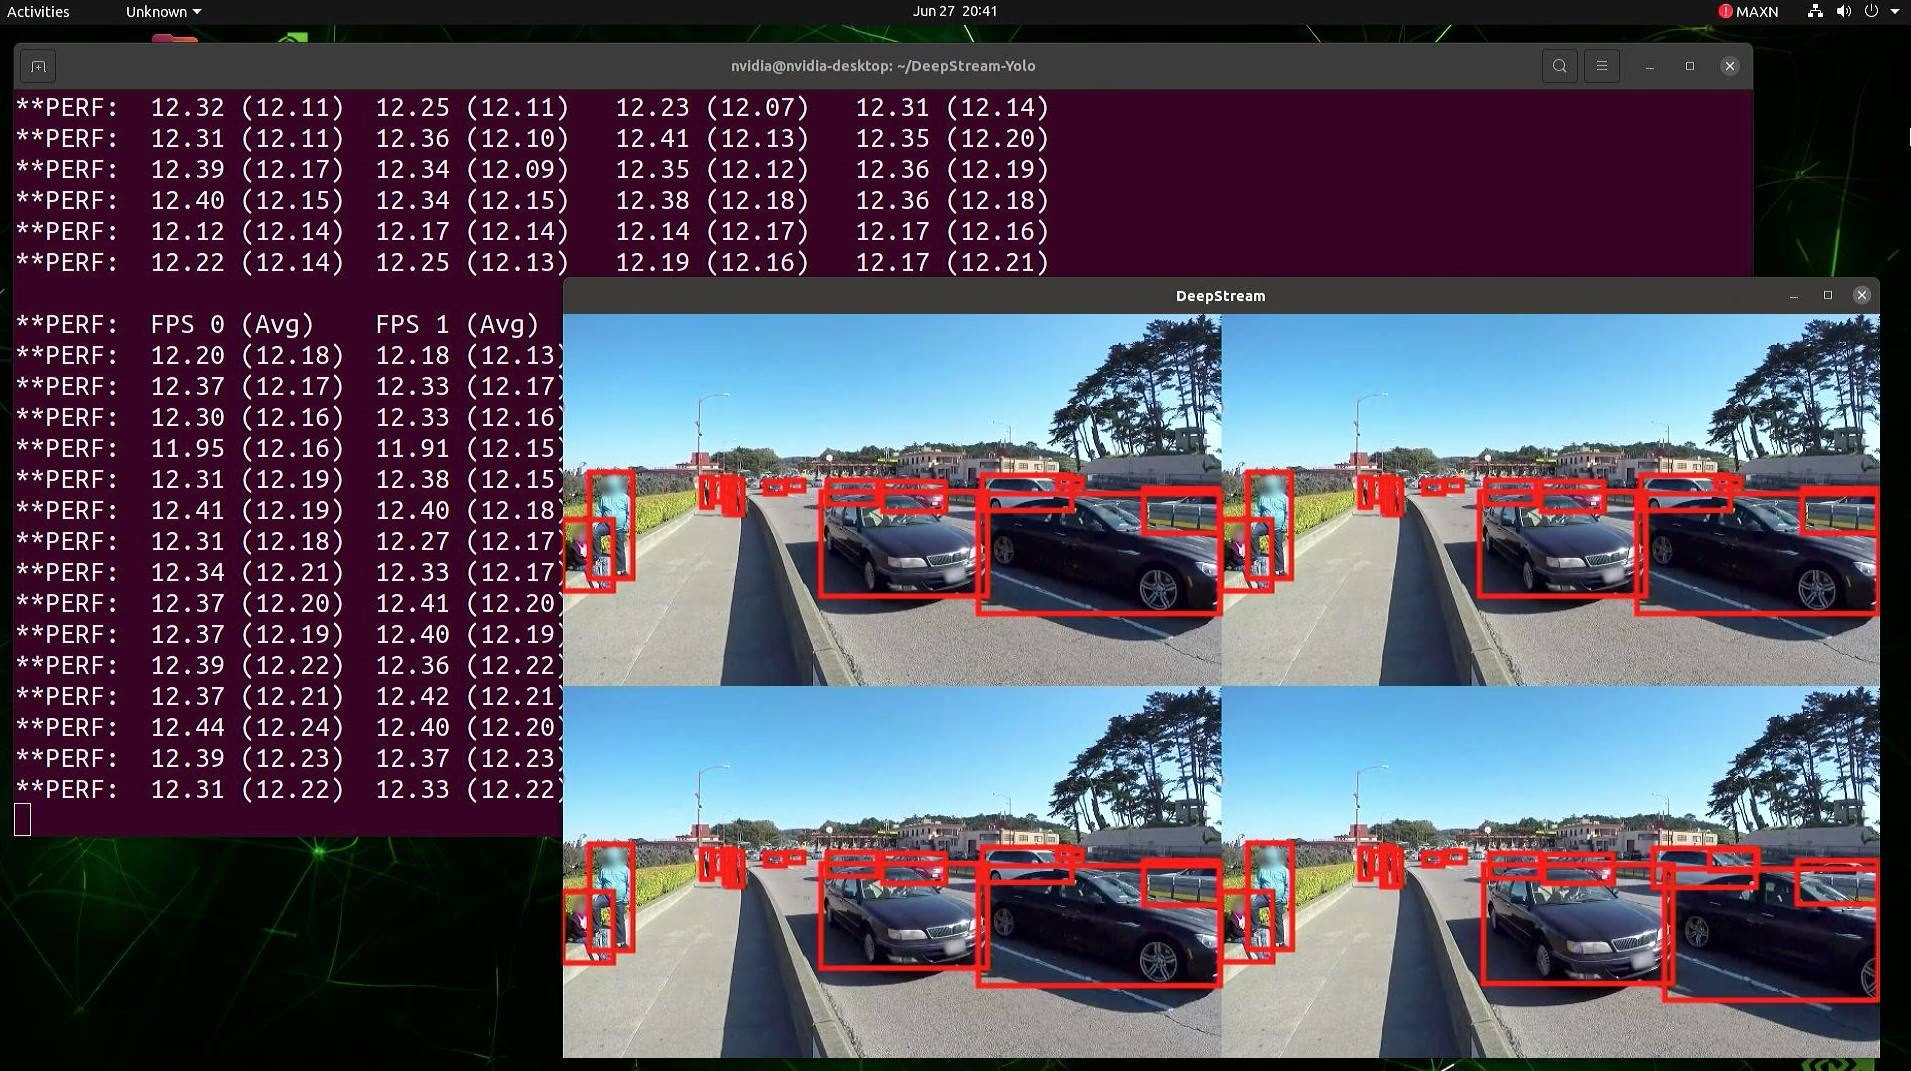
Risultati dei benchmark#
I seguenti benchmark riassumono le prestazioni dei modelli YOLO11 ai diversi livelli di precisione TensorRT, con una dimensione di input di 640x640 su NVIDIA Jetson Orin NX 16GB. YOLO26 usa lo stesso flusso di lavoro di esportazione e inferenza DeepStream descritto sopra.
Grafico di confronto#
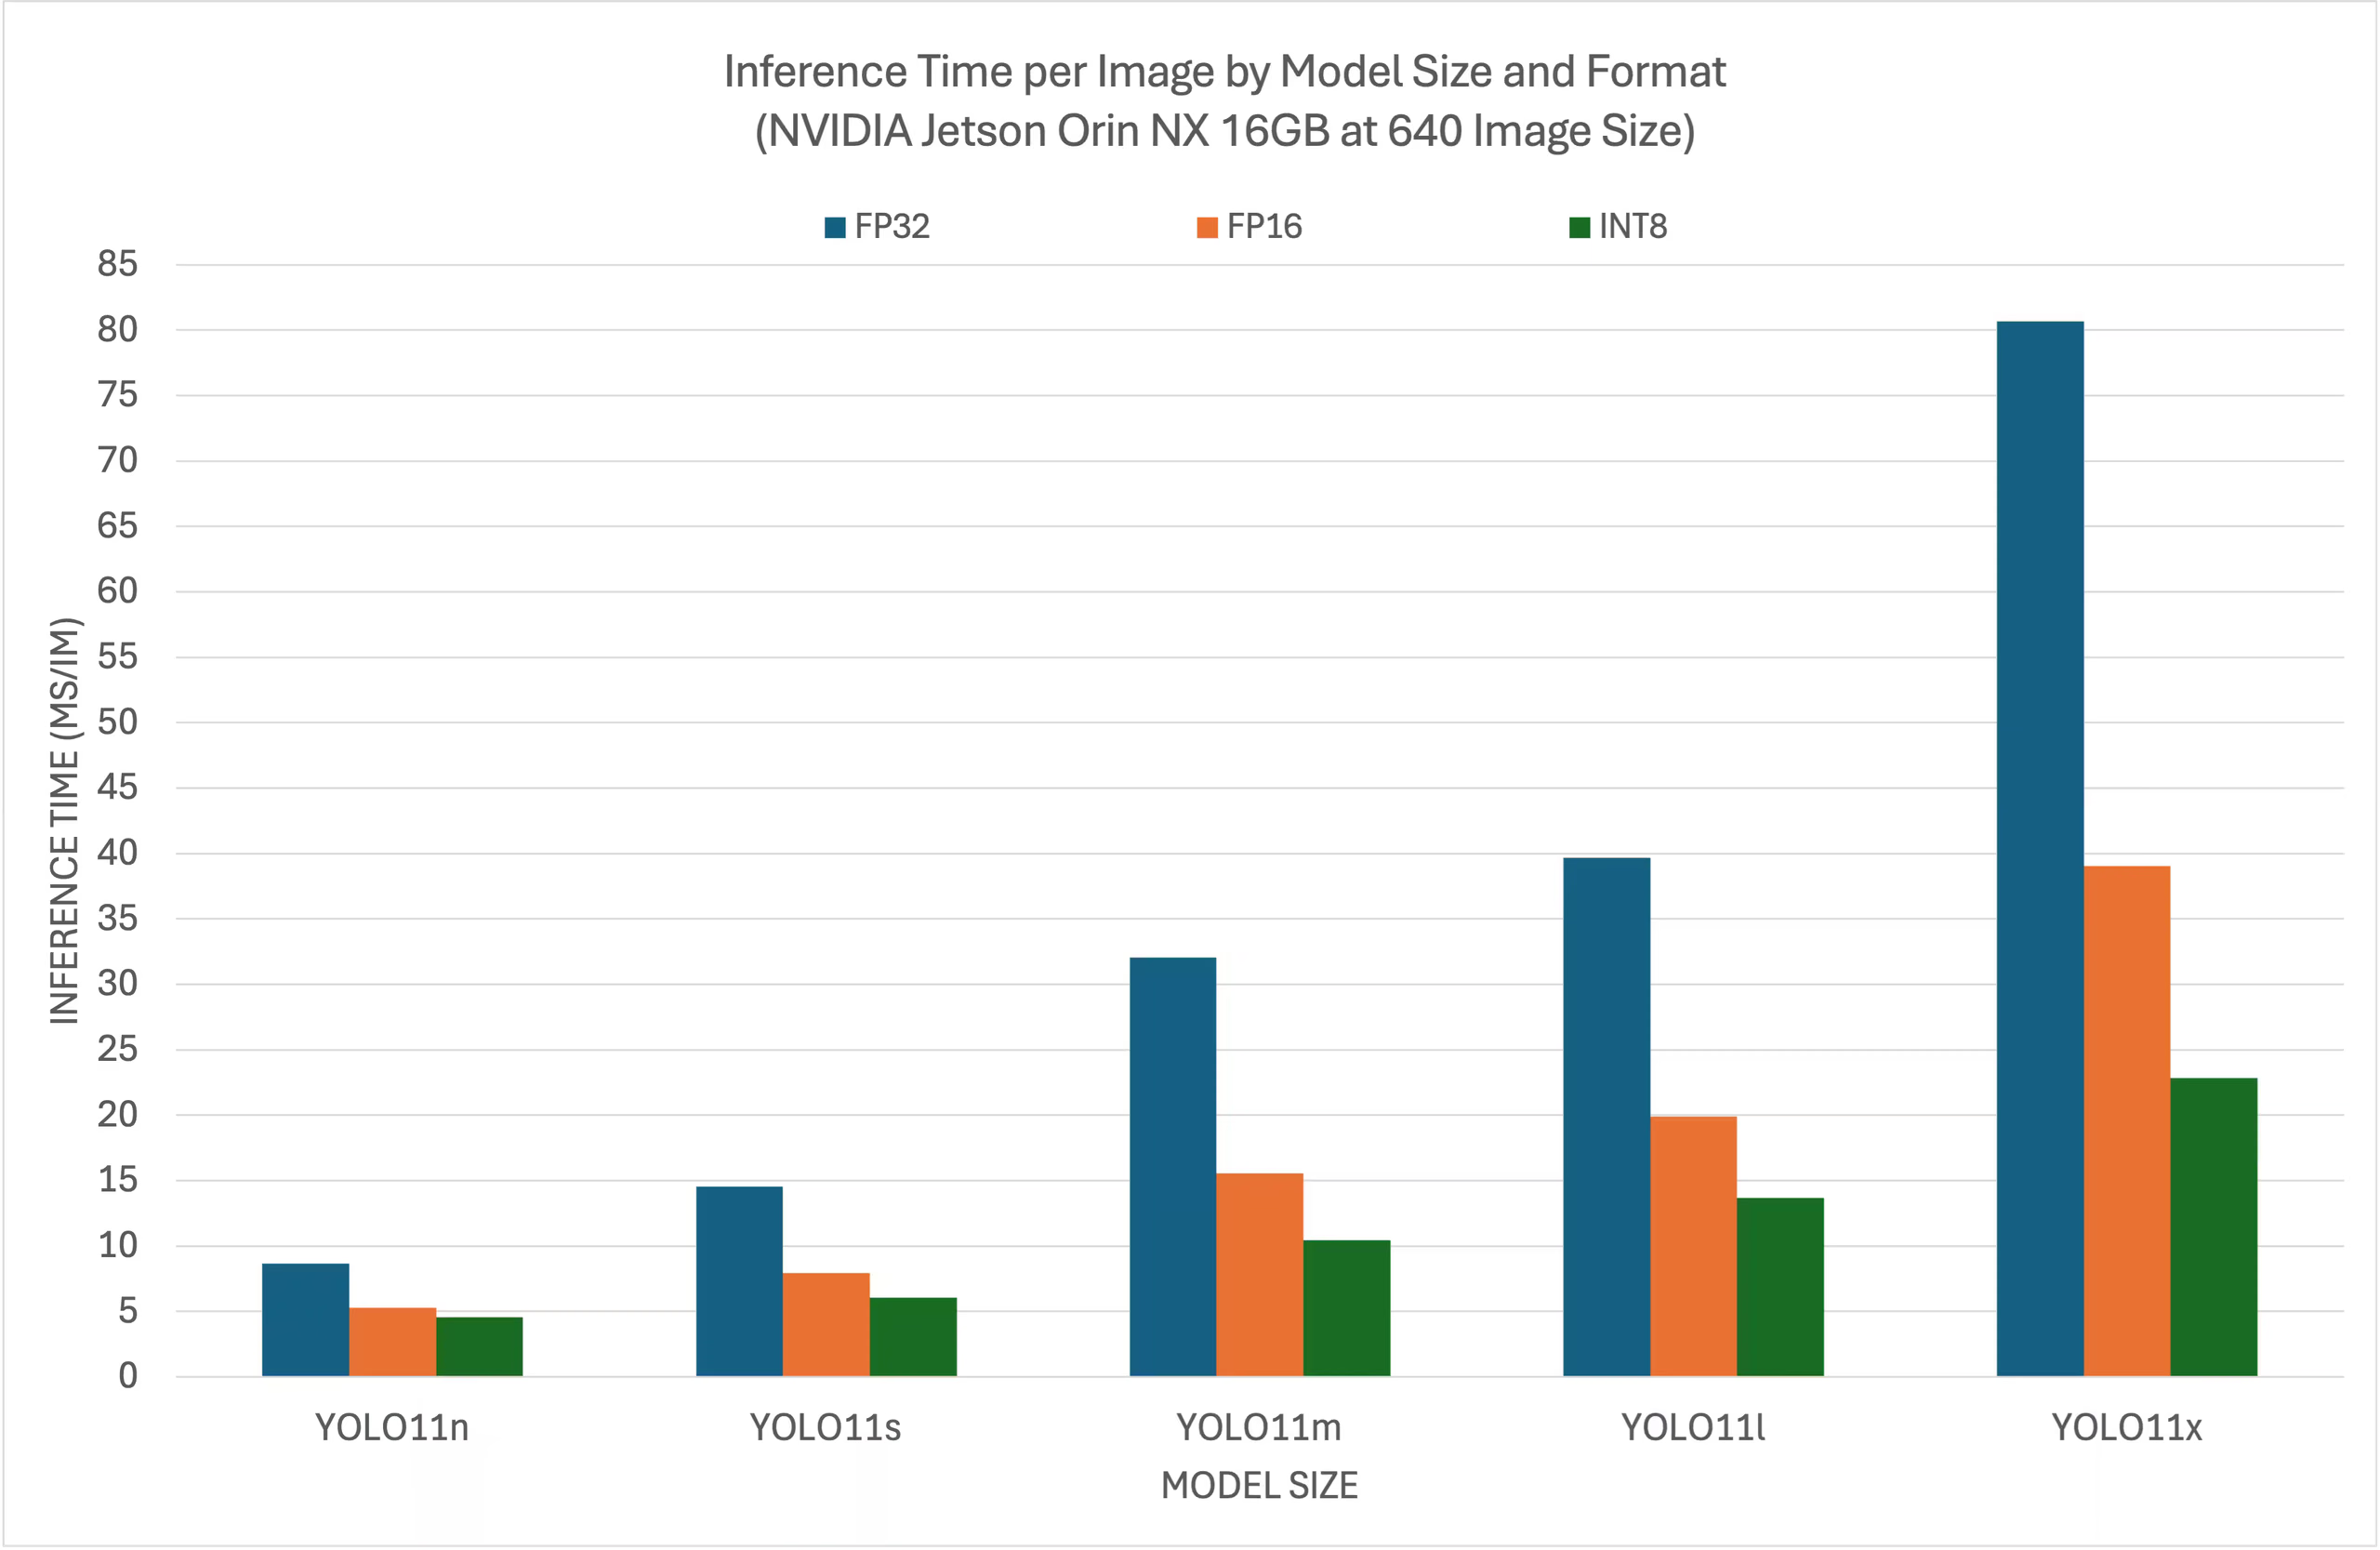
Tabella di confronto dettagliata#
| Formato | Stato | Tempo di inferenza (ms/im) |
|---|---|---|
| TensorRT (FP32) | ✅ | 8.64 |
| TensorRT (FP16) | ✅ | 5.27 |
| TensorRT (INT8) | ✅ | 4.54 |
Ringraziamenti#
Questa guida è stata creata inizialmente dai nostri amici di Seeed Studio, Lakshantha ed Elaine.
Domande frequenti#
Per configurare Ultralytics YOLO26 su un dispositivo NVIDIA Jetson, devi prima installare DeepStream SDK compatibile con la tua versione di JetPack. Segui la guida passo passo nella nostra Guida introduttiva per configurare NVIDIA Jetson per la distribuzione di YOLO26.
L'uso di TensorRT con YOLO26 ottimizza il modello per l'inferenza, riducendo notevolmente la latenza e migliorando il throughput sui dispositivi NVIDIA Jetson. TensorRT offre inferenza di deep learning ad alte prestazioni e bassa latenza grazie alla fusione dei layer, alla calibrazione della precisione e all'ottimizzazione automatica dei kernel. Questo consente un'esecuzione più rapida ed efficiente, particolarmente utile per applicazioni in tempo reale come l'analisi video e i sistemi autonomi.
Sì, la guida alla distribuzione di Ultralytics YOLO26 con DeepStream SDK e TensorRT è compatibile con l'intera gamma NVIDIA Jetson. Include dispositivi come Jetson Orin NX 16GB con JetPack 5.1.3 e Jetson Nano 4GB con JetPack 4.6.4. Consulta la sezione Configurazione di DeepStream per YOLO26 per i passaggi dettagliati.
Esporta il modello con la head senza NMS usando l'esportatore Ultralytics e scrivi il file
labels.txtda cui DeepStream legge i nomi delle classi:from ultralytics import YOLO model = YOLO("yolo26s.pt") model.export(format="onnx", nms=False, agnostic_nms=True) # crea 'yolo26s.onnx' with open("labels.txt", "w") as f: f.write("\n".join(model.names.values()))Aggiungi
opset=12per TensorRT 8.2 o versioni precedenti (DeepStream 6.0.1 e precedenti). Per maggiori dettagli sulla conversione dei modelli, consulta la nostra sezione sull'esportazione dei modelli.Per eseguire l'inferenza INT8, calibra il modello su un set rappresentativo di immagini e imposta la configurazione di DeepStream sulla modalità INT8. Scarica le immagini COCO val2017, seleziona circa 1000 immagini di calibrazione, imposta le variabili d'ambiente
INT8_CALIB_IMG_PATHeINT8_CALIB_BATCH_SIZE, quindi aggiornaconfig_infer_primary_yolo26.txtconmodel-engine-file=model_b1_gpu0_int8.engine,int8-calib-file=calib.tableenetwork-mode=1. Consulta la sezione Calibrazione INT8 per la procedura completa. Al momento INT8 richiede TensorRT 8.x.Per elaborare più stream in una singola applicazione DeepStream, modifica il file
deepstream_app_config.txtper aggiungere una griglia di visualizzazione a mosaico e specificare l'URI di ciascuna sorgente. Impostarowsecolumnsin[tiled-display]per creare la griglia, aggiungi un gruppo[sourceN]separato per ogni stream con i propriurienum-sources=1, quindi adatta la griglia al numero di stream. Consulta la sezione Configurazione MultiStream per un esempio completo.Le prestazioni dei modelli YOLO11 su NVIDIA Jetson Orin NX 16GB variano in base ai livelli di precisione TensorRT. Ad esempio, i modelli YOLO11s raggiungono:
- Precisione FP32: 14.53 ms/im, 68.8 FPS
- Precisione FP16: 7.91 ms/im, 126 FPS
- Precisione INT8: 6.05 ms/im, 165 FPS
Questi benchmark sottolineano l'efficienza e le prestazioni dei modelli YOLO11 ottimizzati per TensorRT su hardware NVIDIA Jetson. Per ulteriori dettagli, consulta la sezione Risultati dei benchmark.