Integrazione con Labelbox#
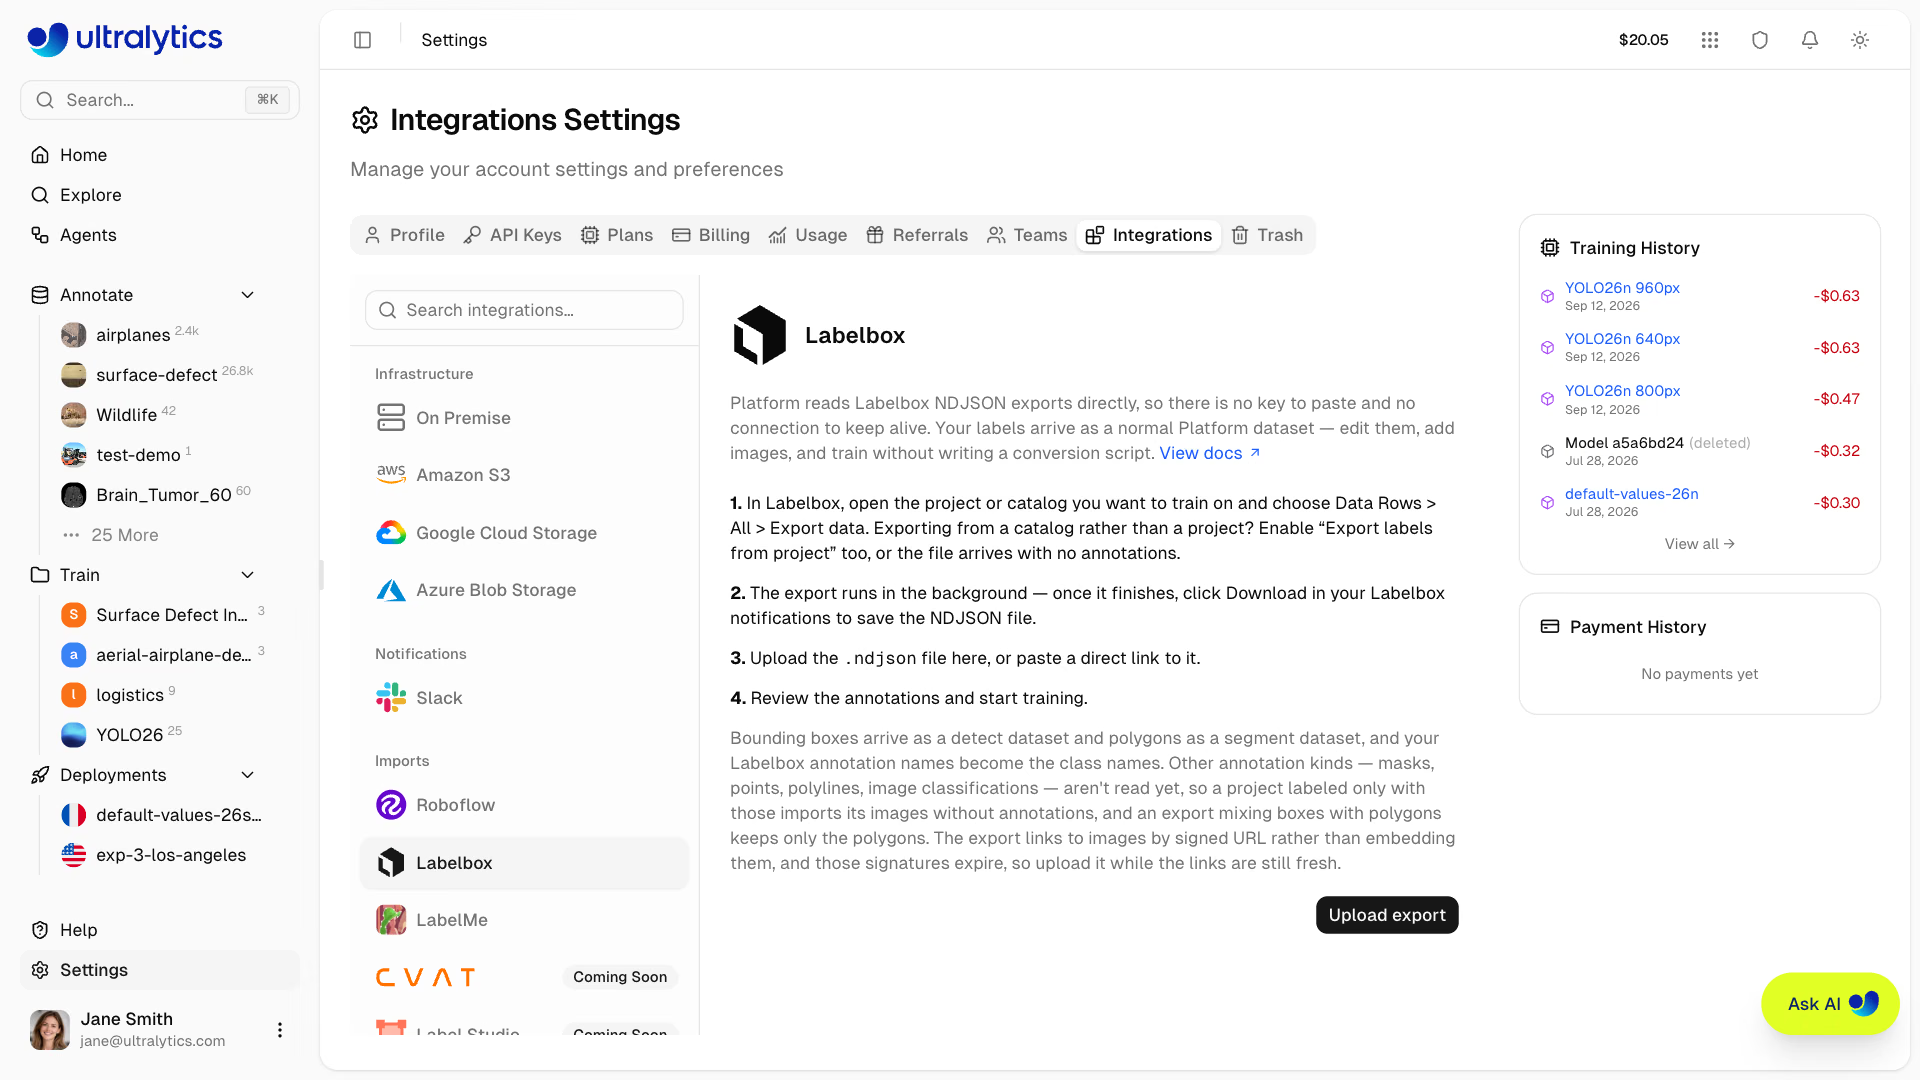
Ultralytics Platform legge direttamente le esportazioni NDJSON di Labelbox. Non devi incollare alcuna chiave, mantenere attiva una connessione o gestire uno script di conversione: esporta da Labelbox, carica il file e le tue etichette verranno importate come un normale dataset Platform.
Importa da Labelbox#
- Esporta da Labelbox. Per un progetto di etichettatura, apri la scheda Righe di dati, seleziona Tutte, fai clic su Esporta dati, scegli i campi da includere e conferma. Da Catalogo, seleziona le righe di dati e scegli Gestisci selezione > Esporta dati, quindi attiva Esporta etichette dal progetto e seleziona il progetto; altrimenti il file non conterrà alcuna annotazione.
- Scarica il file. Labelbox esegue l'esportazione come attività in background. Controlla le Notifiche e, al termine, fai clic su Scarica per salvare il file
.ndjson. - Carica su Platform. Crea un nuovo dataset e carica il file
.ndjsonoppure incolla un collegamento diretto al file. Puoi anche iniziare da Impostazioni > Integrazioni > Labelbox. - Addestra. Al termine dell'elaborazione, modifica le annotazioni e avvia l'addestramento come faresti con qualsiasi altro dataset Platform.
A differenza di CVAT e Label Studio, non devi scegliere un formato: è supportata l'esportazione nativa di Labelbox.
Esporta con l'SDK#
Labelbox offre anche l'attività di esportazione nel suo SDK Python, un'opzione più semplice per una pipeline ripetibile. Trasmetti l'attività in streaming e scrivi un oggetto JSON per riga:
import json

import labelbox

client = labelbox.Client(api_key="YOUR_LABELBOX_API_KEY")
export_task = labelbox.ExportTask.get_task(client, "YOUR_EXPORT_TASK_ID")
export_task.wait_till_done()  # lo streaming di un'attività che non è COMPLETE genera

with open("dataset.ndjson", "w") as f:
f.writelines(json.dumps(data_row.json) + "\n" for data_row in export_task.get_buffered_stream())NDJSON contiene un oggetto JSON per riga. json.dump(list_of_rows, f) scrive invece un singolo array e Platform ignora tutte le righe che non sono oggetti JSON: l'importazione non trova alcuna riga di dati. Usa il ciclo qui sopra oppure "\n".join(json.dumps(r) for r in rows).
Cosa viene importato#
Platform riconosce automaticamente il formato Labelbox e associa i riquadri e i poligoni al tipo di attività YOLO corrispondente:
| Annotazione Labelbox | Importata |
|---|---|
| Riquadro | Rilevamento |
| Poligono | Segmentazione |
| Maschera di segmentazione, punto, polilinea, relazione, classificazione | Non ancora |
Il valore name di ogni oggetto diventa il nome della classe: un'annotazione "name": "Dog" viene quindi importata come classe Dog, non come value in minuscolo; le coordinate in pixel vengono normalizzate rispetto alle dimensioni media_attributes nell'esportazione, quindi mantieni gli attributi multimediali nell'esportazione: le righe senza larghezza e altezza importano l'immagine senza annotazioni. Solo gli oggetti che Platform può importare registrano una classe, quindi gli strumenti per maschere, punti e polilinee non aggiungono classi vuote al dataset. Ogni immagine prende il nome da data_row.external_id, poi da global_key e, se l'esportazione non contiene nessuno dei due, dal nome del file nell'URL firmato. Vengono importate le righe di dati immagine; quelle relative a video, testo e altri dati non immagine vengono ignorate. Un'esportazione di Catalogo priva di annotazioni viene importata come dataset di immagini non etichettate, pronto per l'etichettatura nell'editor di annotazioni di Platform.
Una singola riga di dati ha questo aspetto, ridotta ai campi letti da Platform:
{
    "data_row": {
        "external_id": "000000000307.jpg",
        "global_key": "000000000307.jpg",
        "row_data": "https://storage.labelbox.com/...?Expires=...&Signature=..."
    },
    "media_attributes": { "height": 480, "width": 640, "mime_type": "image/jpeg" },
    "projects": {
        "<project-id>": {
            "labels": [
                {
                    "annotations": {
                        "objects": [
                            {
                                "name": "Dog",
                                "annotation_kind": "ImageBoundingBox",
                                "bounding_box": { "top": 200.0, "left": 407.0, "height": 172.0, "width": 176.0 }
                            }
                        ]
                    }
                }
            ]
        }
    }
}
Tutto il resto dell'esportazione — embeddings, metadata_fields, attachments, project_details — viene ignorato. Conviene deselezionare gli embedding durante l'esportazione: in un'esportazione di esempio occupavano circa quattro quinti del file, contro un quinto per i campi effettivamente letti da Platform.
Al momento vengono letti solo i riquadri e i poligoni, e solo se appartengono a un'annotazione di oggetto; le classificazioni a livello di immagine si trovano altrove nell'esportazione e vengono ignorate. Se un progetto è etichettato interamente con lo strumento maschera di segmentazione (pennello), punti, polilinee o classificazioni, le immagini vengono importate senza annotazioni e non viene generato alcun errore. Puoi verificarlo nella pagina del dataset: un dataset importato che ha mantenuto le etichette mostra il conteggio delle immagini etichettate e delle annotazioni accanto al conteggio delle immagini; se le ha perse, non mostra nessuno dei due.
Un'esportazione Labelbox fa riferimento a ogni immagine tramite un URL firmato, invece di incorporarne i pixel, e le firme scadono. Platform scarica le immagini da questi URL e verifica un campione prima di iniziare, quindi un'esportazione con tutti i collegamenti scaduti non va a buon fine e ti spiega il motivo: esporta di nuovo da Labelbox e carica il nuovo file. Se solo alcuni collegamenti sono scaduti, vengono importate le immagini ancora accessibili e le altre vengono ignorate; carica quindi il file poco dopo averlo esportato.
Un'esportazione che contiene sia riquadri sia poligoni viene importata come dataset di segmentazione, che include solo la geometria dei poligoni: le annotazioni dei riquadri non vengono usate per l'addestramento né incluse nelle esportazioni delle versioni. Se ti servono entrambi, esporta riquadri e poligoni come progetti Labelbox separati. Per essere letti, i poligoni devono inoltre avere almeno tre punti.
Domande frequenti#
Platform legge NDJSON, con un oggetto JSON per riga. Un'esportazione salvata come singolo array JSON viene ignorata interamente. Usa il ciclo dell'SDK qui sopra oppure il download Esporta dati di Labelbox, che è già in formato NDJSON.
Le esportazioni Labelbox fanno riferimento alle immagini tramite URL firmati, le cui firme scadono. Esporta di nuovo da Labelbox e carica il nuovo file appena termina l'esportazione.
No. Un'esportazione mista viene importata come dataset di segmentazione e vengono usati solo i poligoni. Se ti servono entrambi, esporta riquadri e poligoni come progetti Labelbox separati.