CIFAR-100データセット
CIFAR-100(カナダ高等研究所)データセットは、100の細分類クラス(各600枚)に均等に分けられ、それらがさらに20の上位クラスにまとめられた、32x32ピクセルのカラー画像60,000枚からなる画像分類ベンチマークです。Alex Krizhevsky氏が作成したこのデータセットには、トレーニング画像50,000枚とテスト画像10,000枚の分割があらかじめ定義されています。CIFAR-10データセットよりも難易度が高く、細かな分類に適した姉妹データセットです。
Ultralytics PlatformのCIFAR-100では、サンプルのプレビュー、データセット統計の確認、トレーニング用のクローン作成ができます。
視聴: Ultralytics YOLOでCIFAR-100を使用して画像分類モデルをトレーニングする方法
主な機能#
- CIFAR-100には、32x32ピクセルのカラー画像が60,000枚含まれており、100クラスに均等に分けられています。
- 各クラスには画像が正確に600枚含まれ、トレーニング用が500枚、テスト用が100枚です。そのため、データセットは完全にバランスが取れています。
- 100の細分類クラスは、より高レベルの分類に対応するため、20の上位クラスにまとめられています。
- データセットにはトレーニング/テストの分割があらかじめ定義されているため、手動または自動で分割する必要はありません。
- CIFAR-100は、細粒度画像分類および物体認識の研究における標準的なベンチマークです。
データセットの構成#
CIFAR-100には公式の分割があらかじめ定義されているため、自動または手動で分割する必要はありません。
- クラス数: 100の細分類クラスを20の上位クラスに分類
- 画像の合計数: 60,000枚(32x32ピクセルのカラー画像)
- トレーニングセット: 50,000枚(各クラス500枚)
- テストセット: 10,000枚(各クラス100枚)
CIFAR-100には独立した検証用フォルダーがないため、Ultralyticsはデフォルトで、トレーニング中に10,000枚のテストセットを検証用データとして使用します。data="cifar100"でトレーニングすると、100の細分類クラスを学習します。
用途#
CIFAR-100は、従来の畳み込みニューラルネットワーク (CNNs)やサポートベクターマシン (SVMs)から最新のディープアーキテクチャまで、画像分類モデルのトレーニングと評価に広く使用されています。100の細粒度クラスと小さな画像サイズを備えており、機械学習研究、アルゴリズムの比較、コンピュータービジョンの実験において、難易度の高いベンチマークとなります。
使用方法#
画像サイズ32でCIFAR-100を使用し、100エポックにわたってYOLO26n-clsモデルをトレーニングします。
from ultralytics import YOLO

# モデルを読み込む
model = YOLO("yolo26n-cls.pt")  # 事前トレーニング済みモデルを読み込みます(トレーニングにはこちらを推奨します)

# モデルをトレーニングする
results = model.train(data="cifar100", epochs=100, imgsz=32)サンプル画像とアノテーション#
CIFAR-100データセットのサンプル画像:
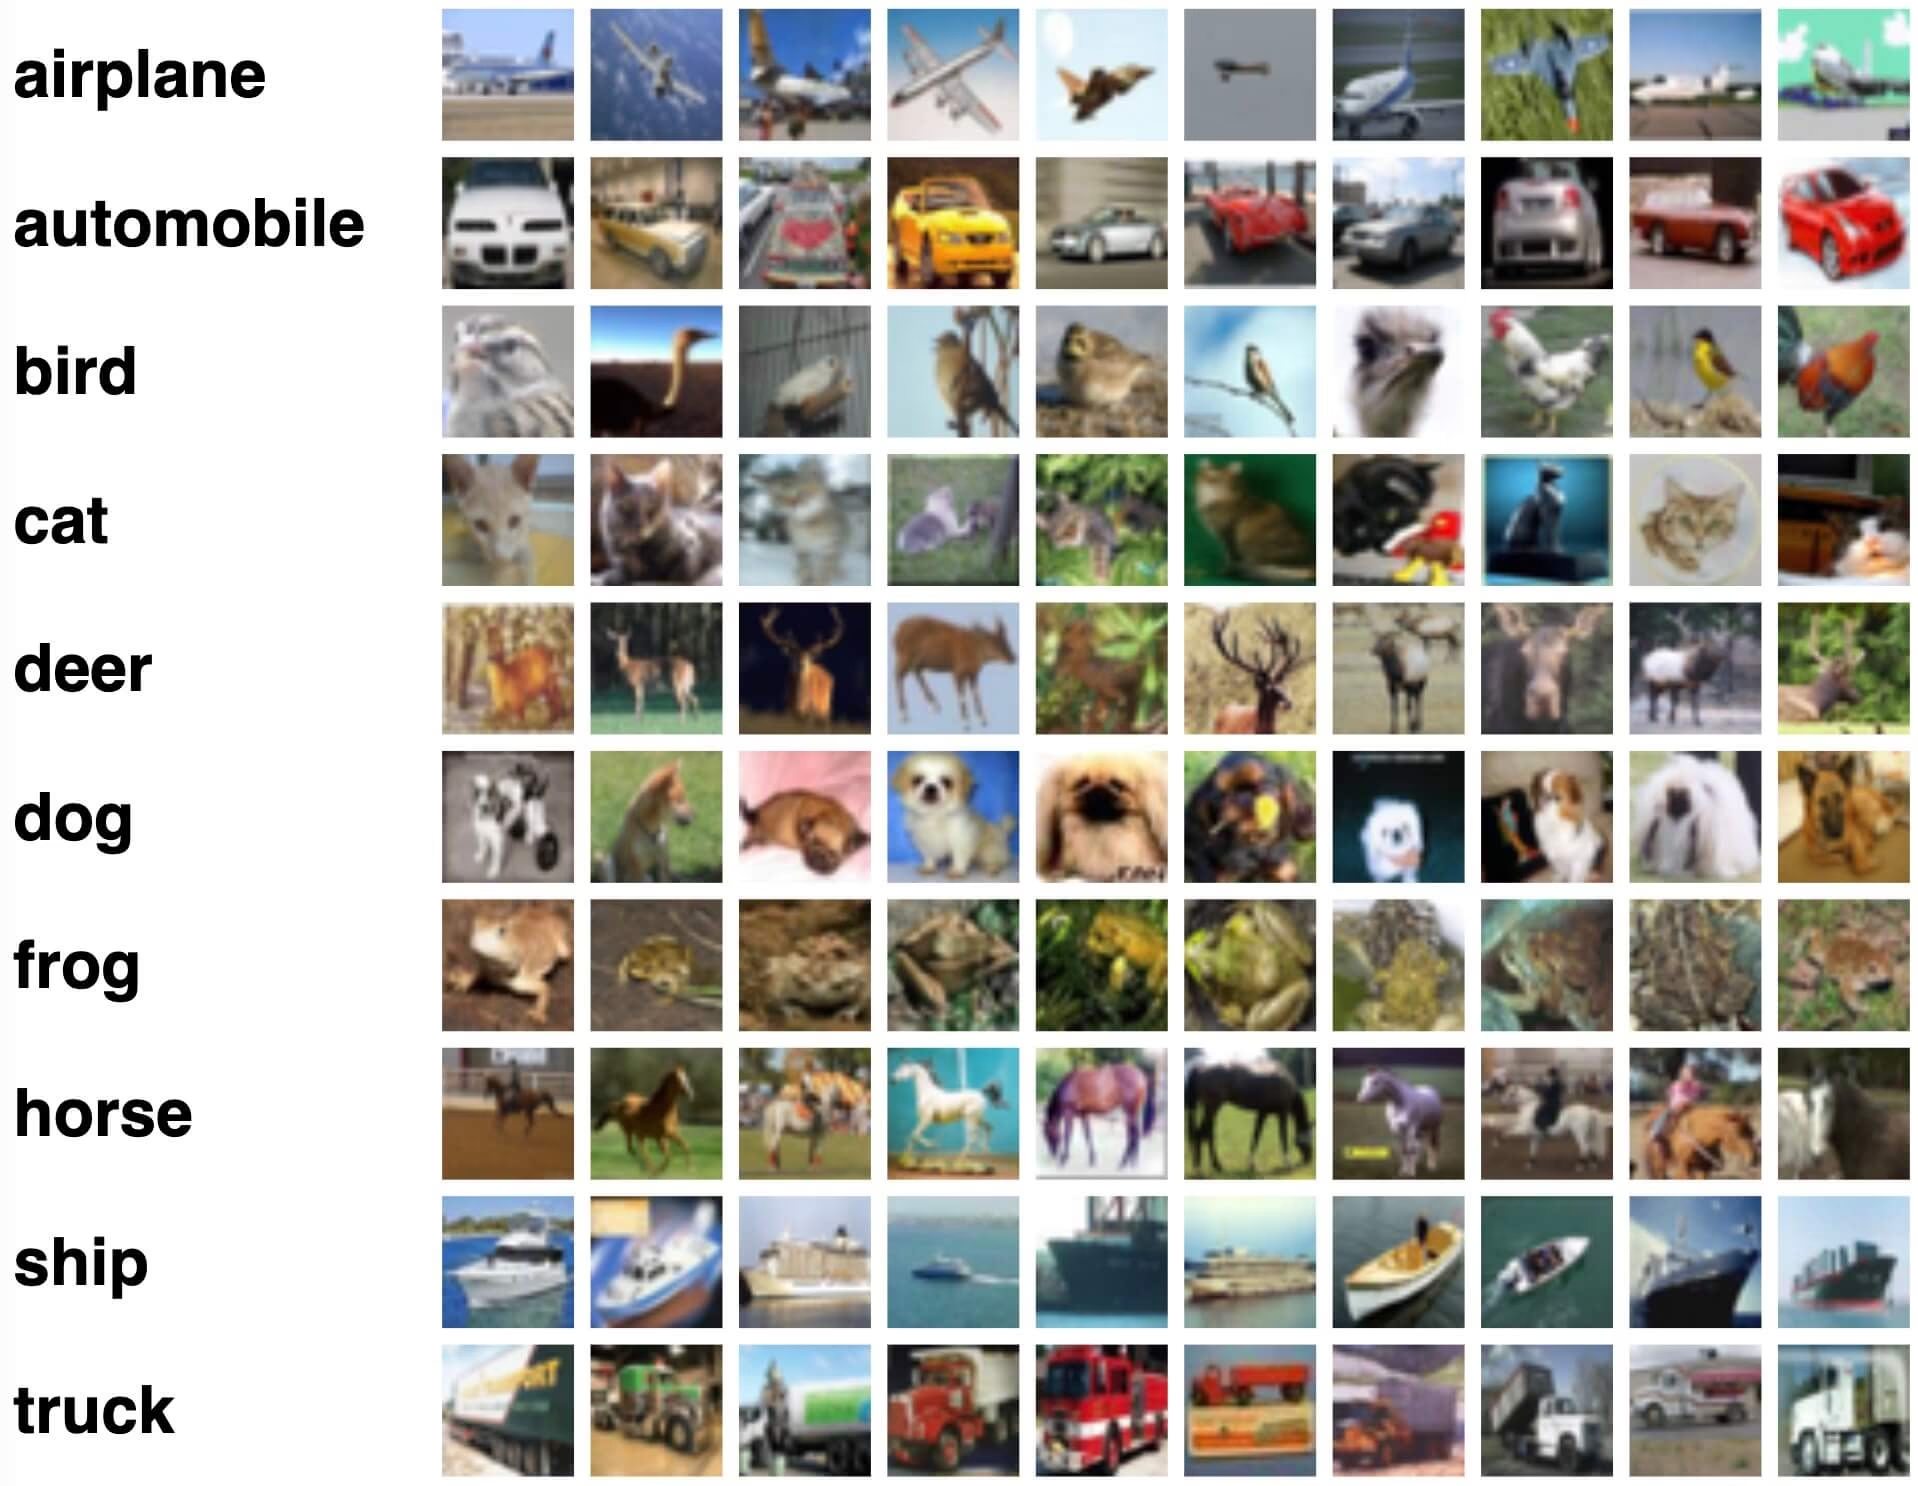
サンプルはCIFAR-100データセットに含まれるオブジェクトの多様性を示しており、堅牢な画像分類モデルのトレーニングに多様なデータセットが重要であることを裏付けています。
引用と謝辞#
研究または開発でCIFAR-100データセットを使用する場合は、以下の論文を引用してください。
@TECHREPORT{Krizhevsky09learningmultiple,
            author={Alex Krizhevsky},
            title={Learning multiple layers of features from tiny images},
            institution={},
            year={2009}
}
機械学習およびコンピュータービジョン研究コミュニティにとって貴重なリソースであるCIFAR-100データセットを作成・維持してくださったAlex Krizhevskyに感謝します。
よくある質問#
CIFAR-100データセットは、細粒度の画像分類モデルや物体認識モデルのトレーニングおよびベンチマークに広く使用されています。20の上位クラスにグループ化された100クラスにわたる、32x32のカラー画像が60,000枚含まれています。畳み込みニューラルネットワーク (CNNs)やサポートベクターマシン (SVMs)などのアルゴリズムに対して、CIFAR-10よりも難易度の高いベンチマークとなり、Ultralytics YOLOで構築されたディープラーニングモデルの評価にも利用できます。
CIFAR-100でUltralytics YOLOモデルをトレーニングするには、以下のコードスニペットを使用します。初回使用時にデータセットが自動的にダウンロードされます。引数の一覧については、モデルのトレーニングページをご覧ください。
トレーニング例from ultralytics import YOLO # モデルを読み込む model = YOLO("yolo26n-cls.pt") # 事前トレーニング済みモデルを読み込みます(トレーニングにはこちらを推奨します) # モデルをトレーニングする results = model.train(data="cifar100", epochs=100, imgsz=32)CIFAR-100には、リンゴ、イルカ、カエデ、オートバイ、ロケットなどの細粒度クラスが100個あり、各クラスに画像がちょうど600枚、合計60,000枚含まれています。これらの100クラスは、さらに20の粗粒度の上位クラスに分類されます(たとえば、樹木の上位クラスにはカエデ、オーク、ヤシ、マツ、ヤナギが含まれます)。
data="cifar100"を使ったトレーニングでは、100の細粒度クラスが使用されます。CIFAR-100には、トレーニング画像50,000枚とテスト画像10,000枚の事前定義済み分割が含まれ、各クラスにトレーニング画像500枚、テスト画像100枚が割り当てられています。Ultralyticsが自動分割するフォルダベースの分類データセットとは異なり、CIFAR-100では公式の分割をそのまま使用し、デフォルトではトレーニング中にテストセットを検証用分割として使用します。
はい。Ultralytics Platformでは、データセットの管理、画像分類モデルのトレーニング、モデルのデプロイを、複雑なコーディングなしで行えます。CIFAR-100の実験をクラウドで実行するのに便利です。また、分類データセットの概要で、ほかの選択肢もご確認いただけます。


コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。