コンピュータービジョンプロジェクトの主な手順を理解する#
コンピュータービジョンプロジェクトの構築では、目標の定義、データの収集とアノテーション、モデルのトレーニングと評価、本番環境へのデプロイと保守という明確な段階を順に進めます。このガイドでは、各手順を順に説明し、その重要性を解説します。これにより、自信を持ってプロジェクトを計画し、実行できるようになります。
コンピュータービジョンは、コンピューターが人間のように世界を見て理解するための人工知能(AI)の一分野です。画像や動画を処理・分析し、情報の抽出、パターンの認識、データに基づく意思決定を行います。
視聴する: コンピュータービジョンプロジェクトの進め方 | ステップごとのガイド
物体検出、画像分類、インスタンスセグメンテーションなどのコンピュータービジョン技術は、自動運転から医用画像まで、さまざまな業界で貴重な知見を得るために活用できます。
コンピュータービジョンプロジェクトの概要#
コンピュータービジョンプロジェクトの各手順の詳細を説明する前に、まず全体の流れを見てみましょう。今日コンピュータービジョンプロジェクトを始めるとしたら、次の手順を踏みます。
- 最初に、プロジェクトの要件を理解します。
- 次に、モデルのトレーニングに役立つ画像を収集し、正確にラベル付けします。
- 続いて、モデルのトレーニングに備えてデータをクリーニングし、拡張します。
- トレーニング後、さまざまな条件下でも一貫した性能を発揮することを確認するため、モデルを十分に評価し、テストします。
- 最後に、モデルを現実の環境にデプロイし、新たな知見やフィードバックに基づいて監視・保守します。
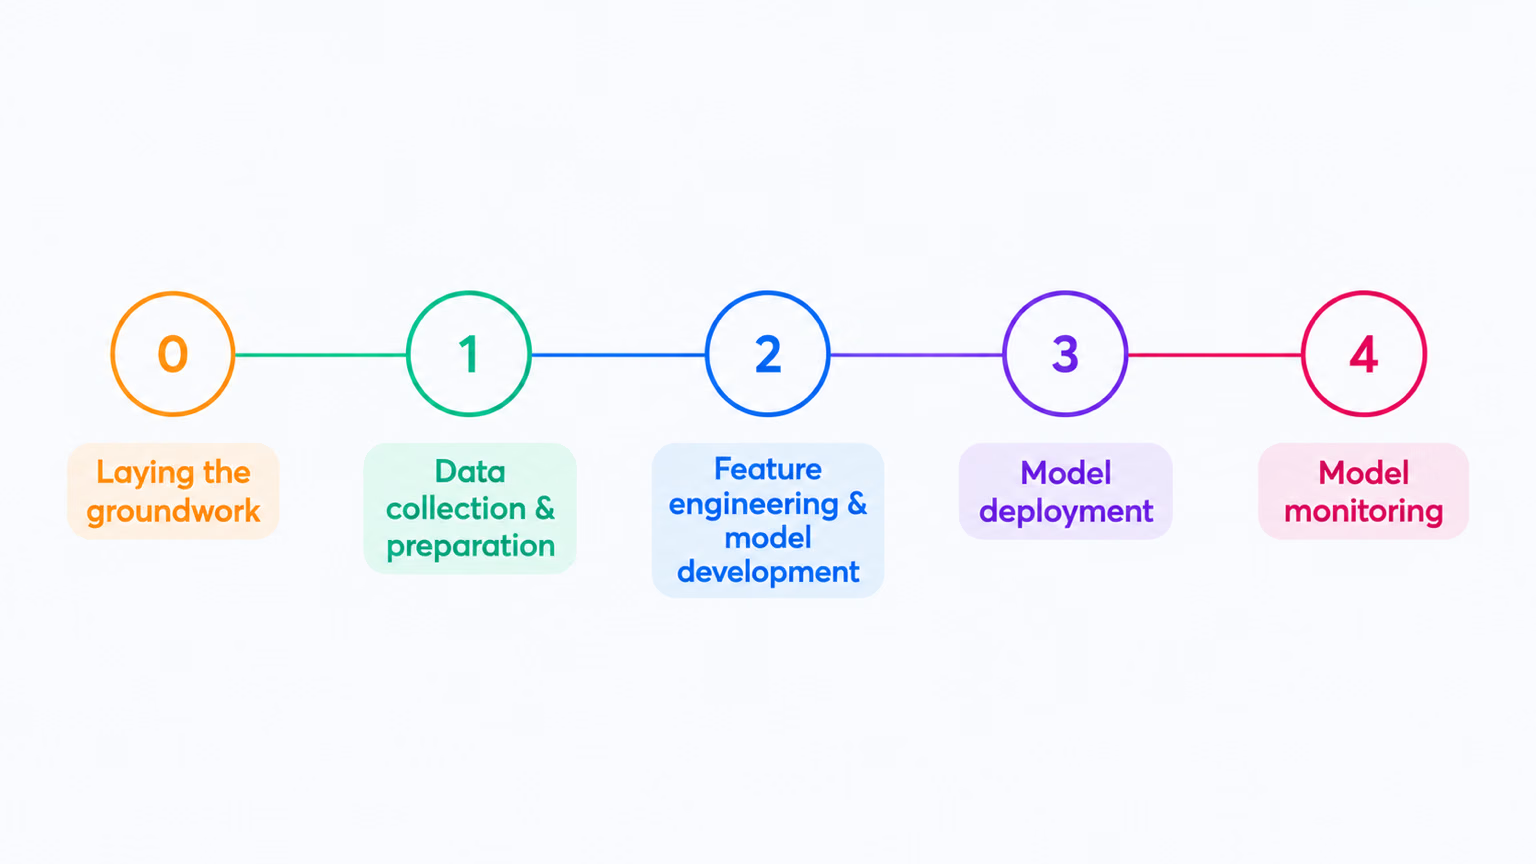
全体像を把握できたところで、以下のセクションでは各ステップを詳しく説明します。
ステップ1:プロジェクトの目標を定義する#
あらゆるコンピュータービジョンプロジェクトの最初のステップは、解決したい課題を明確に定義することです。最終目標を把握すると、ソリューションの構築を始めやすくなります。プロジェクトの目的が、注力すべきコンピュータービジョンタスクに直接影響するため、これは特に重要です。
プロジェクトの目標と、その達成に活用できるコンピュータービジョンタスクの例をいくつか紹介します。
-
目標: 高速道路を走行するさまざまな種類の車両の流れを監視・管理し、交通管理と安全性を向上させるシステムを開発します。
- コンピュータービジョンタスク: 物体検出は、複数の車両の位置を効率的に特定し、識別できるため、交通監視に最適です。このタスクでは不要な詳細まで提供する画像セグメンテーションより計算負荷が低く、高速なリアルタイム分析が可能です。
-
目標: 医用画像スキャンで腫瘍の輪郭をピクセル単位で正確に示し、放射線科医を支援するツールを開発します。
- コンピュータービジョンタスク: 画像セグメンテーションは、腫瘍のサイズ、形状、治療計画の評価に不可欠な、正確で詳細な腫瘍の境界を提供するため、医療画像に適しています。
-
目的: さまざまな書類(請求書、領収書、法的書類など)を分類するデジタルシステムを構築し、組織の業務効率と書類検索を改善します。
- コンピュータービジョンタスク: 画像分類は、画像内での書類の位置を考慮する必要がなく、一度に1つの書類を処理するため、この用途に最適です。この方法により、仕分けのプロセスを簡素化し、迅速化できます。
適切なモデルとトレーニング方法の選択#
プロジェクトの目的と適切なコンピュータービジョンタスクを理解したら、プロジェクトの目標を定義するうえで重要なのが、適切なモデルとトレーニング方法を選択することです。
目的に応じて、モデルを先に選択することも、ステップ2で収集できるデータを確認してから選択することもできます。たとえば、プロジェクトが特定の種類のデータの入手可能性に大きく左右される場合は、モデルを選ぶ前にデータを収集して分析するほうが実用的です。一方、モデルの要件が明確であれば、先にモデルを選択してから、その仕様に合ったデータを収集できます。
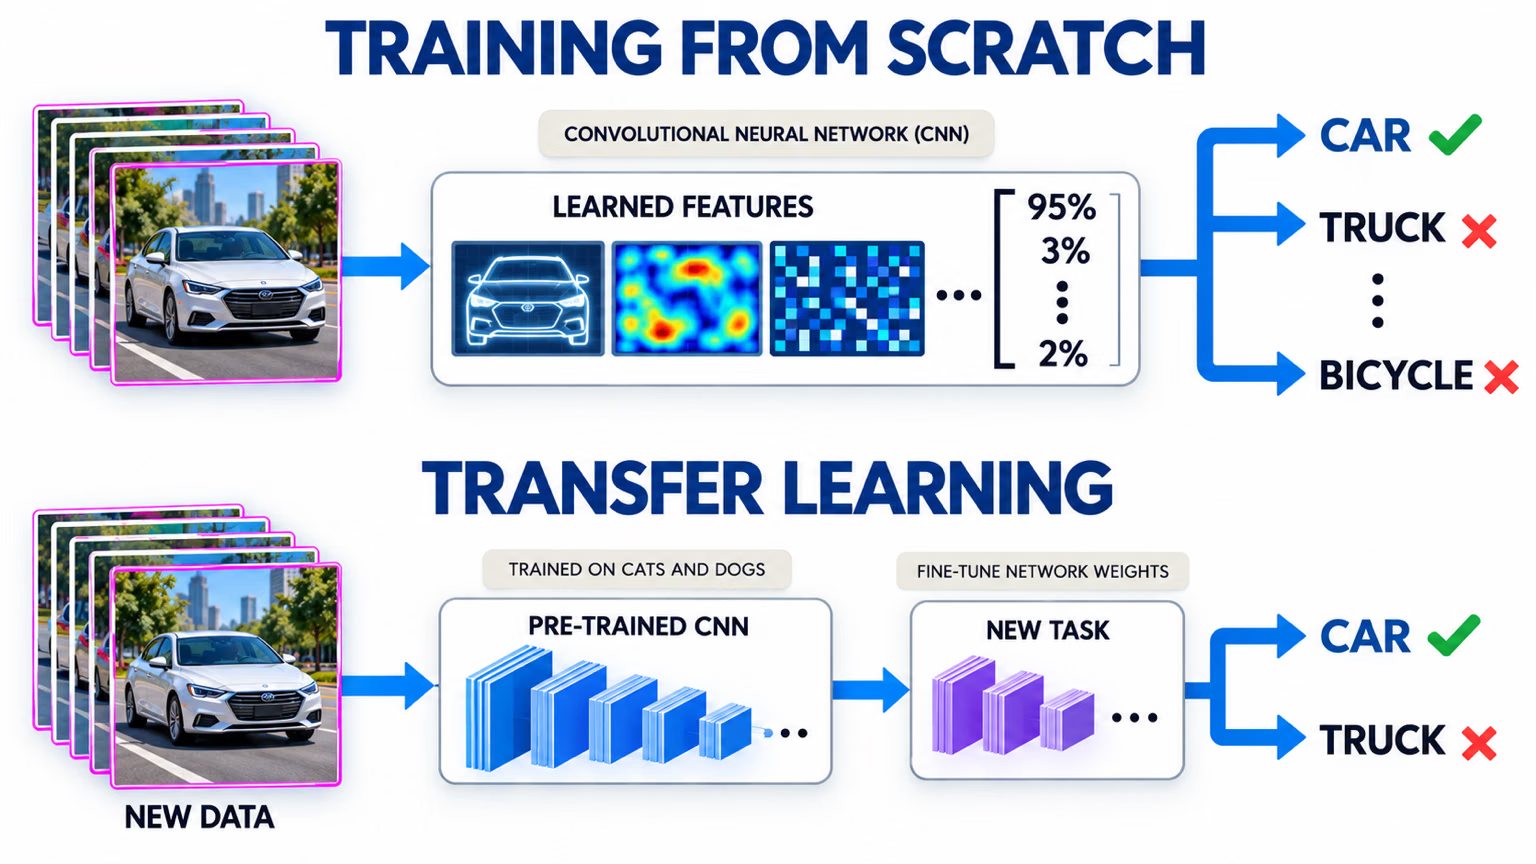
スクラッチからトレーニングするか、転移学習を利用するかによって、データの準備方法が変わります。スクラッチからトレーニングするには、モデルが基礎から知識を構築できるよう、多様なデータセットが必要です。一方、転移学習では、事前学習済みモデルを利用し、より小規模で特定の用途に特化したデータセットで適応させることができます。また、特定のモデルを選択してトレーニングすると、そのモデル固有の要件に応じて、画像のリサイズやアノテーションの追加など、データの準備方法が決まります。
互換性とパフォーマンスを確保するために、モデルのデプロイ先を考慮してください。たとえば、軽量モデルはリソースに制約のあるデバイスでも効率的に動作するため、エッジコンピューティングに最適です。
詳しくは、プロジェクトの目標を定義し、適切なモデルを選択する方法に関するガイドをご覧ください。
コンピュータービジョンプロジェクトの実作業に取りかかる前に、これらの詳細を明確に理解しておくことが重要です。ステップ2に進む前に、次の項目を検討したかどうか確認してください。
- 解決しようとしている問題を明確に定義します。
- プロジェクトの最終目標を決定します。
- 必要なコンピュータービジョンタスク(物体検出、画像分類、画像セグメンテーションなど)を特定します。
- モデルをスクラッチからトレーニングするか、転移学習を利用するかを決定します。
- タスクとデプロイのニーズに適したモデルを選択します。
ステップ2: データ収集とデータアノテーション#
コンピュータービジョンモデルの品質は、データセットの品質に左右されます。インターネットから画像を収集する、自分で撮影する、既存のデータセットを使うなどの方法があります。公開データセットの有用な情報源として、Google Dataset Search Engine、UC Irvine Machine Learning Repository、Kaggle Datasetsがあります。
Ultralyticsなどのライブラリには、さまざまなデータセットの組み込みサポートがあり、高品質なデータを使って簡単に作業を始められます。これらのライブラリには、人気のあるデータセットをダウンロードして読み込むユーティリティが含まれていることが多く、プロジェクトの初期段階にかかる時間と労力を大幅に節約できます。
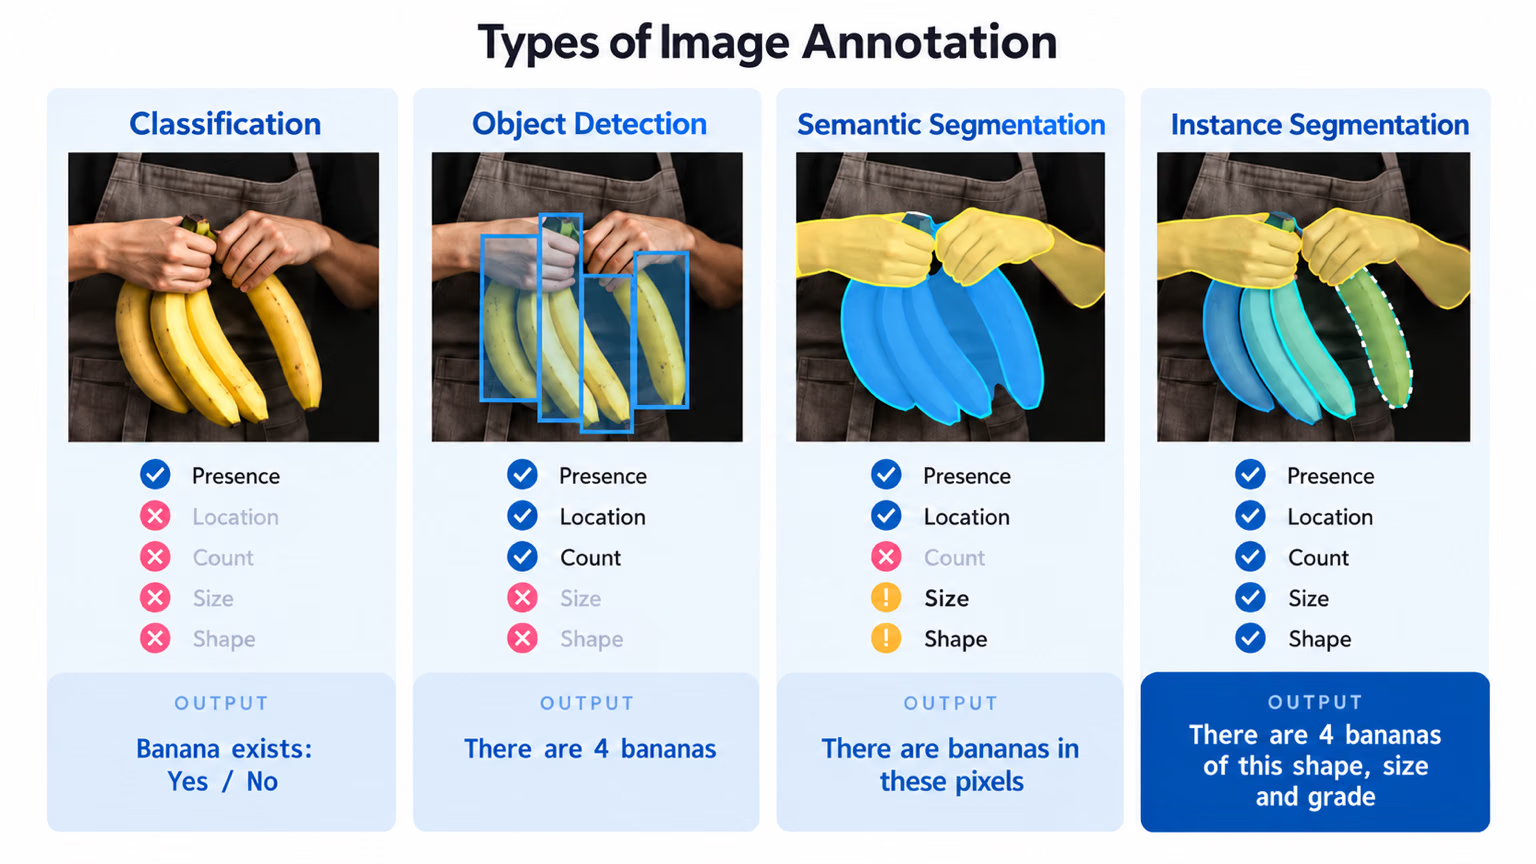
ただし、画像を収集する、または自分で写真を撮る場合は、データにアノテーションを付ける必要があります。データアノテーションとは、モデルに知識を与えるためにデータにラベルを付けるプロセスです。使用するデータアノテーションの種類は、具体的なコンピュータービジョン手法によって異なります。例をいくつか紹介します。
- 画像分類: 画像全体に単一のクラスラベルを付けます。
- 物体検出: 画像内の各物体を囲むバウンディングボックスを描画し、それぞれのボックスにラベルを付けます。
- 画像セグメンテーション: 画像内の各ピクセルに、そのピクセルが属する物体に応じたラベルを付け、物体の境界を詳細に作成します。
データ収集とアノテーションは、時間のかかる手作業になることがあります。専用のアノテーションツールを使えば、作業を迅速化できます。Ultralytics Platformには、検出、セグメンテーション、OBBデータに対応したSAMを活用したスマートアノテーション機能を備えたアノテーションエディターが組み込まれており、ラベルをYOLO形式で直接保存できます。
ステップ3: データ拡張とデータセットの分割#
画像データの収集とアノテーションが完了したら、データ拡張を行う前に、データセットをトレーニング、検証、テスト用に分割することが重要です。データ拡張の前にデータセットを分割することで、変更を加えていない元のデータを使ってモデルをテストおよび検証できます。これにより、モデルが未知の新しいデータにどの程度汎化するかを正確に評価できます。
データの分割方法は次のとおりです。
- トレーニングセット: データのうち最も大きな部分で、通常は全体の70~80%を占め、モデルのトレーニングに使用します。
- 検証セット: 通常はデータの約10~15%を占めます。トレーニング中のハイパーパラメーター調整とモデルの検証に使用し、過学習の防止に役立てます。
- テストセット: 残りの10~15%のデータをテストセットとして確保します。トレーニング完了後、未知のデータに対するモデルのパフォーマンスを評価するために使用します。
データを分割した後、画像の回転、スケーリング、反転などの変換を適用して、データセットのサイズを人為的に増やすデータ拡張を実施できます。データ拡張によって、モデルはさまざまな変化に対してより堅牢になり、未知の画像に対するパフォーマンスが向上します。
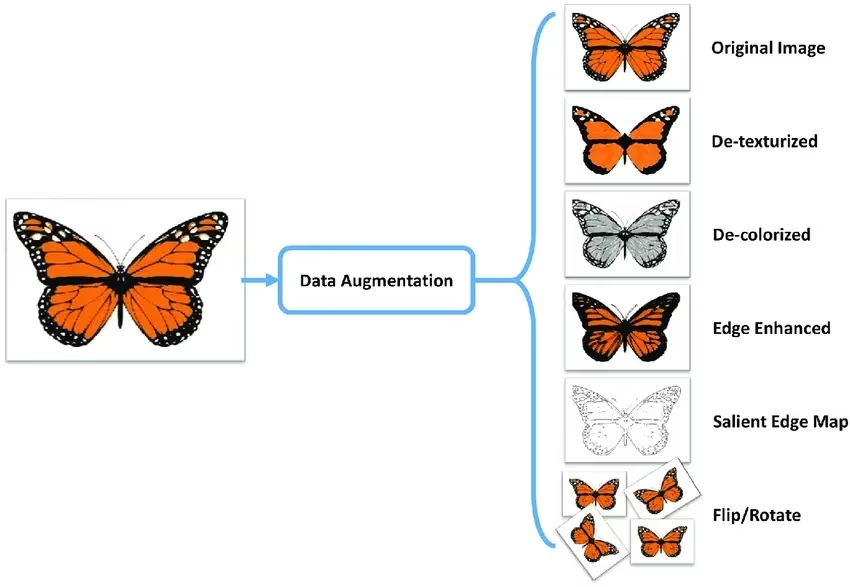
OpenCV、Albumentations、TensorFlowなどのライブラリには、柔軟に使えるデータ拡張関数が用意されています。また、Ultralyticsなど一部のライブラリでは、モデルのトレーニング関数にデータ拡張設定が組み込まれており、作業を簡素化できます。
データをより深く理解するには、MatplotlibやSeabornなどのツールを使って画像を可視化し、分布や特性を分析できます。データを可視化すると、パターンや異常、データ拡張手法の有効性を確認できます。Ultralytics PlatformのChartsタブでは、アップロードされた各データセットについて、分割の分布、クラス数、画像サイズのヒストグラム、アノテーション位置のヒートマップが自動生成されるため、コードを使わずにこうした分析結果を確認できます。
データを適切に理解、分割、拡張することで、実際のアプリケーションで優れた性能を発揮する、十分にトレーニング、検証、テストされたモデルを開発できます。
ステップ4: モデルのトレーニング#
データセットの準備が整ったら、必要な環境のセットアップ、データセットの管理、モデルのトレーニングに取り組みます。
まず、環境が正しく設定されていることを確認します。一般的には、次の作業が含まれます。
- TensorFlow、PyTorch、Ultralyticsなどの必須ライブラリやフレームワークをインストールします。
- GPUを使用する場合は、CUDAやcuDNNなどのライブラリをインストールすると、GPUアクセラレーションを有効にしてトレーニングを高速化できます。
次に、トレーニングデータセットと検証データセットを環境に読み込みます。リサイズ、形式変換、データ拡張を行って、データを正規化および前処理します。モデルを選択したら、レイヤーを設定し、ハイパーパラメーターを指定します。損失関数、オプティマイザー、パフォーマンス指標を設定してモデルをコンパイルします。
Ultralyticsなどのライブラリを使うと、トレーニングプロセスを簡素化できます。最小限のコードでデータをモデルに入力し、トレーニングを開始できます。これらのライブラリは、重みの調整、誤差逆伝播、検証を自動的に処理します。また、進捗を監視し、ハイパーパラメーターを簡単に調整するツールも用意されています。トレーニング後は、いくつかのコマンドでモデルと重みを保存できます。
効率的なトレーニングには、適切なデータセット管理が不可欠であることを覚えておいてください。データセットの変更を追跡し、再現性を確保するために、データセットにバージョン管理を使用します。DVC (Data Version Control)などのツールは、大規模なデータセットの管理に役立ちます。
ステップ5: モデルの評価とファインチューニング#
さまざまな指標を使ってモデルのパフォーマンスを評価し、精度を向上させるためにモデルを改善することが重要です。評価によって、モデルが優れている領域と改善が必要な領域を特定できます。ファインチューニングにより、最高のパフォーマンスが得られるようモデルを最適化できます。
- 性能指標: 精度、適合率、再現率、F1スコアなどの指標を使用して、モデルの性能を評価します。これらの指標から、モデルの予測性能を把握できます。
- ハイパーパラメーターの調整: モデルのパフォーマンスを最適化するために、ハイパーパラメーターを調整します。グリッドサーチやランダムサーチなどの手法を使うと、最適なハイパーパラメーター値を見つけやすくなります。
- ファインチューニング: モデルのパフォーマンスを高めるために、モデルアーキテクチャやトレーニングプロセスを少し調整します。学習率、バッチサイズ、その他のモデルパラメーターを微調整する場合があります。
モデルの評価とファインチューニング手法をさらに深く理解するには、モデル評価のインサイトガイドをご覧ください。
ステップ6: モデルのテスト#
モデルのテストでは、まったく未知のデータに対するモデルの性能を確認し、デプロイの準備が整っていることを検証します。モデルのテストとモデルの評価の違いは、テストではモデルを繰り返し改善するのではなく、最終モデルの性能を確認することに重点を置く点です。
発生する可能性のある一般的な問題を十分にテストし、デバッグすることが重要です。トレーニングや検証で使用していない、独立したテストデータセットでモデルをテストします。このデータセットは、モデルの性能が一貫していて信頼できることを確認できるよう、実際のシナリオを反映したものにしてください。
また、過学習、未学習、データリークなどの一般的な問題にも対処してください。こうした問題の特定には、交差検証などの手法を使用します。包括的なテスト戦略については、モデルテストガイドを参照してください。
ステップ7: モデルのデプロイ#
モデルのテストが十分に完了したら、デプロイに進みます。モデルデプロイとは、本番環境でモデルを利用できるようにすることです。コンピュータービジョンモデルのデプロイ手順は次のとおりです。
- 環境のセットアップ: クラウドベース(AWS、Google Cloud、Azure)またはエッジベース(ローカルデバイス、IoT)のいずれのデプロイ方法を選択する場合も、必要なインフラストラクチャを設定します。
- モデルのエクスポート: デプロイプラットフォームとの互換性を確保するため、適切な形式(YOLO26の場合はONNX、TensorRT、CoreMLなど)にモデルをエクスポートします。
- モデルのデプロイ: APIまたはエンドポイントを設定し、アプリケーションに統合してモデルをデプロイします。
- スケーラビリティの確保: リソースを管理し、増加するデータやユーザーリクエストに対応するために、ロードバランサー、自動スケーリンググループ、監視ツールを導入します。
Ultralytics Platformは、デフォルトでゼロまでスケールする、世界42地域のマネージドデプロイエンドポイントも提供しており、インフラストラクチャのセットアップを自動で処理します。
ステップ8: 監視、メンテナンス、ドキュメント作成#
モデルをデプロイしたら、パフォーマンスを継続的に監視し、問題に対処できるようメンテナンスし、今後の参照や改善に備えてプロセス全体を文書化することが重要です。
モニタリングツールを使うと、主要業績評価指標(KPI)を追跡し、異常や精度低下を検出できます。モデルをモニタリングすると、入力データの変化によって時間の経過とともに性能が低下するモデルドリフトを把握できます。精度と関連性を維持するため、更新されたデータで定期的にモデルを再トレーニングしてください。
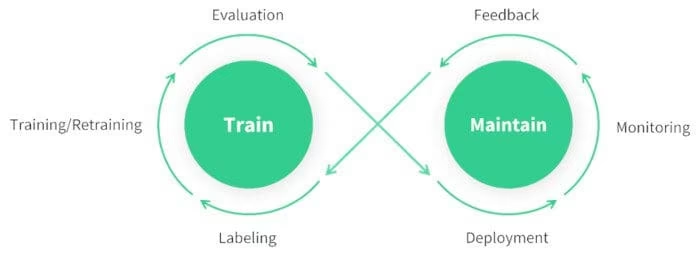
監視とメンテナンスに加えて、ドキュメント作成も重要です。モデルアーキテクチャ、トレーニング手順、ハイパーパラメーター、データの前処理手順、デプロイやメンテナンス中に行った変更など、プロセス全体を詳細に文書化します。適切なドキュメントがあれば、再現性を確保でき、今後の更新やトラブルシューティングも容易になります。モデルのライフサイクルを通じて、モデルが正確で信頼性が高く、管理しやすい状態を維持できるよう、モデルを効果的に監視、メンテナンス、文書化してください。
コミュニティへの参加#
コンピュータービジョン愛好家のコミュニティとつながることで、コンピュータービジョンプロジェクトに取り組む際に直面する問題に、自信を持って対処できます。学習、トラブルシューティング、ネットワーキングを効果的に行う方法をいくつか紹介します。
コミュニティのリソース#
- GitHub Issues: YOLO26 GitHubリポジトリを確認し、Issuesタブから質問、バグの報告、新機能の提案を行ってください。活発なコミュニティとメンテナーが、具体的な問題の解決を支援します。
- Ultralytics Discordサーバー: Ultralytics Discordサーバーに参加して、他のユーザーや開発者と交流し、サポートを受けたり、知見を共有したりできます。
これらのリソースを活用すると、課題を克服し、コンピュータービジョンコミュニティの最新動向やベストプラクティスを把握できます。
次のステップ#
目標の定義からデプロイ済みモデルの監視まで、コンピュータービジョンプロジェクトのあらゆる段階を網羅したロードマップが整いました。最初のYOLOモデルをトレーニングして実践するか、上記のガイドを使って各段階をさらに深く掘り下げてください。コードを書かずにパイプライン全体を実行するには、Ultralytics Platformをご覧ください。
よくある質問#
適切なコンピュータービジョンタスクは、プロジェクトの最終目標によって異なります。たとえば、交通状況を監視する場合、物体検出を使うと、複数の車両タイプをリアルタイムで特定し、位置を検出できます。医用画像では、画像セグメンテーションによって腫瘍の境界を詳細に示し、診断や治療計画に役立てられます。
データアノテーションは、モデルにパターンを認識させるために不可欠です。アノテーションの種類はタスクによって異なります。
- 画像分類: 画像全体に単一のクラスラベルを付けます。
- 物体検出: 物体を囲むバウンディングボックスを描画します。
- 画像セグメンテーション: 各ピクセルに、そのピクセルが属する物体に応じたラベルを付けます。
Ultralytics Platformに組み込まれたアノテーションエディターは、このプロセスを支援します。
データ拡張の前にデータセットを分割すると、変更を加えていない元のデータを使ってモデルのパフォーマンスを検証できます。次の手順に従ってください。
- トレーニングセット: データの70~80%。
- 検証セット: ハイパーパラメーター調整に使用するデータの10~15%。
- テストセット: 最終評価用に確保する残りの10~15%。
分割後、回転、スケーリング、反転などのデータ拡張手法を適用して、データセットの多様性を高めます。AlbumentationsやOpenCVなどのライブラリが役立ちます。Ultralyticsにも、利便性を高めるデータ拡張の設定が組み込まれています。
トレーニング済みモデルを
exportメソッドでエクスポートし、デプロイ先に合った形式を選択します。UltralyticsはONNX、TensorRT、CoreMLなど、複数の形式をサポートしています。YOLO26モデルをエクスポートするには、次の手順に従ってください。- 目的の形式パラメーターを指定して、
exportメソッドを使用します。 - エクスポートしたモデルが、デプロイ環境(エッジデバイス、クラウドなど)の仕様に適合していることを確認します。
詳細については、モデルのエクスポートガイドをご覧ください。
- 目的の形式パラメーターを指定して、
継続的な監視とメンテナンスは、モデルの長期的な成功に不可欠です。主要業績評価指標(KPI)を追跡し、異常を検出するツールを導入します。モデルドリフトに対処するため、更新されたデータを使ってモデルを定期的に再トレーニングします。再現性を確保し、今後の更新を容易にするために、モデルアーキテクチャ、ハイパーパラメーター、変更内容など、プロセス全体を文書化します。詳しくは、監視とメンテナンスのガイドをご覧ください。
コメント2
質問したり、結果を共有したり、ほかの人をサポートしたりできます。
VeeranjaneyuluToka
what is the best way of verifying if the chosen model is right fit for the given dataset or problem statement. Is it just based on evaluation metrics or can we use kind of approach to verify based on the feature maps or heat map visualization if the model is really learning the features that it needs to be learnt.
 Glenn JocherUltralytics
Great question! You're absolutely right that evaluation metrics alone don't tell the whole story. Here are several approaches to verify if your model is truly learning the right features:
Beyond Evaluation Metrics:
- Feature visualization and heat maps (like Grad-CAM, LIME) help you see what regions the model focuses on during predictions
- Activation maps show which features activate at different layers, revealing what the model has learned
- Confusion matrices reveal specific class prediction patterns and potential biases
Practical Verification Approaches:
- Test on edge cases and adversarial examples to understand model robustness
- Cross-validation across different data splits to ensure consistent performance
- Error analysis by examining misclassified samples to identify systematic issues
- Domain adaptation testing on slightly different datasets to check generalization
For YOLO11 specifically:
- Use validation visualizations during training to see bounding box predictions
- Monitor training curves for signs of overfitting or underfitting
- Test inference on diverse real-world scenarios beyond your test set
The key is combining quantitative metrics with qualitative analysis - if your model achieves high accuracy but the heat maps show it's focusing on irrelevant background features instead of the actual objects, that's a red flag even with good metrics.
Would you like specific guidance on implementing any of these visualization techniques with your current project?