Ultralytics YOLOによるインスタンスセグメンテーション#
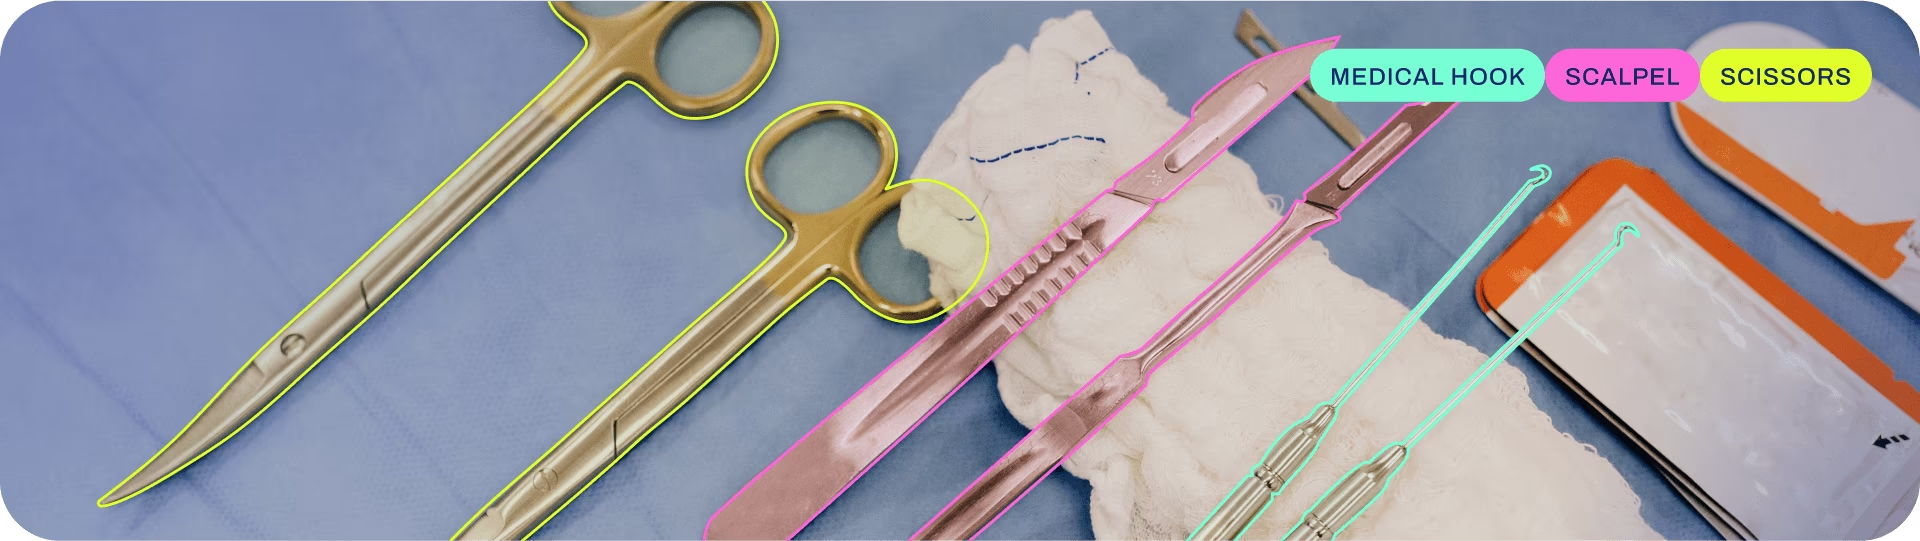
インスタンスセグメンテーションは物体検出をさらに発展させたもので、画像内の個々の物体を識別し、画像のほかの部分から分割します。
インスタンスセグメンテーションモデルの出力は、画像内の各物体の輪郭を示すマスクまたは輪郭線のセットと、各物体のクラスラベルおよび信頼度スコアです。インスタンスセグメンテーションは、画像内の物体の位置だけでなく、正確な形状も把握する必要がある場合に役立ちます。
視聴: Python で学習済み Ultralytics YOLO モデルを使ってセグメンテーションを実行する方法。
YOLO26 Segmentモデルは-segサフィックスを使用します。たとえば、yolo26n-seg.ptです。また、COCOで事前学習されています。
モデル#
COCOデータセットで事前学習されたYOLO26 Segmentモデルを以下に示します。
モデルは、初回使用時に最新のUltralytics リリースから自動的にダウンロードされます。
| モデル | サイズ (ピクセル) | mAPボックス 50-95(e2e) | mAPマスク 50-95(e2e) | 速度 CPU ONNX (ms) | 速度 T4 TensorRT10 (ms) | パラメーター (M) | FLOPs (B) |
|---|---|---|---|---|---|---|---|
| YOLO26n-seg | 640 | 39.6 | 33.9 | 53.3 ± 0.5 | 2.1 ± 0.0 | 2.7 | 9.3 |
| YOLO26s-seg | 640 | 47.3 | 40.0 | 118.4 ± 0.9 | 3.3 ± 0.0 | 10.4 | 34.5 |
| YOLO26m-seg | 640 | 52.5 | 44.1 | 328.2 ± 2.4 | 6.7 ± 0.1 | 23.6 | 121.7 |
| YOLO26l-seg | 640 | 54.4 | 45.5 | 387.0 ± 3.7 | 8.0 ± 0.1 | 28.0 | 140.1 |
| YOLO26x-seg | 640 | 56.5 | 47.0 | 787.0 ± 6.8 | 16.4 ± 0.1 | 62.8 | 314.0 |
- mAPvalの値は、COCO val2017データセットにおける単一モデル、単一スケールでのものです。
yolo segment val data=coco.yaml device=0 nms=Falseで再現できます。 - 速度は、COCO val画像に対してONNXをCPUで、TensorRT10をNVIDIA T4 GPUで使用した場合の平均値です。
yolo segment val data=coco.yaml batch=1 device=0|cpu nms=Falseで再現できます。 - ParamsとFLOPsの値は、Conv/BatchNormのfoldingと未使用の検出ブランチの削除を適用した後の、融合済みモデルの値です。事前学習済みチェックポイントにはトレーニング時のアーキテクチャ全体が保持されているため、より大きな値が表示される場合があります。
これらのチェックポイントは、COCOの80クラスをセグメント化します。再トレーニングせずにリスト外のカテゴリをセグメント化するには、クラスをテキストプロンプト、視覚的な例、または組み込み語彙として指定できるYOLOEをご覧ください。
予備的なCOCOのボックスおよびマスクの結果については、未リリースのYOLO27プレビューをご覧ください。
学習#
COCO8-segデータセットでYOLO26n-segを、画像サイズ640で100エポックトレーニングします。使用可能な引数の一覧は、Configurationページをご覧ください。
from ultralytics import YOLO

# モデルを読み込む
model = YOLO("yolo26n-seg.yaml")  # YAMLから新しいモデルを構築します
model = YOLO("yolo26n-seg.pt")  # 事前トレーニング済みモデルを読み込みます(トレーニングにはこちらを推奨します)
model = YOLO("yolo26n-seg.yaml").load("yolo26n-seg.pt")  # YAMLからモデルを構築し、重みを転送します

# モデルをトレーニングする
results = model.train(data="coco8-seg.yaml", epochs=100, imgsz=640)trainモードの詳細は、Trainページをご覧ください。セグメンテーションモデルは、Ultralytics Platformのクラウドトレーニングでもトレーニングできます。
データセットのフォーマット#
YOLOセグメンテーションデータセットの形式について詳しくは、Dataset Guideをご覧ください。既存のCOCO JSONデータセットをYOLO形式に変換するには、COCOからYOLOへのガイドで説明されているように、use_segments=Trueを指定して組み込みのconvert_coco関数を使用します。また、ポリゴンツールとSAMを活用したスマートアノテーションを備えたUltralytics Platformのアノテーションでセグメンテーションマスクを作成することもできます。
検証#
トレーニング済みYOLO26n-segモデルの精度を検証します。modelにはトレーニング時のdataと引数がモデル属性として保持されるため、引数は不要です。Trainの例にあるpath/to/best.ptは、COCO8-segで検証します。公式ウェイトには、お使いのマシンに存在しないトレーニングデータセットのパスが記録されているため、警告を出してタスクのデフォルトであるcoco8-seg.yamlにフォールバックします。別のデータセットで検証するには、dataを指定します。
from ultralytics import YOLO

# モデルを読み込む
model = YOLO("yolo26n-seg.pt")  # 公式モデルを読み込みます
model = YOLO("path/to/best.pt")  # カスタムモデルを読み込む

# モデルを検証します
metrics = model.val()  # データセットと設定が記憶されるため、引数は不要です
metrics.box.map  # map50-95(B)
metrics.box.map50  # map50(B)
metrics.box.map75  # map75(B)
metrics.box.maps  # 各カテゴリのmAP50-95(B)を含むリスト
metrics.box.image_metrics  # detの画像ごとのメトリクス辞書。precision、recall、F1、TP、FP、FNを含みます
metrics.seg.map  # map50-95(M)
metrics.seg.map50  # map50(M)
metrics.seg.map75  # map75(M)
metrics.seg.maps  # 各カテゴリのmAP50-95(M)を含むリスト
metrics.seg.image_metrics # segの画像ごとのメトリクス辞書。precision、recall、F1、TP、FP、FNを含みます推論#
トレーニング済みのYOLO26n-segモデルを使用して、画像の推論を実行します。
from ultralytics import YOLO

# モデルを読み込む
model = YOLO("yolo26n-seg.pt")  # 公式モデルを読み込みます
model = YOLO("path/to/best.pt")  # カスタムモデルを読み込む

# モデルで予測します
results = model("https://ultralytics.com/images/bus.jpg")  # 画像に対して予測します

# 結果にアクセスします
for result in results:
    xy = result.masks.xy  # ピクセル座標で表したマスクポリゴン
    xyn = result.masks.xyn  # 正規化されたマスクポリゴン
masks = result.masks.data # バイナリマスク、shape (N,H,W)、dtype torch.uint8Predictページでpredictモードの詳細をご確認ください。
結果の出力#
YOLOのインスタンスセグメンテーションは、画像ごとに1つのResultsオブジェクトを返します。各結果には物体単位の予測が格納され、検出された各インスタンスは独自のバイナリマスク、クラス、信頼度、ボックスを持ちます。
| 属性 | 種類 | 形状 | 説明 |
|---|---|---|---|
result.masks | Masks | (N) | インスタンスマスクです。 |
result.masks.data | torch.uint8 | (N,H,W) | バイナリマスクです。値は 0 または 1 です。 |
result.masks.xy | np.float32 | list[(P,2)] | ピクセルポリゴンです。 |
result.masks.xyn | np.float32 | list[(P,2)] | 正規化されたポリゴンです。 |
result.boxes | Boxes | (N) | インスタンスのボックス、クラス、信頼度です。 |
result.boxes.cls | torch.float32 | (N,) | クラスIDです。名前を取得するには int にキャストします。 |
すべてのタスクにおける、タスク固有のResultsフィールドについては、タスク別の予測結果セクションをご覧ください。
インスタンスセグメンテーションとセマンティックセグメンテーションの比較#
インスタンスセグメンテーションは物体単位のセグメンテーションです。2台の車は、2つのマスク、2つのボックス、2つの信頼度スコアになります。 セマンティックセグメンテーションはピクセル単位の分類です。同じ車は、1つの画像サイズのクラスマップ内で同じクラスIDを持つピクセルになり、物体ごとのボックス、信頼度、デフォルトのポリゴンリストはありません。セマンティックセグメンテーションのページにある項目ごとの比較をご覧ください。
エクスポート#
YOLO26n-segモデルをONNXやCoreMLなどの別の形式にエクスポートします。
from ultralytics import YOLO

# モデルを読み込む
model = YOLO("yolo26n-seg.pt")  # 公式モデルを読み込みます
model = YOLO("path/to/best.pt")  # カスタムモデルを読み込む

# モデルをエクスポートする
model.export(format="onnx")使用可能なYOLO26-segのエクスポート形式を以下の表に示します。format引数を使用すると、format='onnx'やformat='engine'など、任意の形式にエクスポートできます。エクスポート済みモデルで直接推論または検証することもできます(例: yolo predict model=yolo26n-seg.onnx)。エクスポートが完了すると、モデルの使用例が表示されます。
CoreMLは、静的形状の検出、インスタンスセグメンテーション、ポーズに対して、組み込みNMS(nms=True)をサポートしています。デフォルトのセグメンテーションエクスポート(nms=None)では、NMSをコンシューマー側で実行します。
| 形式 | format引数 | モデル | メタデータ | 引数 |
|---|---|---|---|---|
| PyTorch | - | yolo26n-seg.pt | ✅ | - |
| TorchScript | torchscript | yolo26n-seg.torchscript | ✅ | imgsz, quantize, dynamic, nms, batch, device |
| ONNX | onnx | yolo26n-seg.onnx | ✅ | imgsz, quantize, dynamic, simplify, opset, nms, batch, data, fraction, device |
| OpenVINO | openvino | yolo26n-seg_openvino_model/ | ✅ | imgsz, quantize, dynamic, nms, batch, data, fraction, device |
| TensorRT | engine | yolo26n-seg.engine | ✅ | imgsz, quantize, dynamic, simplify, opset, workspace, nms, batch, data, fraction, device |
| CoreML | coreml | yolo26n-seg.mlpackage | ✅ | imgsz, dynamic, quantize, nms, batch, device |
| Apple Core AI | coreai | yolo26n-seg.aimodel | ✅ | imgsz, batch, quantize |
| TF SavedModel | saved_model | yolo26n-seg_saved_model/ | ✅ | imgsz, quantize, opset, nms, batch, data, fraction, device |
| TF GraphDef | pb | yolo26n-seg.pb | ❌ | imgsz, opset, batch, device |
| TF Edge TPU | edgetpu | yolo26n-seg_edgetpu.tflite | ✅ | imgsz, quantize, opset, data, fraction, device |
| LiteRT | litert | yolo26n-seg.tflite | ✅ | imgsz, quantize, batch, data, fraction, device |
| PaddlePaddle | paddle | yolo26n-seg_paddle_model/ | ✅ | imgsz, batch, device |
| MNN | mnn | yolo26n-seg.mnn | ✅ | imgsz, batch, dynamic, quantize, simplify, opset, nms, device |
| NCNN | ncnn | yolo26n-seg_ncnn_model/ | ✅ | imgsz, quantize, batch, device |
| IMX500 | imx | yolo26n-seg_imx_model/ | ✅ | imgsz, quantize, data, fraction, nms, device |
| RKNN | rknn | yolo26n-seg_rknn_model/ | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| ExecuTorch | executorch | yolo26n-seg_executorch_model/ | ✅ | imgsz, batch, device |
| Axelera | axelera | yolo26n-seg_axelera_model/ | ✅ | imgsz, batch, quantize, data, fraction, device |
| DEEPX | deepx | yolo26n-seg_deepx_model/ | ✅ | imgsz, quantize, simplify, opset, data, optimize, device |
| Qualcomm QNN | qnn | yolo26n-seg_qnn.onnx | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| Hailo | hailo | yolo26n-seg_hailo_model/ | ✅ | imgsz, name, quantize, data, fraction, simplify, conf, iou, device |
| Huawei Ascend | ascend | yolo26n-seg_ascend_model/ | ✅ | imgsz, batch, name, quantize, opset, simplify, nms, device |
| AMD Xilinx | xilinx | yolo26n-seg_xilinx_model/ | ✅ | imgsz, name, quantize, data, fraction, opset, simplify, device |
nms=None は外部NMS向けにraw出力をデフォルトで使用します。利用可能なNMSフリーヘッドを選択するには、nms=Falseを設定してください。未対応のフォーマットでは、ネイティブの出力パスにフォールバックします。上記のnmsの項目は、nms=Trueを使用してNMSを埋め込めるフォーマットを示しています。
詳細なexport情報については、Exportページをご覧ください。
よくある質問#
カスタムデータセットでYOLO26セグメンテーションモデルをトレーニングするには、まずデータセットをYOLOセグメンテーション形式に準備する必要があります。組み込みの
convert_cocoユーティリティを使用して、COCO JSONデータセットを変換できます。データセットの準備ができたら、PythonまたはCLIコマンドを使用してモデルをトレーニングできます。例from ultralytics import YOLO # 事前学習済みYOLO26セグメントモデルを読み込みます model = YOLO("yolo26n-seg.pt") # モデルをトレーニングする results = model.train(data="path/to/your_dataset.yaml", epochs=100, imgsz=640)使用可能なその他の引数については、Configurationページをご覧ください。
物体検出は、物体を囲むバウンディングボックスを描画して、画像内の物体を識別し、位置を特定します。一方、インスタンスセグメンテーションはバウンディングボックスを特定するだけでなく、各物体の正確な形状も示します。YOLO26のインスタンスセグメンテーションモデルは、検出した各物体の輪郭を示すマスクまたは輪郭線を生成します。そのため、医用画像や自動運転など、物体の正確な形状の把握が重要なタスクに特に役立ちます。
Ultralytics YOLO26は、高い精度とリアルタイム性能で知られる最先端のモデルであり、インスタンスセグメンテーションのタスクに適しています。YOLO26 SegmentモデルはCOCOデータセットで事前学習されており、多様な物体に対して安定した性能を発揮します。さらに、YOLOはトレーニング、検証、推論、エクスポートの各機能をシームレスに統合してサポートするため、研究用途と産業用途の両方で高い汎用性を備えています。
事前学習済みYOLOセグメンテーションモデルの読み込みと検証は簡単です。PythonとCLIの両方を使った方法を以下に示します。
例from ultralytics import YOLO # 事前トレーニング済みモデルを読み込む model = YOLO("yolo26n-seg.pt") # モデルを検証します metrics = model.val() print("Mean Average Precision for boxes:", metrics.box.map) print("Mean Average Precision for masks:", metrics.seg.map)これらの手順により、モデル性能の評価に不可欠な平均適合率(mAP)などの検証メトリクスを取得できます。
YOLOセグメンテーションモデルは、PythonまたはCLIコマンドを使用して簡単にONNX形式へエクスポートできます。
例from ultralytics import YOLO # 事前トレーニング済みモデルを読み込む model = YOLO("yolo26n-seg.pt") # モデルをONNXフォーマットにエクスポート model.export(format="onnx")さまざまな形式へのエクスポートの詳細は、Exportページをご覧ください。