Conjunto de dados Caltech-101
O conjunto de dados Caltech-101 é um benchmark clássico de classificação de imagens, com 9.144 imagens distribuídas por 101 categorias de objetos, além de uma classe de fundo. Cada categoria contém cerca de 40 a 800 imagens de objetos do mundo real — animais, veículos, itens domésticos e pessoas —, o que faz dele um benchmark compacto, mas desafiador, para modelos de reconhecimento de objetos.
Explore o Caltech-101 na Plataforma Ultralytics para visualizar amostras, consultar as estatísticas do conjunto de dados e cloná-lo para treinamento.
Assista: Como treinar um modelo de classificação de imagens usando o conjunto de dados Caltech-101 com a plataforma Ultralytics
O Caltech-101 não inclui uma divisão predefinida entre treinamento e validação. Os comandos de treinamento abaixo fazem automaticamente a divisão: 80% para treinamento e 20% para validação; portanto, não é necessário preparar os dados manualmente.
Principais funcionalidades#
- O Caltech-101 contém 9.144 imagens coloridas distribuídas por 101 categorias de objetos, além de uma classe
BACKGROUND_Google(102 pastas de classes no total). - As categorias abrangem uma grande variedade de objetos do mundo real, incluindo animais, veículos, itens domésticos e pessoas.
- Cada categoria contém cerca de 40 a 800 imagens, portanto, o tamanho das classes é desigual.
- As imagens têm tamanhos variados; a maioria mede aproximadamente 300x200 pixels (resolução média).
- O Caltech-101 é amplamente usado para avaliar algoritmos de classificação de imagens e reconhecimento de objetos.
Estrutura do conjunto de dados#
O Caltech-101 é distribuído em 102 pastas — uma por classe, abrangendo 101 categorias de objetos e uma classe BACKGROUND_Google —, sem divisão predefinida entre treinamento e validação. Quando você inicia o treinamento, a Ultralytics divide automaticamente as imagens para que os modelos treinem nas 102 classes sem qualquer configuração manual:
- Classes: 102 (101 categorias de objetos + 1 de fundo)
- Total de imagens: 9.144
- Divisão entre treinamento e validação: automática, 80% / 20% (≈7.280 para treinamento, ≈1.864 para validação)
- Imagens por classe: cerca de 40 a 800 (desbalanceado)
Aplicações#
O Caltech-101 é amplamente usado para treinar e avaliar modelos de classificação de imagens e reconhecimento de objetos, incluindo redes neuronais convolucionais (CNNs) e máquinas de vetores de suporte (SVMs). A ampla variedade de categorias e as imagens nítidas e rotuladas fazem dele uma referência popular para pesquisa e prototipagem em aprendizado de máquina e visão computacional.
Uso#
Treine um modelo YOLO26n-cls no Caltech-101 por 100 épocas, com tamanho de imagem 416.
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n-cls.pt")  # carregue um modelo pré-treinado (recomendado para treinamento)

# Treinar o modelo
results = model.train(data="caltech101", epochs=100, imgsz=416)
Imagens de exemplo e anotações#
O conjunto de dados Caltech-101 contém imagens coloridas de alta qualidade de vários objetos, formando um conjunto bem estruturado para tarefas de classificação de imagens. Veja alguns exemplos de imagens do conjunto de dados:
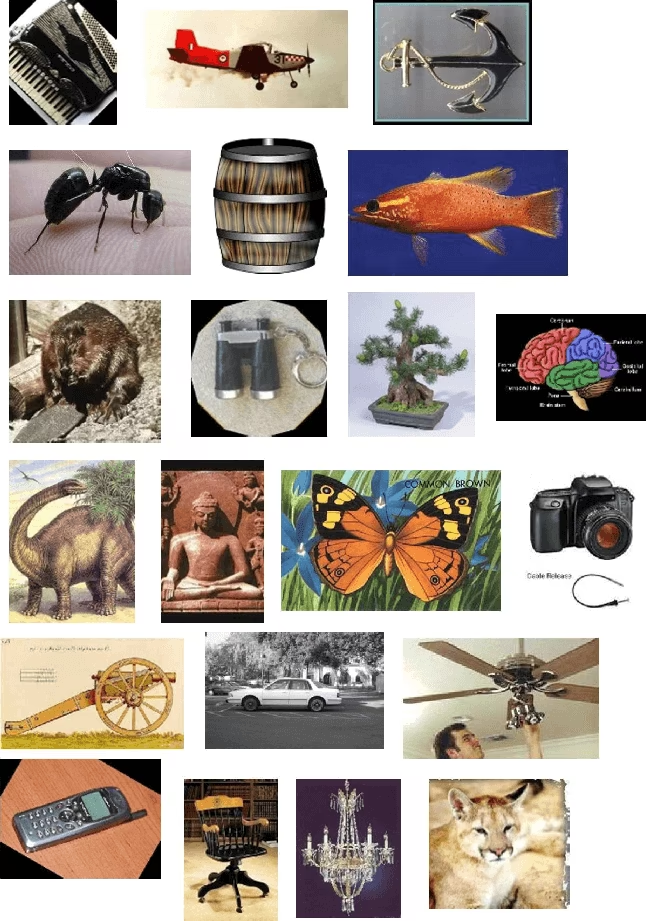
As amostras mostram a variedade de categorias e o enquadramento natural e centralizado típico do Caltech-101, que o torna um ponto de partida confiável para treinar modelos robustos de reconhecimento de objetos.
Citações e agradecimentos#
Se você usar o conjunto de dados Caltech-101 em suas pesquisas ou atividades de desenvolvimento, cite o artigo a seguir:
@article{fei2007learning,
  title={Learning generative visual models from few training examples: An incremental Bayesian approach tested on 101 object categories},
  author={Fei-Fei, Li and Fergus, Rob and Perona, Pietro},
  journal={Computer vision and Image understanding},
  volume={106},
  number={1},
  pages={59--70},
  year={2007},
  publisher={Elsevier}
}
Gostaríamos de agradecer a Li Fei-Fei, Rob Fergus e Pietro Perona por criarem e manterem o conjunto de dados Caltech-101 como um recurso valioso para a comunidade de pesquisa em aprendizado de máquina e visão computacional. Para saber mais sobre o conjunto de dados Caltech-101 e seus criadores, acesse o site do conjunto de dados Caltech-101.
Perguntas frequentes#
O conjunto de dados Caltech-101 é amplamente usado para treinar modelos de classificação de imagens e reconhecimento de objetos e avaliá-los. Ele contém 9.144 imagens distribuídas por 101 categorias de objetos, além de uma classe de fundo, oferecendo um desafio de referência para avaliar algoritmos como redes neuronais convolucionais (CNNs) e máquinas de vetores de suporte (SVMs).
Para treinar um modelo Ultralytics YOLO no Caltech-101, use os trechos de código abaixo. O conjunto de dados é baixado automaticamente no primeiro uso. Para ver a lista completa de argumentos, consulte a página de treinamento do modelo.
Exemplo de treinofrom ultralytics import YOLO # Carregar um modelo model = YOLO("yolo26n-cls.pt") # carregue um modelo pré-treinado (recomendado para treinamento) # Treinar o modelo results = model.train(data="caltech101", epochs=100, imgsz=416)O Caltech-101 contém 101 categorias de objetos e uma classe de fundo
BACKGROUND_Google, totalizando 102 pastas de classes e 9.144 imagens. Ao treinar com Ultralytics, o modelo aprende todas as 102 classes. O tamanho das categorias é desbalanceado, variando de cerca de 40 a 800 imagens por categoria.O Caltech-101 não tem uma divisão predefinida. Na primeira vez que você treinar, a Ultralytics dividirá automaticamente o conjunto em 80% para treinamento e 20% para validação — cerca de 7.280 imagens de treinamento e 1.864 de validação —, então você não precisa criar as divisões manualmente. Para controlar a divisão, organize as imagens nas pastas
train/eval/antes do treinamento.Sim. A Ultralytics Platform permite gerenciar conjuntos de dados, treinar modelos de classificação de imagens e implantá-los sem precisar escrever muito código. É uma maneira prática de executar experimentos com Caltech-101 na nuvem, e você pode explorar mais opções na nossa visão geral dos conjuntos de dados de classificação.


Comentários
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.