Conjunto de dados de tumores cerebrais
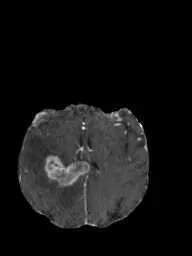
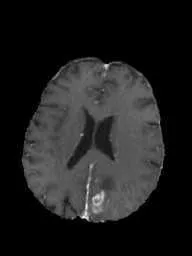
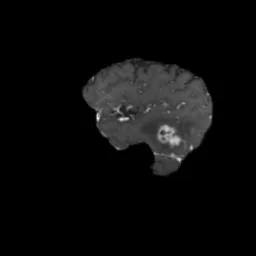
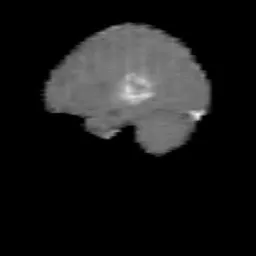

O conjunto de dados Brain Tumor da Ultralytics é um conjunto de dados de detecção de objetos com 1.115 imagens de ressonância magnética cerebral (994 para treinamento e 121 para validação) e 1.180 caixas delimitadoras em uma única classe, tumor. Cada imagem contém de 1 a 3 caixas de tumor. A divisão de validação contém as imagens de 25 pacientes identificados, e nenhum paciente identificado aparece nas duas divisões. Com apenas 4,06 MB, é um conjunto de dados compacto para aprender e criar protótipos de modelos de visão computacional para aplicações na área da saúde, mas não é um recurso de diagnóstico validado clinicamente.
Assista: Detecção de tumores cerebrais usando a plataforma Ultralytics com Ultralytics YOLO26 | Detecção de objetos 🚀
Estrutura do conjunto de dados#
O conjunto de dados Brain Tumor da Ultralytics contém 1.115 imagens de ressonância magnética cerebral e 1.180 caixas delimitadoras em duas divisões definidas pela configuração brain-tumor.yaml:
| Divisão | Imagens | Caixas delimitadoras | Pacientes |
|---|---|---|---|
| Treinar | 994 | 1,057 | 95 com ID, mais 541 imagens sem ID de paciente |
| Validação | 121 | 123 | 25 |
| Total | 1,115 | 1,180 |
Cada imagem contém de 1 a 3 caixas delimitadoras da única classe tumor, e os tamanhos das imagens variam de 192x256 a 512x512 pixels. A configuração não define uma divisão de teste separada.
A divisão de validação é feita por paciente. Alguns nomes de arquivo começam com um ID de paciente de cinco dígitos: por exemplo, 00097_77.jpg pertence ao paciente 00097. As imagens com os IDs de 25 desses pacientes formam a divisão de validação, e as imagens dos outros 95 pacientes identificados ficam no treinamento, portanto nenhum paciente identificado aparece nas duas divisões. As 541 imagens restantes não têm ID de paciente no nome do arquivo e ficam todas na divisão de treinamento.
O conjunto de dados é baixado automaticamente (4,06 MB) dos recursos do GitHub da Ultralytics na primeira vez que você treina, portanto não é necessário fazer o download nem a preparação manualmente.
O conjunto de dados passou a ter uma única classe tumor em novembro de 2026. Se a pasta local brain-tumor/images/train contiver 893 imagens em vez de 994, exclua a pasta brain-tumor do diretório de conjuntos de dados (veja datasets_dir em yolo settings) e atualize o pacote com pip install -U ultralytics. A versão atual será baixada na próxima execução de treinamento.
Explore Tumores cerebrais na Ultralytics Platform para ver as imagens com as sobreposições das anotações, consultar a distribuição das classes e os mapas de calor das caixas delimitadoras na aba Charts e cloná-lo para treinar seu próprio modelo na nuvem.
Aplicações#
Os modelos de detecção de tumores cerebrais localizam tumores em imagens de ressonância magnética cerebral. Com 1.115 imagens e um download de 4,06 MB, o conjunto de dados Brain Tumor da Ultralytics é adequado para:
- Aprender o fluxo de trabalho: executar o ciclo completo de treinamento, validação e predição com imagens médicas usando um conjunto de dados pequeno.
- Criar protótipos: desenvolver e testar um pipeline de localização de tumores antes de passar para um conjunto de dados clínicos maior.
- Avaliação em pacientes identificados: medir a detecção nos 25 pacientes da validação. Como 541 imagens de treinamento não têm ID de paciente, não é possível descartar a sobreposição com esses pacientes.
- Pesquisa e educação: comparar modelos de detecção e estudar a análise de imagens médicas e a IA em radiologia.
Os modelos treinados com este conjunto de dados destinam-se à pesquisa e à educação e não foram validados para diagnóstico clínico.
YAML do conjunto de dados#
A configuração brain-tumor.yaml define o caminho do conjunto de dados, as pastas de imagens de treinamento e validação, a única classe tumor e o URL de download. Os rótulos usam o formato YOLO da Ultralytics.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Brain-tumor dataset by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/detect/brain-tumor
# Example usage: yolo train data=brain-tumor.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── brain-tumor ← downloads here (4.06 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: brain-tumor # dataset root dir
train: images/train # train images (relative to 'path') 994 images
val: images/val # val images (relative to 'path') 121 images

# Classes
names:
  0: tumor

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/brain-tumor.zipUso#
Para treinar um modelo YOLO26n no conjunto de dados de tumores cerebrais durante 100 épocas, com tamanho de imagem 640, utiliza os exemplos de código abaixo.
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n.pt")  # carregue um modelo pré-treinado (recomendado para treinamento)

# Treinar o modelo
results = model.train(data="brain-tumor.yaml", epochs=100, imgsz=640)from ultralytics import YOLO
# Carregar um modelo
model = YOLO("path/to/best.pt") # carregar um modelo de tumores cerebrais ajustado
# Inferência usando o modelo
results = model.predict("https://ultralytics.com/assets/brain-tumor-sample.jpg")Imagens de exemplo e anotações#
Abaixo estão imagens de exemplo do conjunto de dados Brain Tumor da Ultralytics com suas anotações:
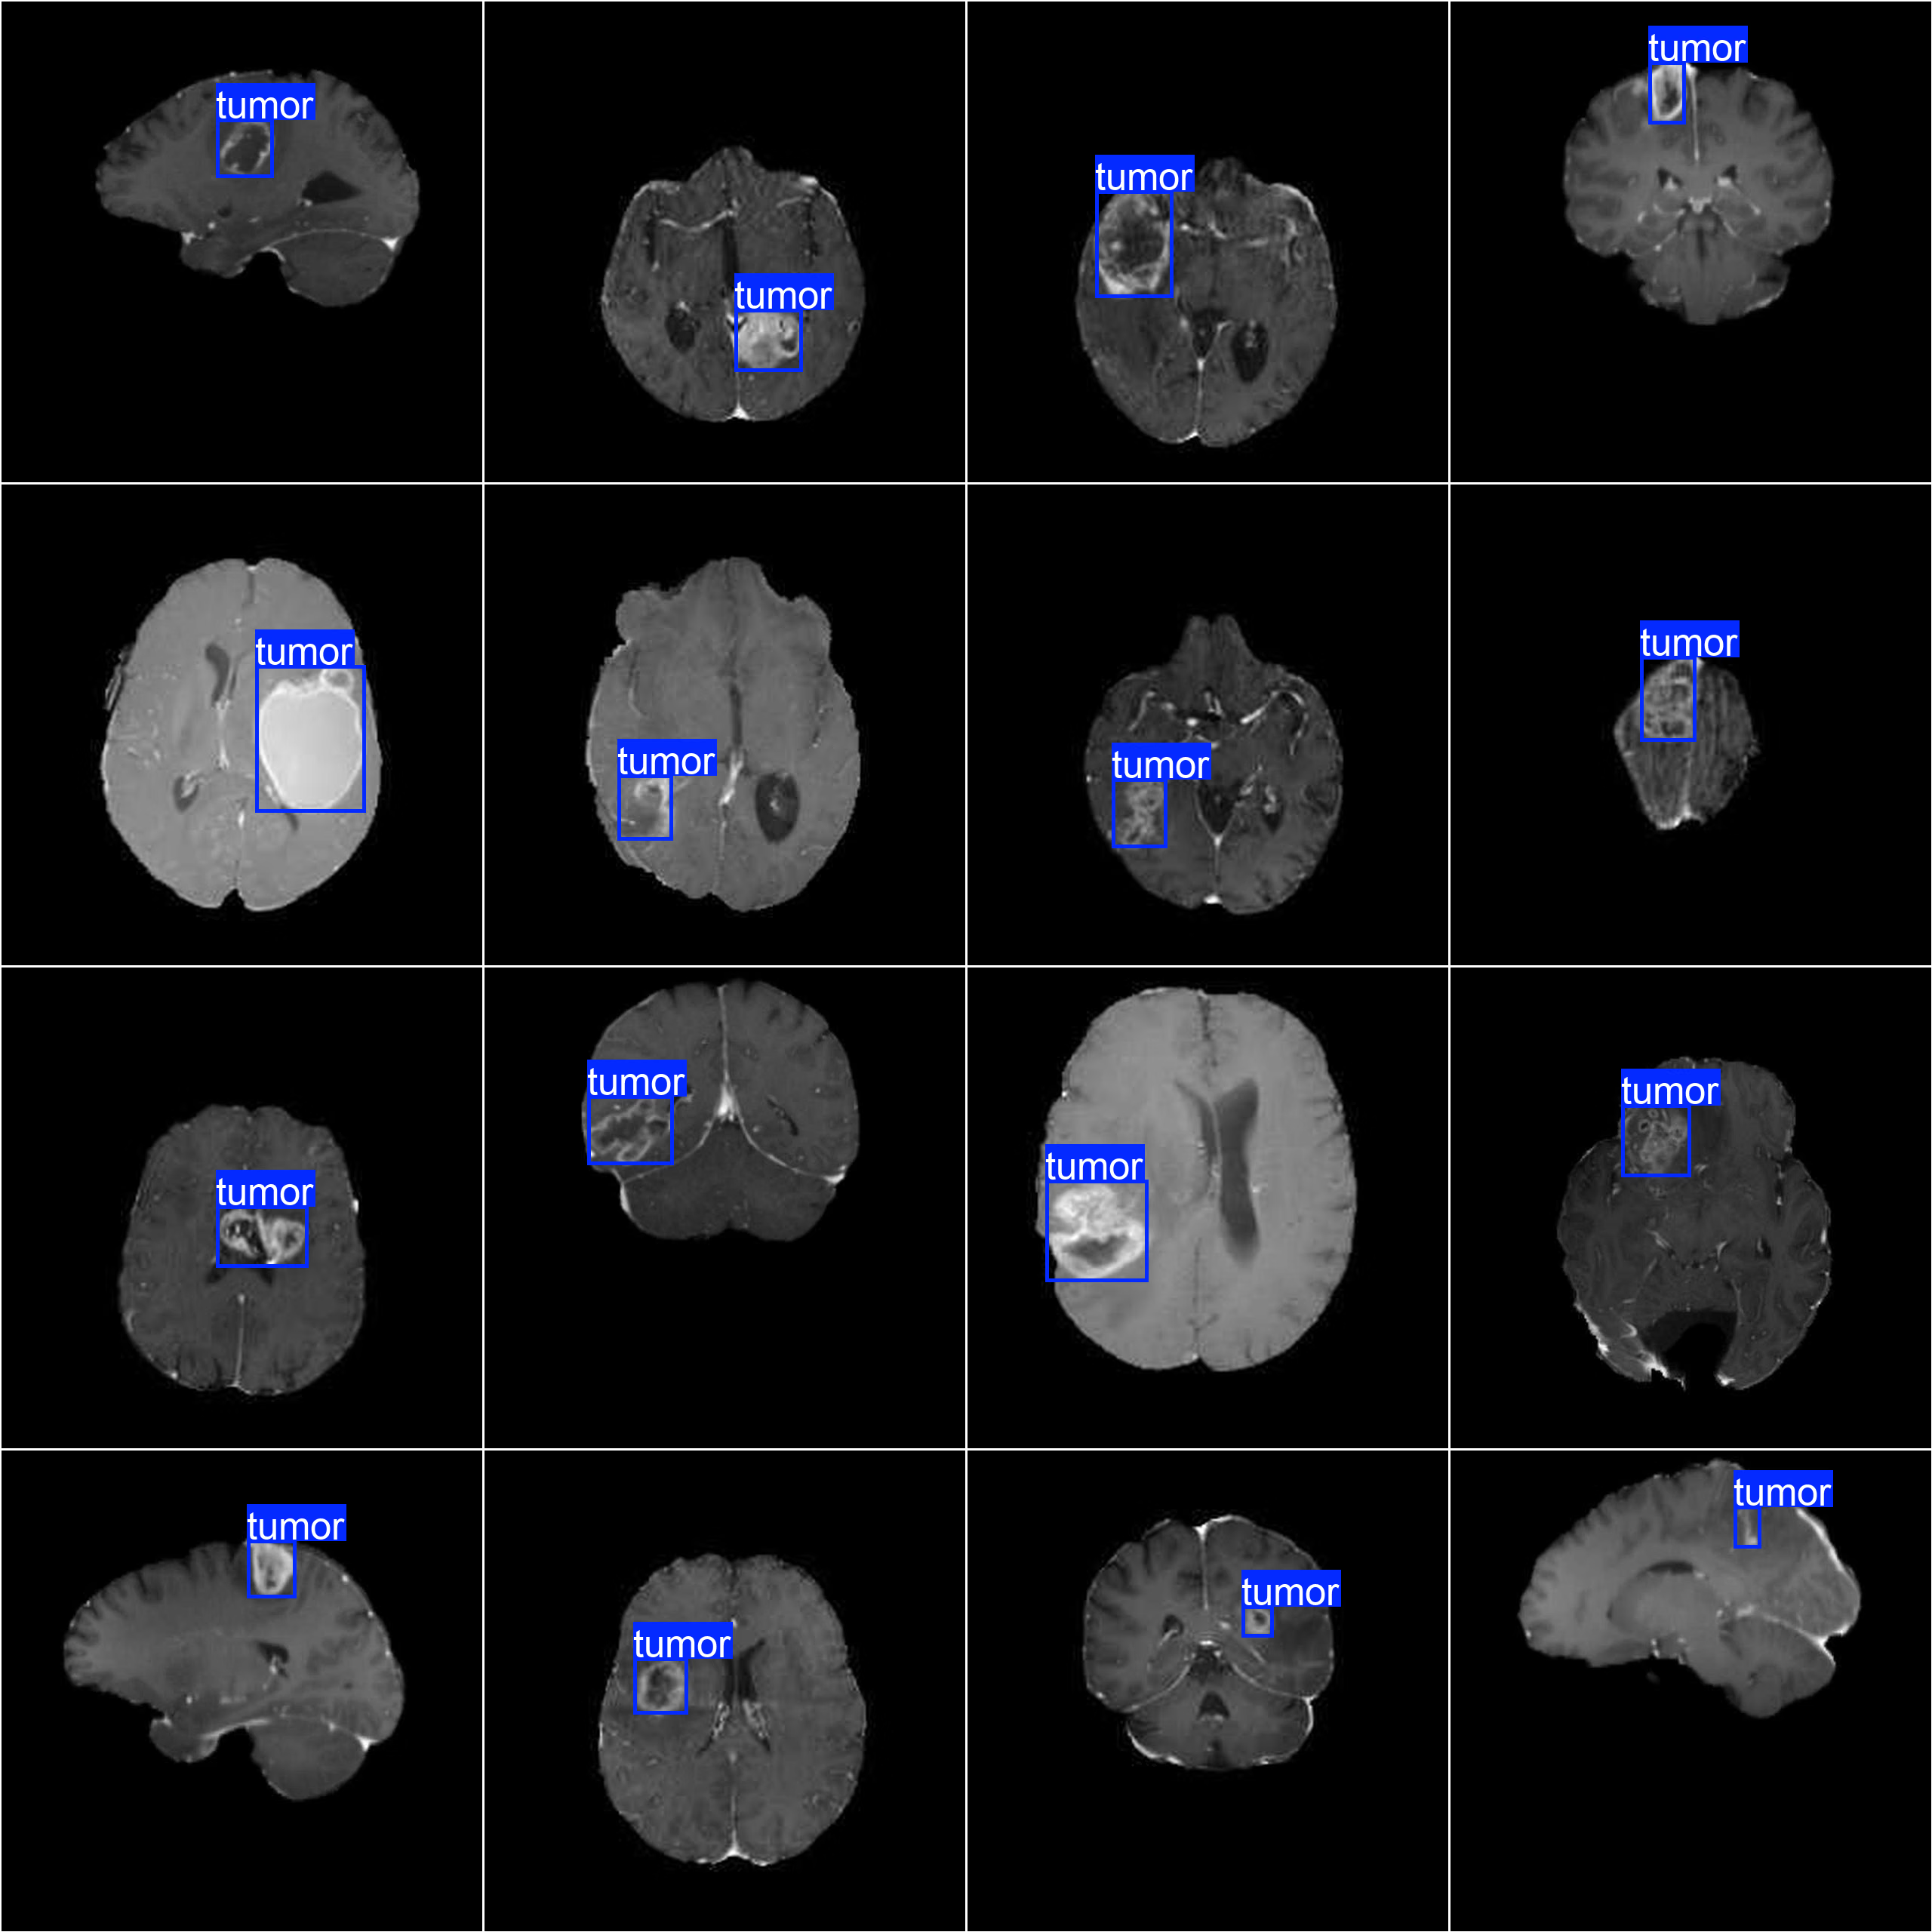
- Imagens anotadas: a grade mostra 16 imagens de treinamento, cada uma com uma caixa delimitadora
tumorao redor da lesão. Os tumores variam em tamanho, forma e localização no conjunto de dados, o que ajuda um modelo de detecção a generalizar.
Citações e agradecimentos#
O conjunto de dados está disponível sob a Licença AGPL-3.0.
Se você usar o conjunto de dados de tumores cerebrais em seu trabalho de pesquisa ou desenvolvimento, cite-o:
@dataset{Ultralytics_Brain_Tumor_Dataset_2023,
    author = {Ultralytics},
    title = {Brain Tumor Detection Dataset},
    year = {2023},
    publisher = {Ultralytics},
    url = {https://docs.ultralytics.com/datasets/detect/brain-tumor}
}
Perguntas frequentes#
O conjunto de dados Brain Tumor da Ultralytics tem 1.115 imagens de ressonância magnética cerebral e 1 classe,
tumor: 994 imagens de treinamento com 1.057 caixas delimitadoras e 121 imagens de validação com 123 caixas delimitadoras. Cada imagem tem de 1 a 3 caixas, e não há uma divisão de teste separada. Consulte Estrutura do conjunto de dados para ver os detalhes das divisões.O conjunto de dados Brain Tumor da Ultralytics contém imagens de ressonância magnética cerebral e nenhuma tomografia computadorizada. Os tamanhos das imagens variam de 192x256 a 512x512 pixels, e cada imagem é anotada com 1 a 3 caixas delimitadoras
tumorno formato YOLO da Ultralytics.Não, o conjunto de dados Brain Tumor da Ultralytics não contém imagens sem tumores nem uma classe negativa. Todas as 1.115 imagens têm de 1 a 3 caixas delimitadoras
tumor, portanto um modelo treinado com ele aprende onde está um tumor, não se um exame está saudável. Os modelos treinados com este conjunto de dados destinam-se à pesquisa e à educação, não ao diagnóstico clínico.O conjunto de dados Brain Tumor da Ultralytics é dividido por paciente: as 121 imagens de validação têm os IDs de 25 pacientes, e nenhum paciente identificado aparece nas duas divisões. Os pacientes são identificados pelo prefixo de cinco dígitos no nome do arquivo, como
00097_77.jpg. O conjunto de treinamento contém os outros 95 pacientes identificados, além de 541 imagens cujos nomes de arquivo não têm ID de paciente.O conjunto de dados Brain Tumor da Ultralytics (4,06 MB) é baixado automaticamente dos recursos do GitHub da Ultralytics na primeira vez que você treina com
data="brain-tumor.yaml", portanto não é necessário fazer o download manualmente. Se uma cópia anterior com 893 imagens de treinamento já estiver no disco, exclua a pastabrain-tumore atualize primeiro o pacoteultralyticspara que a versão atual com uma única classe seja baixada. Para outro conjunto de dados pequeno de imagens médicas, consulte o conjunto de dados de detecção de pílulas médicas.Para treinar YOLO26 com o conjunto de dados Brain Tumor da Ultralytics, passe
data="brain-tumor.yaml"ao comando de treinamento, e o conjunto de dados será baixado automaticamente. Os exemplos abaixo treinam YOLO26n por 100 épocas com um tamanho de imagem de 640:Exemplo de treinofrom ultralytics import YOLO # Carregar um modelo model = YOLO("yolo26n.pt") # carregue um modelo pré-treinado (recomendado para treinamento) # Treinar o modelo results = model.train(data="brain-tumor.yaml", epochs=100, imgsz=640)Para ver uma lista detalhada dos argumentos disponíveis, consulte a página de treinamento.
Para executar inferência com um modelo YOLO26 ajustado com o conjunto de dados Brain Tumor da Ultralytics, carregue os pesos
best.pte chame predict em uma imagem de ressonância magnética cerebral. Cada resultado contém as caixas delimitadorastumorcom pontuações de confiança:Exemplo de inferênciafrom ultralytics import YOLO # Carregar um modelo model = YOLO("path/to/best.pt") # carregar um modelo de tumores cerebrais ajustado # Inferência usando o modelo results = model.predict("https://ultralytics.com/assets/brain-tumor-sample.jpg")O conjunto de dados Brain Tumor da Ultralytics foi criado pela Ultralytics e é distribuído sob a Licença AGPL-3.0.


Comentários11
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
ZoltinZyc
how can i download this datasett??
1 Paula DerrengerUltralytics(editado)
Hey there! 😊 The easiest way is to train with
data=brain-tumor.yaml, which downloads the dataset automatically the first time. To download it manually, use:wget https://github.com/ultralytics/assets/releases/download/v0.0.0/brain-tumor.zip unzip brain-tumor.zip -d path/to/destinationReplace
path/to/destinationwith the directory where you'd like the dataset stored. Once you have the dataset, you're all set to start training or inferencing with YOLO models on brain tumor images!Should you need further guidance, feel free to ask. Happy coding! 🚀
G-qingqian
Thank you for your reply. I noticed that in the original dataset, the images in the train folder do have ID prefixes, but the images in the val folder are all prefixed with val1_, making it impossible to distinguish which patient the data belongs to. Therefore, I cannot redivide the dataset. Could you please provide data with complete identifiers? ---- Replied Message ---- FromGlenn @.>Date1/18/2026 @.>@.>, @.>SubjectRe: [ultralytics/ultralytics] zh/datasets/detect/brain-tumor/ (Discussion #9988) The packaged brain-tumor dataset split is provided at the image-folder level and doesn’t ship patient IDs/metadata, so we can’t guarantee a patient-disjoint (no same patient in both train/val) split; if you need patient-wise separation, you’ll need to rebuild the split from patient identifiers and point a custom YAML to *.txt image lists (supported by Ultralytics YOLO), e.g. see the provided config in the Brain Tumor dataset docs and the brain-tumor.yaml in the repo.
my-brain-tumor.yaml path: /data/brain-tumor train: splits/train.txt # one image path per line (ideally grouped by patient ID when you create it) val: splits/val.txt names: 0: negative 1: positive
— Reply to this email directly, view it on GitHub, or unsubscribe. You are receiving this because you commented.Message ID: @.***>
 Glenn JocherUltralytics
The packaged
brain-tumorzip only includes image-level labels with anonymized filenames (no patient IDs/metadata), so we can’t provide “complete identifiers” or guarantee a patient-disjoint re-split; for patient-wise splitting you’ll need to rebuild from a source that includes patient IDs (e.g., your DICOM/NIfTI originals) and then generatetrain.txt/val.txt, and if you just need stronger evaluation without IDs you can use our K-Fold Cross Validation guide—please keep follow-ups here in the GitHub discussion (we can’t provide support over email/DM).
Can your dataset ensure that the data are independently and identically distributed by patient? That is, there will be no data from the same patient in both the training set and the validation set.
- Glenn JocherUltralytics
The packaged
brain-tumordataset split is provided at the image-folder level and doesn’t ship patient IDs/metadata, so we can’t guarantee a patient-disjoint (no same patient in both train/val) split; if you need patient-wise separation, you’ll need to rebuild the split from patient identifiers and point a custom YAML to*.txtimage lists (supported by Ultralytics YOLO), e.g. see the provided config in the Brain Tumor dataset docs and the brain-tumor.yaml in the repo.# my-brain-tumor.yaml path: /data/brain-tumor train: splits/train.txt # one image path per line (ideally grouped by patient ID when you create it) val: splits/val.txt names: 0: negative 1: positive
pizzas17
How could I download this dataset on COCO format or how could I convert it? (Since I wish to have an EDA on it
xySun17
How can i train the yoloV8 using this dataset without loading the pre-trained weights?
- Paula DerrengerUltralytics(editado)
@xySun17 hello!
To train YOLO26 without loading the pre-trained weights, you can initialize the model from scratch by specifying the model architecture file (e.g.,
yolo26n.yaml) instead of the pre-trained weights file. Here’s how you can do it:Python
from ultralytics import YOLO

# Load a model architecture without pre-trained weights
model = YOLO("yolo26n.yaml")  # build a new model from YAML

# Train the model
results = model.train(data="brain-tumor.yaml", epochs=100, imgsz=640)
CLI
# Train from scratch using the model architecture file
yolo detect train data=brain-tumor.yaml model=yolo26n.yaml epochs=100 imgsz=640
This approach ensures that the model starts training with random weights rather than pre-trained ones. If you encounter any issues, please ensure you are using the latest version of the Ultralytics package and provide a minimum reproducible example if the problem persists. You can find more details on creating a reproducible example here.
Feel free to reach out if you have any further questions. Happy training! 🚀
1 Thank you!! However, there is another problem, that is, why it says the path of dataset is not found? I already downloaded the dataset files and changed the path in "brain-tumor.yaml" file.
The threw error was follows: "Dataset 'brain-tumor.yaml' images not found ⚠️, missing path '/valid/images' Note dataset download directory is '/home/ros/datasets'. You can update this in '/home/ros/.config/Ultralytics/settings.yaml'"
- Paula DerrengerUltralytics(editado)
Hello @xySun17,
Thank you for reaching out! It looks like the issue might be related to the dataset path configuration in your
brain-tumor.yamlfile. Here are a few steps to troubleshoot and resolve this:-
Verify Dataset Path: Ensure that the paths specified in your
brain-tumor.yamlfile correctly point to the locations of your dataset images. For example:path: /home/ros/datasets/brain-tumor train: images/train val: images/val -
Check Directory Structure: Confirm that the directory structure matches what is specified in the YAML file. The
images/trainandimages/valdirectories should exist within/home/ros/datasets/brain-tumor. -
Update Configuration: If the dataset is located in a different directory, update the
pathin the YAML file accordingly. For instance, if your dataset is in/home/ros/my-datasets/brain-tumor, update thepathto:path: /home/ros/my-datasets/brain-tumor -
Reproducible Example: If the issue persists, providing a minimum reproducible example can greatly help in diagnosing the problem. You can find guidance on creating a reproducible example here.
-
Latest Version: Ensure you are using the latest version of the Ultralytics package. You can update it using:
pip install --upgrade ultralytics
Here’s an example of how your
brain-tumor.yamlshould look:# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license # Brain-tumor dataset by Ultralytics # Documentation: https://docs.ultralytics.com/datasets/detect/brain-tumor/ # Example usage: yolo train data=brain-tumor.yaml path: /home/ros/datasets/brain-tumor # dataset root dir train: images/train # train images (relative to 'path') val: images/val # val images (relative to 'path') # Classes names: 0: negative 1: positive # Download script/URL (optional) download: https://github.com/ultralytics/assets/releases/download/v0.0.0/brain-tumor.zipIf you follow these steps and still encounter issues, please share more details or any error messages you receive. This will help us assist you better.
Best regards and happy coding! 🚀
-