Conjunto de dados Roboflow 100#
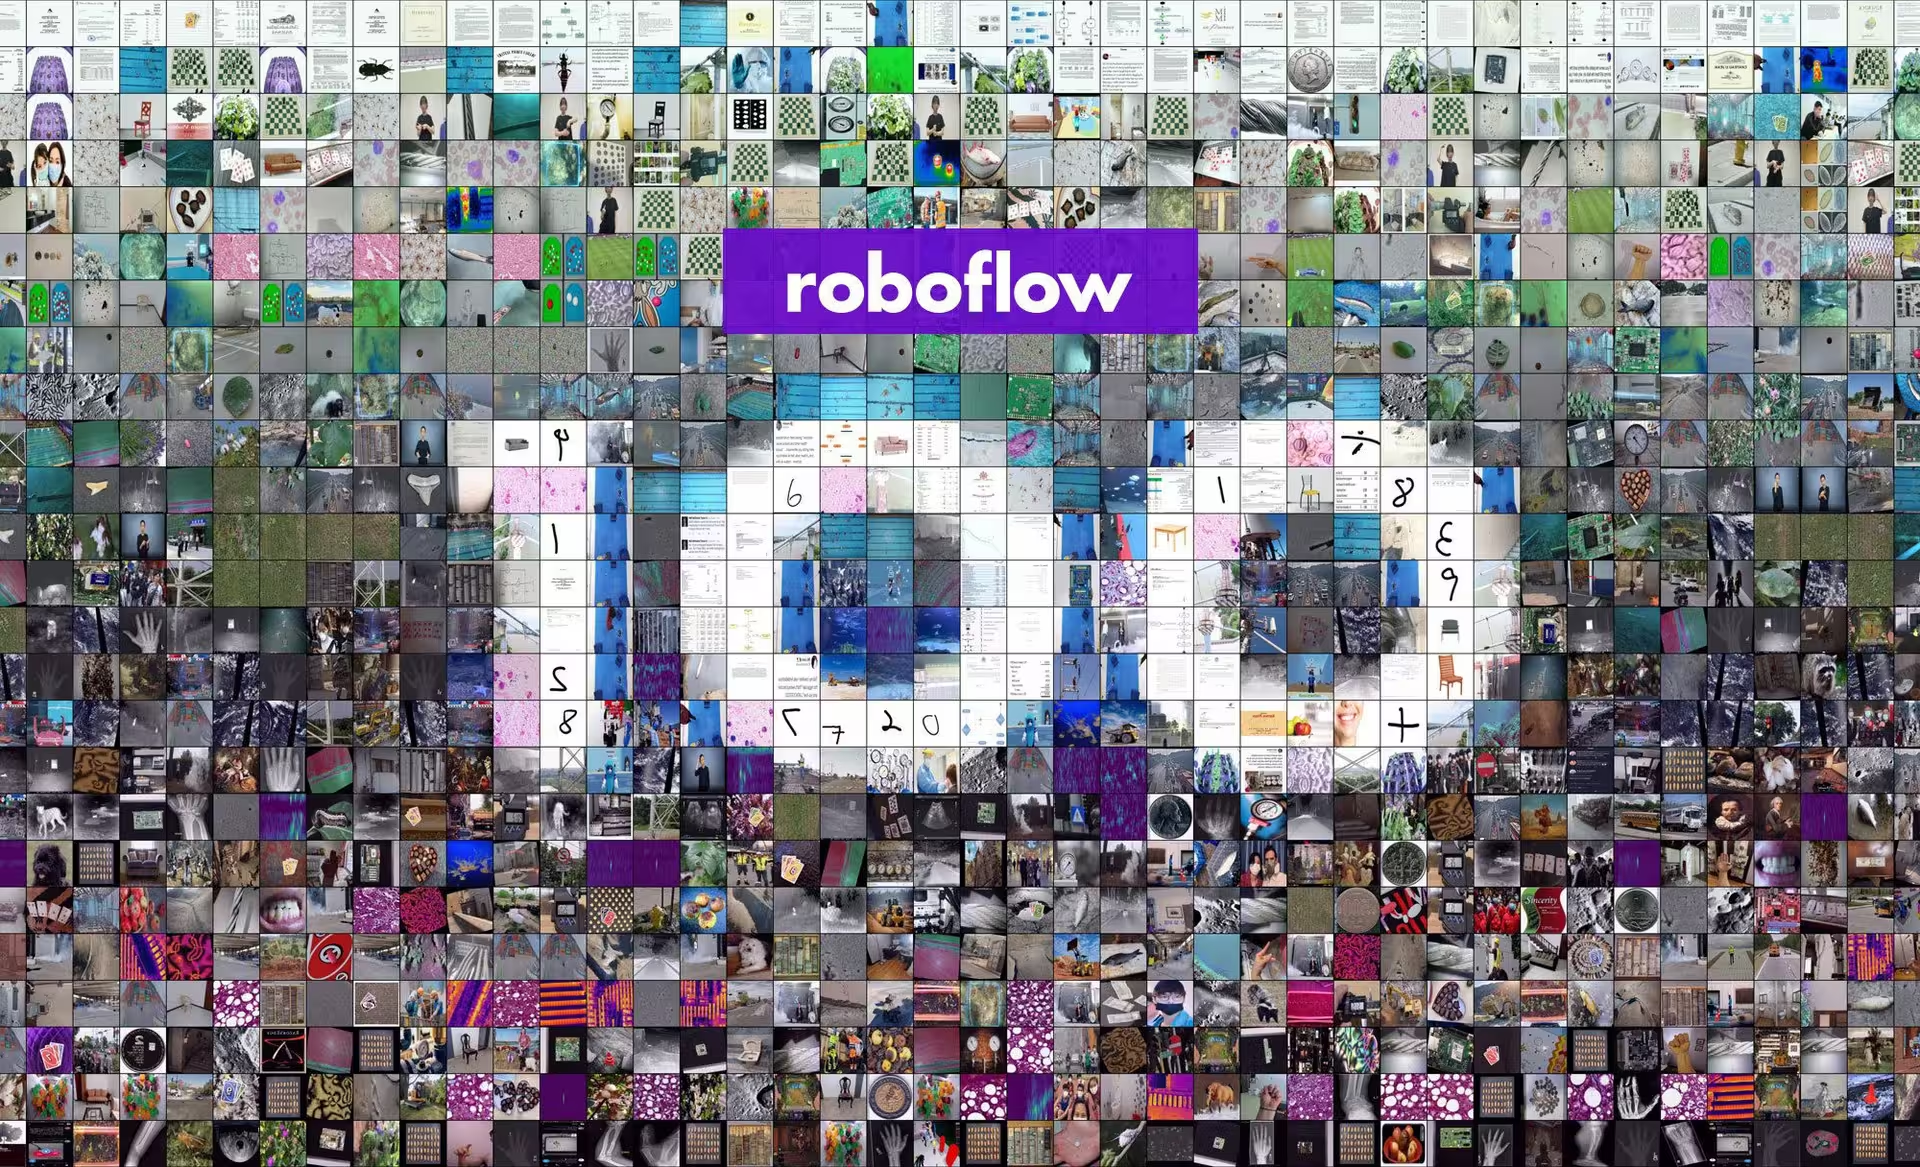
O Roboflow 100, patrocinado pela Intel, é um conjunto de dados inovador de benchmark de detecção de objetos. Ele inclui 100 conjuntos de dados variados. Esse benchmark foi desenvolvido especificamente para testar a adaptabilidade de modelos de visão computacional, como os modelos Ultralytics YOLO, a vários domínios, incluindo saúde, imagens aéreas e videogames.
Principais funcionalidades#
- Diversidade de domínios: inclui 100 conjuntos de dados distribuídos por sete domínios distintos: aéreo, videogames, microscópico, subaquático, documentos, eletromagnético e mundo real.
- Escala: o benchmark reúne 224.714 imagens em 805 classes, representando mais de 11.170 horas de trabalho de rotulagem de dados.
- Padronização: todas as imagens são pré-processadas e redimensionadas para 640x640 pixels para garantir uma avaliação consistente.
- Avaliação rigorosa: concentra-se em eliminar ambiguidades entre classes e filtra classes sub-representadas para garantir uma avaliação de modelos mais confiável.
- Anotações: inclui caixas delimitadoras para objetos, adequadas ao treinamento e à avaliação de modelos de detecção de objetos com métricas como mAP.
Estrutura do conjunto de dados#
O conjunto de dados Roboflow 100 está organizado em sete categorias, cada uma com uma coleção exclusiva de conjuntos de dados, imagens e classes:
- Aéreo: 7 conjuntos de dados, 9.683 imagens, 24 classes.
- Videogames: 7 conjuntos de dados, 11.579 imagens, 88 classes.
- Microscópico: 11 conjuntos de dados, 13.378 imagens, 28 classes.
- Subaquático: 5 conjuntos de dados, 18.003 imagens, 39 classes.
- Documentos: 8 conjuntos de dados, 24.813 imagens, 90 classes.
- Eletromagnético: 12 conjuntos de dados, 36.381 imagens, 41 classes.
- Mundo real: 50 conjuntos de dados, 110.615 imagens, 495 classes.
Essa estrutura oferece um ambiente de teste diversificado e abrangente para modelos de detecção de objetos, refletindo uma ampla gama de cenários de aplicação do mundo real encontrados em várias soluções da Ultralytics.
Avaliação comparativa#
A avaliação comparativa de conjuntos de dados consiste em avaliar o desempenho de modelos de aprendizado de máquina em conjuntos de dados específicos usando métricas padronizadas. Entre as métricas comuns estão acurácia, precisão média (mAP) e pontuação F1. Saiba mais sobre elas no nosso guia de métricas de desempenho do YOLO.
Cada saída é agrupada em um único diretório runs/<task>/multitrain/: cada conjunto de dados é ajustado em seu próprio subdiretório (com seu próprio results.png), e as métricas por conjunto de dados e a média são gravadas em multitrain_results.json, junto com um gráfico de barras multitrain_results.png. A chamada model.train() também retorna um dicionário {dataset: metrics} para acesso programático.
O script abaixo baixa do Roboflow os conjuntos de dados Roboflow 100 listados em datasets_links.txt e, em seguida, ajusta um único modelo base (por exemplo, YOLO26n) em toda a coleção com uma única chamada model.train(). Ao passar uma lista de conjuntos de dados, o modelo base é ajustado em cada um deles, em sequência, e os resultados entre os conjuntos são visualizados automaticamente.
import re
from pathlib import Path

from roboflow import Roboflow

from ultralytics import YOLO
from ultralytics.utils import ASSETS_URL, LOGGER, YAML
from ultralytics.utils.downloads import safe_download

# Download the RF100 datasets (requires a Roboflow API key)
rf = Roboflow(api_key="YOUR_ROBOFLOW_API_KEY")
safe_download(f"{ASSETS_URL}/datasets_links.txt")  # list of RF100 dataset links

datasets = []
for line in Path("datasets_links.txt").read_text().splitlines():
    try:
        _, _url, workspace, project, version = re.split("/+", line.strip())
        location = f"rf-100/{project}-{version}"
        rf.workspace(workspace).project(project).version(version).download("yolov8", location=location)
        yaml = Path(location) / "data.yaml"
        cfg = YAML.load(yaml)  # point train/val at the downloaded image folders
        cfg["train"], cfg["val"] = "train/images", "valid/images"
        YAML.save(yaml, cfg)
        datasets.append(str(yaml))
    except Exception as e:
        LOGGER.warning(f"Failed to prepare dataset from {line!r}: {e}")

# Fine-tune one base model across all RF100 datasets and visualize the cross-dataset results
model = YOLO("yolo26n.pt")
results = model.train(data=datasets, epochs=100, imgsz=640)  # {dataset: metrics}

# Per-dataset runs, multitrain_results.json (per-dataset + mean), and multitrain_results.png are saved
# together under runs/detect/multitrain. Read results in-memory or from the JSON for custom post-processing.
for dataset, metrics in results.items():
    if metrics:  # None if that dataset failed to train
print(f"{dataset}: mAP50-95 = {metrics['metrics/mAP50-95(B)']:.4f}")Aplicações#
O Roboflow 100 é extremamente útil para várias aplicações relacionadas à visão computacional e ao aprendizado profundo. Pesquisadores e engenheiros podem aproveitar esse benchmark para:
- Avaliar o desempenho de modelos de detecção de objetos em um contexto multidomínio.
- Testar a adaptabilidade e a robustez dos modelos em cenários do mundo real, além de conjuntos de dados de benchmark comuns, como COCO ou PASCAL VOC.
- Avaliar comparativamente os recursos de modelos de detecção de objetos em diversos conjuntos de dados, incluindo áreas especializadas como saúde, imagens aéreas e videogames.
- Comparar o desempenho de modelos em diferentes arquiteturas de redes neurais e técnicas de otimização.
- Identificar desafios específicos de cada domínio que possam exigir dicas especializadas de treinamento de modelos ou abordagens de ajuste fino, como aprendizado por transferência.
Para encontrar mais ideias e inspiração para aplicações do mundo real, explore nossos guias de projetos práticos ou conheça a Ultralytics Platform para simplificar o treinamento de modelos e a implantação.
Uso#
O conjunto de dados Roboflow 100, incluindo metadados e links para download, está disponível no repositório oficial do Roboflow 100 no GitHub. Você pode acessar e usar o conjunto de dados diretamente de lá para suas necessidades de avaliação comparativa. Depois de baixar e preparar os conjuntos de dados conforme mostrado acima, é possível ajustar os modelos Ultralytics em toda a coleção com uma única chamada model.train(), passando a lista de arquivos YAML dos conjuntos de dados.
Dados de exemplo e anotações#
O Roboflow 100 reúne conjuntos de dados com imagens variadas, capturadas de diferentes ângulos e domínios. Abaixo estão exemplos de imagens anotadas incluídas no benchmark RF100, que ilustram a variedade de objetos e cenas. Técnicas como aumento de dados podem ampliar ainda mais a diversidade durante o treinamento.
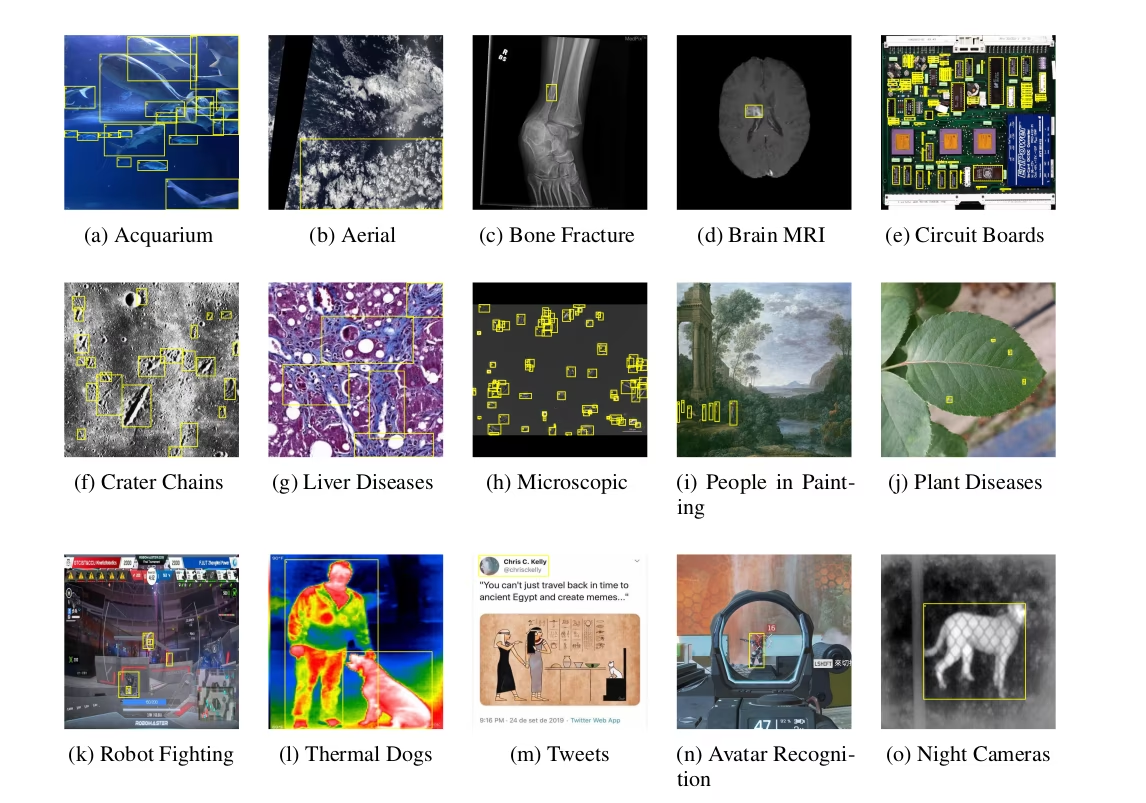
A diversidade do benchmark Roboflow 100 representa um avanço significativo em relação aos benchmarks tradicionais, que muitas vezes se concentram na otimização de uma única métrica em um domínio limitado. Essa abordagem abrangente ajuda a desenvolver modelos de visão computacional mais robustos e versáteis, capazes de ter bom desempenho em muitos cenários diferentes.
Citações e agradecimentos#
Se você usar o conjunto de dados Roboflow 100 em sua pesquisa ou trabalho de desenvolvimento, cite o artigo original:
@misc{rf100benchmark,
    Author = {Floriana Ciaglia and Francesco Saverio Zuppichini and Paul Guerrie and Mark McQuade and Jacob Solawetz},
    Title = {Roboflow 100: A Rich, Multi-Domain Object Detection Benchmark},
    Year = {2022},
    Eprint = {arXiv:2211.13523},
    url = {https://arxiv.org/abs/2211.13523}
}
Agradecemos à equipe do Roboflow e a todos os colaboradores por seus esforços significativos na criação e manutenção do conjunto de dados Roboflow 100 como um recurso valioso para a comunidade de visão computacional.
Se você quiser explorar mais conjuntos de dados para aprimorar seus projetos de detecção de objetos e aprendizado de máquina, visite nossa coleção abrangente de conjuntos de dados, que inclui vários outros conjuntos de dados de detecção.
Perguntas frequentes#
O conjunto de dados Roboflow 100 é um benchmark para modelos de detecção de objetos. Ele reúne 100 conjuntos de dados variados que abrangem domínios como saúde, imagens aéreas e videogames. Sua importância está em oferecer uma forma padronizada de testar a adaptabilidade e a robustez dos modelos em uma ampla variedade de cenários do mundo real, indo além dos benchmarks tradicionais, muitas vezes limitados a um único domínio.
O conjunto de dados Roboflow 100 abrange sete domínios diversos, que oferecem desafios exclusivos para modelos de detecção de objetos:
- Aéreo: 7 conjuntos de dados (por exemplo, imagens de satélite e vistas de drones).
- Videogames: 7 conjuntos de dados (por exemplo, objetos de vários ambientes de jogos).
- Microscópico: 11 conjuntos de dados (por exemplo, células e partículas).
- Subaquático: 5 conjuntos de dados (por exemplo, vida marinha e objetos submersos).
- Documentos: 8 conjuntos de dados (por exemplo, regiões de texto e elementos de formulários).
- Eletromagnético: 12 conjuntos de dados (por exemplo, assinaturas de radar e visualizações de dados espectrais).
- Mundo real: 50 conjuntos de dados (uma categoria abrangente que inclui objetos do cotidiano, cenas, varejo etc.).
Essa variedade faz do RF100 um excelente recurso para avaliar a capacidade de generalização dos modelos de visão computacional.
Ao usar o conjunto de dados Roboflow 100, cite o artigo original para dar crédito aos criadores. Esta é a citação BibTeX recomendada:
Citação@misc{rf100benchmark, Author = {Floriana Ciaglia and Francesco Saverio Zuppichini and Paul Guerrie and Mark McQuade and Jacob Solawetz}, Title = {Roboflow 100: A Rich, Multi-Domain Object Detection Benchmark}, Year = {2022}, Eprint = {arXiv:2211.13523}, url = {https://arxiv.org/abs/2211.13523} }Para explorar mais, considere visitar nossa coleção abrangente de conjuntos de dados ou consultar outros conjuntos de dados de detecção compatíveis com os modelos Ultralytics.