Conjunto de dados SKU-110K
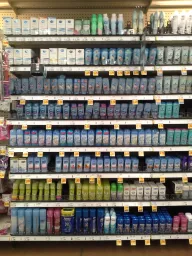
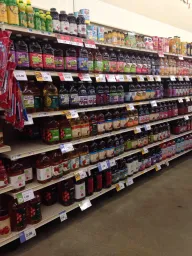
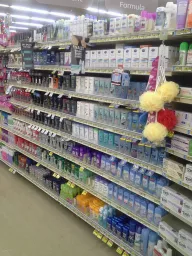
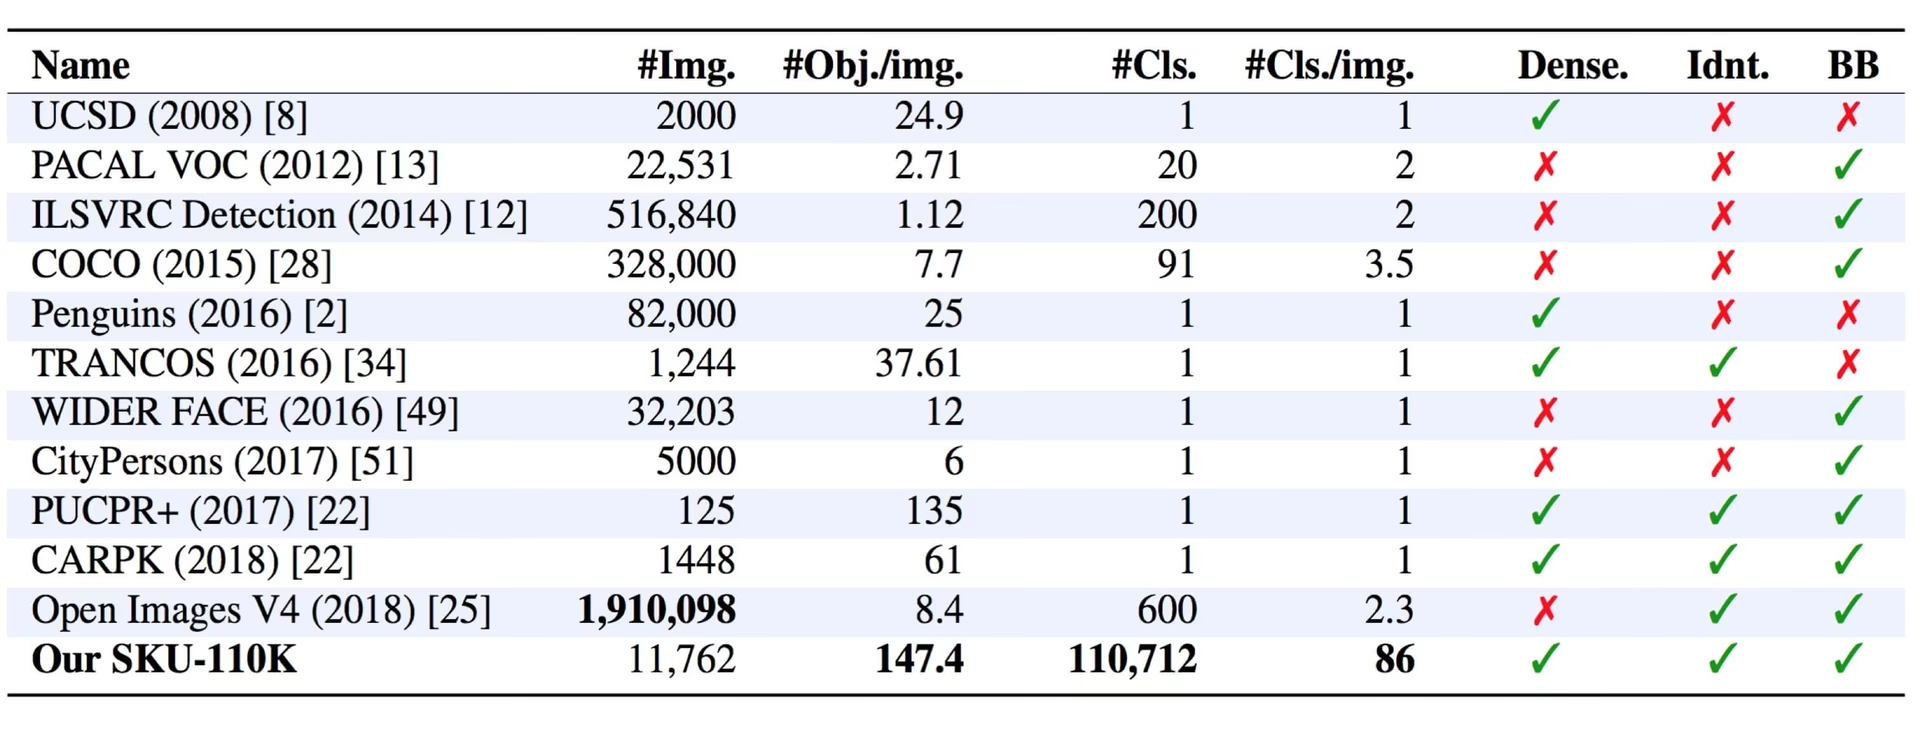
O conjunto de dados SKU-110K é um conjunto de dados de deteção de objetos de classe única, com 11 743 imagens de prateleiras de lojas com produtos densamente agrupados, dividido em 8 219 imagens de treino, 588 de validação e 2 936 de teste. Cada produto é anotado com uma caixa delimitadora numa única classe, object — o nome refere-se às mais de 110 000 unidades de manutenção de estoque (SKUs) únicas retratadas nas cenas, não a 110 000 classes de deteção. Criado por Eran Goldman et al. para o artigo da CVPR 2019 Precise Detection in Densely Packed Scenes, contém mais de 1,7 milhões de produtos anotados — uma média de cerca de 147 por imagem —, o que o torna uma referência exigente para modelos de visão computacional em ambientes de retalho com grande concentração de produtos.
Assista: Como treinar Ultralytics YOLO26 para detectar todos os produtos em uma prateleira de varejo | SKU-110K 🛒
Principais funcionalidades#
- Deteção de classe única: Cada produto é identificado com uma caixa delimitadora numa única classe,
object(names: {0: object}) — as anotações não incluem rótulos de categoria por SKU. - Densidade extrema de objetos: As imagens de prateleiras de lojas de todo o mundo contêm, em média, cerca de 147 produtos muito próximos uns dos outros, muitas vezes semelhantes ou até idênticos.
- Grande escala: Mais de 110 000 SKUs únicos e mais de 1,7 milhões de caixas delimitadoras anotadas em 11 743 imagens desafiam os detetores de objetos de última geração.
Estrutura do conjunto de dados#
O conjunto de dados SKU-110K está dividido em três subconjuntos, todos com a mesma classe object:
| Divisão | Imagens | Descrição |
|---|---|---|
| Treinar | 8,219 | Imagens e anotações para treino do modelo |
| Validação | 588 | Imagens reservadas para avaliação durante o treino |
| Teste | 2,936 | Imagens para a avaliação final do modelo treinado |
Aplicações#
O conjunto de dados SKU-110K é amplamente utilizado para treinar e avaliar modelos de aprendizagem profunda em tarefas de deteção de objetos, sobretudo em cenas com grande concentração de objetos, como as prateleiras de lojas. Entre as suas aplicações estão:
- Gestão de inventário e automação no retalho
- Reconhecimento de produtos em plataformas de comércio eletrónico
- Verificação da conformidade com o planograma
- Sistemas de pagamento autónomo em lojas
- Recolha e triagem robóticas em armazéns
Para anotares as tuas próprias imagens de prateleiras, treinares e gerires conjuntos de dados de deteção no retalho no navegador, executa o fluxo de trabalho completo com a Ultralytics Platform.
YAML do conjunto de dados#
O ficheiro SKU-110K.yaml define a configuração do conjunto de dados — os caminhos dos dados, os nomes das classes e outros metadados. É mantido no repositório da Ultralytics em https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/SKU-110K.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# SKU-110K retail items dataset https://github.com/eg4000/SKU110K_CVPR19 by Trax Retail
# Documentation: https://docs.ultralytics.com/datasets/detect/sku-110k
# Example usage: yolo train data=SKU-110K.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── SKU-110K ← downloads here (13.6 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: SKU-110K # dataset root dir
train: train.txt # train images (relative to 'path') 8219 images
val: val.txt # val images (relative to 'path') 588 images
test: test.txt # test images (optional) 2936 images

# Classes
names:
  0: object

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  import shutil
  from pathlib import Path

  import numpy as np
  import polars as pl

  from ultralytics.utils import TQDM
  from ultralytics.utils.downloads import download
  from ultralytics.utils.ops import xyxy2xywh

  # Download
  dir = Path(yaml["path"])  # dataset root dir
  parent = Path(dir.parent)  # download dir
  urls = ["http://trax-geometry.s3.amazonaws.com/cvpr_challenge/SKU110K_fixed.tar.gz"]
  download(urls, dir=parent)

  # Rename directories
  if dir.exists():
      shutil.rmtree(dir)
  (parent / "SKU110K_fixed").rename(dir)  # rename dir
  (dir / "labels").mkdir(parents=True, exist_ok=True)  # create labels dir

  # Convert labels
  names = "image", "x1", "y1", "x2", "y2", "class", "image_width", "image_height"  # column names
  for d in "annotations_train.csv", "annotations_val.csv", "annotations_test.csv":
      x = pl.read_csv(dir / "annotations" / d, has_header=False, new_columns=names, infer_schema_length=None).to_numpy()  # annotations
      images, unique_images = x[:, 0], np.unique(x[:, 0])
      with open((dir / d).with_suffix(".txt").__str__().replace("annotations_", ""), "w", encoding="utf-8") as f:
          f.writelines(f"./images/{s}\n" for s in unique_images)
      for im in TQDM(unique_images, desc=f"Converting {dir / d}"):
          cls = 0  # single-class dataset
          with open((dir / "labels" / im).with_suffix(".txt"), "a", encoding="utf-8") as f:
              for r in x[images == im]:
                  w, h = r[6], r[7]  # image width, height
                  xywh = xyxy2xywh(np.array([[r[1] / w, r[2] / h, r[3] / w, r[4] / h]]))[0]  # instance
f.write(f"{cls} {xywh[0]:.5f} {xywh[1]:.5f} {xywh[2]:.5f} {xywh[3]:.5f}\n") # write labelUso#
O SKU-110K é transferido automaticamente na primeira vez que treinas e requer cerca de 13,6 GB de espaço livre em disco para as suas 11 743 imagens. O script de transferência também obtém as anotações originais e converte-as para o formato YOLO, o que pode demorar alguns minutos.
Para treinar um modelo YOLO26n no conjunto de dados SKU-110K durante 100 épocas, com tamanho de imagem 640, podes utilizar os seguintes exemplos de código.
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n.pt")  # carregue um modelo pré-treinado (recomendado para treinamento)

# Treinar o modelo
results = model.train(data="SKU-110K.yaml", epochs=100, imgsz=640)
Dados de exemplo e anotações#
As imagens do SKU-110K mostram produtos densamente agrupados em prateleiras de lojas reais, onde dezenas de artigos quase idênticos estão lado a lado. Aqui está um exemplo de imagem com as respetivas anotações:
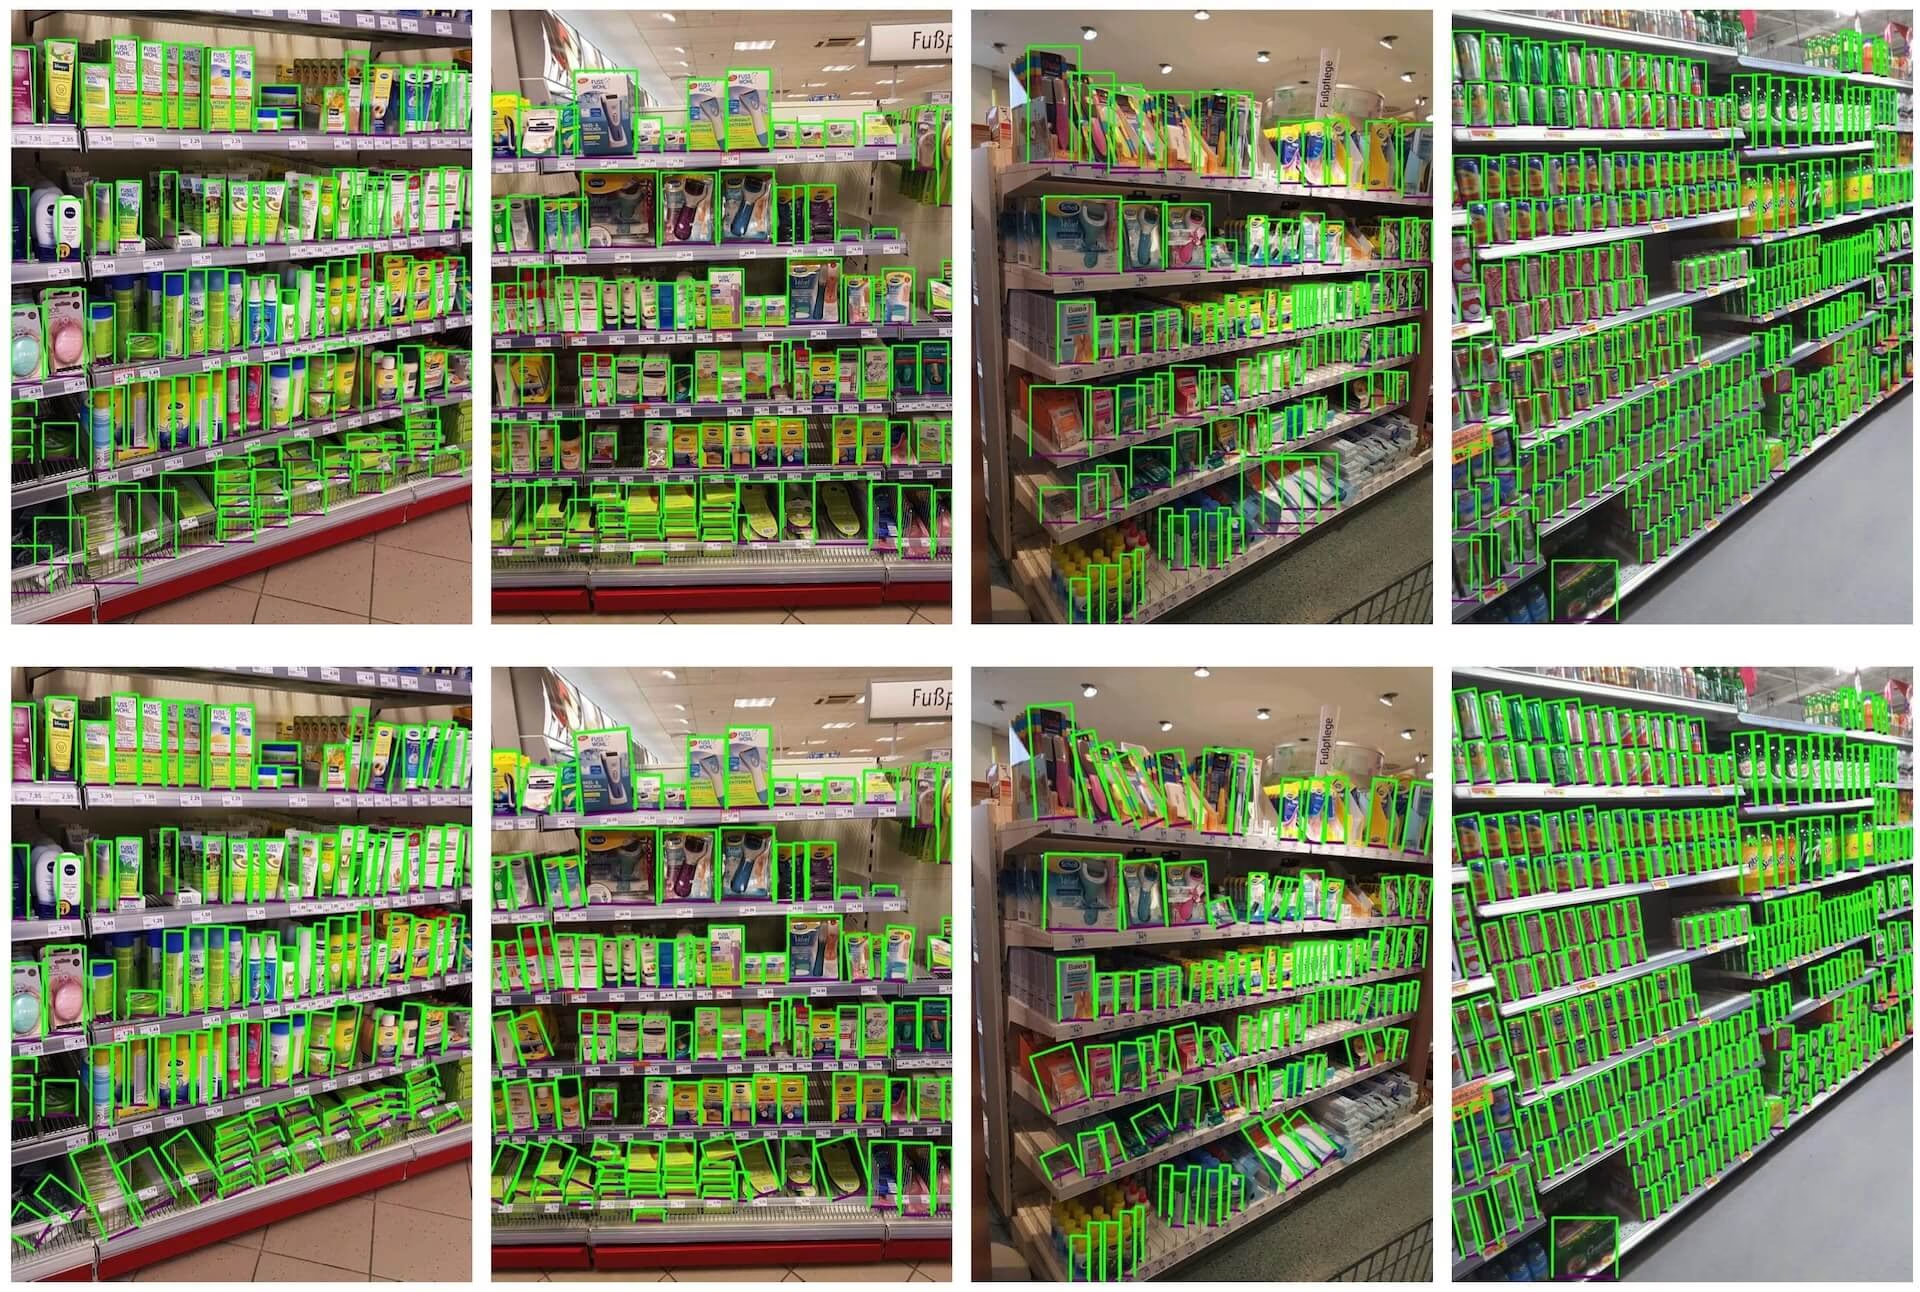
- Imagem de uma prateleira de retalho densamente ocupada: Esta imagem mostra um exemplo de objetos densamente agrupados numa prateleira de retalho. Os objetos estão anotados com caixas delimitadoras da única classe
object.
A disposição densa dos produtos torna o SKU-110K particularmente valioso para desenvolver soluções robustas de visão computacional orientadas para o retalho, uma vez que a elevada quantidade de objetos por imagem coloca os detetores muito além das referências habituais.
Citações e agradecimentos#
Se utilizares o conjunto de dados SKU-110K na tua investigação ou trabalho de desenvolvimento, cita o artigo seguinte:
@inproceedings{goldman2019dense,
  author    = {Eran Goldman and Roei Herzig and Aviv Eisenschtat and Jacob Goldberger and Tal Hassner},
  title     = {Precise Detection in Densely Packed Scenes},
  booktitle = {Proc. Conf. Comput. Vision Pattern Recognition (CVPR)},
  year      = {2019}
}
Gostaríamos de agradecer a Eran Goldman et al. pela criação e manutenção do conjunto de dados SKU-110K, um recurso valioso para a comunidade de investigação em visão computacional. Para obteres mais informações sobre o conjunto de dados SKU-110K e os seus criadores, visita o repositório GitHub do conjunto de dados SKU-110K.
Perguntas frequentes#
O conjunto de dados SKU-110K é um conjunto de dados de detecção de objetos de classe única, com 11.743 imagens de prateleiras de retalho densamente ocupadas, criado por Eran Goldman et al. para o seu artigo da CVPR 2019. Cada produto tem uma caixa delimitadora
object, e as imagens abrangem mais de 110.000 unidades de manutenção de stock (SKUs) únicas, tornando-o um benchmark sólido para detetar objetos em cenas congestionadas e criar sistemas de visão computacional para o retalho.Não. O SKU-110K tem uma única classe: cada produto é anotado com uma caixa delimitadora da classe
object(names: {0: object}). O termo «110K» no nome refere-se ao número de unidades de manutenção de estoque (SKUs) únicas representadas nas imagens, não ao número de classes de deteção.O conjunto de dados SKU-110K contém 11 743 imagens — 8 219 para treino, 588 para validação e 2 936 para teste — e uma única classe de deteção,
object. Consulta a secção Estrutura do conjunto de dados e a configuraçãoSKU-110K.yamlpara obteres mais informações.O SKU-110K ocupa cerca de 13,6 GB e é transferido automaticamente na primeira vez que treinas com
data="SKU-110K.yaml"— não é necessário transferi-lo manualmente. Para explorares opções mais pequenas, consulta a visão geral dos conjuntos de dados de deteção.É simples treinar um modelo YOLO26 com o conjunto de dados SKU-110K. Segue-se um exemplo de treino de um modelo YOLO26n durante 100 épocas, com um tamanho de imagem de 640:
Exemplo de treinofrom ultralytics import YOLO # Carregar um modelo model = YOLO("yolo26n.pt") # carregue um modelo pré-treinado (recomendado para treinamento) # Treinar o modelo results = model.train(data="SKU-110K.yaml", epochs=100, imgsz=640)


Comentários6
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
syafiqmuda
Hi, newbie here, I try to use this dataset to compare and see the accuracy for this dataset with my own, but during training almost all the file were show
Corrupt JPEG data: 786 extraneous bytes before marker 0xd9and sometimesCorrupt JPEG data: premature end of data segment. can I know why? my code look like this:training.py
from ultralytics import YOLO, checks, hub checks() def main(): hub.login('something') model = YOLO('https://hub.ultralytics.com/models/ukr3hHHq88WJASNn3aUz') results = model.train(device=[0,1,2,3]) if __name__ == '__main__': main() Glenn JocherUltralytics
Those messages are PIL JPEG warnings from a handful of non-standard images in SKU-110K; Ultralytics usually auto-recovers/filters these during dataloading via
ultralytics.data.utils.verify_image()(see theverify_image()reference), so if training continues it’s safe to ignore—if it actually crashes, re-download/re-extract the dataset (or re-encode the specific bad JPGs), then delete any*.cacheunder yourlabels/folder and rerun; if you share the text output ofyolo checksplus the full traceback (not a screenshot) we can pinpoint whether it’s data corruption or an environment issue.
ApodiAlsurihi
Hi, thank you for this amazing and detailed explanation! Your work is incredibly helpful and inspiring. I would deeply appreciate it if you could share the trained model after the training process. It would make a significant difference in advancing my project and learning. Thank you so much for your generosity and support!
- Glenn JocherUltralytics
@ApodiAlsurihi thank you for your kind words! Unfortunately, we cannot share trained models directly. However, you can train your own model using the SKU-110K dataset by following the instructions provided in the documentation.
serna01
Are this warnings OK, when training? the batch=0.1 I used it to avoid a memory error. yolo detect train data=SKU-110K.yaml model=yolov8n.pt epochs=50 imgsz=640 batch=0.1
AutoBatch: Using batch-size 2 for CUDA:0 0.49G/3.81G (13%) ✅ train: Scanning /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/labels... 8216 train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_1797.jpg: 3 duplicate labels removed train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_4222.jpg: ignoring corrupt image/label: image file is truncated (23 bytes not processed) train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_882.jpg: ignoring corrupt image/label: image file is truncated (3 bytes not processed) train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_924.jpg: ignoring corrupt image/label: image file is truncated (10 bytes not processed)
al: Scanning /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/labels... 588 ima val: New cache created: /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/labels.cache Corrupt JPEG data: 305 extraneous bytes before marker 0xd9 Corrupt JPEG data: 786 extraneous bytes before marker 0xd9 Plotting labels to runs/detect/train5/labels.jpg... optimizer: 'optimizer=auto' found, ignoring 'lr0=0.01' and 'momentum=0.937' and determining best 'optimizer', 'lr0' and 'momentum' automatically... optimizer: AdamW(lr=0.002, momentum=0.9) with parameter groups 57 weight(decay=0.0), 64 weight(decay=0.0005), 63 bias(decay=0.0) TensorBoard: model graph visualization added ✅ Image sizes 640 train, 640 val Using 8 dataloader workers Logging results to runs/detect/train5 Starting training for 50 epochs...
  Epoch    GPU_mem   box_loss   cls_loss   dfl_loss  Instances       Size
   1/50      1.14G      2.504      3.041       1.53        378        640:   5Corrupt JPEG data: premature end of data segment
   1/50      1.15G      2.382      2.658      1.454        331        640:   7Corrupt JPEG data: 562 extraneous bytes before marker 0xd9
   1/50      1.42G      2.273      2.314      1.382        314        640:  11Corrupt JPEG data: bad Huffman code
   1/50      1.42G      2.266      2.295      1.378        578        64       1/50      1.42G      2.266      2.293      1.377        678        64       1/50      1.42G      2.266      2.293      1.377        678        64       1/50      1.42G      2.265      2.292      1.377        723        64       1/50      1.42G      2.265      2.292      1.377        723        64       1/50      1.42G      2.266       2.29      1.377        695        64       1/50      1.42G      2.266          1/50      1.42G      2.255      2.2       1/50      1.42G      2.254      2.247       1.3       1/50      1       1/50              1/50                          1/50      1.42G      2.232      2.187      1.358        608        640:  13Corrupt JPEG data: bad Huffman code
   1/50      1.42G      2.216      2.138      1.347        437        640:  14Corrupt JPEG data: premature end of data segment
   1/50      1.42G      2.164      1.993      1.318        478        640:  17Corrupt JPEG data: 41 extraneous bytes before marker 0xd9
   1/50      1.42G      2.157      1.967      1.312        308        640:  17Corrupt JPEG data: premature end of data segment
   1/50      1.42G      2.011       1.61      1.239        173        640:  30Corrupt JPEG data: premature end of data segment
   1/50      1.42G      1.987      1.556      1.227        461        640:  33Corrupt JPEG data: 96 extraneous bytes before marker 0xd9
   1/50      1.42G      1.978      1.537      1.223        214        640:  34Corrupt JPEG data: bad Huffman code
   1/50      1.42G      1.959      1.497      1.215        250        640:  37Corrupt JPEG data: bad Huffman code
   1/50      1.42G      1.915      1.403      1.197        500        640:  46Corrupt JPEG data: premature end of data segment
   1/50      1.42G      1.888      1.345      1.185        616        640:  52Corrupt JPEG data: premature end of data segment
Thanks.
- Glenn JocherUltralytics
@serna01 the warnings you see are generally okay and indicate that the training process is handling issues like duplicate labels and corrupt images. Using
batch=0.1to avoid memory errors is fine, but consider adjusting your batch size to better utilize your GPU memory. If the warnings persist or cause issues, ensure you're using the latest version of the package. For more details on the SKU-110k dataset, visit SKU-110k Dataset Documentation.