Ultralytics YOLO26 na NVIDIA Jetson usando DeepStream SDK e TensorRT#
Assista: Como usar modelos Ultralytics YOLO26 com NVIDIA DeepStream no Jetson Orin NX 🚀
Este guia abrangente apresenta uma explicação detalhada sobre como implementar o Ultralytics YOLO26 em dispositivos NVIDIA Jetson usando DeepStream SDK e TensorRT. Aqui, usamos TensorRT para maximizar o desempenho da inferência na plataforma Jetson.
Este guia explica a configuração do DeepStream para YOLO26, a calibração INT8, a configuração de vários fluxos e os resultados dos benchmarks.
Este guia foi testado com o NVIDIA Jetson Orin Nano Super Developer Kit executando a versão JetPack JP6.1, o Seeed Studio reComputer J4012, baseado no NVIDIA Jetson Orin NX de 16 GB e executando a versão JetPack JP5.1.3, e o Seeed Studio reComputer J1020 v2, baseado no NVIDIA Jetson Nano de 4 GB e executando a versão JetPack JP4.6.4. Espera-se que funcione em toda a linha de hardware NVIDIA Jetson, incluindo os modelos mais recentes e os mais antigos.
O que é o NVIDIA DeepStream?#
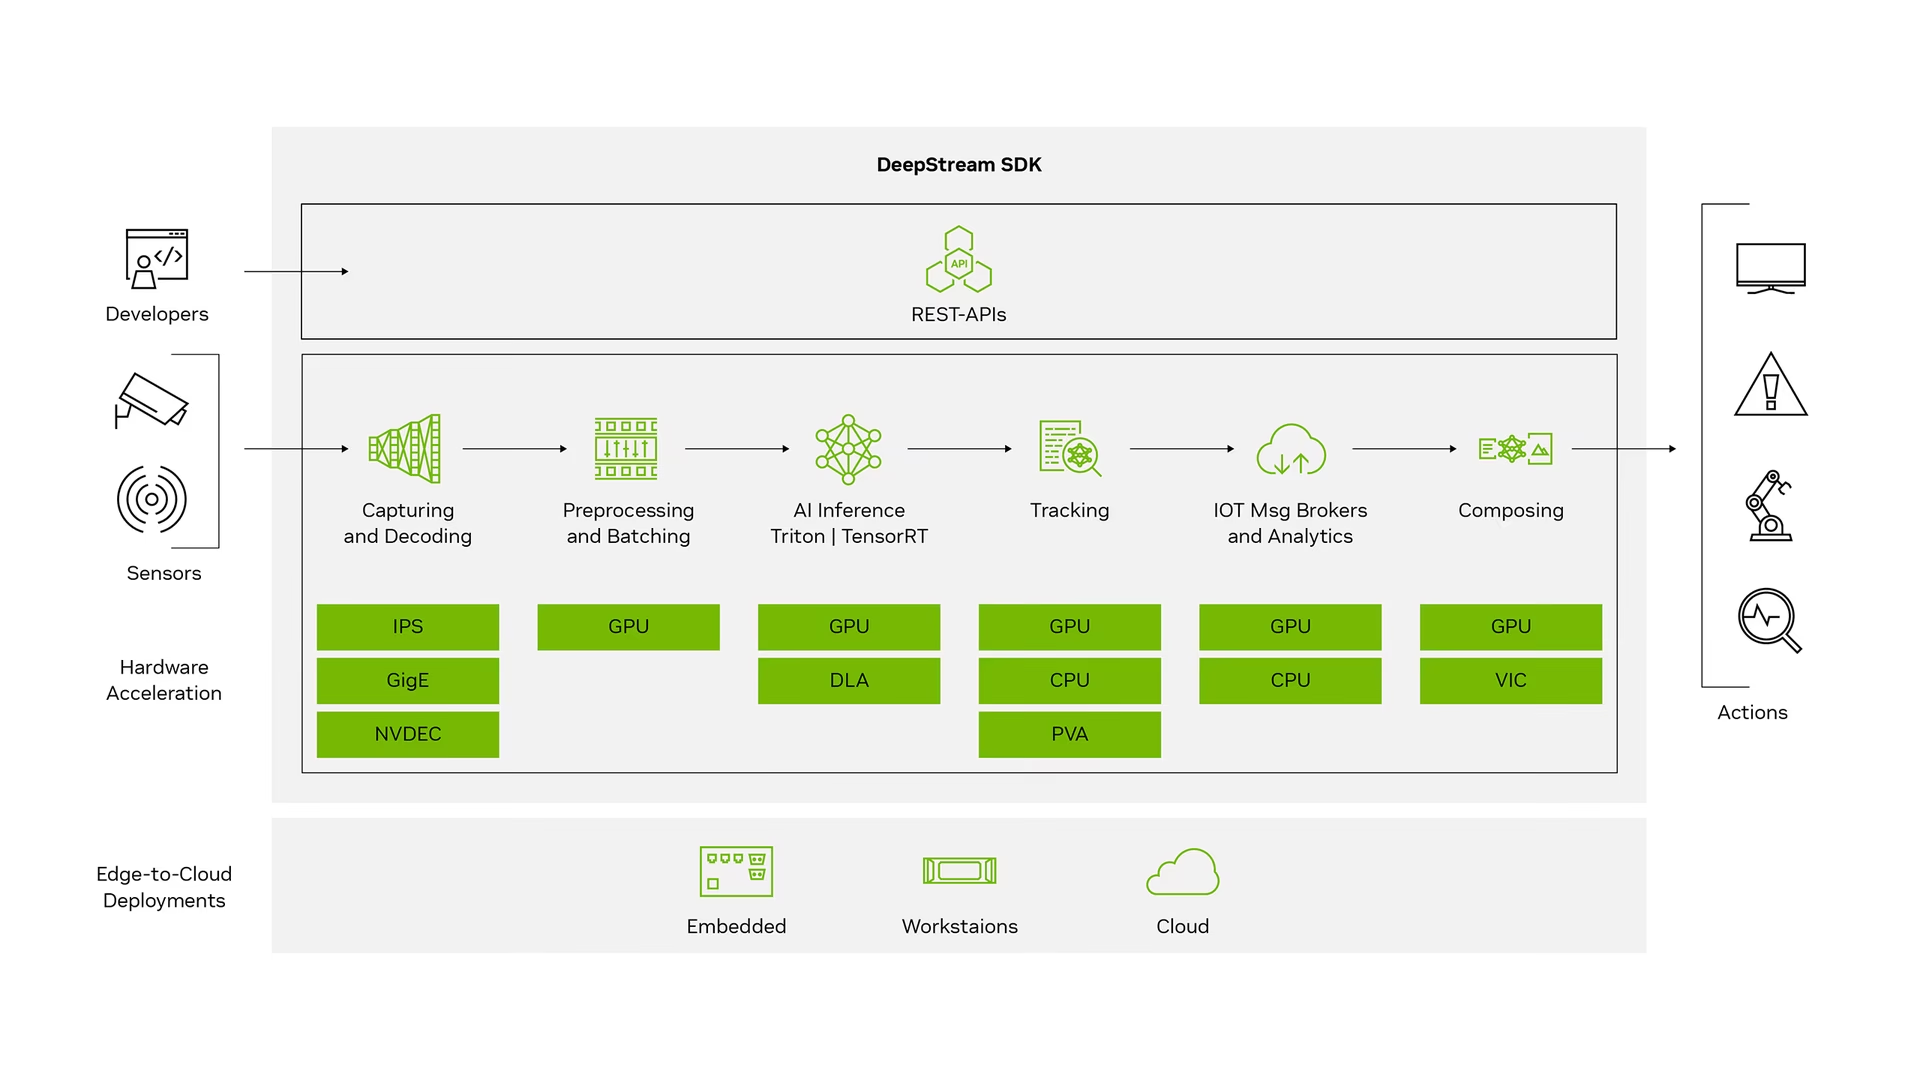
O DeepStream SDK da NVIDIA é um conjunto completo de ferramentas de análise de fluxos, baseado no GStreamer, para processamento multissensor com IA e compreensão de vídeo, áudio e imagens. É ideal para desenvolvedores de IA visual, parceiros de software, startups e fabricantes de equipamento original (OEMs) que criam aplicações e serviços de análise inteligente de vídeo (IVA). Agora, podes criar pipelines de processamento de fluxos que incorporam redes neurais e outras tarefas complexas de processamento, como rastreamento, codificação/descodificação de vídeo e renderização de vídeo. Esses pipelines permitem análises em tempo real de dados de vídeo, imagem e sensores. O suporte multiplataforma do DeepStream oferece uma forma mais rápida e fácil de desenvolver aplicações e serviços de IA visual localmente, na periferia da rede e na nuvem.
Pré-requisitos#
Antes de começares a seguir este guia:
- Consulta a nossa documentação, Guia de início rápido: NVIDIA Jetson com Ultralytics YOLO26, para configurar o teu dispositivo NVIDIA Jetson com o Ultralytics YOLO26
- Instala o DeepStream SDK de acordo com a versão do JetPack
- Para o JetPack 4.6.4, instala o DeepStream 6.0.1
- Para o JetPack 5.1.3, instala o DeepStream 6.3
- Para o JetPack 6.1, instala o DeepStream 7.1
- Para o JetPack 7.1, instala o DeepStream 9.0
Neste guia, usamos o método de pacote Debian para instalar o DeepStream SDK no dispositivo Jetson. Também podes consultar o DeepStream SDK no Jetson (arquivado) para aceder a versões antigas do DeepStream.
Configuração do DeepStream para YOLO26#
Aqui, usamos o repositório GitHub marcoslucianops/DeepStream-Yolo, que inclui suporte do NVIDIA DeepStream SDK para modelos YOLO. Agradecemos o trabalho e as contribuições de marcoslucianops!
-
Instala o Ultralytics com as dependências necessárias
pip install ultralytics onnx onnxslim -
Clona o repositório DeepStream-Yolo
cd ~ git clone https://github.com/marcoslucianops/DeepStream-Yolo -
Transfere um modelo de deteção Ultralytics YOLO26 (.pt) à tua escolha do projeto YOLO26. Aqui, usamos yolo26s.pt.
wget https://github.com/ultralytics/assets/releases/download/v8.4.0/yolo26s.pt
Também podes usar um modelo YOLO26 treinado de forma personalizada.
-
Converte o modelo para ONNX e escreve o ficheiro
labels.txtde onde o DeepStream lê os nomes das classesfrom ultralytics import YOLO model = YOLO("yolo26s.pt") model.export(format="onnx", nms=False, agnostic_nms=True) # cria 'yolo26s.onnx' with open("labels.txt", "w") as f: f.write("\n".join(model.names.values()))
nms=False exporta a cabeça sem NMS, e agnostic_nms=True mantém uma única classe por deteção para que cluster-mode=4 (sem agrupamento) na configuração do DeepStream não desenhe duas vezes a mesma caixa. Adiciona imgsz=1280 para alterar o tamanho da inferência (predefinição: 640), batch=4 para um tamanho de lote de 4 (o lote exportado é estático, por isso tem de corresponder a batch-size na configuração do DeepStream) e opset=12 para TensorRT 8.2 ou anterior (DeepStream 6.0.1 e anteriores). Consulta a lista completa de argumentos de exportação.
-
Copia o ficheiro de modelo gerado
.onnxe o ficheirolabels.txtpara a pastaDeepStream-Yolocp yolo26s.onnx labels.txt ~/DeepStream-Yolo cd ~/DeepStream-Yolo -
Define a versão do CUDA de acordo com a versão do JetPack instalada
Para o JetPack 4.6.4:
export CUDA_VER=10.2Para o JetPack 5.1.3:
export CUDA_VER=11.4Para o JetPack 6.1:
export CUDA_VER=12.6Para o JetPack 7.1:
export CUDA_VER=13.0 -
Compila a biblioteca
make -C nvdsinfer_custom_impl_Yolo clean && make -C nvdsinfer_custom_impl_Yolo -
Edita o ficheiro
config_infer_primary_yolo26.txtde acordo com o teu modelo (para YOLO26s com 80 classes)[property] ... onnx-file=yolo26s.onnx ... num-detected-classes=80 ... parse-bbox-func-name=NvDsInferParseYolo ...
O YOLO26 redimensiona a entrada com preenchimento central e é executado sem NMS. Para obter a melhor precisão, adiciona o seguinte à secção [property] de config_infer_primary_yolo26.txt:
[property]
...
maintain-aspect-ratio=1
symmetric-padding=1
cluster-mode=4
...-
Edita o ficheiro
deepstream_app_config... [primary-gie] ... config-file=config_infer_primary_yolo26.txt -
Também podes alterar a origem do vídeo no ficheiro
deepstream_app_config. Aqui, é carregado um ficheiro de vídeo predefinido... [source0] ... uri=file:///opt/nvidia/deepstream/deepstream/samples/streams/sample_1080p_h264.mp4
Executa a inferência#
deepstream-app -c deepstream_app_config.txtA geração do ficheiro do mecanismo TensorRT demorará bastante tempo antes de a inferência começar. Por isso, tem paciência.
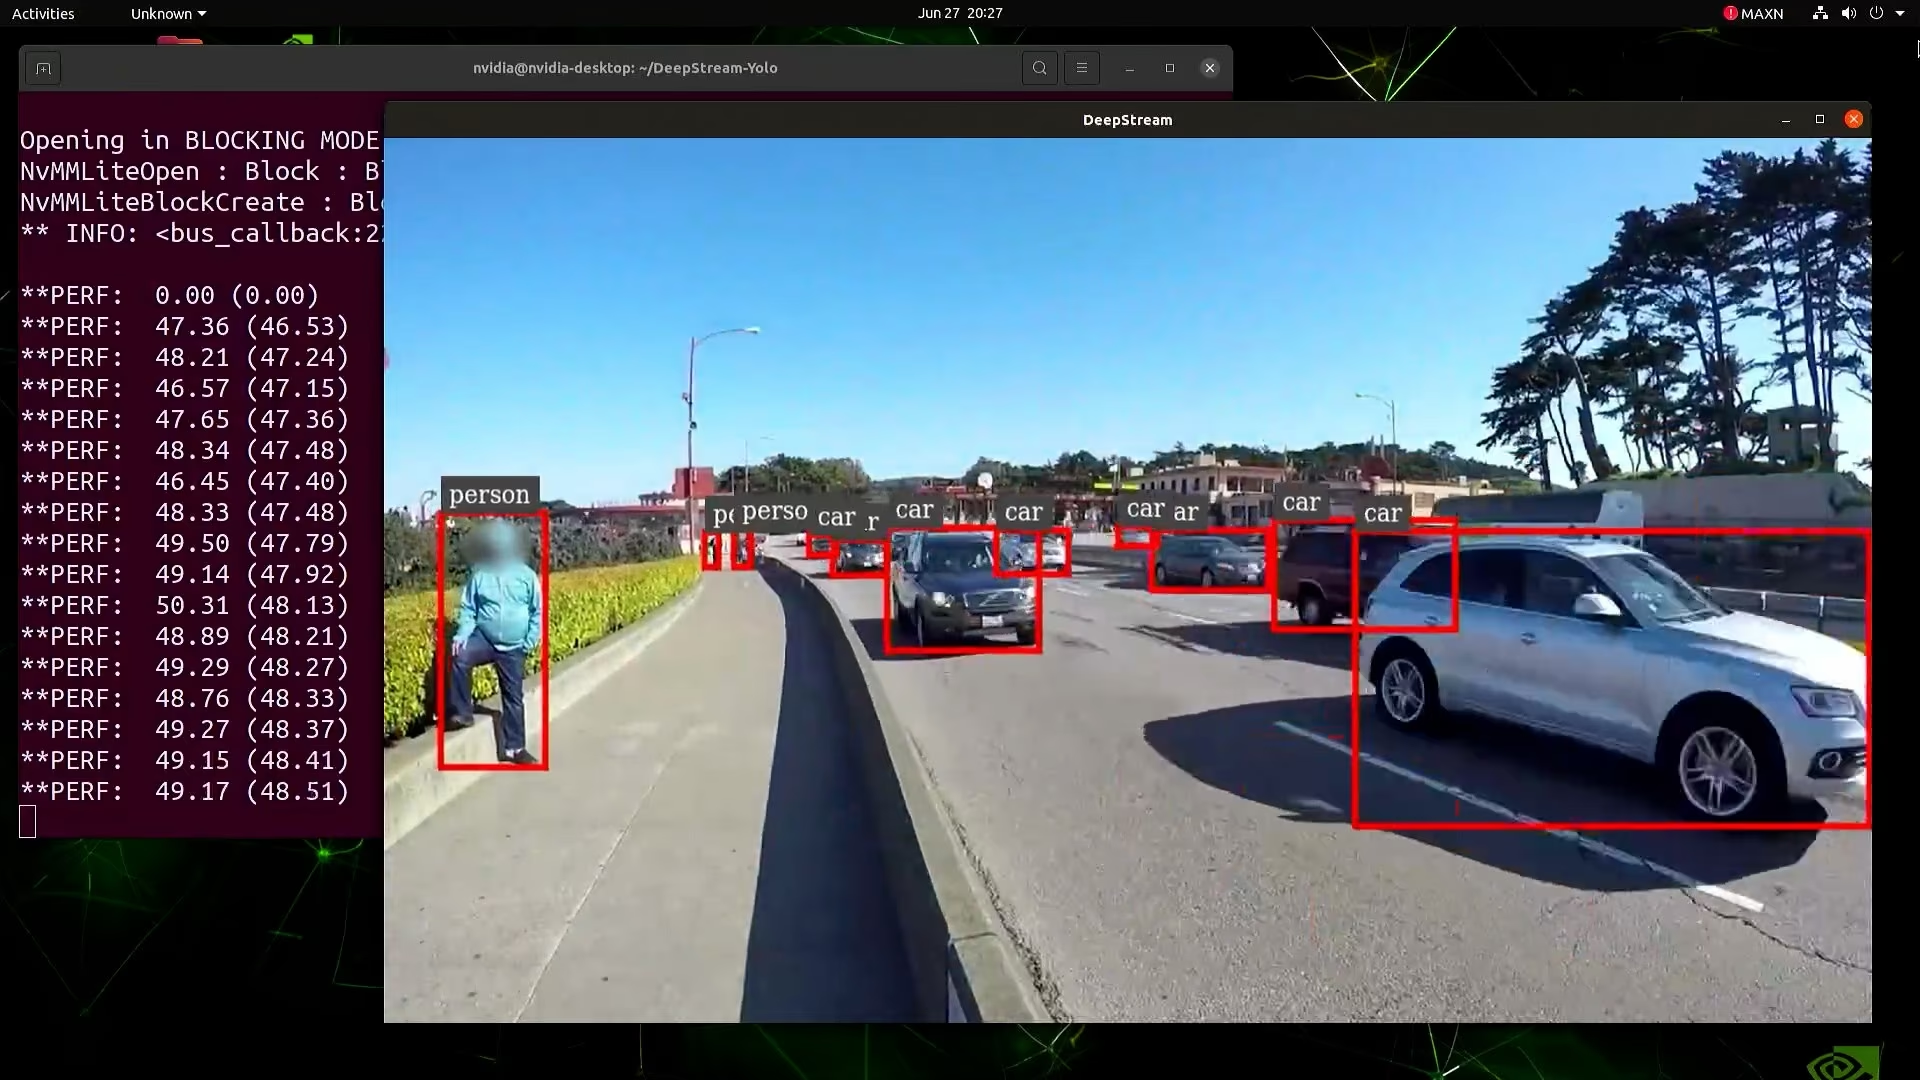
Se quiseres converter o modelo para precisão FP16, basta definir model-engine-file=model_b1_gpu0_fp16.engine e network-mode=2 dentro de config_infer_primary_yolo26.txt
Calibração INT8#
Se quiseres usar precisão INT8 para a inferência, tens de seguir estes passos:
Atualmente, INT8 não funciona com TensorRT 10.x. Esta secção do guia foi testada com TensorRT 8.x, que deverá funcionar.
-
Define a variável de ambiente
OPENCVexport OPENCV=1 -
Compila a biblioteca
make -C nvdsinfer_custom_impl_Yolo clean && make -C nvdsinfer_custom_impl_Yolo -
Para o conjunto de dados COCO, transfere o val2017, extrai-o e move-o para a pasta
DeepStream-Yolo -
Cria um novo diretório para as imagens de calibração
mkdir calibration -
Executa o seguinte para selecionar 1000 imagens aleatórias do conjunto de dados COCO para a calibração
for jpg in $(ls -1 val2017/*.jpg | sort -R | head -1000); do
  cp ${jpg} calibration/
done
A NVIDIA recomenda pelo menos 500 imagens para obter uma boa precisão. Neste exemplo, são selecionadas 1000 imagens para obter maior precisão (mais imagens = maior precisão). Podes definir esse valor com head -1000. Por exemplo, para 2000 imagens, usa head -2000. Este processo pode demorar bastante tempo.
-
Cria o ficheiro
calibration.txtcom todas as imagens selecionadasrealpath calibration/*jpg > calibration.txt -
Define as variáveis de ambiente
export INT8_CALIB_IMG_PATH=calibration.txt
export INT8_CALIB_BATCH_SIZE=1
Valores mais altos de INT8_CALIB_BATCH_SIZE resultam em maior precisão e numa calibração mais rápida. Define o valor de acordo com a memória da tua GPU.
-
Atualiza o ficheiro
config_infer_primary_yolo26.txtDe
...
model-engine-file=model_b1_gpu0_fp32.engine
#int8-calib-file=calib.table
...
network-mode=0
...
Para
...
model-engine-file=model_b1_gpu0_int8.engine
int8-calib-file=calib.table
...
network-mode=1
...
Executa a inferência INT8#
Executa o mesmo comando para criar o mecanismo INT8 e iniciar a inferência:
deepstream-app -c deepstream_app_config.txtConfiguração de vários fluxos#
Assista: Como executar inferência em vários fluxos com Ultralytics YOLO26 usando NVIDIA DeepStream no Jetson Orin 🚀
Para configurar vários fluxos numa única aplicação DeepStream, faz as seguintes alterações no ficheiro deepstream_app_config.txt:
-
Altera as linhas e as colunas para criar uma grelha de visualização de acordo com o número de fluxos pretendido. Por exemplo, para 4 fluxos, podemos adicionar 2 linhas e 2 colunas.
[tiled-display] rows=2 columns=2 -
Adiciona um grupo
[sourceN]separado para cada fluxo, cada um com o seu própriourienum-sources=1.[source0] enable=1 type=3 uri=file:///path/to/video1.mp4 num-sources=1 [source1] enable=1 type=3 uri=file:///path/to/video2.mp4 num-sources=1 [source2] enable=1 type=3 uri=file:///path/to/video3.mp4 num-sources=1 [source3] enable=1 type=3 uri=file:///path/to/video4.mp4 num-sources=1
Executa a inferência com vários fluxos#
Executa o mesmo comando para iniciar todos os fluxos na visualização em mosaico:
deepstream-app -c deepstream_app_config.txt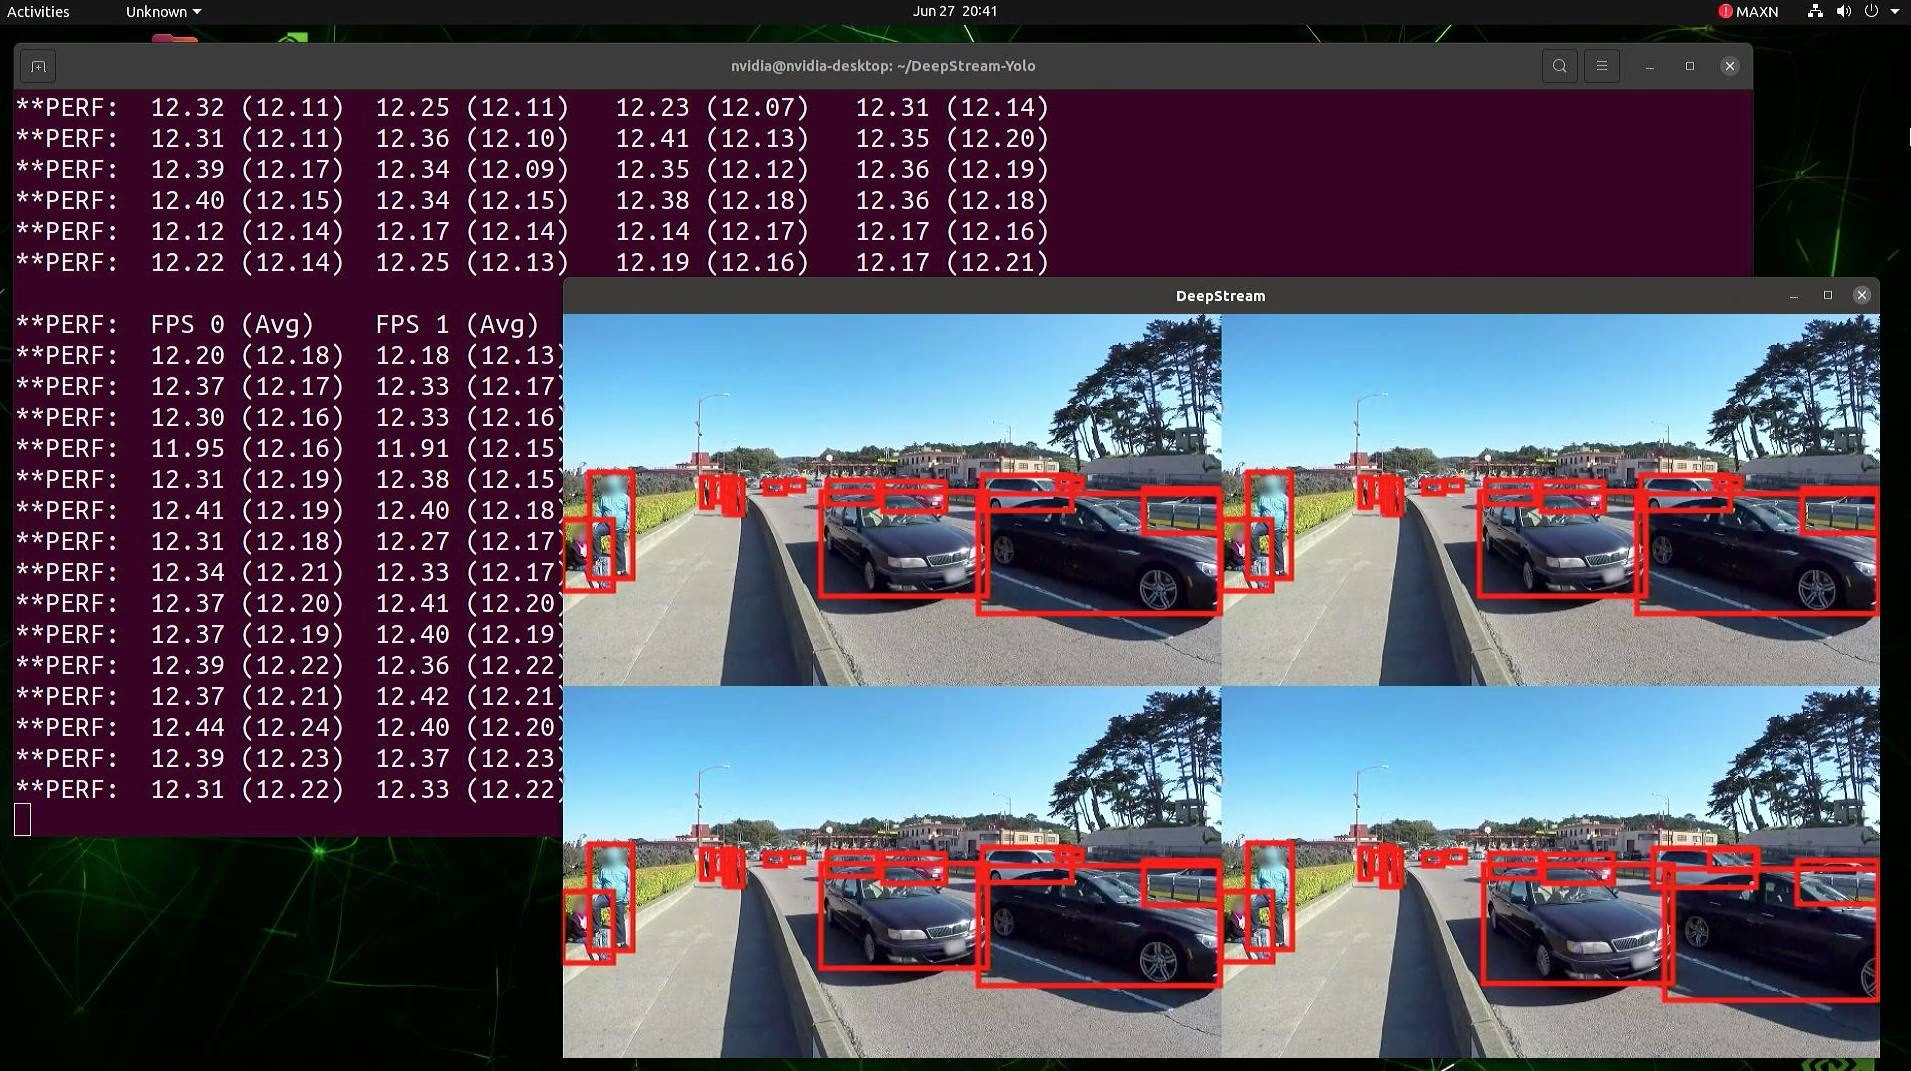
Resultados dos benchmarks#
Os seguintes benchmarks resumem o desempenho dos modelos YOLO11 com diferentes níveis de precisão do TensorRT, usando um tamanho de entrada de 640x640 no NVIDIA Jetson Orin NX de 16 GB. O YOLO26 usa o mesmo fluxo de trabalho de exportação e inferência do DeepStream descrito acima.
Gráfico comparativo#
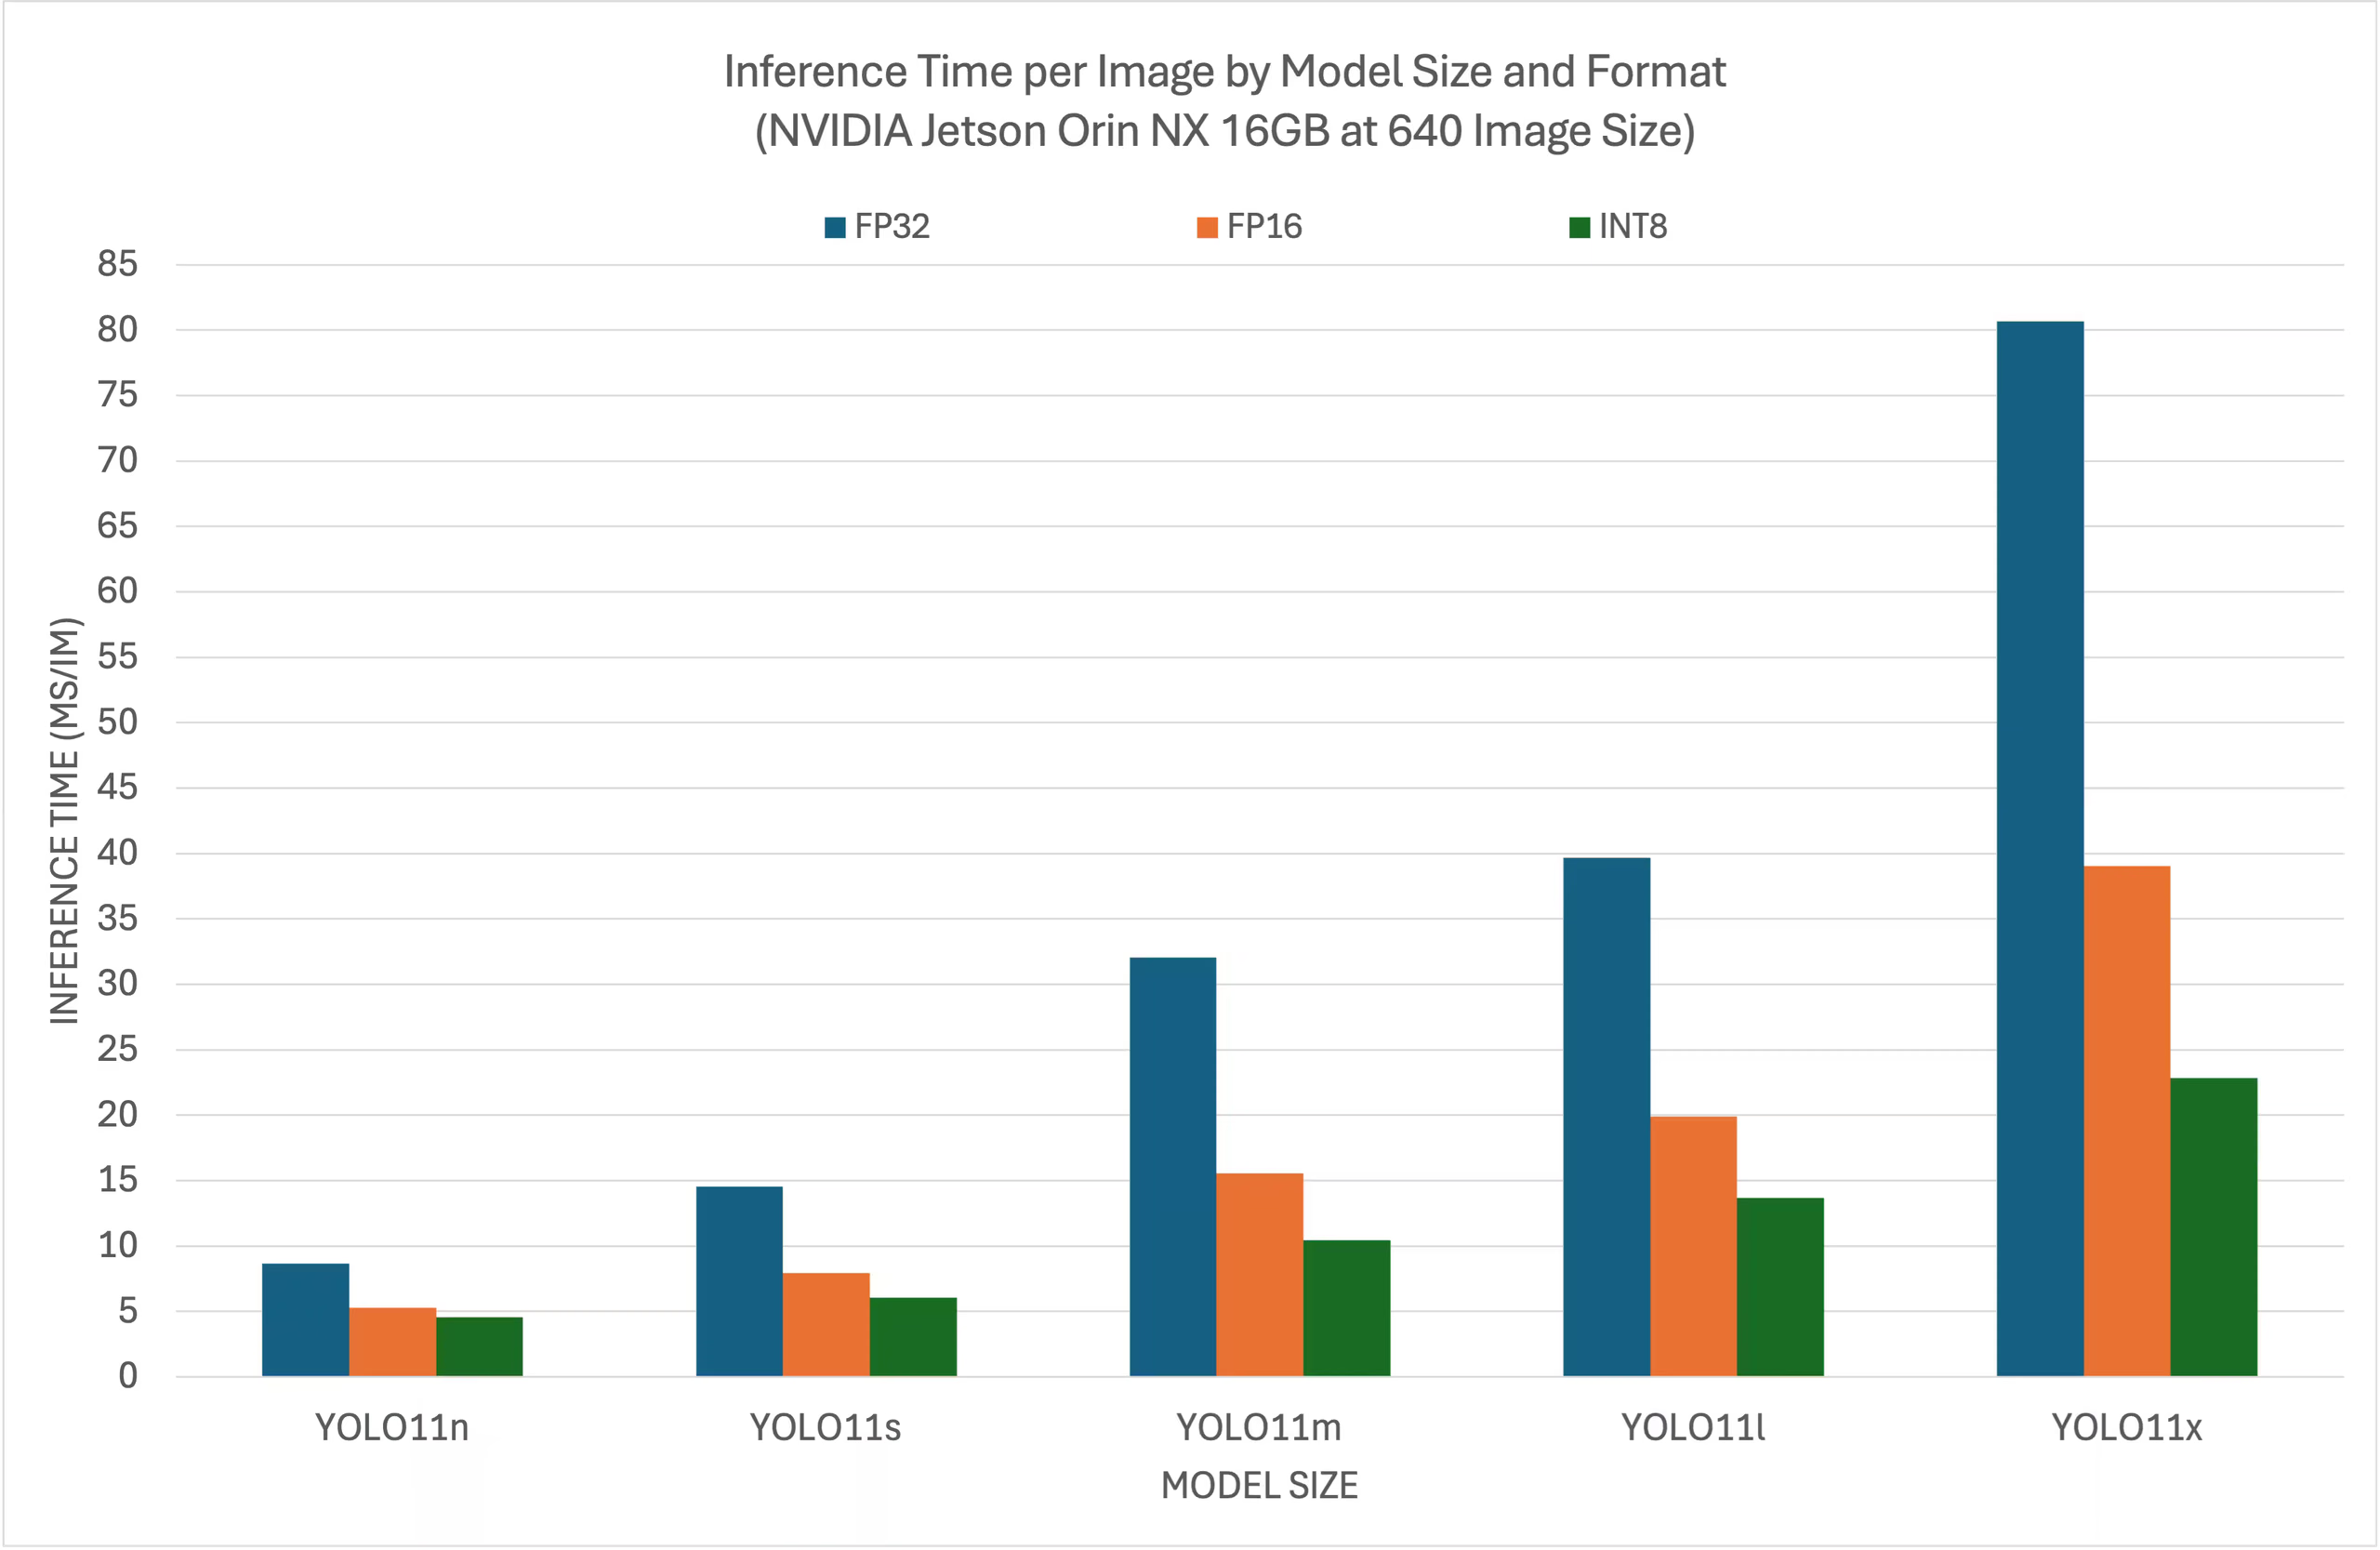
Tabela comparativa detalhada#
| Formato | Status | Tempo de inferência (ms/im) |
|---|---|---|
| TensorRT (FP32) | ✅ | 8.64 |
| TensorRT (FP16) | ✅ | 5.27 |
| TensorRT (INT8) | ✅ | 4.54 |
Agradecimentos#
Este guia foi criado inicialmente pelos nossos amigos da Seeed Studio, Lakshantha e Elaine.
Perguntas frequentes#
Para configurar o Ultralytics YOLO26 num dispositivo NVIDIA Jetson, primeiro tens de instalar o DeepStream SDK compatível com a tua versão do JetPack. Segue o guia passo a passo do nosso Guia de início rápido para configurar o NVIDIA Jetson para a implementação do YOLO26.
Usar TensorRT com YOLO26 otimiza o modelo para inferência, reduzindo significativamente a latência e melhorando o débito em dispositivos NVIDIA Jetson. O TensorRT proporciona inferência de aprendizagem profunda de alto desempenho e baixa latência através da fusão de camadas, da calibração de precisão e da otimização automática de kernels. Isto permite uma execução mais rápida e eficiente, particularmente útil para aplicações em tempo real, como análise de vídeo e máquinas autónomas.
Sim, o guia para implementar o Ultralytics YOLO26 com DeepStream SDK e TensorRT é compatível com toda a linha NVIDIA Jetson. Isto inclui dispositivos como o Jetson Orin NX de 16 GB com JetPack 5.1.3 e o Jetson Nano de 4 GB com JetPack 4.6.4. Consulta a secção Configuração do DeepStream para YOLO26 para ver as instruções detalhadas.
Exporta o modelo com a cabeça sem NMS usando o exportador Ultralytics e escreve o ficheiro
labels.txtde onde o DeepStream lê os nomes das classes:from ultralytics import YOLO model = YOLO("yolo26s.pt") model.export(format="onnx", nms=False, agnostic_nms=True) # cria 'yolo26s.onnx' with open("labels.txt", "w") as f: f.write("\n".join(model.names.values()))Adiciona
opset=12para TensorRT 8.2 ou anterior (DeepStream 6.0.1 e anteriores). Para mais detalhes sobre a conversão de modelos, consulta a nossa secção de exportação de modelos.Para executar inferência INT8, calibra o modelo com um conjunto representativo de imagens e muda a configuração do DeepStream para o modo INT8. Transfere as imagens COCO val2017, seleciona cerca de 1000 imagens de calibração, define as variáveis de ambiente
INT8_CALIB_IMG_PATHeINT8_CALIB_BATCH_SIZEe, em seguida, atualizaconfig_infer_primary_yolo26.txtcommodel-engine-file=model_b1_gpu0_int8.engine,int8-calib-file=calib.tableenetwork-mode=1. Consulta a secção Calibração INT8 para ver todas as etapas. Atualmente, INT8 requer TensorRT 8.x.Para processar vários fluxos numa única aplicação DeepStream, edita o ficheiro
deepstream_app_config.txtpara adicionar uma grelha de visualização em mosaico e listar cada URI de origem. Definerowsecolumnsem[tiled-display]para criar a grelha, adiciona um grupo[sourceN]separado por fluxo, com os seus própriosurienum-sources=1, e ajusta a grelha ao número de fluxos. Consulta a secção Configuração de vários fluxos para ver um exemplo completo.O desempenho dos modelos YOLO11 no NVIDIA Jetson Orin NX de 16 GB varia consoante os níveis de precisão do TensorRT. Por exemplo, os modelos YOLO11s alcançam:
- Precisão FP32: 14.53 ms/im, 68.8 FPS
- Precisão FP16: 7.91 ms/im, 126 FPS
- Precisão INT8: 6.05 ms/im, 165 FPS
Esses benchmarks destacam a eficiência e a capacidade de usar modelos YOLO11 otimizados para TensorRT no hardware NVIDIA Jetson. Para mais detalhes, consulta a seção Resultados dos benchmarks.