Набор данных xView#
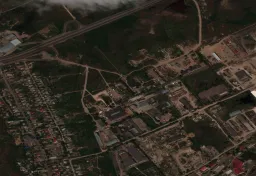
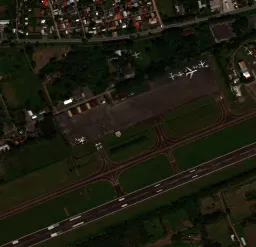
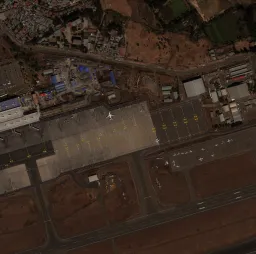
Набор данных xView — один из крупнейших общедоступных бенчмарков спутниковых снимков для обнаружения объектов. Он содержит более 1 млн экземпляров объектов 60 классов, размеченных ограничивающими рамками на снимках WorldView-3 с разрешением 0,3 м и площадью более 1 400 км². Набор был выпущен для соревнования DIUx xView 2018 Национальным агентством геопространственной разведки США (NGA); для его скачивания вручную потребуется около 20,7 ГБ.
Набор данных создан для продвижения четырёх рубежей в области компьютерного зрения:
- Снизить минимальное разрешение для обнаружения объектов.
- Повысить эффективность обучения.
- Обеспечить обнаружение большего числа классов объектов.
- Улучшить обнаружение мелкозернистых классов.
В отличие от таких бенчмарков, как COCO, xView ориентирован на снимки сверху, где объекты намного меньше и расположены плотнее, чем на фотографиях с уровня земли.
Набор данных xView не скачивается автоматически. Зарегистрируйся на сайте соревнования DIUx xView 2018, чтобы скачать train_images.zip (~15 ГБ), train_labels.zip и val_images.zip (~5 ГБ), а затем распакуй их в datasets/xView/, чтобы структура содержала:
datasets/xView/
├── train_images/          # 847 TIF satellite images
├── val_images/            # 282 TIF images (no public labels)
└── xView_train.geojson    # bounding-box annotations
При первом запуске обучения Ultralytics автоматически преобразует аннотации GeoJSON в формат YOLO и разделит размеченные изображения на обучающую и валидационную выборки примерно в пропорции 90/10 — вручную преобразовывать данные не нужно.
Основные особенности#
- Мелкозернистые классы: 60 классов объектов, включающих летательные аппараты, транспортные средства, железнодорожный подвижной состав, морские суда, строительную технику и здания; многие объекты маленькие, редкие и визуально похожие.
- Высокое разрешение: наземное разрешение 0,3 м, снимки сделаны спутниками WorldView-3.
- Плотная разметка: более 1 млн экземпляров объектов на снимках площадью более 1 400 км², все размечены горизонтальными ограничивающими рамками.
- Автоматическое преобразование: скрипт загрузки Ultralytics преобразует исходные метки GeoJSON в формат YOLO и при первом использовании создает разделение на обучающую и валидационную выборки.
Структура набора данных#
Изображения xView — это большие спутниковые сцены в формате TIF; открытые метки доступны только для 847 обучающих изображений, а для валидационного набора соревнования из 282 изображений меток нет. Поэтому конфигурация Ultralytics xView.yaml при первом использовании автоматически разделяет размеченные изображения:
| Подвыборка | Изображения | Описание |
|---|---|---|
| Обучение | ~90% от 847 | Размеченные изображения, перечисленные в autosplit_train.txt; список создается при первом запуске |
| Валидация | ~10% от 847 | Размеченные изображения, перечисленные в autosplit_val.txt и используемые для оценки |
К 60 классам относятся такие детализированные категории, как самолёт с неподвижным крылом, грузовой самолёт, легковой автомобиль, автобус, локомотив, морское судно, экскаватор, здание, ангар для самолётов и резервуар для хранения; полный список приведен ниже в YAML-файле набора данных. При преобразовании исходные идентификаторы классов соревнования (11–94) перенумеровываются в последовательные индексы от 0 до 59.
Применение#
Мелкозернистые классы и съемка с высокого разрешения сверху делают xView стандартным бенчмарком для обучения и оценки моделей глубокого обучения в области дистанционного зондирования. Типичные области применения:
- Военная разведка и оборона
- Городское планирование и развитие
- Мониторинг окружающей среды
- Реагирование на стихийные бедствия и оценка ущерба
- Картографирование инфраструктуры и управление ею
Другие бенчмарки снимков сверху см. в наборе данных VisDrone, ориентированном на беспилотники, и наборе данных DOTA-v2 с ориентированными рамками.
Файл YAML набора данных#
Файл xView.yaml задает конфигурацию набора данных: пути к данным, имена 60 классов и скрипт загрузки, который преобразует аннотации GeoJSON и создает автоматическое разделение. Файл поддерживается в репозитории Ultralytics: https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/xView.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# DIUx xView 2018 Challenge dataset https://challenge.xviewdataset.org by U.S. National Geospatial-Intelligence Agency (NGA)
# --------  Download and extract data manually to `datasets/xView` before running the train command.  --------
# Documentation: https://docs.ultralytics.com/datasets/detect/xview
# Example usage: yolo train data=xView.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── xView ← downloads here (20.7 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: xView # dataset root dir
train: images/autosplit_train.txt # train images (relative to 'path') 90% of 847 train images
val: images/autosplit_val.txt # val images (relative to 'path') 10% of 847 train images

# Classes
names:
  0: Fixed-wing Aircraft
  1: Small Aircraft
  2: Cargo Plane
  3: Helicopter
  4: Passenger Vehicle
  5: Small Car
  6: Bus
  7: Pickup Truck
  8: Utility Truck
  9: Truck
  10: Cargo Truck
  11: Truck w/Box
  12: Truck Tractor
  13: Trailer
  14: Truck w/Flatbed
  15: Truck w/Liquid
  16: Crane Truck
  17: Railway Vehicle
  18: Passenger Car
  19: Cargo Car
  20: Flat Car
  21: Tank car
  22: Locomotive
  23: Maritime Vessel
  24: Motorboat
  25: Sailboat
  26: Tugboat
  27: Barge
  28: Fishing Vessel
  29: Ferry
  30: Yacht
  31: Container Ship
  32: Oil Tanker
  33: Engineering Vehicle
  34: Tower crane
  35: Container Crane
  36: Reach Stacker
  37: Straddle Carrier
  38: Mobile Crane
  39: Dump Truck
  40: Haul Truck
  41: Scraper/Tractor
  42: Front loader/Bulldozer
  43: Excavator
  44: Cement Mixer
  45: Ground Grader
  46: Hut/Tent
  47: Shed
  48: Building
  49: Aircraft Hangar
  50: Damaged Building
  51: Facility
  52: Construction Site
  53: Vehicle Lot
  54: Helipad
  55: Storage Tank
  56: Shipping container lot
  57: Shipping Container
  58: Pylon
  59: Tower

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  import json
  from pathlib import Path
  import shutil

  import numpy as np
  from PIL import Image

  from ultralytics.utils import TQDM
  from ultralytics.data.split import autosplit
  from ultralytics.utils.ops import xyxy2xywhn

  def convert_labels(fname=Path("xView/xView_train.geojson")):
      """Convert xView GeoJSON labels to YOLO format (classes 0-59) and save them as text files."""
      path = fname.parent
      with open(fname, encoding="utf-8") as f:
          print(f"Loading {fname}...")
          data = json.load(f)

      # Make dirs
      labels = path / "labels" / "train"
      shutil.rmtree(labels, ignore_errors=True)
      labels.mkdir(parents=True, exist_ok=True)

      # xView classes 11-94 to 0-59
      xview_class2index = [-1, -1, -1, -1, -1, -1, -1, -1, -1, -1, -1, 0, 1, 2, -1, 3, -1, 4, 5, 6, 7, 8, -1, 9, 10, 11,
                           12, 13, 14, 15, -1, -1, 16, 17, 18, 19, 20, 21, 22, -1, 23, 24, 25, -1, 26, 27, -1, 28, -1,
                           29, 30, 31, 32, 33, 34, 35, 36, 37, -1, 38, 39, 40, 41, 42, 43, 44, 45, -1, -1, -1, -1, 46,
                           47, 48, 49, -1, 50, 51, -1, 52, -1, -1, -1, 53, 54, -1, 55, -1, -1, 56, -1, 57, -1, 58, 59]

      shapes = {}
      for feature in TQDM(data["features"], desc=f"Converting {fname}"):
          p = feature["properties"]
          if p["bounds_imcoords"]:
              image_id = p["image_id"]
              image_file = path / "train_images" / image_id
              if image_file.exists():  # 1395.tif missing
                  try:
                      box = np.array([int(num) for num in p["bounds_imcoords"].split(",")])
                      assert box.shape[0] == 4, f"incorrect box shape {box.shape[0]}"
                      cls = p["type_id"]
                      cls = xview_class2index[int(cls)]  # xView class to 0-59
                      assert 59 >= cls >= 0, f"incorrect class index {cls}"

                      # Write YOLO label
                      if image_id not in shapes:
                          shapes[image_id] = Image.open(image_file).size
                      box = xyxy2xywhn(box[None].astype(float), w=shapes[image_id][0], h=shapes[image_id][1], clip=True)
                      with open((labels / image_id).with_suffix(".txt"), "a", encoding="utf-8") as f:
                          f.write(f"{cls} {' '.join(f'{x:.6f}' for x in box[0])}\n")  # write label.txt
                  except Exception as e:
                      print(f"WARNING: skipping one label for {image_file}: {e}")

  # Download manually from https://challenge.xviewdataset.org
  dir = Path(yaml["path"])  # dataset root dir
  # urls = [
  #     "https://d307kc0mrhucc3.cloudfront.net/train_labels.zip",  # train labels
  #     "https://d307kc0mrhucc3.cloudfront.net/train_images.zip",  # 15G, 847 train images
  #     "https://d307kc0mrhucc3.cloudfront.net/val_images.zip",  # 5G, 282 val images (no labels)
  # ]
  # download(urls, dir=dir)

  # Convert labels
  convert_labels(dir / "xView_train.geojson")

  # Move images
  images = Path(dir / "images")
  images.mkdir(parents=True, exist_ok=True)
  Path(dir / "train_images").rename(dir / "images" / "train")
  Path(dir / "val_images").rename(dir / "images" / "val")

  # Split
autosplit(dir / "images" / "train")Использование#
Для обучения нужно вручную скачать данные, как описано выше, и распаковать их в datasets/xView/; затем преобразование аннотаций и разделение на обучающую и валидационную выборки выполняются автоматически.
Чтобы обучить модель на наборе данных xView в течение 100 эпох с размером изображения 640, используй следующие фрагменты кода. Полный список доступных аргументов см. на странице обучения модели.
from ultralytics import YOLO

# Загрузить модель
model = YOLO("yolo26n.pt")  # загрузить предварительно обученную модель (рекомендуется для обучения)

# Обучить модель
results = model.train(data="xView.yaml", epochs=100, imgsz=640)
Чтобы размечать дополнительные спутниковые снимки и управлять запусками обучения xView в браузере, используй платформу Ultralytics.
Примеры данных и аннотаций#
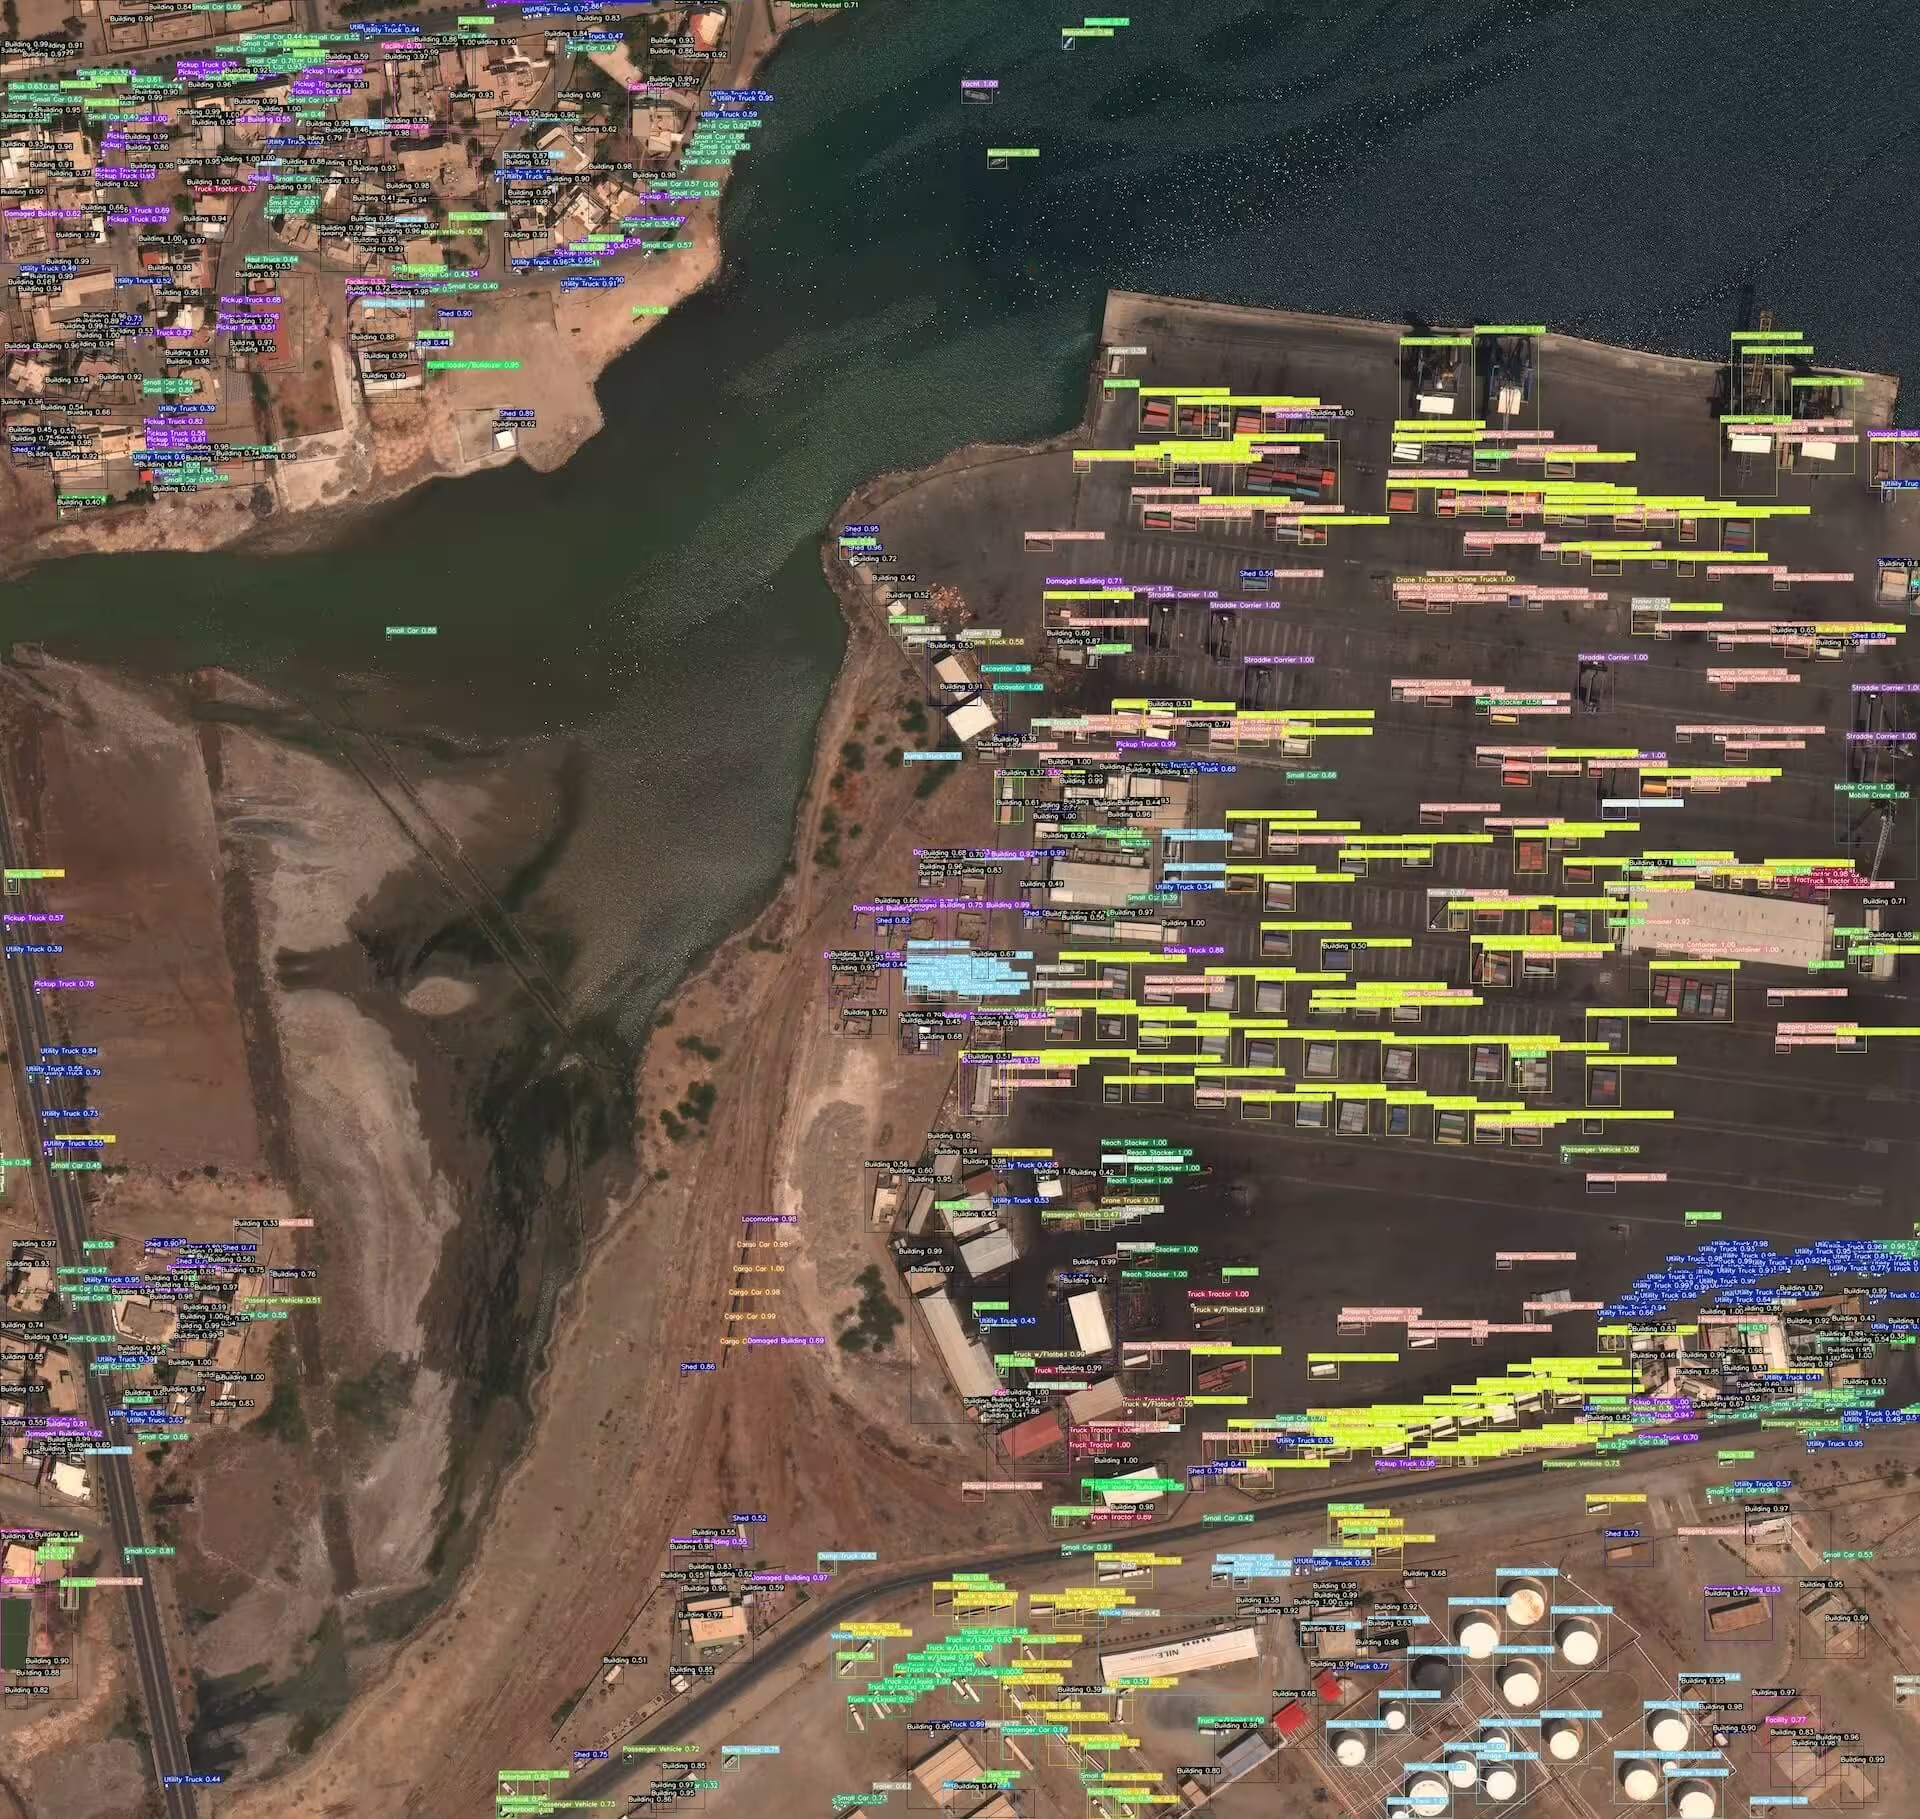
На примере ниже показана типичная сцена xView: спутниковый снимок высокого разрешения, на котором небольшие объекты, например автомобили и здания, размечены ограничивающими рамками. Это наглядно показывает, почему обнаружение объектов на спутниковых снимках требует точной локализации.
Цитирование и благодарности#
Если ты используешь набор данных xView в исследовательской или разработческой работе, укажи в цитировании следующую статью:
@misc{lam2018xview,
      title={xView: Objects in Context in Overhead Imagery},
      author={Darius Lam and Richard Kuzma and Kevin McGee and Samuel Dooley and Michael Laielli and Matthew Klaric and Yaroslav Bulatov and Brendan McCord},
      year={2018},
      eprint={1802.07856},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Мы хотели бы поблагодарить Подразделение инноваций в сфере обороны (DIU) и создателей набора данных xView за ценный вклад в развитие сообщества исследователей компьютерного зрения. Дополнительную информацию см. на сайте набора данных xView.
Часто задаваемые вопросы#
Набор данных xView — это бенчмарк спутниковых снимков, выпущенный для соревнования DIUx xView 2018 Национальным агентством геопространственной разведки США. Он содержит более 1 млн экземпляров объектов 60 мелкозернистых классов на снимках WorldView-3 с разрешением 0,3 м. Набор помогает исследовать обнаружение небольших, редких и детализированных объектов на снимках сверху; такие объекты обнаруживать намного сложнее, чем на фотографиях с уровня земли.
Набор данных xView нужно скачать вручную: зарегистрируйся на сайте соревнования DIUx xView 2018, скачай
train_images.zip(~15 ГБ),train_labels.zipиval_images.zip(~5 ГБ) — всего около 20,7 ГБ — и распакуй их вdatasets/xView/в соответствии со структурой, показанной в предупреждении вверху страницы. При первом запуске обучения Ultralytics автоматически преобразует аннотации GeoJSON в формат YOLO и создает разделение на обучающую и валидационную выборки.В xView есть 847 размеченных обучающих изображений и 282 валидационных изображения без открытых меток; все снимки сделаны спутниками WorldView-3 с разрешением 0,3 м. Аннотации охватывают более 1 млн экземпляров объектов 60 классов. Поскольку общедоступны только обучающие метки, конфигурация Ultralytics
xView.yamlделит 847 размеченных изображений на обучающую и валидационную выборки примерно в пропорции 90/10. Подробнее см. в разделе Структура набора данных.Обучи модель YOLO26n на xView в течение 100 эпох с размером изображения 640:
Пример обученияfrom ultralytics import YOLO # Загрузить модель model = YOLO("yolo26n.pt") # загрузить предварительно обученную модель (рекомендуется для обучения) # Обучить модель results = model.train(data="xView.yaml", epochs=100, imgsz=640)Подробное описание аргументов и настроек см. на странице обучения модели.
Процитируй статью «xView: Objects in Context in Overhead Imagery» (Lam et al., arXiv:1802.07856, 2018); полная запись BibTeX приведена выше в разделе Цитирование и благодарности.