Интеграция Labelbox#
Ultralytics Platform напрямую обрабатывает экспорты Labelbox в формате NDJSON. Не нужно вставлять ключ, поддерживать подключение или обновлять скрипт конвертации: экспортируй данные из Labelbox, загрузи файл — и метки появятся в обычном датасете Platform.
Импорт из Labelbox#
- Экспорт из Labelbox. В проекте разметки открой вкладку Data Rows, выбери All, нажми Export data, укажи поля для включения и подтверди экспорт. В разделе Catalog выбери строки данных и нажми Manage selection > Export data, затем включи Export labels from project и выбери проект — иначе файл будет экспортирован без аннотаций.
- Скачай файл. Labelbox выполняет экспорт в фоновом режиме. Найди его в разделе Notifications и нажми Download, когда экспорт завершится, чтобы сохранить файл
.ndjson. - Загрузи файл в Platform. Создай датасет и загрузи файл
.ndjsonили вставь прямую ссылку на него. Также можно начать с раздела Settings > Integrations > Labelbox. - Обучай модель. Когда обработка завершится, отредактируй аннотации и запусти обучение, как и для любого другого датасета Platform.
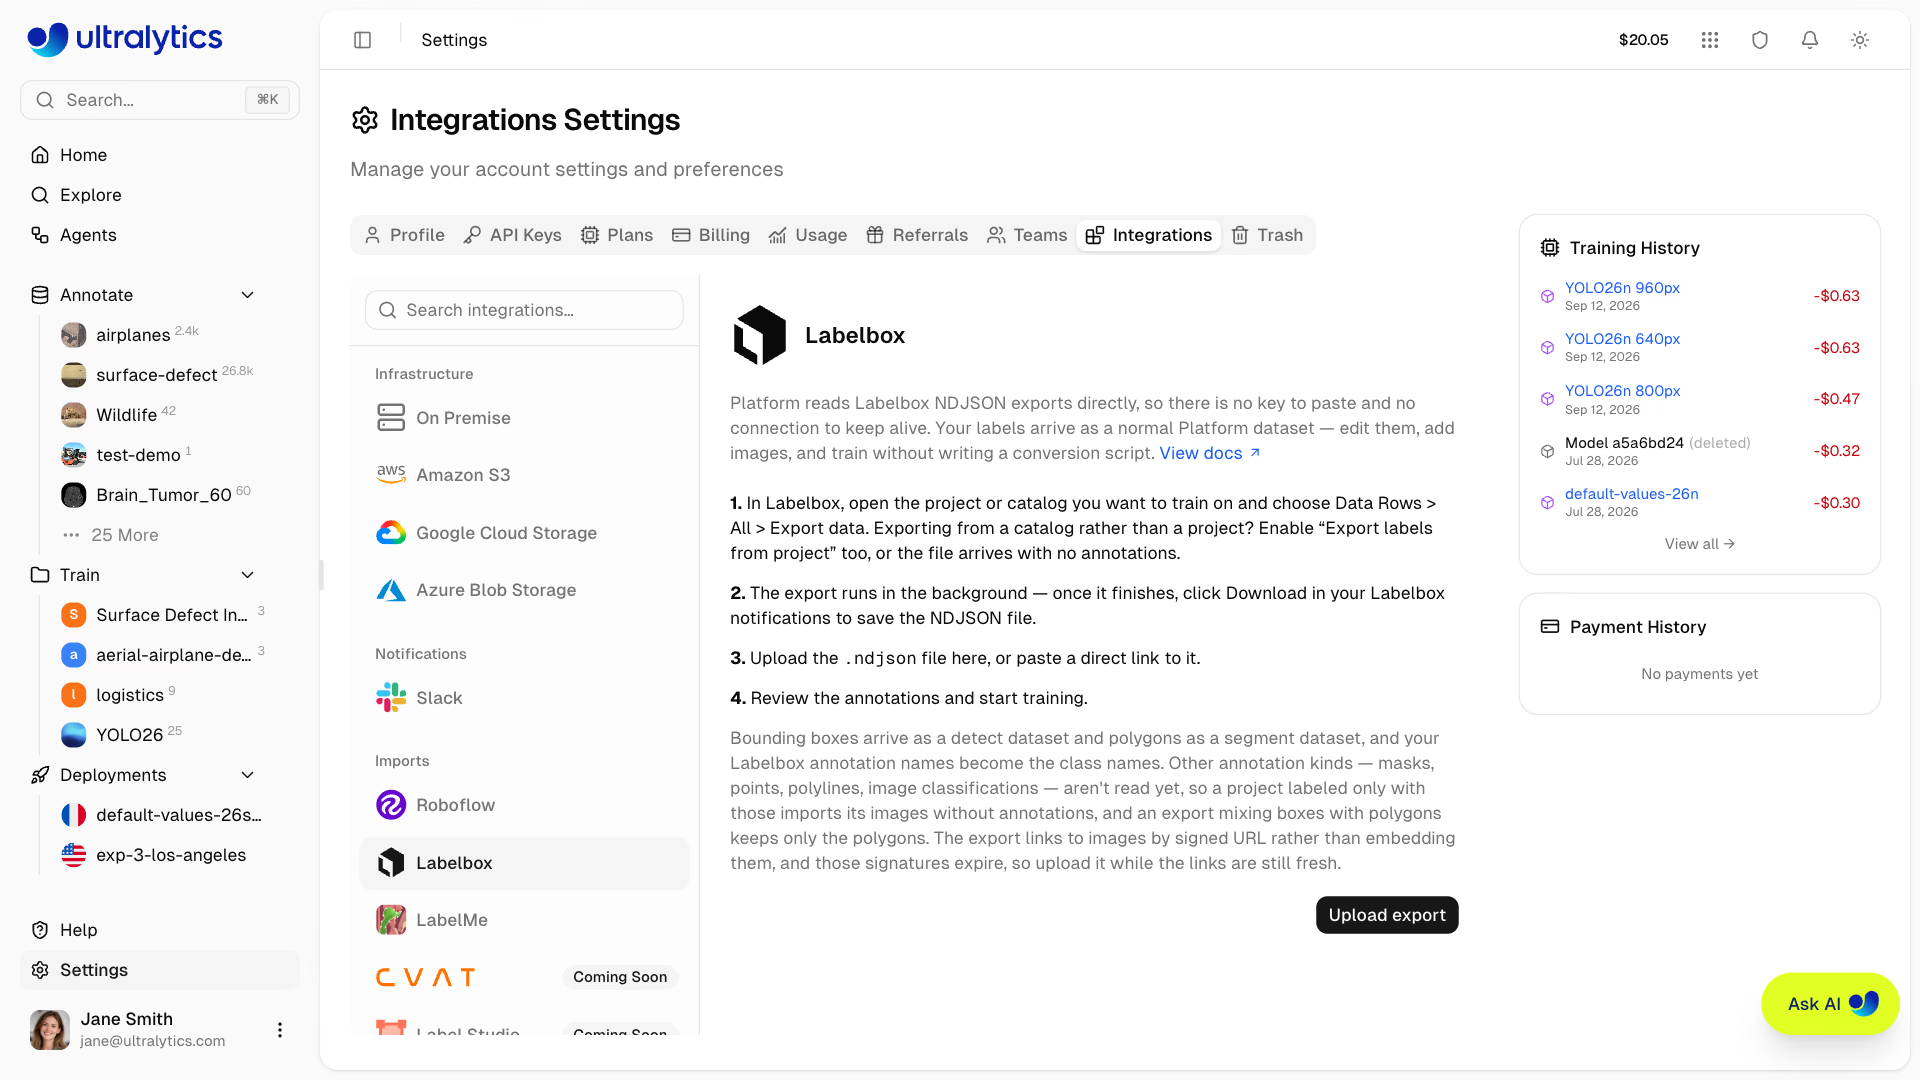
В отличие от CVAT и Label Studio, выбирать формат не нужно — поддерживается собственный формат экспорта Labelbox.
Экспорт с помощью SDK#
Labelbox также позволяет запускать задачу экспорта через Python SDK — это удобнее для воспроизводимого конвейера. Получай данные из задачи потоком и записывай по одному объекту JSON в строке:
import json

import labelbox

client = labelbox.Client(api_key="YOUR_LABELBOX_API_KEY")
export_task = labelbox.ExportTask.get_task(client, "YOUR_EXPORT_TASK_ID")
export_task.wait_till_done()  # попытка получить данные потоком из задачи, которая не находится в состоянии COMPLETE, приводит к ошибке

with open("dataset.ndjson", "w") as f:
f.writelines(json.dumps(data_row.json) + "\n" for data_row in export_task.get_buffered_stream())В NDJSON в каждой строке записан один объект JSON. json.dump(list_of_rows, f) записывает вместо этого единый массив, а Platform пропускает все строки, которые не являются объектами JSON, — в итоге при импорте не находится ни одной строки данных. Используй цикл выше или "\n".join(json.dumps(r) for r in rows).
Что импортируется#
Platform автоматически распознаёт формат Labelbox и сопоставляет ограничивающие рамки и многоугольники с соответствующим типом задачи YOLO:
| Аннотация Labelbox | Импортируется |
|---|---|
| Ограничивающая рамка | Обнаружение |
| Полигон | Сегментация |
| Маска сегментации, точка, ломаная линия, связь, классификация | Пока не поддерживается |
Значение name каждого объекта становится названием класса: например, аннотация "name": "Dog" импортируется как класс Dog, а не как её вариант в нижнем регистре value. Координаты пикселей нормализуются относительно размеров media_attributes, указанных в экспорте, поэтому не удаляй атрибуты медиафайлов из экспорта: изображения из строк без ширины и высоты импортируются без аннотаций. Класс регистрируется только для объектов, которые Platform может импортировать, поэтому инструменты масок, точек и ломаных линий не добавляют в датасет пустые классы. Каждое изображение получает имя из data_row.external_id, затем из global_key, а если в экспорте нет ни одного из этих значений — из имени файла в подписанном URL. Импортируются строки данных с изображениями; строки с видео, текстом и другими типами данных пропускаются. Экспорт каталога без аннотаций импортируется как датасет с изображениями без меток, готовый к разметке в редакторе аннотаций Platform.
Пример строки данных с сокращённым набором полей, которые считывает Platform:
{
    "data_row": {
        "external_id": "000000000307.jpg",
        "global_key": "000000000307.jpg",
        "row_data": "https://storage.labelbox.com/...?Expires=...&Signature=..."
    },
    "media_attributes": { "height": 480, "width": 640, "mime_type": "image/jpeg" },
    "projects": {
        "<project-id>": {
            "labels": [
                {
                    "annotations": {
                        "objects": [
                            {
                                "name": "Dog",
                                "annotation_kind": "ImageBoundingBox",
                                "bounding_box": { "top": 200.0, "left": 407.0, "height": 172.0, "width": 176.0 }
                            }
                        ]
                    }
                }
            ]
        }
    }
}
Все остальные данные в экспорте — embeddings, metadata_fields, attachments, project_details — игнорируются. При экспорте стоит снять выбор с эмбеддингов: в одном примере на них приходилось около четырёх пятых файла, а на поля, которые Platform действительно считывает, — одна пятая.
Сейчас считываются только ограничивающие рамки и многоугольники, причём только из объектных аннотаций: классификации уровня изображения хранятся в другой части экспорта и пропускаются. Если проект размечен исключительно инструментом маски сегментации (кистью), точками, ломаными линиями или классификациями, изображения импортируются без аннотаций, и ошибка не возникает. Это можно проверить на странице датасета: у импортированного датасета с сохранёнными метками рядом с количеством изображений указаны количества изображений с метками и аннотациями, а если метки не сохранились, эти значения не отображаются.
В экспорте Labelbox для ссылки на каждое изображение используется подписанный URL, а срок действия подписи ограничен. Platform скачивает изображения по этим URL и перед началом проверяет часть из них. Если срок действия всех ссылок в экспорте уже истёк, импорт сразу завершится с ошибкой и сообщит причину — повторно экспортируй данные из Labelbox и загрузи новый файл. Если срок действия истёк только у части ссылок, будут импортированы доступные изображения, а остальные будут пропущены, поэтому загружай файл вскоре после экспорта.
Экспорт, содержащий и ограничивающие рамки, и многоугольники, импортируется как датасет сегментации, в котором сохраняется только геометрия многоугольников: аннотации рамками не используются при обучении и не включаются в экспорт версий. Если нужны и рамки, и многоугольники, экспортируй их из отдельных проектов Labelbox. Для обработки многоугольника также требуется не менее трёх точек.
Часто задаваемые вопросы#
Ограничивающие рамки импортируются как датасет обнаружения, а многоугольники — как датасет сегментации. Маски сегментации, точки, ломаные линии, связи и классификации пока не считываются, поэтому изображения из проекта, размеченного только этими инструментами, импортируются без аннотаций.
Platform считывает NDJSON, где в каждой строке находится один объект JSON. Экспорт, сохранённый как единый массив JSON, полностью пропускается. Используй цикл SDK выше или скачай файл через Export data в Labelbox — этот файл уже имеет формат NDJSON.
В экспорте Labelbox изображения указываются по подписанным URL, срок действия которых ограничен. Повторно экспортируй данные из Labelbox и загрузи новый файл вскоре после завершения экспорта.
Нет. Смешанный экспорт импортируется как датасет сегментации, и используются только многоугольники. Если нужны и рамки, и многоугольники, экспортируй их из отдельных проектов Labelbox.