Model Dağıtımı için En İyi Uygulamalar
Giriş#
Model dağıtımı, bir modeli geliştirme aşamasından gerçek dünya uygulamasına taşıyan bilgisayarlı görü projesi adımıdır. Çeşitli model dağıtım seçenekleri vardır: bulut dağıtımı ölçeklenebilirlik ve kolay erişim sağlar, uç dağıtımı modeli veri kaynağına yaklaştırarak gecikmeyi azaltır, yerel dağıtım ise gizlilik ve kontrol sağlar. Doğru stratejiyi seçmek, uygulamanın gereksinimlerine bağlıdır; hız, güvenlik ve ölçeklenebilirliği dengelemen gerekir.
İzle: Yapay zekâ modellerini optimize etme ve dağıtma: en iyi uygulamalar, sorun giderme ve güvenlik konuları
Dağıtım, modelin performansının etkinliğini ve güvenilirliğini önemli ölçüde etkileyebileceğinden, model dağıtırken en iyi uygulamalara uymak da önemlidir. Bu kılavuzda, model dağıtımının sorunsuz, verimli ve güvenli olmasını nasıl sağlayabileceğine odaklanacağız.
Model Dağıtım Seçenekleri#
Bir model eğitildikten, değerlendirildikten ve test edildikten sonra bulut, uç veya yerel cihazlar gibi farklı ortamlarda etkili biçimde dağıtılabilmesi için genellikle belirli biçimlere dönüştürülmesi gerekir.
YOLO26 ile dağıtım gereksinimlerine bağlı olarak modelini çeşitli biçimlere aktarabilirsin. Örneğin, YOLO26'yı ONNX'e aktarmak kolaydır ve modelleri çerçeveler arasında aktarmak için idealdir. Daha fazla entegrasyon seçeneğini keşfetmek ve farklı ortamlarda sorunsuz dağıtım sağlamak için model entegrasyon kataloğumuzu ziyaret et.
Dağıtım Ortamı Seçimi#
Bilgisayarlı görü modelini nereye dağıtacağını seçmek birçok faktöre bağlıdır. Farklı ortamların kendine özgü avantajları ve zorlukları vardır; bu nedenle ihtiyaçlarına en uygun ortamı seçmen önemlidir.
Bulut Dağıtımı#
Bulut dağıtımı, hızla ölçeklenmesi ve büyük miktarda veriyi işlemesi gereken uygulamalar için idealdir. AWS, Google Cloud ve Azure gibi platformlar, modellerini eğitimden dağıtıma kadar kolayca yönetmeni sağlar. Süreç boyunca yardımcı olmak için Amazon SageMaker, Google Vertex AI ve Azure Machine Learning gibi hizmetler sunarlar. Ultralytics Platform, YOLO modellerini 42 küresel bölgede bulunan özel uç noktalara da dağıtır.
Ancak bulutu kullanmak, özellikle yüksek miktarda veri kullanıldığında pahalı olabilir ve kullanıcıların veri merkezlerinden uzakta olması durumunda gecikme sorunlarıyla karşılaşabilirsin. Maliyetleri ve performansı yönetmek için kaynak kullanımını optimize etmek ve veri gizliliği kurallarına uyulduğundan emin olmak önemlidir.
Uç Dağıtımı#
Uç dağıtımı, özellikle internet erişiminin sınırlı olduğu veya hiç olmadığı yerlerde, gerçek zamanlı yanıt ve düşük gecikme gerektiren uygulamalar için uygundur. Modelleri akıllı telefonlar veya IoT cihazları gibi uç cihazlara dağıtmak hızlı işlemeyi ve verilerin yerel kalmasını sağlar; bu da gizliliği artırır. Uca dağıtım, buluta gönderilen veri miktarını azaltarak bant genişliğinden de tasarruf sağlar.
Ancak uç cihazların işlem gücü genellikle sınırlıdır; bu yüzden modellerini optimize etmen gerekir. LiteRT ve NVIDIA Jetson gibi çalışma ortamları ve donanım platformları yardımcı olabilir. Avantajlarına rağmen çok sayıda cihazı sürdürmek ve güncellemek zor olabilir.
Yerel Dağıtım#
Veri gizliliğinin kritik olduğu ya da internet erişiminin güvenilmez veya hiç olmadığı durumlarda yerel dağıtım en iyi seçenektir. Modelleri yerel sunucularda veya masaüstü bilgisayarlarda çalıştırmak tam kontrol sağlar ve verilerini güvende tutar. Sunucu kullanıcıya yakınsa gecikmeyi de azaltabilir.
Ancak yerel ortamda ölçeklendirme zor olabilir ve bakım zaman alabilir. Yerel dağıtımları daha verimli hâle getirmek için kapsayıcılaştırmada Docker, yönetimde ise Kubernetes gibi araçlar yardımcı olabilir. Her şeyin sorunsuz çalışmasını sağlamak için düzenli güncelleme ve bakım gerekir.
Kolaylaştırılmış Dağıtım için Kapsayıcılaştırma#
Konteynerleştirme, modelini ve tüm bağımlılıklarını konteyner adı verilen standart bir birim içinde paketler. Bu teknik, farklı ortamlarda tutarlı performans sağlar ve dağıtım sürecini basitleştirir.
Model Dağıtımında Docker Kullanmanın Avantajları#
Docker, çeşitli nedenlerle makine öğrenmesi dağıtımlarında kapsayıcılaştırma için sektör standardı hâline gelmiştir:
- Ortam tutarlılığı: Docker kapsayıcıları, modelini ve tüm bağımlılıklarını içine alır; geliştirme, test ve üretim ortamlarında tutarlı davranış sağlayarak "benim makinemde çalışıyor" sorununu ortadan kaldırır.
- Yalıtım: Kapsayıcılar uygulamaları birbirinden yalıtarak farklı yazılım sürümleri veya kitaplıklar arasındaki çakışmaları önler.
- Taşınabilirlik: Docker kapsayıcıları, Docker'ı destekleyen her sistemde çalışabilir; böylece modellerini değiştirmeden farklı platformlara dağıtabilirsin.
- Ölçeklenebilirlik: Kapsayıcılar talebe göre kolayca ölçeklendirilebilir; Kubernetes gibi orkestrasyon araçları bu süreci otomatikleştirebilir.
- Sürüm denetimi: Docker imajları sürümlendirilebilir; böylece değişiklikleri takip edebilir ve gerektiğinde önceki sürümlere dönebilirsin.
YOLO26 Dağıtımı için Docker Kullanımı#
YOLO26 modelini konteynerleştirmek için gerekli tüm bağımlılıkları ve yapılandırmaları belirten bir Dockerfile oluşturabilirsin. İşte temel bir örnek:
FROM ultralytics/ultralytics:latest

WORKDIR /app

# Copy your model and any additional files
COPY ./models/yolo26n.pt /app/models/
COPY ./scripts /app/scripts/

# Set up any environment variables
ENV MODEL_PATH=/app/models/yolo26n.pt

# Command to run when the container starts
CMD ["python", "/app/scripts/predict.py"]
Bu yaklaşım, model dağıtımının geliştirme, test ve üretim ortamlarında yeniden üretilebilir ve tutarlı olmasını sağlar.
Model Optimizasyonu Teknikleri#
Bilgisayarlı görü modelini optimize etmek, özellikle uç cihazlar gibi kaynakların sınırlı olduğu ortamlara dağıtım yaparken modelin verimli çalışmasına yardımcı olur. İşte modelini optimize etmek için temel teknikler.
Model Budama#
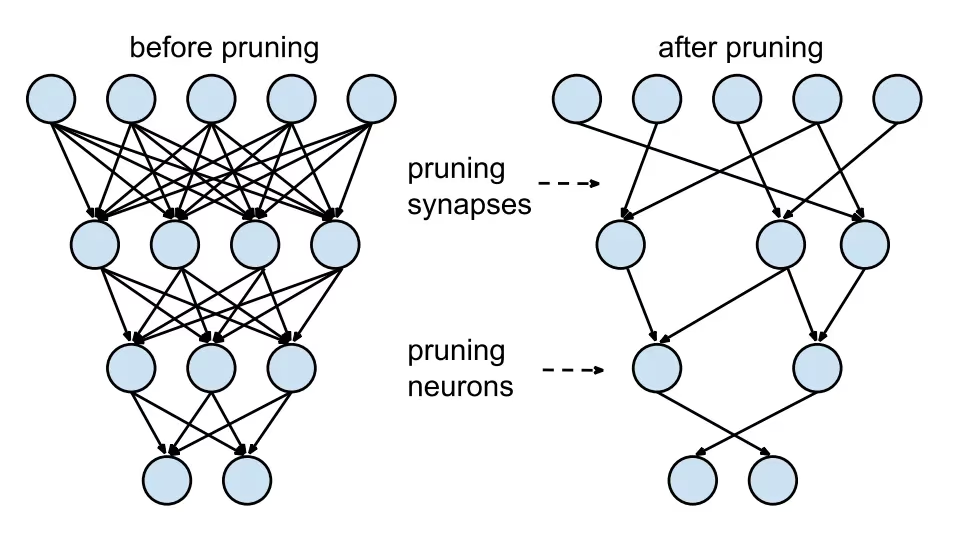
Budama, nihai çıktıya çok az katkıda bulunan ağırlıkları kaldırarak modelin boyutunu küçültür. Doğruluğu önemli ölçüde etkilemeden modeli küçültür ve hızlandırır. Budama, gereksiz parametrelerin belirlenip kaldırılmasını içerir ve böylece daha az işlem gücü gerektiren daha hafif bir model ortaya çıkar. Kaynakları sınırlı cihazlara model dağıtmak için özellikle kullanışlıdır.
Model Kuantizasyonu#
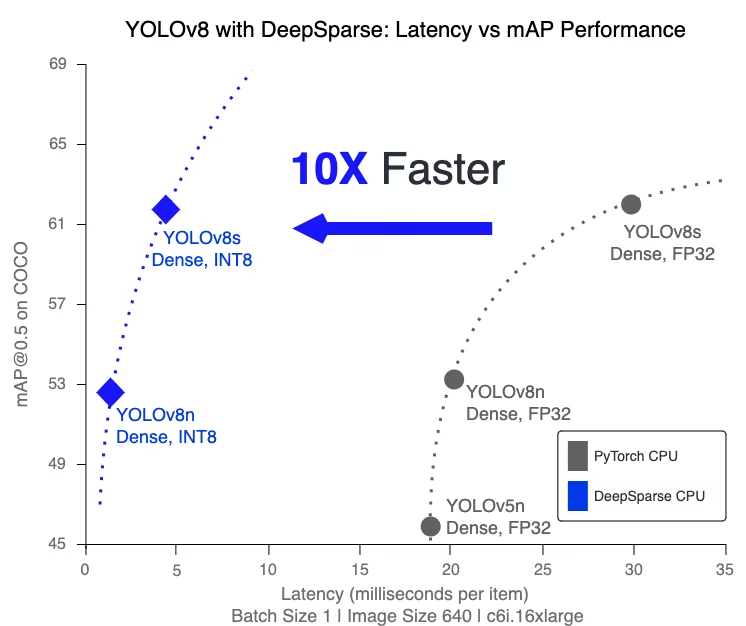
Nicemleme, modelin ağırlıklarını ve aktivasyonlarını yüksek duyarlıklı değerlerden (32 bit kayan noktalı sayılar gibi) daha düşük duyarlıklı değerlere (8 bit tam sayılar gibi) dönüştürür. Model boyutunu küçülterek çıkarımı hızlandırır. Nicemleme farkındalıklı eğitim (QAT), modelin nicemleme göz önünde bulundurularak eğitildiği ve eğitim sonrası nicemlemeye kıyasla doğruluğun daha iyi korunduğu bir yöntemdir. Eğitim aşamasında nicemlemeyi ele alan model, daha düşük duyarlılığa uyum sağlamayı öğrenir; böylece işlem gereksinimlerini azaltırken performansını korur. Ultralytics YOLO'da, eğitim sonrası INT8 nicemlemesi için dışa aktarma sırasında quantize=8 ayarını, QAT içinse eğitim sırasında ayarla.
Bilgi Damıtımı#
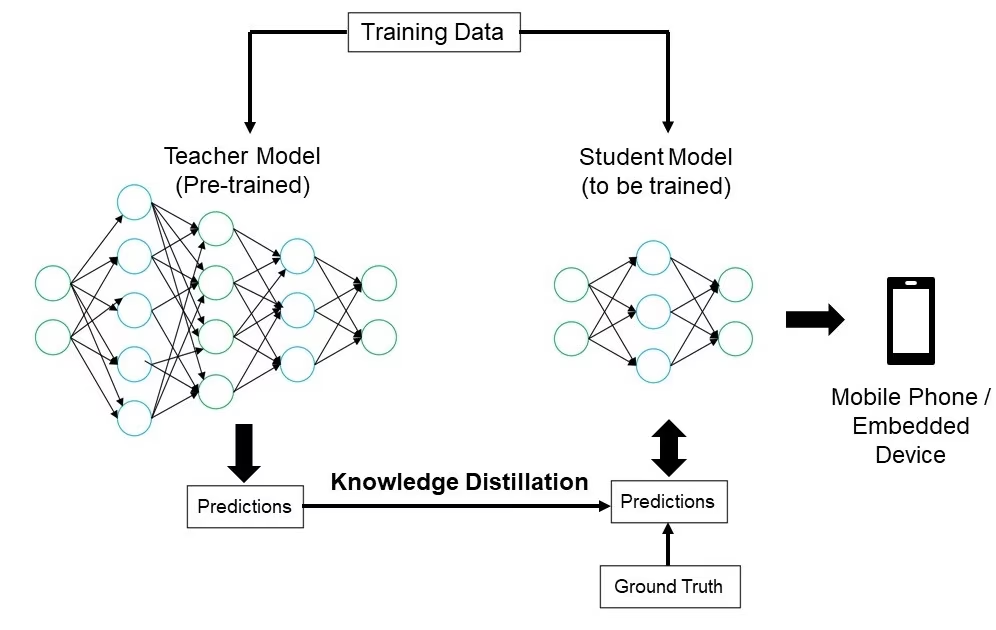
Bilgi damıtma, daha büyük ve daha karmaşık bir modelin (öğretmenin) çıktılarını taklit edecek şekilde daha küçük ve daha basit bir modelin (öğrencinin) eğitilmesini içerir. Öğrenci model, öğretmenin tahminlerini yaklaşık olarak üretmeyi öğrenir; bunun sonucunda öğretmenin doğruluğunun büyük bir kısmını koruyan kompakt bir model ortaya çıkar. Bu teknik, kaynakları kısıtlı uç cihazlarda dağıtıma uygun verimli modeller oluşturmak için faydalıdır. Ultralytics YOLO, bu tekniği distill_model eğitim argümanı aracılığıyla destekler.
Dağıtım Sorunlarını Giderme#
Bilgisayarlı görü modellerini dağıtırken zorluklarla karşılaşabilirsin; ancak yaygın sorunları ve çözümleri anlamak süreci kolaylaştırabilir. Dağıtım sorunlarını çözmene yardımcı olacak genel sorun giderme ipuçlarını ve en iyi uygulamaları burada bulabilirsin.
Dağıtımdan Sonra Modelin Daha Düşük Doğruluk Gösteriyor#
Dağıtımdan sonra modelinin doğruluğunun düşmesi çeşitli etkenlerden kaynaklanabilir. Sorunu belirleyip çözmene yardımcı olacak bazı adımlar şunlardır:
- Veri Tutarlılığını Kontrol Et: Modelinin dağıtım sonrası işlediği verilerin, eğitimde kullanılan verilerle tutarlı olduğundan emin ol. Veri dağılımı, kalitesi veya biçimindeki farklılıklar performansı önemli ölçüde etkileyebilir.
- Ön İşleme Adımlarını Doğrula: Eğitim sırasında uygulanan tüm ön işleme adımlarının dağıtım sırasında da tutarlı biçimde uygulandığını doğrula. Buna görüntüleri yeniden boyutlandırma, piksel değerlerini normalleştirme ve diğer veri dönüşümleri dahildir.
- Modelin Çalışma Ortamını Değerlendir: Dağıtımda kullanılan donanım ve yazılım yapılandırmalarının eğitim sırasında kullanılanlarla eşleştiğinden emin ol. Kitaplıklardaki, sürümlerdeki ve donanım özelliklerindeki farklılıklar tutarsızlıklara yol açabilir.
- Model Çıkarımını İzle: Aykırılıkları tespit etmek için çıkarım işlem hattının çeşitli aşamalarında girdileri ve çıktıları kaydet. Bu, verilerin bozulması veya model çıktılarının yanlış işlenmesi gibi sorunları belirlemeye yardımcı olabilir.
- Modeli Dışa Aktarma ve Dönüştürme Sürecini Gözden Geçir: Modeli yeniden dışa aktar ve dönüştürme sürecinin model ağırlıklarının ve mimarisinin bütünlüğünü koruduğundan emin ol.
- Kontrollü Bir Veri Kümesiyle Test Et: Modeli, kontrol ettiğin bir veri kümesinin bulunduğu test ortamında dağıt ve sonuçları eğitim aşamasındakilerle karşılaştır. Sorunun dağıtım ortamından mı yoksa verilerden mi kaynaklandığını belirleyebilirsin.
YOLO26'yı dağıtırken çeşitli etkenler model doğruluğunu etkileyebilir. Modelleri TensorRT gibi biçimlere dönüştürmek, ağırlık nicemleme ve katman birleştirme gibi optimizasyonları içerir ve bunlar küçük duyarlılık kayıplarına yol açabilir. FP32 (tam duyarlık) yerine FP16 (yarım duyarlık) kullanmak çıkarımı hızlandırabilir, ancak sayısal duyarlık hatalarına neden olabilir. Ayrıca, daha az CUDA çekirdeğine ve daha düşük bellek bant genişliğine sahip Jetson Nano gibi donanım kısıtları da performansı etkileyebilir.
Çıkarımlar Beklediğinden Daha Uzun Sürüyor#
Makine öğrenimi modellerini dağıtırken verimli çalışmaları önemlidir. Çıkarımlar beklenenden uzun sürüyorsa bu durum kullanıcı deneyimini ve uygulamanın etkinliğini etkileyebilir. Sorunu belirleyip çözmene yardımcı olacak bazı adımlar:
- Isınma Çalıştırmaları Yap: İlk çalıştırmalarda genellikle gecikme ölçümlerini saptırabilecek kurulum ek yükü bulunur. Gecikmeyi ölçmeden önce birkaç ısınma çıkarımı gerçekleştir. İlk çalıştırmaları ölçüm dışında bırakmak, model performansını daha doğru ölçmeni sağlar.
- Çıkarım Motorunu Optimize Et: Çıkarım motorunun kullandığın GPU mimarisi için tamamen optimize edildiğini tekrar kontrol et. En yüksek performans ve uyumluluk için donanımına uygun en yeni sürücüleri ve yazılım sürümlerini kullan.
- Asenkron İşleme Kullan: Asenkron işleme, iş yüklerini daha verimli yönetmeye yardımcı olabilir. Birden fazla çıkarımı eş zamanlı işlemek için asenkron işleme teknikleri kullan; böylece yükü dağıtıp bekleme sürelerini azaltabilirsin.
- Çıkarım İşlem Hattının Profilini Çıkar: Çıkarım işlem hattındaki darboğazları belirlemek, gecikmelerin kaynağını bulmana yardımcı olabilir. Çıkarım sürecinin her adımını analiz etmek, verimsiz katmanlar veya veri aktarımı sorunları gibi önemli gecikmelere neden olan aşamaları belirleyip düzeltmek için profil oluşturma araçlarını kullan.
- Uygun Duyarlığı Kullan: Gereğinden yüksek duyarlık kullanmak çıkarım sürelerini yavaşlatabilir. FP32 (tam duyarlık) yerine dışa aktarma sırasında
quantize=16ile FP16 gibi daha düşük duyarlık kullanmayı dene. FP16 çıkarım süresini kısaltabilir, ancak model doğruluğunu da etkileyebileceğini unutma.
YOLO26'yı dağıtırken bu sorunla karşılaşıyorsan YOLO26'nın, belleği daha az olan cihazlar için YOLO26n (nano) ve daha güçlü GPU'lar için YOLO26x (çok büyük) gibi çeşitli model boyutları sunduğunu göz önünde bulundur. Donanımına uygun model varyantını seçmek, bellek kullanımı ile işlem süresini dengelemene yardımcı olabilir.
Girdi görüntülerinin boyutunun bellek kullanımını ve işlem süresini doğrudan etkilediğini de unutma. Daha düşük çözünürlük bellek kullanımını azaltıp çıkarımı hızlandırırken daha yüksek çözünürlük doğruluğu artırır, ancak daha fazla bellek ve işlem gücü gerektirir.
Model Dağıtımında Güvenlikle İlgili Hususlar#
Dağıtımın bir diğer önemli yönü de güvenliktir. Dağıtılan modellerinin güvenliği, hassas verileri ve fikri mülkiyeti korumak açısından kritik öneme sahiptir. Güvenli model dağıtımı için uygulayabileceğin en iyi yöntemler:
Güvenli Veri Aktarımı#
İstemciler ve sunucular arasında gönderilen verilerin güvenliğini sağlamak, verilerin ele geçirilmesini veya yetkisiz tarafların erişimini önlemek için gereklidir. İletim sırasında verileri şifrelemek için TLS (Aktarım Katmanı Güvenliği) gibi şifreleme protokollerini kullanabilirsin. Birisi verileri ele geçirse bile okuyamaz. Ayrıca verileri kaynaktan hedefe kadar koruyan uçtan uca şifreleme kullanabilir, böylece aradaki hiç kimsenin verilere erişememesini sağlayabilirsin.
Erişim Denetimleri#
Yetkisiz kullanımı önlemek için modeline ve modelin verilerine kimlerin erişebileceğini denetlemek çok önemlidir. Modele erişmeye çalışan kullanıcıların veya sistemlerin kimliğini doğrulamak için güçlü kimlik doğrulama yöntemleri kullan ve çok faktörlü kimlik doğrulama (MFA) ile ek güvenlik sağlamayı düşün. İzinleri kullanıcı rollerine göre atamak ve kişilerin yalnızca ihtiyaç duydukları şeylere erişmesini sağlamak için rol tabanlı erişim denetimi (RBAC) ayarla. Modele ve modelin verilerine yapılan tüm erişimleri ve değişiklikleri izlemek için ayrıntılı denetim günlükleri tut ve şüpheli etkinlikleri tespit etmek için bu günlükleri düzenli olarak gözden geçir.
Model Gizleme#
Modelini tersine mühendislikten veya kötüye kullanımdan korumak için model gizleme yöntemini kullanabilirsin. Bu yöntem, yetkisiz kişilerin modeli anlamasını veya değiştirmesini zorlaştırmak amacıyla sinir ağlarındaki ağırlıklar ve bias değerleri gibi model parametrelerini şifrelemeyi içerir. Ayrıca katmanları ve parametreleri yeniden adlandırarak veya sahte katmanlar ekleyerek modelin mimarisini gizleyebilir ve saldırganların model üzerinde tersine mühendislik yapmasını zorlaştırabilirsin. Modeli güvenli bir yerleşik alan veya güvenilir yürütme ortamı (TEE) gibi güvenli bir ortamda sunmak da çıkarım sırasında ek bir koruma katmanı sağlayabilir.
Sonuç ve Sonraki Adımlar#
Bilgisayarlı görü modellerini dağıtırken uygulanabilecek bazı en iyi yöntemleri ele aldık. Verileri güvenceye alarak, erişimi denetleyerek ve model ayrıntılarını gizleyerek modellerinin sorunsuz çalışmasını sağlarken hassas bilgileri koruyabilirsin. Ayrıca ısınma çalıştırmaları, motor optimizasyonu, asenkron işleme, işlem hattı profili çıkarma ve doğru duyarlığı seçme gibi stratejilerle doğruluk düşüşü ve yavaş çıkarımlar gibi yaygın sorunların nasıl giderileceğini de ele aldık.
Modelini dağıttıktan sonraki adım, uygulamanı izlemek, bakımını yapmak ve belgelemektir. Düzenli izleme sorunları hızlıca fark edip gidermene yardımcı olur, bakım modellerini güncel ve işlevsel tutar, iyi bir belgelendirme ise tüm değişiklikleri ve güncellemeleri kaydeder. Bu adımlar, bilgisayarlı görü projenin hedeflerine ulaşmana yardımcı olur.
Sık Sorulan Sorular#
Bir makine öğrenimi modelini, özellikle Ultralytics YOLO26 ile dağıtırken verimliliği ve güvenilirliği sağlamak için çeşitli en iyi uygulamalara uymak gerekir. Öncelikle ihtiyaçlarına uygun dağıtım ortamını (bulut, uç veya yerel) seç. Kaynakları kısıtlı ortamlarda verimli dağıtım için budama, niceleme ve bilgi damıtma gibi tekniklerle modelini optimize et. Farklı ortamlarda tutarlılık sağlamak için Docker ile kapsayıcılaştırmayı değerlendirebilirsin. Son olarak, performansı korumak için veri tutarlılığını ve ön işleme adımlarını eğitim aşamasıyla uyumlu hâle getir. Daha ayrıntılı yönergeler için model dağıtım seçeneklerine de başvurabilirsin.
Dağıtım sorunlarını gidermeyi birkaç temel adıma ayırabilirsin. Dağıtımdan sonra modelinin doğruluğu düşerse veri tutarlılığını kontrol et, ön işleme adımlarını doğrula ve donanım/yazılım ortamının eğitim sırasında kullandığın ortamla eşleştiğinden emin ol. Çıkarım yavaşsa ısınma çalıştırmaları yap, çıkarım motorunu optimize et, asenkron işleme kullan ve çıkarım işlem hattının profilini çıkar. Bu en iyi uygulamalarla ilgili ayrıntılı bir kılavuz için dağıtım sorunlarını gidermeye başvur.
Ultralytics YOLO26 modellerini uç cihazlar için optimize ederken model boyutunu azaltmak için budama, ağırlıkları daha düşük duyarlığa dönüştürmek için niceleme ve daha büyük modelleri taklit eden küçük modeller eğitmek için bilgi damıtma gibi tekniklerden yararlanılır. Bu teknikler, modelin işlem gücü kısıtlı cihazlarda verimli çalışmasını sağlar. LiteRT ve NVIDIA Jetson gibi araçlar bu optimizasyonlar için özellikle kullanışlıdır. Bu teknikler hakkında daha fazla bilgi edinmek için model optimizasyonu bölümümüze göz at.
Makine öğrenimi modellerini dağıtırken güvenlik çok önemlidir. TLS gibi şifreleme protokollerini kullanarak güvenli veri aktarımı sağla. Güçlü kimlik doğrulama ve rol tabanlı erişim denetimi (RBAC) dâhil olmak üzere sağlam erişim denetimleri uygula. Model parametrelerini şifrelemek ve modelleri güvenilir yürütme ortamı (TEE) gibi güvenli bir ortamda sunmak gibi model gizleme teknikleri ek koruma sağlar. Ayrıntılı uygulamalar için güvenlikle ilgili hususlara başvur.
Ultralytics YOLO26 modelin için en uygun dağıtım ortamını seçmek, uygulamanın özel ihtiyaçlarına bağlıdır. Bulut dağıtımı ölçeklenebilirlik ve kolay erişim sunar; bu nedenle yüksek veri hacmine sahip uygulamalar için idealdir. Uç dağıtım, LiteRT gibi araçlarla gerçek zamanlı yanıt gerektiren düşük gecikmeli uygulamalar için en uygun seçenektir. Yerel dağıtım ise sıkı veri gizliliği ve denetimi gerektiren senaryolara uygundur. Her ortamla ilgili kapsamlı bir genel bakış için dağıtım ortamı seçimi bölümümüze göz at.


Yorumlar10
Bir soru sor, sonuçlarını paylaş veya başka birine yardım et.
 TaoBenHui
shafa~hahaha
Taufiq-Ahmed
Hi, I Have trained my custom dataset on yolov8s model. Now I want to optimized the model by using pruning and quantization. could you please tell me How I can implement it and what is the python code of it?
 Paula DerrengerUltralytics
@Taufiq-Ahmed to optimize your YOLOv8 model using pruning and quantization, you can follow these steps:
-
Pruning: This involves removing weights that contribute little to the final output, making the model smaller and faster. You can use libraries like TensorFlow Model Optimization Toolkit or PyTorch's pruning methods.
-
Quantization: This converts the model's weights and activations from high precision (e.g., 32-bit floats) to lower precision (e.g., 8-bit integers), reducing model size and speeding up inference. You can use TensorFlow Lite for post-training quantization or PyTorch's quantization tools.
For detailed guidance and code examples, please refer to the Ultralytics documentation on model optimization. This resource provides comprehensive instructions and best practices for deploying and optimizing your models effectively.
-
Thank you so much for your reply. One think I would like to know, is it possible to do pruning and quantization in my YOLOv8 best.pt model with TensorFlow Model Optimization Toolkit or PyTorch's pruning methods. Do do I need to convert it and also need to convert my dataset from YOLO format to any other format?
- Paula DerrengerUltralytics
Yes, you can perform pruning and quantization on your YOLOv8 model using TensorFlow Model Optimization Toolkit or PyTorch's pruning methods. You don't need to convert your dataset format, but you may need to convert your model to a compatible format like ONNX if using TensorFlow tools. For PyTorch, you can directly apply pruning and quantization techniques. For detailed steps, please refer to the Ultralytics documentation on model deployment practices.
Thank you for your reply. could you please give me any git hub repositories or any coding example on how to apply pruning and quantization techniques on the best.pt model on custom dataset. and how will i maintain the accuracy of the model.
- Paula DerrengerUltralytics
@Taufiq-Ahmed for pruning and quantization of your YOLOv8 model, you can use PyTorch's built-in functionalities. You don't need to convert your dataset format. For pruning, you can use
torch.nn.utils.prune, and for quantization, you can usetorch.quantization. If you need specific code examples, please let me know. For more detailed guidance, you can refer to the Ultralytics documentation on model deployment practices. Thank you for your reply. it would be better for me if you share a coding example of how to prune and quantize the model on the custom data to reduce it's size and weights using pytorch and how to ´maintain it's accuracy. do I need to train it again or there is some other way to maintain it's accuracy.
Hi could you please check whether this idea works:
import torch import torch.nn as nn from torch.nn.utils import prune from ultralytics import YOLO
model = YOLO('best.pt')
def gradual_prune_model(model, prune_step=0.05, prune_iterations=10): for i in range(prune_iterations):
    for name, module in model.model.named_modules():
        if isinstance(module, nn.Conv2d):
            prune.l1_unstructured(module, name='weight', amount=prune_step)
            prune.remove(module, 'weight')  # Remove pruning reparameterization

    print(f'Fine-tuning after pruning iteration {i+1}/{prune_iterations}')
    model.train(data='dataset.yaml', epochs=2, lr=1e-4)
gradual_prune_model(model, prune_step=0.05, prune_iterations=10)
print('Final fine-tuning after pruning') model.train(data='/path/to/your/dataset.yaml', epochs=10, lr=1e-5)
model.save('pruned_yolov8.pt')
is this pruned technique works? and after pruning is this the right way to regain it's accuracy?
- Paula DerrengerUltralytics
Your approach to pruning looks good. Gradual pruning followed by fine-tuning can help maintain accuracy. After pruning, fine-tuning with a lower learning rate is essential to regain any lost accuracy. For quantization, you can use PyTorch's quantization tools. Ensure you validate the model's performance after each step. For more detailed guidance, refer to the Ultralytics documentation on model deployment practices.