Export Qualcomm QNN cho model Ultralytics YOLO#
Triển khai model thị giác máy tính trên thiết bị Qualcomm Snapdragon cần định dạng model được tinh chỉnh cho runtime Qualcomm AI Engine Direct (QNN). Export model Ultralytics YOLO sang định dạng QNN cho phép chạy inference tăng tốc ngay trên thiết bị với phần cứng Snapdragon CPU, Adreno GPU và Hexagon NPU, hiện diện trong hàng tỷ điện thoại di động, laptop, hệ thống ô tô và thiết bị IoT. Hướng dẫn này trình bày cách export YOLO sang Qualcomm QNN và triển khai để inference nhanh, tiêu thụ ít năng lượng trên phần cứng Snapdragon.
Plugin Flutter chính thức của Ultralytics cung cấp hỗ trợ QNN tùy chọn cho suy luận camera theo thời gian thực và dự đoán ảnh đơn trên cả bảy tác vụ YOLO26. Bật runtime QNN và thêm dependency ONNX Runtime theo hướng dẫn trong README của plugin. Để triển khai trên iOS, xem Ultralytics YOLO iOS SDK và tích hợp CoreML.
Xuất các model phân loại tại imgsz=224. Xuất các model phát hiện, phân đoạn, ngữ nghĩa, độ sâu, pose và OBB tại imgsz=640. Chuẩn 224/640 này được dùng chung cho các asset di động QNN, LiteRT và CoreML chính thức. Các asset v73 và v81 sẵn sàng chạy cho cả bảy tác vụ ở mọi kích thước (n đến x) được công bố trong bản phát hành yolo-flutter-app v0.7.0.
Qualcomm QNN là gì?#
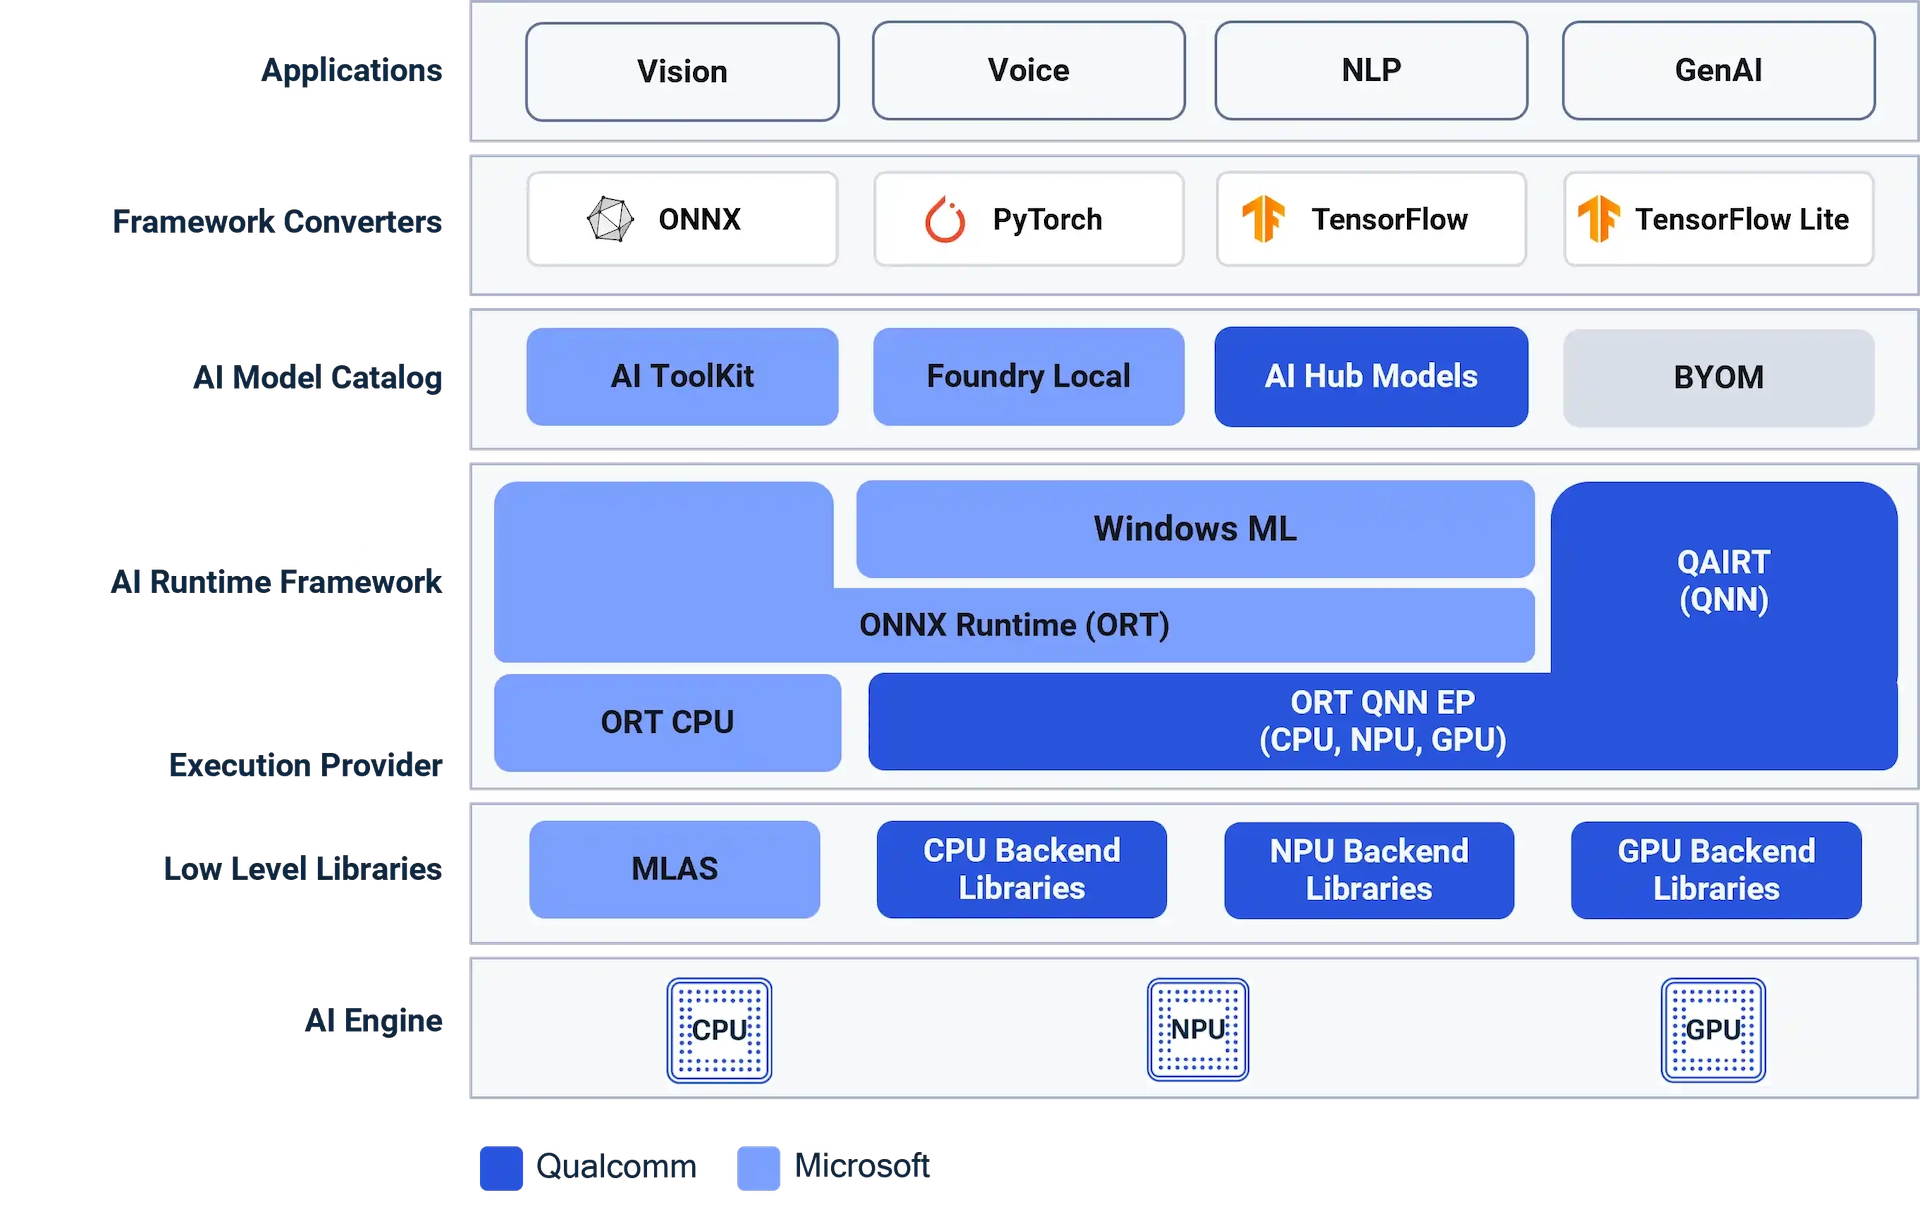
Qualcomm AI Engine Direct — thường được gọi là QNN và phân phối trong bộ SDK Qualcomm AI Runtime (QAIRT) — là stack suy luận cấp thấp của Qualcomm dành cho bộ xử lý Snapdragon. Stack này cung cấp API thống nhất cùng các thư viện riêng cho từng backend, nhắm đến CPU Snapdragon, GPU Adreno và Hexagon Tensor Processor (HTP), đơn vị xử lý thần kinh (NPU) chuyên dụng bên trong các SoC Snapdragon hiện đại. QNN cung cấp cho nhà phát triển quyền truy cập toàn diện vào các bộ tăng tốc AI Snapdragon và là thế hệ kế nhiệm hiện đại của SDK Snapdragon Neural Processing Engine (SNPE) cũ hơn. QNN hỗ trợ AI trực tiếp trên thiết bị trên các nền tảng di động Snapdragon 8 Gen 2, 8 Gen 3 và 8 Elite, laptop Snapdragon X, cũng như các sản phẩm ô tô và XR.
Vì sao nên export sang Qualcomm QNN?#
Snapdragon là một trong những nền tảng tính toán di động được triển khai rộng rãi nhất. Xuất Ultralytics YOLO sang định dạng Qualcomm QNN giúp khai thác phần cứng AI chuyên dụng trên các thiết bị này:
- Tăng tốc bằng NPU Hexagon: Chạy YOLO trên Hexagon Tensor Processor mang lại thông lượng cao hơn nhiều và mức tiêu thụ điện năng thấp hơn so với suy luận trên CPU, phù hợp với suy luận thời gian thực và thị giác máy tính luôn bật trên Snapdragon.
- Trên thiết bị và ngoại tuyến: QNN chạy inference hoàn toàn trên thiết bị Snapdragon, không cần trao đổi dữ liệu với đám mây, duy trì độ trễ thấp và dữ liệu không bao giờ rời khỏi thiết bị.
- Hiệu quả nhờ lượng tử hóa: QNN export lượng tử hóa YOLO thành trọng số INT8 với activation 16-bit, mức cân bằng độ chính xác/hiệu năng được Hexagon NPU ưu tiên, giúp thu nhỏ kích thước model và tối đa hóa số khung hình mỗi giây trên phần cứng chạy bằng pin.
- Một định dạng, nhiều thiết bị: Một bản export Qualcomm QNN duy nhất nhắm đến Snapdragon CPU, Adreno GPU và Hexagon NPU trên các dòng Snapdragon 8 Gen 2, 8 Gen 3, 8 Elite và các thế hệ sau.
- Stack AI Qualcomm sẵn sàng cho môi trường production: QNN (Qualcomm AI Engine Direct / QAIRT) là runtime AI trên thiết bị hiện tại, được Qualcomm tích cực duy trì và khuyến nghị thay thế SNPE.
Định dạng export QNN#
Ultralytics biên dịch model YOLO sang QNN ngay trên máy bằng ONNX Runtime QNN Execution Provider (gói onnxruntime-qnn có thể cài bằng pip, tích hợp các thư viện QAIRT). Bộ export chuyển model sang ONNX, lượng tử hóa model bằng dữ liệu hiệu chuẩn thành activation 16-bit và trọng số INT8 (mức cân bằng được khuyến nghị cho Hexagon NPU), sau đó khởi tạo phiên ONNX Runtime với tính năng lưu cache context binary được bật — quá trình này biên dịch đồ thị đã lượng tử hóa thành QNN context binary được nhúng trong <model>_qnn.onnx. Không cần tài khoản Qualcomm, tải dữ liệu lên đám mây hoặc tải SDK riêng.
Khác với Qualcomm AI Hub chạy trên đám mây, vốn biên dịch và profiling model trên các thiết bị Snapdragon do Qualcomm lưu trữ và yêu cầu tài khoản Qualcomm, tính năng QNN export của Ultralytics chạy hoàn toàn trên máy của bạn chỉ với một lệnh gọi export(format="qnn", imgsz=640) (imgsz=224 cho tác vụ phân loại). Bạn nhận được cùng runtime đích QNN/QAIRT — Snapdragon CPU, Adreno GPU và Hexagon NPU — mà không cần đăng ký, không giới hạn tải lên hay thời gian chờ hàng đợi, đồng thời tích hợp trực tiếp vào workflow YOLO export tiêu chuẩn.
File *_qnn.onnx được export là độc lập: file nhúng QNN context binary và metadata ONNX như tên lớp, kích thước ảnh và tác vụ.
Các tính năng chính của model QNN#
- Lượng tử hóa: Model được lượng tử hóa với activation 16-bit và trọng số INT8 bằng quy trình ONNX Runtime QNN QDQ cùng tập dữ liệu hiệu chỉnh; đây là mức cân bằng độ chính xác/hiệu năng được khuyến nghị cho NPU Hexagon.
- Biên dịch hoàn toàn cục bộ: Context binary được tạo hoàn toàn trên máy chủ của bạn — không cần tài khoản Qualcomm, API token hay tải dữ liệu lên đám mây.
- Tăng tốc toàn diện trên Snapdragon: Chạy inference trên Hexagon NPU (HTP), Adreno GPU hoặc CPU thông qua một runtime hợp nhất duy nhất.
- Hỗ trợ nhiều thiết bị: Nhắm đến nhiều nền tảng Snapdragon được trang bị trên điện thoại, PC (Windows trên Snapdragon), ô tô, XR và sản phẩm nhúng.
- Context binary biên dịch sẵn: Phân phối context binary giúp giảm thiểu việc biên dịch đồ thị trên thiết bị, giảm độ trễ tải model trên thiết bị đích.
- Đầu ra độc lập: File ONNX được export bao gồm QNN context binary đã biên dịch sẵn và metadata để triển khai dễ dàng.
Hiệu năng đo được#
Điện thoại Android#
Phần cứng: Xiaomi 17 với bộ nhớ LPDDR5X 12 GB và Android 17 / API 37. Snapdragon 8 Elite Gen 5 3 nm (SM8850) có CPU Qualcomm Oryon 8 nhân (2 nhân Prime tối đa 4.6 GHz và 6 nhân Performance tối đa 3.62 GHz), GPU Adreno và NPU Hexagon (HTP v81).
| Model | Tác vụ | kích thước (pixel) | CPU w8a32 LiteRT (ms) | GPU w8a32 LiteRT (ms) | NPU QNN W8A16 (ms) |
|---|---|---|---|---|---|
| YOLO26n | Detect | 640 | 36.9 1.9 / 32.6 / 2.3 | 10.6 1.8 / 6.2 / 2.6 | 10.2 1.9 / 6.0 / 2.3 |
| YOLO26n-seg | Segment | 640 | 50.5 1.9 / 42.9 / 5.8 | 18.0 1.9 / 9.5 / 6.6 | 16.2 2.1 / 8.4 / 5.7 |
| YOLO26n-sem | Ngữ nghĩa | 640 | 45.7 1.9 / 35.7 / 8.2 | 30.6 1.9 / 20.5 / 8.3 | 10.8 2.0 / 6.2 / 2.6 |
| YOLO26n-depth | Độ sâu | 640 | 66.8 2.2 / 55.0 / 9.7 | 21.9 2.1 / 10.1 / 9.8 | 19.3 2.2 / 7.4 / 9.7 |
| YOLO26n-cls | Phân loại | 224 | 3.6 0.3 / 3.3 / 0.0 | 2.0 0.4 / 1.4 / 0.2 | 0.8 0.3 / 0.5 / 0.0 |
| YOLO26n-pose | Tư thế | 640 | 39.9 2.0 / 36.5 / 1.4 | 10.0 1.8 / 6.7 / 1.4 | 9.7 1.9 / 5.9 / 1.8 |
| YOLO26n-obb | OBB | 640 | 36.3 2.0 / 33.2 / 1.2 | 10.1 2.6 / 5.9 / 1.6 | 8.1 1.9 / 5.1 / 1.0 |
- Các giá trị Speed là độ trễ burst của một ảnh — trung bình của 15 lần chạy sau 3 lượt warmup trên
bus.jpg, được đo bằng harness benchmark trên thiết bị0.7.1của plugin Flutter và các assetv0.7.0chính thức (bản xuất Ultralytics 8.4.188). Thứ tự backend luân phiên giữa các tác vụ trong một lượt chạy tuần tự. Nhật ký native xác nhận mọi hàng CPU đều dùng LiteRT CPU/XNNPACK, mọi hàng GPU đều chuyển toàn bộ graph cho LiteRT OpenCL (LITERT_CL), và mọi hàng NPU đều dùng backend QNN Hexagon HTP. - Bản ghi benchmark chi tiết có trong tài liệu hiệu năng Flutter.
- So sánh các thiết bị Android khác trong tích hợp LiteRT và các thiết bị Apple trong tích hợp CoreML.
Laptop Windows trên Snapdragon#
Lượt benchmark lịch sử này sử dụng các QNN binary v73 trước khi chuẩn hóa; semantic và OBB sử dụng đầu vào 1024px. Benchmark chạy trên laptop Lenovo với bộ nhớ 32 GB và Windows 11. Snapdragon X Elite (X1E78100) có Qualcomm Oryon CPU 12 lõi, Adreno GPU và Hexagon NPU (HTP v73); không ghi lại chính xác model Lenovo. Phép so sánh Windows trên Snapdragon này đối chiếu baseline CPU PyTorch FP32 gốc mà phần lớn nhà phát triển máy tính để bàn sử dụng ban đầu với đường chạy Hexagon HTP QNN của ONNX Runtime. Mỗi ô hiển thị tổng thời gian thực thi model.predict() cùng các thời gian tiền xử lý / inference / hậu xử lý được báo cáo bên dưới; tổng thời gian có thể bao gồm overhead của framework ngoài ba giai đoạn này. Số liệu CPU là PyTorch FP32 (torch==2.10.0+cpu) và số liệu NPU là ONNX Runtime QNN (onnxruntime-qnn==2.2.0, trọng số INT8 / activation 16-bit).
| Model | Tác vụ | kích thước (pixel) | CPU PT FP32 (ms) | NPU Hexagon QNN W8A16 (ms) |
|---|---|---|---|---|
| YOLO26n | Detect | 640 | 91.4 4.3 / 75.2 / 0.1 | 27.2 4.9 / 19.4 / 0.9 |
| YOLO26n-seg | Segment | 640 | 138.8 4.5 / 127.1 / 2.8 | 34.3 5.0 / 24.0 / 5.1 |
| YOLO26n-sem | Ngữ nghĩa | 1024 | 295.8 9.1 / 189.2 / 94.8 | 133.0 8.8 / 37.4 / 83.9 |
| YOLO26n-cls | Phân loại | 224 | 15.4 3.0 / 9.8 / 0.0 | 11.7 2.7 / 5.5 / 0.0 |
| YOLO26n-pose | Tư thế | 640 | 109.6 4.6 / 102.9 / 0.2 | 28.9 5.3 / 23.3 / 0.6 |
| YOLO26n-obb | OBB | 1024 | 267.8 8.1 / 254.6 / 0.1 | 64.8 8.9 / 54.7 / 0.6 |
- Các giá trị Speed là độ trễ burst trên một ảnh — giá trị trung bình của 100 lần chạy sau 10 lần chạy khởi động trên
bus.jpg, được đo bằngtime.perf_counter()quanh toàn bộ lệnh gọimodel.predict()trên thiết bị đã nguội (ultralytics==8.4.67, Python 3.12.10). - NPU Hexagon chạy nhanh hơn khoảng 2-4x so với baseline CPU PyTorch trên các tác vụ 640-1024 px (phát hiện nhanh hơn khoảng ~3.4x), mức chênh lệch giảm còn ~1.3x trên bộ phân loại 224 px, nơi chi phí tiền xử lý cố định chiếm ưu thế trong khối lượng công việc rất nhỏ.
Các tác vụ được hỗ trợ#
Tính năng xuất Qualcomm QNN hỗ trợ cả bảy tác vụ Ultralytics. Phân đoạn ngữ nghĩa và ước tính độ sâu chỉ có trên YOLO26, dòng model duy nhất đi kèm các head này.
Xuất sang QNN: Chuyển đổi model YOLO của bạn#
Xuất model Ultralytics YOLO sang định dạng QNN để triển khai trên phần cứng Qualcomm. Tệp nhị phân context được hoàn thiện cho kiến trúc Hexagon Tensor Processor (HTP) mục tiêu hoặc SoC được hỗ trợ, được chọn bằng đối số name — cũng là đối số dùng để chỉ định chip trong tính năng xuất RKNN.
Các mục tiêu HTP được hỗ trợ#
Truyền kiến trúc mục tiêu hoặc SoC qua name (ví dụ: name="73" hoặc name="iq-8275"). Khả năng hỗ trợ được xác định bởi target HTP, vì vậy các dòng Snapdragon bên dưới là những nền tảng đại diện, không phải danh sách đầy đủ mọi SoC. Các thiết bị Dragonwing được liệt kê cụ thể.
| Trạng thái | name | Hexagon HTP | Thiết bị hoặc nền tảng ví dụ |
|---|---|---|---|
| ✅ Được hỗ trợ | 68 | v68 | Snapdragon 888 |
| ✅ Được hỗ trợ | 69 | v69 | Snapdragon 8 Gen 1 / 8+ Gen 1 |
| ✅ Được hỗ trợ | 73 | v73 | Snapdragon 8 Gen 2, X Elite (mặc định) |
| ✅ Được hỗ trợ | 75 | v75 | Snapdragon 8 Gen 3 |
| ✅ Được hỗ trợ | 79 | v79 | Snapdragon 8 Elite |
| ✅ Được hỗ trợ | 81 | v81 | Snapdragon 8 Elite Gen 5 |
| ✅ Được hỗ trợ | iq-8275 hoặc qcs8275 | v75 | Dragonwing IQ-8275 / QCS8275 (model SoC QNN 82) |
| ❌ Không được hỗ trợ | — | v66 | Dragonwing IQ-615 / QCS615 |
Dragonwing IQ-615 không thể sử dụng tính năng xuất context-binary QNN của Ultralytics vì ONNX Runtime không cung cấp DSP v66 như một target HTP ngoại tuyến. Vẫn có thể tích hợp riêng bản xuất ONNX tiêu chuẩn với execution provider CPU hoặc GPU được BSP của bo mạch hỗ trợ.
from ultralytics import YOLO

model = YOLO("best.pt")
model.export(format="qnn", name="iq-8275", imgsz=640)Tính năng xuất QNN sử dụng package onnxruntime-qnn. Từ phiên bản 2.4.0 trở đi, package này cung cấp các wheel dựng sẵn cho Windows (x64 và ARM64) và Linux (x86-64 và ARM64) trên Python 3.11 trở lên; macOS không phải là host QNN được hỗ trợ. Quá trình tạo context-binary QNN chạy trên host x64 và không cần thiết bị Snapdragon cho bước xuất.
Cài đặt#
Để cài đặt các package cần thiết, hãy chạy:
# Install the required package for YOLO
pip install ultralytics
Package onnxruntime-qnn (cung cấp ONNX Runtime QNN Execution Provider và đóng gói các thư viện QAIRT) được tự động cài đặt trong lần xuất đầu tiên. Để biết hướng dẫn chi tiết và các phương pháp hay nhất liên quan đến quá trình cài đặt, hãy xem hướng dẫn cài đặt Ultralytics. Nếu gặp khó khăn khi cài đặt các package cần thiết cho YOLO, hãy tham khảo hướng dẫn về các vấn đề thường gặp để tìm giải pháp và mẹo.
Cách sử dụng#
Định dạng QNN hỗ trợ các chế độ Export, Predict và Validate. Suy luận và xác thực chạy trên phần cứng Qualcomm Snapdragon thông qua QNN Execution Provider của ONNX Runtime (cùng package onnxruntime-qnn được dùng để xuất). Hãy xuất model, sau đó tải model đã xuất lên thiết bị Snapdragon để chạy suy luận hoặc xác thực độ chính xác.
from ultralytics import YOLO

# Nạp model YOLO26
model = YOLO("yolo26n.pt")

# Xuất sang định dạng Qualcomm QNN (tự động bật INT8) cho target HTP v73 mặc định
model.export(format="qnn", name="73", imgsz=640) # dùng imgsz=224 cho phân loạifrom ultralytics import YOLO
# Tải model QNN đã xuất (trên thiết bị Snapdragon có onnxruntime-qnn)
model = YOLO("yolo26n_qnn.onnx")
# Chạy suy luận
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Tải model QNN đã xuất (trên thiết bị Snapdragon có onnxruntime-qnn)
model = YOLO("yolo26n_qnn.onnx")
# # Đánh giá độ chính xác trên bộ dữ liệu COCO8
metrics = model.val(data="coco8.yaml")Các tham số xuất model#
| Đối số | Kiểu | Mặc định | Mô tả |
|---|---|---|---|
format | str | 'qnn' | Định dạng mục tiêu của model đã xuất, xác định khả năng tương thích với Qualcomm QNN runtime. |
imgsz | int hoặc tuple | 640 | Kích thước ảnh mong muốn cho đầu vào model. Có thể là một số nguyên cho ảnh vuông hoặc một tuple (height, width). |
batch | int | 1 | Chỉ định batch size của model xuất, được cố định trong tệp nhị phân context QNN tạo ra. |
name | str | '73' | Kiến trúc Hexagon HTP mục tiêu (68, 69, 73, 75, 79 hoặc 81) hoặc SoC được hỗ trợ (iq-8275 hoặc qcs8275). Tệp nhị phân context được hoàn thiện cho target này. |
quantize | int hoặc str | 'w8a16'/auto | Độ chính xác lượng tử hóa. Tính năng xuất QNN HTP lượng tử hóa trọng số thành INT8 với activation 16 bit ('w8a16') và tự động bật nếu không được chỉ định. Thay thế các cờ half/int8 đã lỗi thời. |
simplify | bool | True | Đơn giản hóa đồ thị ONNX trung gian bằng onnxslim. |
opset | int | None | Chỉ định phiên bản ONNX opset cho đồ thị ONNX trung gian. Nếu không được thiết lập, phiên bản opset 18 sẽ được sử dụng (thấp hơn trên PyTorch < 2.4), tối đa bằng phiên bản onnx đã cài đặt. |
data | str | None | YAML dataset được dùng để hiệu chuẩn INT8; với phân loại, thay vào đó hãy cung cấp thư mục dataset hoặc tên dataset tích hợp sẵn. Nếu bỏ qua, Ultralytics sẽ chọn dataset hiệu chuẩn mặc định cho tác vụ của model. |
fraction | float, int hoặc list | 1.0 | Tập con hiệu chuẩn dưới dạng tỷ lệ, số lượng ảnh hoặc tỷ lệ/số lượng [train, val, test]. Danh sách gồm hai mục giữ test ở dạng đầy đủ, còn 0 sẽ bỏ qua mục này. |
device | str | None | Chỉ định thiết bị cho bước xuất ONNX: GPU (device=0) hoặc CPU (device=cpu). |
Tính năng xuất QNN lượng tử hóa model với activation 16 bit và trọng số INT8 — mức cân bằng độ chính xác/hiệu năng được khuyến nghị cho NPU Hexagon — bằng quy trình lượng tử hóa ONNX Runtime QDQ, sử dụng ảnh hiệu chuẩn từ data. quantize='w8a16' được tự động bật.
Để biết thêm chi tiết về quy trình xuất, hãy truy cập trang tài liệu Ultralytics về xuất model.
Cấu trúc đầu ra#
Sau khi xuất thành công, một tệp ONNX độc lập được tạo:
yolo26n_qnn.onnx # ONNX wrapping the precompiled QNN context binary and metadata
Tệp yolo26n_qnn.onnx chứa nhúng tệp nhị phân context QNN và được ONNX Runtime tải bằng QNN Execution Provider trên thiết bị Snapdragon. Tệp cũng chứa metadata của model như tên lớp, kích thước ảnh và tác vụ trong ONNX metadata_props.
Triển khai model YOLO QNN đã xuất#
Model QNN chạy trên phần cứng Qualcomm được hỗ trợ, giúp việc triển khai model trực tiếp trên thiết bị trở nên đơn giản. Trên thiết bị tương thích đã cài onnxruntime-qnn, hãy chạy trực tiếp model đã xuất bằng API Ultralytics (yolo predict/yolo val, xem Cách sử dụng ở trên) — Ultralytics tải tệp nhị phân context HTP thông qua ONNX Runtime QNN Execution Provider.
Với pipeline tùy chỉnh, bạn cũng có thể tải trực tiếp ONNX context-binary bằng ONNX Runtime. onnxruntime-qnn là một plugin Execution Provider, vì vậy hãy đăng ký trong lúc chạy:
import onnxruntime as ort
import onnxruntime_qnn as qnn_ep

# Trên thiết bị Snapdragon, đăng ký plugin QNN EP và chọn (các) thiết bị
ort.register_execution_provider_library("QNNExecutionProvider", qnn_ep.get_library_path())
devices = [d for d in ort.get_ep_devices() if d.ep_name == "QNNExecutionProvider"]

options = ort.SessionOptions()
options.add_provider_for_devices(devices, {"backend_path": qnn_ep.get_qnn_htp_path()})
session = ort.InferenceSession("yolo26n_qnn.onnx", sess_options=options)
input_info = session.get_inputs()[0]
outputs = session.run(None, {input_info.name: input_tensor})  # input_tensor: float32 NHWC
Vì tệp nhị phân context QNN được biên dịch sẵn, phiên chạy được tải nhanh mà không cần biên dịch lại graph trên thiết bị.
Yêu cầu đối với BSP Linux và Yocto#
Bo mạch đích phải cung cấp runtime Qualcomm và BSP tương thích với nhau. Đối với suy luận HTP, các thành phần này bao gồm ONNX Runtime QNN Execution Provider, libQnnSystem.so, libQnnHtp.so, các thư viện stub và skeleton HTP v75 cho IQ-8275, hỗ trợ FastRPC ở userspace như libcdsprpc.so, firmware DSP và các driver FastRPC/kernel tương ứng. Thư viện skeleton phải có thể được tìm thấy thông qua đường dẫn thư viện DSP của BSP.
Các thành phần phía target này được cung cấp trong BSP hỗ trợ QAIRT/QNN của nhà cung cấp bo mạch; chúng không được nhúng trong model đã xuất. Thực thi GPU thay vào đó cần libQnnGpu.so và ngăn xếp driver userspace Adreno tương ứng. Đầu ra format=qnn của Ultralytics là tệp nhị phân context dành riêng cho HTP, vì vậy triển khai GPU hoặc CPU cần bắt đầu từ bản xuất ONNX tiêu chuẩn thay vì tệp *_qnn.onnx đã biên dịch sẵn.
Quy trình được khuyến nghị#
- Huấn luyện model bằng Train Mode của Ultralytics
- Xuất sang định dạng QNN bằng
model.export(format="qnn", name="iq-8275", imgsz=640)trên nền tảng được hỗ trợ (dùngimgsz=224cho tác vụ phân loại) - Triển khai tệp
*_qnn.onnxđã xuất lên thiết bị Qualcomm của bạn - Chạy suy luận bằng ONNX Runtime và QNN Execution Provider với backend HTP
Ứng dụng thực tế#
Các model YOLO chạy trên phần cứng Qualcomm Snapdragon phù hợp với nhiều ứng dụng AI biên:
- Điện thoại thông minh: Phát hiện đối tượng theo thời gian thực và hiểu cảnh trong ứng dụng camera, ảnh với khả năng tăng tốc NPU.
- Windows trên Snapdragon: Thị giác máy tính trực tiếp trên thiết bị trong các PC Copilot+ mà không cần chuyển tác vụ lên cloud.
- Ô tô: Giám sát tài xế, phát hiện hành khách và các tính năng ADAS trên nền tảng Snapdragon Digital Chassis.
- XR và thiết bị đeo: Khả năng nhận thức tiêu thụ ít điện năng, độ trễ thấp cho kính AR/VR và kính thông minh.
- IoT và robot: Suy luận thị giác hiệu quả trên camera, drone và hệ thống nhúng dùng Snapdragon.
Tóm tắt#
Trong hướng dẫn này, bạn đã tìm hiểu cách xuất cục bộ model Ultralytics YOLO sang định dạng Qualcomm QNN bằng ONNX Runtime QNN Execution Provider. Pipeline xuất chuyển đổi model sang ONNX, sau đó biên dịch thành tệp nhị phân context QNN trên máy host — không cần tài khoản Qualcomm hay cloud — tạo ra tệp *_qnn.onnx được tối ưu cho phần cứng CPU Snapdragon, GPU Adreno và NPU Hexagon thông qua runtime QNN/QAIRT.
Kết hợp với nhau, Ultralytics YOLO và stack AI trực tiếp trên thiết bị của Qualcomm cho phép bạn chạy workload thị giác máy tính trên hệ sinh thái Snapdragon rộng khắp.
Để so sánh các định dạng trước khi phát hành, hãy dùng chế độ Benchmark.
Câu hỏi thường gặp#
Bạn có thể xuất model bằng
export(format="qnn", imgsz=640)(imgsz=224cho tác vụ phân loại) hoặc các đối số CLI tương đương. Trước tiên, quá trình xuất tạo model ONNX, sau đó biên dịch model cục bộ thành tệp nhị phân context QNN bằng ONNX Runtime QNN Execution Provider. Packageonnxruntime-qnnđược tự động cài đặt trong lần xuất đầu tiên.Ví dụfrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="qnn", imgsz=640) # dùng imgsz=224 cho phân loạiKhông. Tính năng xuất QNN chạy hoàn toàn trên máy cục bộ bằng package
onnxruntime-qnn, trong đó có đóng gói các thư viện QAIRT. Không cần tài khoản Qualcomm, token API hay kết nối mạng.Qualcomm AI Hub là dịch vụ đám mây của Qualcomm dùng để biên dịch, lập hồ sơ hiệu năng và benchmark model trên các thiết bị Snapdragon được lưu trữ, đồng thời yêu cầu tài khoản Qualcomm. Ultralytics QNN export nhắm đến cùng runtime QNN/QAIRT (CPU Snapdragon, GPU Adreno và NPU Hexagon), nhưng biên dịch tệp nhị phân context cục bộ bằng ONNX Runtime QNN Execution Provider — không cần tài khoản, không tải dữ liệu lên và không phải chờ hàng đợi. Đây là cách nhanh chóng để chuyển từ model
.ptsang bản dựng sẵn sàng cho Snapdragon ngay trong quy trình xuất YOLO tiêu chuẩn.Từ phiên bản
onnxruntime-qnn2.4.0 trở đi, package này cung cấp các wheel dựng sẵn cho Windows (x64 và ARM64) và Linux (x86-64 và ARM64) trên Python 3.11 trở lên; macOS không phải là host QNN được hỗ trợ. Quá trình tạo context-binary chạy trên host x64 và không cần thiết bị Snapdragon thực.Xuất bằng
model.export(format="qnn", imgsz=640)(imgsz=224cho tác vụ phân loại), sao chép tệpyolo26n_qnn.onnxthu được sang thiết bị Snapdragon, rồi chạyyolo predict model=yolo26n_qnn.onnx source=image.jpg(hoặcyolo val). Ultralytics tải tệp nhị phân context thông qua ONNX Runtime QNN Execution Provider và chạy trên NPU Hexagon — xem Triển khai model YOLO QNN đã xuất.QNN (Qualcomm AI Engine Direct, một phần của SDK QAIRT) là ngăn xếp suy luận hiện tại của Qualcomm và là lựa chọn thay thế được khuyến nghị cho SDK Snapdragon Neural Processing Engine (SNPE) cũ hơn. Các triển khai mới nên nhắm đến QNN.
Có, trên thiết bị Qualcomm Snapdragon đã cài
onnxruntime-qnn—YOLO("yolo26n_qnn.onnx")tải tệp nhị phân context thông qua QNN Execution Provider và chạypredict/valnhư mọi định dạng khác. Trên host x86 không có phần cứng QNN, model không thể thực thi vì tệp nhị phân context được thiết kế cho NPU Snapdragon.Quá trình xuất tạo một tệp ONNX context-binary độc lập (ví dụ:
yolo26n_qnn.onnx) có nhúng tên lớp, kích thước ảnh, tác vụ và metadata khác của model trong ONNXmetadata_props.
Bình luận
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.