Phân đoạn ngữ nghĩa với Ultralytics YOLO#
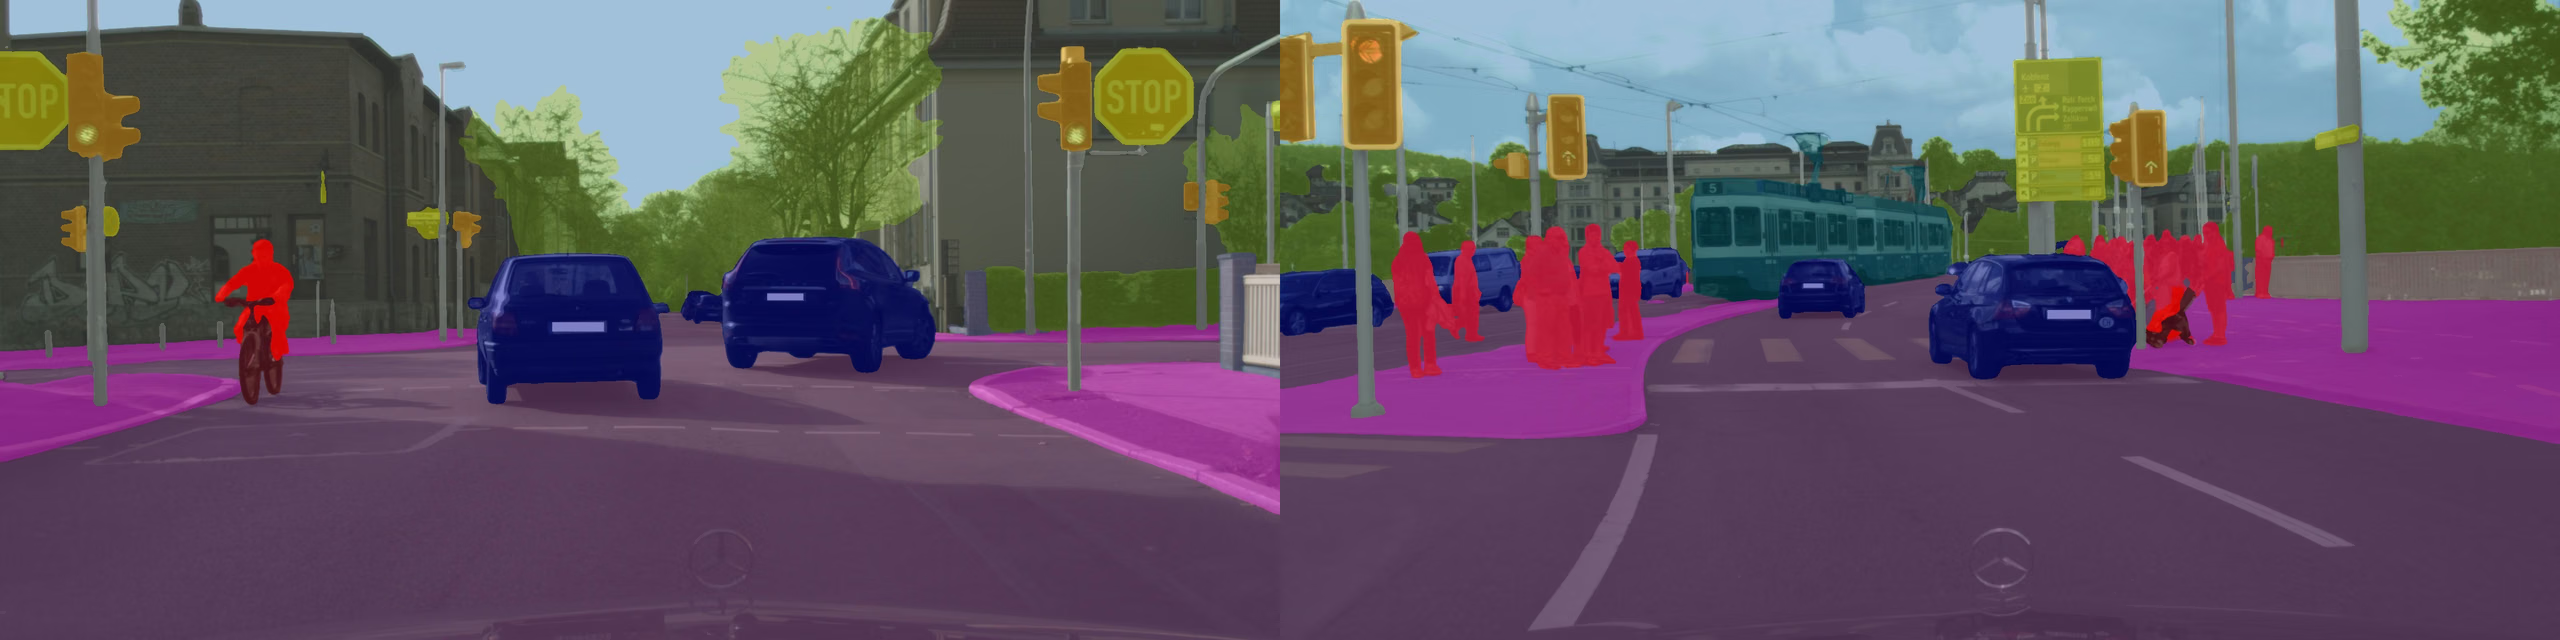
Phân đoạn ngữ nghĩa gán nhãn lớp cho mọi pixel trong một hình ảnh, tạo ra bản đồ lớp dày đặc bao phủ toàn bộ cảnh. Không giống phân đoạn đối tượng, vốn phân tách từng đối tượng riêng lẻ, phân đoạn ngữ nghĩa nhóm tất cả pixel cùng lớp lại với nhau bất kể có bao nhiêu đối tượng riêng biệt hiện diện.
Watch: Semantic Segmentation with Ultralytics YOLO26 | Quickstart Tutorial
Đầu ra của model phân đoạn ngữ nghĩa là một bản đồ lớp có kích thước bằng chiều cao × chiều rộng, trong đó giá trị của mỗi pixel tương ứng với ID lớp được dự đoán. Điều này khiến phân đoạn ngữ nghĩa phù hợp với các tác vụ phân tích cảnh như lái xe tự động, chụp ảnh y tế và lập bản đồ lớp phủ mặt đất.
Sử dụng tác vụ CLI task=semantic hoặc yolo semantic cho phân đoạn ngữ nghĩa. Các tệp model phân đoạn ngữ nghĩa YOLO26 sử dụng hậu tố -sem, chẳng hạn như yolo26n-sem.pt.
Models#
Các model phân đoạn ngữ nghĩa YOLO26 được pretrained trên dataset Cityscapes được hiển thị bên dưới.
Models được tự động tải xuống từ bản phát hành mới nhất của Ultralytics trong lần sử dụng đầu tiên.
| Model | kích thước (pixel) | mIoUval | Tốc độ RTX3090 PyTorch (ms) | tham số (M) | FLOPs (B) |
|---|---|---|---|---|---|
| YOLO26n-sem | 1024 × 2048 | 78.3 | 4.4 ± 0.0 | 1.6 | 23.8 |
| YOLO26s-sem | 1024 × 2048 | 80.8 | 8.4 ± 0.0 | 6.5 | 91.0 |
| YOLO26m-sem | 1024 × 2048 | 82.0 | 19.9 ± 0.1 | 14.3 | 305.5 |
| YOLO26l-sem | 1024 × 2048 | 82.9 | 26.5 ± 0.1 | 17.8 | 388.2 |
| YOLO26x-sem | 1024 × 2048 | 83.6 | 48.9 ± 0.2 | 40.1 | 866.9 |
- Các giá trị mIoUval là kết quả của một model, một scale trên tập validation Cityscapes.
Tái hiện bằngyolo semantic val data=cityscapes.yaml device=0 imgsz=2048 - Các chỉ số Speed được tính trung bình trên các ảnh validation của Cityscapes bằng một instance RTX3090.
Tái hiện bằngyolo semantic val data=cityscapes.yaml batch=1 device=0|cpu imgsz=2048 - Các giá trị Params và FLOPs áp dụng cho model đã fuse sau
model.fuse(), trong đó các layer Conv và BatchNorm được hợp nhất. Các checkpoint pretrained giữ nguyên kiến trúc training đầy đủ và có thể hiển thị số lượng cao hơn.
Các model phân đoạn ngữ nghĩa YOLO26 được pretrained trên dataset ADE20K được hiển thị bên dưới.
Models được tự động tải xuống từ bản phát hành mới nhất của Ultralytics trong lần sử dụng đầu tiên.
| Model | kích thước (pixel) | mIoUval | Tốc độ RTX3090 PyTorch (ms) | tham số (M) | FLOPs (B) |
|---|---|---|---|---|---|
| YOLO26n-sem-ade20k | 640 | 38.8 | 3.9 ± 0.2 | 1.6 | 4.5 |
| YOLO26s-sem-ade20k | 640 | 45.6 | 4.2 ± 0.3 | 6.5 | 17.5 |
| YOLO26m-sem-ade20k | 640 | 47.4 | 4.7 ± 0.3 | 14.4 | 59.6 |
| YOLO26l-sem-ade20k | 640 | 49.7 | 8.3 ± 0.2 | 17.9 | 75.2 |
| YOLO26x-sem-ade20k | 640 | 51.5 | 9.9 ± 0.3 | 40.2 | 168.4 |
- Các giá trị mIoUval là kết quả của một model, một scale trên tập validation ADE20K.
Tái hiện bằngyolo semantic val model=yolo26n-sem-ade20k.pt data=ade20k.yaml device=0 imgsz=640, thayyolo26n-sem-ade20k.ptbằng checkpointyolo26*-sem-ade20k.ptmong muốn. - Các chỉ số Speed được tính trung bình trên các ảnh validation của ADE20K bằng một instance RTX3090.
Tái hiện bằngyolo semantic val model=yolo26n-sem-ade20k.pt data=ade20k.yaml batch=1 device=0|cpu imgsz=640, thayyolo26n-sem-ade20k.ptbằng checkpointyolo26*-sem-ade20k.ptmong muốn. - Các giá trị Params và FLOPs áp dụng cho model đã fuse sau
model.fuse(), trong đó các layer Conv và BatchNorm được hợp nhất. Các checkpoint pretrained giữ nguyên kiến trúc training đầy đủ và có thể hiển thị số lượng cao hơn.
Xem bản xem trước YOLO27 chưa phát hành để biết kết quả mIoU sơ bộ trên Cityscapes.
Huấn luyện#
Train YOLO26n-sem trên dataset Cityscapes8 trong 100 epoch với kích thước ảnh là 1024. Xem danh sách đầy đủ các đối số hiện có trên trang Configuration.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-sem.yaml")  # build a new model from YAML
model = YOLO("yolo26n-sem.pt")  # load a pretrained model (recommended for training)
model = YOLO("yolo26n-sem.yaml").load("yolo26n-sem.pt")  # build from YAML and transfer weights

# Train the model
results = model.train(data="cityscapes8.yaml", epochs=100, imgsz=1024)
Xem thông tin đầy đủ về chế độ train trên trang Train. Các model phân đoạn ngữ nghĩa cũng có thể được train bằng Ultralytics Platform cloud training.
Định dạng dataset#
Dataset phân đoạn ngữ nghĩa sử dụng ảnh mask một kênh, thường ở định dạng PNG, trong đó giá trị của mỗi pixel biểu thị một ID lớp. Các pixel có giá trị 255 được xem là "ignore" và bị loại khỏi phép tính loss. YAML của dataset cần chỉ định đường dẫn đến các thư mục ảnh và mask tương ứng. Xem Semantic Segmentation Dataset Guide để biết chi tiết về định dạng. Các dataset được hỗ trợ gồm Cityscapes và ADE20K. Bạn có thể quản lý và gán nhãn dataset ngữ nghĩa bằng Ultralytics Platform annotation.
Val#
Validate độ chính xác của model YOLO26n-sem đã train trên dataset phân đoạn ngữ nghĩa. Truyền tường minh data để validation sử dụng đúng YAML của dataset.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-sem.pt")  # load an official model
model = YOLO("path/to/best.pt")  # load a custom model

# Validate the model
metrics = model.val(data="cityscapes.yaml")
metrics.miou  # mean Intersection over Union
metrics.pixel_accuracy # overall pixel accuracyPredict#
Sử dụng model YOLO26n-sem đã train để chạy dự đoán trên các ảnh.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-sem.pt")  # load an official model
model = YOLO("path/to/best.pt")  # load a custom model

# Predict with the model
results = model("https://ultralytics.com/images/bus.jpg")  # predict on an image

# Access the results
for result in results:
    semantic_mask = result.semantic_mask.data  # class map, shape (H,W), integer dtype selected by class count
Xem đầy đủ chi tiết về mode predict trên trang Predict.
Output kết quả#
Phân đoạn ngữ nghĩa YOLO trả về một đối tượng Results cho mỗi ảnh. Mỗi result lưu một bản đồ lớp dày đặc cho toàn bộ
ảnh thay vì một danh sách các mask đối tượng. Các pixel có cùng lớp được dự đoán sẽ dùng chung một ID lớp, ngay cả khi chúng
thuộc về các đối tượng riêng biệt.
| Thuộc tính | Kiểu | Shape | Mô tả |
|---|---|---|---|
result.semantic_mask | SemanticMask | (H,W) | Bản đồ lớp dày đặc. |
result.semantic_mask.data | torch.uint8torch.int16torch.int32 | (H,W) | ID lớp; dtype được chọn dựa trên số lượng lớp. |
result.masks | - | - | Không có mask của instance. |
result.boxes | - | - | Không có bbox/confidence của instance. |
result.masks.xy | - | - | Không có polygon mặc định. |
Để xem các field Results dành riêng cho từng task trên mọi task, hãy xem phần Predict Results by Task.
Phân đoạn ngữ nghĩa dự đoán một bản đồ lớp dày đặc, sau đó thay đổi kích thước bản đồ đó về hình dạng ảnh để trực quan hóa và
sử dụng cho các bước tiếp theo. Do đó, các cấu trúc rất mảnh như vạch làn đường, vạch sân, cột hoặc dây điện có thể trông
bậc thang khi inference chạy ở imgsz thấp hơn nhiều so với độ phân giải ảnh gốc. Nếu các biên có vẻ
lởm chởm, trước tiên hãy kiểm tra lại model PyTorch gốc .pt với imgsz lớn hơn,
chẳng hạn như 1024, 1280 hoặc giá trị thực tế gần nhất với kích thước ảnh nguồn. Chỉ sử dụng model đã export sau khi xác nhận đầu ra .pt là chấp nhận được,
vì input có độ phân giải thấp hơn không thể khôi phục chi tiết nhỏ vốn không xuất hiện trong bản đồ lớp được dự đoán.
Phân đoạn đối tượng và Phân đoạn ngữ nghĩa#
| Khía cạnh | Phân đoạn đối tượng (task="segment") | Phân đoạn ngữ nghĩa (task="semantic") |
|---|---|---|
| Mục tiêu dự đoán | Phân đoạn riêng từng đối tượng được phát hiện | Gán một ID lớp cho mọi pixel |
| Trường đầu ra | result.masks | result.semantic_mask |
| Dữ liệu chính | result.masks.data | result.semantic_mask.data |
| Shape | (N,H,W) | (H,W) |
| Giá trị pixel | Giá trị mask nhị phân: 0 hoặc 1 | ID lớp: 0, 1, 2, ... |
| Dtype | torch.uint8 | torch.uint8torch.int16torch.int32 |
| Các đối tượng cùng lớp | Được giữ thành các instance riêng biệt | Được hợp nhất vào cùng một vùng lớp |
| Polygon | Có, thông qua result.masks.xy và result.masks.xyn | Mặc định không có đầu ra polygon |
| BBox và confidence | Có, thông qua result.boxes | Không có bbox hoặc confidence score theo từng instance |
| Trường hợp sử dụng điển hình | Đếm, tracking, cắt ảnh, đo lường cấp đối tượng | Gán nhãn cảnh dày đặc, vùng có thể lái xe, lớp phủ mặt đất, vùng y tế |
Export#
Export model YOLO26n-sem sang định dạng khác như ONNX, CoreML, v.v.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-sem.pt")  # load an official model
model = YOLO("path/to/best.pt")  # load a custom model

# Export the model
model.export(format="onnx")
Các định dạng export phân đoạn ngữ nghĩa YOLO26 hiện có được liệt kê trong bảng bên dưới. Bạn có thể export sang bất kỳ định dạng nào bằng đối số format, tức là format='onnx' hoặc format='engine'. Bạn có thể dự đoán hoặc validate trực tiếp trên các model đã export, tức là yolo predict model=yolo26n-sem.onnx. Các ví dụ sử dụng cho model của bạn sẽ được hiển thị sau khi quá trình export hoàn tất.
| Định dạng | Argument format | Model | Metadata | Arguments |
|---|---|---|---|---|
| PyTorch | - | yolo26n-sem.pt | ✅ | - |
| TorchScript | torchscript | yolo26n-sem.torchscript | ✅ | imgsz, quantize, dynamic, nms, batch, device |
| ONNX | onnx | yolo26n-sem.onnx | ✅ | imgsz, quantize, dynamic, simplify, opset, nms, batch, data, fraction, device |
| OpenVINO | openvino | yolo26n-sem_openvino_model/ | ✅ | imgsz, quantize, dynamic, nms, batch, data, fraction, device |
| TensorRT | engine | yolo26n-sem.engine | ✅ | imgsz, quantize, dynamic, simplify, opset, workspace, nms, batch, data, fraction, device |
| CoreML | coreml | yolo26n-sem.mlpackage | ✅ | imgsz, dynamic, quantize, nms, batch, device |
| TF SavedModel | saved_model | yolo26n-sem_saved_model/ | ✅ | imgsz, keras, quantize, opset, nms, batch, data, fraction, device |
| TF GraphDef | pb | yolo26n-sem.pb | ❌ | imgsz, opset, batch, device |
| TF Edge TPU | edgetpu | yolo26n-sem_edgetpu.tflite | ✅ | imgsz, quantize, opset, data, fraction, device |
| PaddlePaddle | paddle | yolo26n-sem_paddle_model/ | ✅ | imgsz, batch, device |
| MNN | mnn | yolo26n-sem.mnn | ✅ | imgsz, batch, dynamic, quantize, simplify, opset, nms, device |
| NCNN | ncnn | yolo26n-sem_ncnn_model/ | ✅ | imgsz, quantize, batch, device |
| IMX500 | imx | yolo26n-sem_imx_model/ | ✅ | imgsz, quantize, data, fraction, nms, device |
| RKNN | rknn | yolo26n-sem_rknn_model/ | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| ExecuTorch | executorch | yolo26n-sem_executorch_model/ | ✅ | imgsz, batch, device |
| Axelera | axelera | yolo26n-sem_axelera_model/ | ✅ | imgsz, batch, quantize, data, fraction, device |
| DEEPX | deepx | yolo26n-sem_deepx_model/ | ✅ | imgsz, quantize, simplify, opset, data, optimize, device |
| Qualcomm QNN | qnn | yolo26n-sem_qnn.onnx | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| LiteRT | litert | yolo26n-sem.tflite | ✅ | imgsz, quantize, batch, data, fraction, device |
| Hailo | hailo | yolo26n-sem_hailo_model/ | ✅ | imgsz, name, quantize, data, fraction, simplify, conf, iou |
| Huawei Ascend | ascend | yolo26n-sem_ascend_model/ | ✅ | imgsz, batch, name, quantize, opset, simplify, nms |
| Apple Core AI | coreai | yolo26n-sem.aimodel | ✅ | imgsz, batch, quantize |
nms=None mặc định sử dụng đầu ra thô cho NMS bên ngoài. Thiết lập nms=False để chọn phần đầu không có NMS khả dụng; các định dạng không được hỗ trợ sẽ quay lại đường dẫn đầu ra gốc của chúng. Các mục nms ở trên xác định các định dạng có thể nhúng NMS bằng nms=True.
Xem đầy đủ chi tiết về export trên trang Export.
FAQ#
Để train model phân đoạn ngữ nghĩa YOLO26 trên dataset tùy chỉnh, bạn cần chuẩn bị các ảnh mask PNG trong đó giá trị của mỗi pixel biểu thị một ID lớp (0, 1, 2, ...) và các pixel có giá trị 255 sẽ bị bỏ qua trong quá trình training. Tạo tệp YAML của dataset trỏ đến các thư mục ảnh và mask, sau đó train model:
Ví dụfrom ultralytics import YOLO # Load a pretrained YOLO26 semantic segmentation model model = YOLO("yolo26n-sem.pt") # Train the model results = model.train(data="path/to/your_dataset.yaml", epochs=100, imgsz=512)Xem trang Configuration để biết thêm các argument khả dụng.
Phân đoạn đối tượng và phân đoạn ngữ nghĩa đều là các tác vụ cấp pixel nhưng khác nhau ở một điểm chính:
- Phân đoạn ngữ nghĩa gán nhãn lớp cho mọi pixel nhưng không phân biệt các đối tượng riêng lẻ cùng lớp. Ví dụ, tất cả ô tô trong một cảnh đều dùng chung một nhãn lớp.
- Phân đoạn đối tượng nhận diện riêng từng đối tượng, tạo ra các mask riêng biệt cho từng đối tượng ngay cả khi chúng thuộc cùng một lớp.
Phân đoạn ngữ nghĩa phù hợp nhất với các tác vụ hiểu cảnh như lái xe tự động và lập bản đồ lớp phủ mặt đất, trong khi phân đoạn đối tượng được ưu tiên khi cần đếm hoặc tracking từng đối tượng riêng lẻ.
Có. Nếu dataset của bạn sử dụng nhãn polygon Ultralytics YOLO (một
.txtcho mỗi ảnh), bỏ quamasks_dirtrong YAML của dataset và đảm bảo không có thư mụcmasks/nào tồn tại bên cạnh ảnh tại thư mục gốc của dataset (chỉ riêng sự hiện diện của thư mục này đã kích hoạt chế độ mask PNG ngay cả khi chưa đặtmasks_dir). Sau đó, loader sẽ chuyển đổi polygon thành mask ngữ nghĩa theo từng ảnh trong thời gian chạy. Đối với dataset đa lớp (N > 1), một lớpbackgroundbổ sung sẽ tự động được thêm vàonames. Đối với dataset một lớp (N == 1), training vẫn giữ ở 1 lớp — lớp bạn khai báo sẽ trở thành1trong mask và các pixel không được phủ sẽ trở thành0. Xem Semantic Segmentation Dataset Guide để biết chi tiết.Ultralytics YOLO26 cung cấp cấu hình tích hợp cho một số dataset phân đoạn ngữ nghĩa:
- Cityscapes: Các cảnh đường phố đô thị với 19 lớp, được sử dụng rộng rãi trong nghiên cứu lái xe tự động.
- ADE20K: Dataset phân tích cảnh quy mô lớn với 150 lớp.
Bạn cũng có thể sử dụng bất kỳ dataset tùy chỉnh nào cung cấp annotation mask PNG trong đó các giá trị pixel tương ứng với ID lớp.
Validate model phân đoạn ngữ nghĩa YOLO26 pretrained bằng YAML của dataset được sử dụng để đánh giá:
Ví dụfrom ultralytics import YOLO # Load a pretrained model model = YOLO("yolo26n-sem.pt") # Validate the model metrics = model.val(data="cityscapes.yaml") print("Mean IoU:", metrics.miou) print("Pixel Accuracy:", metrics.pixel_accuracy)Các bước này sẽ cung cấp cho bạn các chỉ số validation như Intersection over Union trung bình (mIoU) và độ chính xác pixel, là những thước đo tiêu chuẩn để đánh giá hiệu suất phân đoạn ngữ nghĩa.
Export model phân đoạn ngữ nghĩa YOLO26 sang định dạng ONNX bằng các lệnh Python hoặc CLI:
Ví dụfrom ultralytics import YOLO # Load a pretrained model model = YOLO("yolo26n-sem.pt") # Export the model to ONNX format model.export(format="onnx")Để biết thêm chi tiết về việc export sang nhiều định dạng khác nhau, hãy tham khảo trang Export.