Ước lượng Độ sâu Đơn ảnh với Ultralytics YOLO#
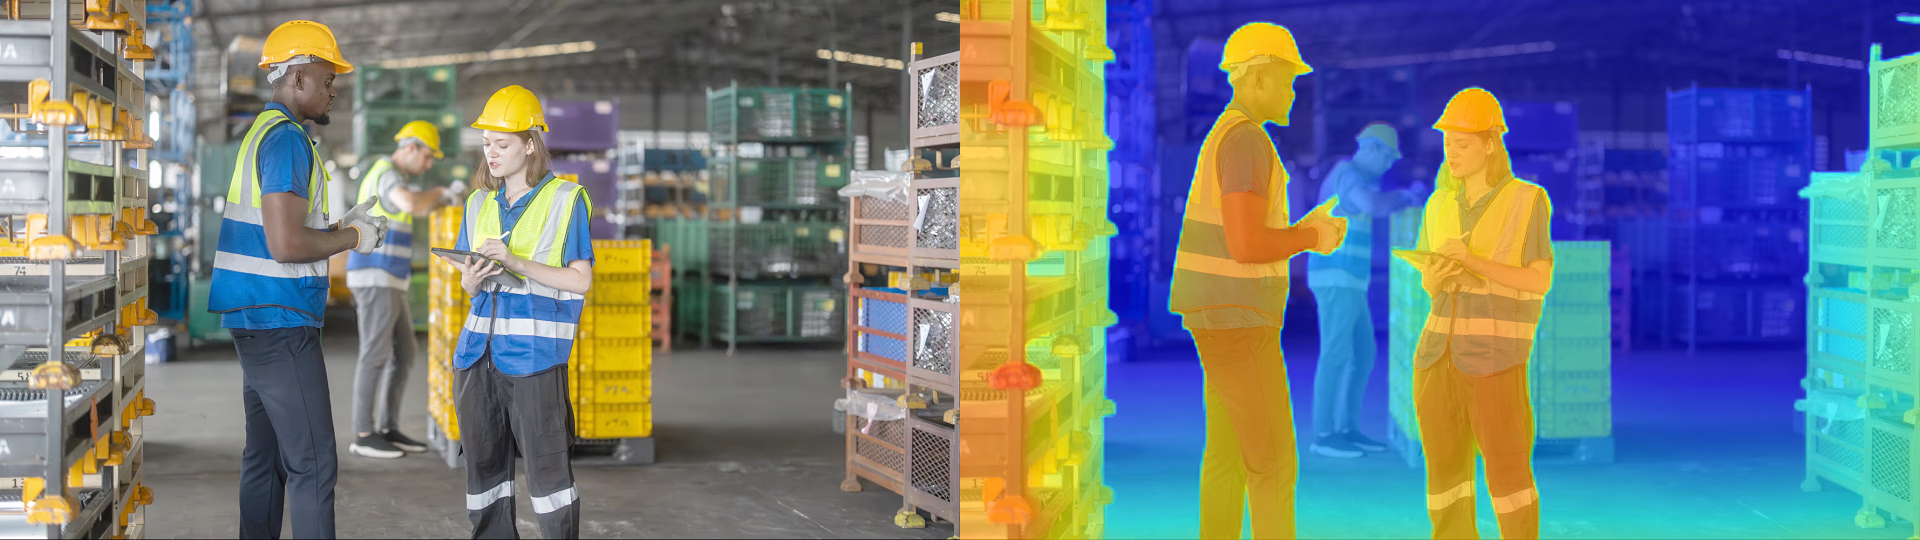
Ước lượng độ sâu đơn ảnh dự đoán bản đồ độ sâu theo từng pixel từ một ảnh RGB duy nhất. Mỗi pixel đầu ra chứa giá trị độ sâu tính bằng mét, biểu thị khoảng cách ước tính từ camera đến điểm bề mặt đó.
Đầu ra của model độ sâu là bản đồ float dày đặc có hình dạng (H, W), căn chỉnh với ảnh đầu vào. Biểu diễn theo từng pixel này khiến ước lượng độ sâu đơn ảnh phù hợp với việc tái tạo cảnh 3D, điều hướng robot, tạo nội dung AR/VR và mọi ứng dụng cần bố cục không gian từ một camera duy nhất.
Xem: Ước tính độ sâu đơn mắt với Ultralytics YOLO26 | Hướng dẫn Python | Vision AI 🚀
Sử dụng task=depth hoặc tác vụ CLI yolo depth để ước lượng độ sâu đơn ảnh. Các file model độ sâu YOLO26 sử dụng hậu tố -depth, chẳng hạn như yolo26n-depth.pt.
Model#
Các model độ sâu YOLO26 được pretrained trên tập hợp nhiều dataset đa dạng (trong nhà + ngoài trời, ~2.19M ảnh) được trình bày bên dưới. Các cột metric được báo cáo trên tập kiểm tra Eigen của NYU Depth V2.
Model sẽ tự động tải xuống từ bản phát hành Ultralytics mới nhất trong lần sử dụng đầu tiên.
| Model | kích thước (pixel) | delta1NYU | abs_relNYU | rmseNYU | Tốc độ CPU ONNX (ms) | Tốc độ T4 TensorRT10 (ms) | params (M) | FLOPs (B) |
|---|---|---|---|---|---|---|---|---|
| YOLO26n-depth | 768 | 0.882 | 0.109 | 0.414 | 272.0 ± 27.2 | 2.7 ± 0.1 | 6.3 | 46.9 |
| YOLO26s-depth | 768 | 0.896 | 0.104 | 0.399 | 393.7 ± 13.1 | 3.8 ± 0.0 | 13.2 | 68.0 |
| YOLO26m-depth | 768 | 0.921 | 0.089 | 0.364 | 621.5 ± 49.7 | 6.0 ± 0.1 | 23.3 | 130.4 |
| YOLO26l-depth | 768 | 0.930 | 0.083 | 0.351 | 821.9 ± 50.7 | 7.7 ± 0.1 | 27.7 | 157.0 |
| YOLO26x-depth | 768 | 0.933 | 0.080 | 0.344 | 1240.9 ± 73.3 | 13.6 ± 0.2 | 57.0 | 301.7 |
- delta1NYU là tỷ lệ pixel mà độ sâu dự đoán nằm trong phạm vi hệ số 1.25 so với ground truth, trên tập kiểm tra Eigen của NYU Depth V2 (654 ảnh), với TTA đa tỷ lệ + lật ngang và căn chỉnh bình phương tối thiểu theo log.
- Độ chính xác ở một tỷ lệ duy nhất, không dùng TTA, có thể tái lập bằng
yolo depth val model=yolo26n-depth.pt data=nyu-depth.yaml imgsz=768 device=0(thaymodel=cho mỗi kích thước); phương pháp này dùng căn chỉnh median (chỉ tỷ lệ) và cho điểm thấp hơn: delta1 0.783 (n), 0.793 (s), 0.840 (m), 0.853 (l), 0.860 (x). - abs_rel là sai số tương đối tuyệt đối trung bình giữa giá trị độ sâu dự đoán và ground truth.
- rmse là căn bậc hai của sai số bình phương trung bình, tính bằng mét.
- Tốc độ là độ trễ chỉ tính suy luận (không bao gồm tiền/hậu xử lý) ở
imgsz=768,batch=1, được báo cáo dưới dạng trung bình ± độ lệch chuẩn qua các lần chạy được đo sau warmup. CPU ONNX là ONNX Runtime fp32 trên Intel Xeon 32 lõi (Skylake); T4 TensorRT10 là TensorRT fp16 trên Tesla T4. - params và FLOPs được đo ở kích thước 768×768, độ phân giải huấn luyện của các weight được phát hành.
Xem bản xem trước YOLO27 chưa phát hành để biết kết quả sơ bộ trên NYU Depth V2.
So sánh tốc độ với Depth Anything V2#
Depth Anything V2 là một baseline mở được sử dụng rộng rãi cho bài toán ước lượng độ sâu đơn ảnh. Backbone DINOv2 Transformer thị giác và decoder DPT đòi hỏi nhiều tài nguyên tính toán, vì vậy khi chạy TensorRT fp16 trên cùng một Tesla T4, model Depth Anything V2 nhỏ nhất đã phát hành chạy chậm hơn mọi model độ sâu YOLO26 — kể cả YOLO26x-depth, vốn có số lượng tham số nhiều hơn gấp đôi.
Ở mức ~768 px — imgsz=768 cho YOLO26, độ phân giải mà các weight đã phát hành được huấn luyện, và 770 px cho Depth Anything V2, vì backbone DINOv2 yêu cầu kích thước là bội số của patch size 14:
| Model | params (M) | FLOPs (B) | T4 TensorRT10 (ms) | FPS | Tăng tốc so với V2 Small | Tăng tốc so với V2 Base |
|---|---|---|---|---|---|---|
| Depth Anything V2 Base | 97.5 | 1025.5 | 55.40 | 18.1 | — | — |
| Depth Anything V2 Small | 24.8 | 346.9 | 20.99 | 47.6 | — | — |
| YOLO26x-depth | 57.0 | 301.7 | 13.57 | 73.7 | 1.5× | 4.1× |
| YOLO26l-depth | 27.7 | 157.0 | 7.68 | 130.2 | 2.7× | 7.2× |
| YOLO26m-depth | 23.3 | 130.4 | 6.00 | 166.7 | 3.5× | 9.2× |
| YOLO26s-depth | 13.2 | 68.0 | 3.82 | 261.6 | 5.5× | 14.5× |
| YOLO26n-depth | 6.3 | 46.9 | 2.73 | 365.8 | 7.7× | 20.3× |
Ở mức ~640 px — lần lượt là imgsz=640 và 644 px — thứ tự không thay đổi, và YOLO26n-depth nhanh hơn Depth Anything V2 Small 5.9×:
| Model | T4 TensorRT10 (ms) | FPS |
|---|---|---|
| Depth Anything V2 Base | 35.10 | 28.5 |
| Depth Anything V2 Small | 13.62 | 73.4 |
| YOLO26x-depth | 10.26 | 97.5 |
| YOLO26l-depth | 6.14 | 162.8 |
| YOLO26m-depth | 4.71 | 212.1 |
| YOLO26s-depth | 3.08 | 324.4 |
| YOLO26n-depth | 2.29 | 436.9 |
- Độ trễ chỉ tính suy luận,
batch=1, TensorRT fp16 trên Tesla T4 — sử dụng cùng bộ kiểm thử như bảng model ở trên, kết quả ở đây được hiển thị đến hai chữ số thập phân; FPS là nghịch đảo của độ trễ chưa làm tròn. Các cột Tăng tốc lấy độ trễ của Depth Anything V2 Small (20.99 ms) và Base (55.40 ms) chia cho độ trễ của YOLO26. - Depth Anything V2 Small và Base lần lượt là các checkpoint ViT-S và ViT-B được phát hành.
- Phần so sánh chỉ xét độ trễ — hai họ model không được đánh giá theo cùng một quy trình đo độ chính xác.
Phạm vi độ sâu và head độ sâu log#
Head độ sâu dự đoán exp(logit) — không giới hạn (~0.02–150 m) — và tách hình dạng cảnh khỏi tỷ lệ tuyệt đối: mạng dự đoán trường độ sâu log tương đối, còn giá trị mét tuyệt đối được xác định bằng một phép biến đổi hai tham số riêng (exp(a·log d + b)), được khôi phục khi đánh giá, bằng hiệu chuẩn nhẹ hoặc qua fine-tuning. Phương án phổ biến khác là head sigmoid × max_depth có giới hạn, thay vào đó tích hợp ngưỡng cố định vào kiến trúc, vì vậy mọi độ sâu vượt quá max_depth đều bị cắt — điều này ngăn việc huấn luyện và dự đoán các cảnh có tầm xa hơn.
A/B có kiểm soát — cùng dữ liệu, cùng lịch huấn luyện, chỉ khác head. Huấn luyện cả hai head từ đầu trên cùng một tập dữ liệu trong nhà (≤10 m) và ngoài trời (≤80 m):
| Head | Phạm vi đầu ra | δ1 xác thực trên phạm vi hỗn hợp | Hành vi huấn luyện |
|---|---|---|---|
sigmoid × max_depth (10 m) | giới hạn 0–10 m | 0.221 | chững lại ở epoch 1 |
log (không giới hạn) | 0–~150 m | 0.367 (+66%) | cải thiện trong suốt quá trình |
Head có giới hạn không thể biểu diễn phần lớn pixel ngoài trời ở khoảng cách >10 m, nên gần như ngừng cải thiện ngay lập tức; head log học được trên toàn bộ phạm vi.
Vấn đề được khắc phục — fine-tuning trên một dataset, phân tầng theo phạm vi. Fine-tuning head có giới hạn (10 m) trên từng dataset riêng lẻ cho kết quả tốt khi dữ liệu nằm trong giới hạn và suy giảm nghiêm trọng khi vượt quá giới hạn đó:
| Dataset | Phạm vi độ sâu | δ1 của head có giới hạn |
|---|---|---|
| SUN RGB-D | ≤10 m | 0.78 ✅ |
| Hypersim | phần lớn ≤10 m | 0.74 ✅ |
| KITTI | ~80 m | 0.08 ❌ (abs_rel ≈ 7.0 — độ lệch tỷ lệ 80/10) |
| vKITTI2 | 80 m | 0.04 ❌ |
Sự suy giảm xảy ra chính xác tại ngưỡng giới hạn. Head log không có ngưỡng như vậy.
Các model đã phát hành — hiệu năng trên nhiều phạm vi. Họ model log đã phát hành, được đánh giá trên các benchmark có phạm vi từ 10 m (NYU, iBims-1) đến 80 m (KITTI), với δ1 đã căn chỉnh tỷ lệ:
| Benchmark | Phạm vi | YOLO26x-depth (log) | bản phát hành có giới hạn trước đó |
|---|---|---|---|
| NYU Eigen | 10 m | 0.933 | 0.934 |
| iBims-1 | 10 m | 0.961 | 0.945 |
| ETH3D | ~60 m | 0.959 | 0.931 |
| Make3D | ~70 m | 0.302 | 0.296 |
| KITTI Eigen | 80 m | 0.942 | 0.891 |
| Trung bình | — | 0.819 | 0.799 |
Cả hai cột đều giữ nguyên số liệu đã công bố. Các hàng còn lại được chấm điểm theo quy trình TTA và bình phương tối thiểu theo log được mô tả trên trang dataset tương ứng; validator trong repo này không triển khai quy trình đó, nên không thể đo lại hàng KITTI theo cùng điều kiện. Trang KITTI cung cấp các số liệu được đo trên tập Eigen chuẩn gồm 652 khung hình.
Mức cải thiện lớn nhất nằm ở các benchmark ngoài trời có tầm xa hơn (KITTI, ETH3D) — chính là nơi giới hạn cố định 10 m gây ảnh hưởng lớn nhất — trong khi hiệu năng trong nhà vẫn được duy trì.
Huấn luyện#
Huấn luyện YOLO26n-depth trên dataset Depth8 trong 100 epoch ở kích thước ảnh 640. Xem trang Cấu hình để biết danh sách đầy đủ các tham số hiện có.
from ultralytics import YOLO

# Tải model
model = YOLO("yolo26n-depth.yaml")  # tạo model mới từ YAML
model = YOLO("yolo26n-depth.pt")  # tải model đã huấn luyện trước (được khuyến nghị khi huấn luyện)
model = YOLO("yolo26n-depth.yaml").load("yolo26n-depth.pt")  # tạo từ YAML và chuyển trọng số

# Huấn luyện model
results = model.train(data="depth8.yaml", epochs=100, imgsz=640)
Xem chi tiết đầy đủ về chế độ train trên trang Huấn luyện. Bạn cũng có thể huấn luyện model độ sâu bằng dịch vụ huấn luyện đám mây Ultralytics Platform.
Định dạng dataset#
Dataset ước lượng độ sâu ghép mỗi ảnh RGB với ảnh độ sâu PNG uint16 đã scale hoặc bản đồ độ sâu NPY dấu phẩy động tính bằng mét. Mặc định, giá trị PNG dùng đơn vị milimét; dataset dùng quy ước khác sẽ đặt depth_scale trong YAML. Loader xác định đường dẫn ảnh độ sâu bằng cách thay thành phần images bằng depth, ưu tiên .png và dùng .npy làm phương án dự phòng.
dataset/
├── images/
│   ├── train/
│   └── val/
└── depth/
    ├── train/
    └── val/
Ví dụ: ảnh tại images/train/scene_001.jpg được ghép với bản đồ độ sâu tại depth/train/scene_001.png. Xem Hướng dẫn Dataset Ước lượng Độ sâu để biết đầy đủ thông số định dạng.
Fine-tuning trên dữ liệu của riêng bạn#
Khi điều chỉnh model độ sâu đã pretrained cho dataset tùy chỉnh, hãy giảm learning rate và sử dụng optimizer AdamW. Cấu hình optimizer mặc định được tinh chỉnh cho việc huấn luyện từ đầu; khi áp dụng cho model độ sâu đã hội tụ, cấu hình này có thể ghi đè kiến thức pretrained và làm giảm kết quả — đặc biệt khi fine-tuning trên một miền dữ liệu duy nhất.
from ultralytics import YOLO

model = YOLO("yolo26s-depth.pt")  # bắt đầu từ weights đã pretrained

model.train(
    data="path/to/your_dataset.yaml",
    epochs=20,
    imgsz=640,
    optimizer="AdamW",
    lr0=1e-4,  # ~thấp hơn khoảng 100x so với mặc định khi huấn luyện từ đầu
    warmup_bias_lr=1e-4,  # giữ warmup nhẹ nhàng
)
Mẹo bổ sung:
- Augmentation được kiểm soát bằng các args tiêu chuẩn (
degrees,translate,scale,shear,perspective,flipud,fliplr,hsv_h,hsv_s,hsv_v); phép biến đổi hình học và lật được áp dụng giống hệt cho depth map đi kèm. Để xem công thức chính xác được dùng cho weights YOLO26-Depth đã phát hành, hãy kiểm tratrain_argsđược lưu trong checkpoint — xem Kiểm tra các tham số huấn luyện của checkpoint YOLO26. mosaic,mixup,cutmixvàcopy_pastekhông được triển khai cho depth. Bộ nạp depth dataset tự động đặt các xác suất này về 0, vì vậy truyền chúng vào sẽ không có tác dụng. Các phép augmentation này không được hỗ trợ vì chúng kết hợp nhiều ảnh, khiến các depth map đi kèm không hợp lệ.- Mọi dải depth đều hoạt động ngay sau khi cài đặt. Các model có head
logdự đoán depth không giới hạn, nên thích ứng với dữ liệu cự ly ngắn (macro) hoặc cự ly xa (ngoài trời/lái xe) mà không cần thay đổi. Đặtmax_depth:trong YAML dataset (theo mét) để giới hạn những pixel GT được tính vào các metric validation. - Duy trì hiệu suất tổng quát. Nếu cần model duy trì độ chính xác trên các cảnh nằm ngoài tập huấn luyện, hãy trộn một tỷ lệ nhỏ (~5–10%) ảnh đa dạng, phục vụ mục đích tổng quát vào dữ liệu huấn luyện; cách này giảm đáng kể hiện tượng quên trong quá trình fine-tune.
- Chỉ huấn luyện từ đầu (
model=yolo26s-depth.yaml) nếu miền của bạn rất khác biệt và bạn có dataset lớn — trong trường hợp đó,optimizer=automặc định là phù hợp vì không có weights pretrained cần được giữ lại.
Hiệu chỉnh scale depth#
Head depth tách biệt shape (cấu trúc tương đối của cảnh) với scale (đơn vị mét tuyệt đối). Nếu model đã tạo depth tương đối tốt trên các cảnh của bạn nhưng các giá trị tuyệt đối không đúng với camera, bạn có thể hiệu chỉnh scale trong vài giây bằng model.calibrate() — phép fit dạng đóng, chỉ hiệu chỉnh scale cho biến đổi log-affine của head dựa trên một tập nhỏ có nhãn; chỉ giữ lại kết quả khi δ1 trên tập giữ lại cross-validation được cải thiện, không huấn luyện bằng gradient và không thay đổi weights của network, do đó không thể làm suy giảm cấu trúc tương đối.
from ultralytics import YOLO

model = YOLO("yolo26s-depth.pt")

# Fit scale trên một tập con có nhãn (khoảng 100+ ảnh là đủ), sau đó lưu lại
model.calibrate(data="path/to/your_dataset.yaml")
model.save("yolo26s-depth-calibrated.pt")
Hiệu chỉnh cần có depth ground truth để fit, vì vậy quy trình chạy trên một tập con có nhãn — không thể thực hiện trong quá trình inference không có nhãn. Quy trình fit và chấm điểm trên cùng các pixel được đánh giá bằng metric val: GT bằng hoặc vượt quá max_depth trong YAML dataset (mặc định 100 m) sẽ bị loại trừ. Hãy sử dụng khi depth tương đối đã tốt và chỉ scale/dải giá trị chưa đúng; nếu bản thân cấu trúc tương đối cần thay đổi cho miền của bạn, hãy fine-tune.
Quá trình huấn luyện tự động thực hiện việc này: sau khi model.train(...) hoàn tất, các checkpoint tốt nhất và cuối cùng được hiệu chỉnh trên tập validation để có thể tạo depth theo thang đo mét ngay sau khi cài đặt.
Các checkpoint yolo26*-depth.pt đã phát hành được tích hợp sẵn hiệu chỉnh này, được fit trên tập validation kết hợp trong giai đoạn pretraining. Đây là một scale toàn cục duy nhất áp dụng cho mọi miền, vì vậy để có depth tuyệt đối chính xác nhất trên một camera hoặc loại cảnh cụ thể, hãy chạy model.calibrate() trên một tập con nhỏ có nhãn từ dữ liệu của riêng bạn — thao tác này thay thế kết quả fit tích hợp sẵn.
Thu thập dữ liệu độ sâu ground truth mà không cần camera đo độ sâu#
Nếu camera không có cảm biến độ sâu, bạn vẫn có thể hiệu chuẩn camera. Quá trình hiệu chuẩn khớp một hệ số tỷ lệ toàn cục và bỏ qua các pixel có giá trị độ sâu bằng 0, vì vậy chỉ cần một vài điểm đo cho mỗi ảnh.
-
Thu thập ảnh. Chụp từ 50 đến 150 ảnh bằng camera ở độ phân giải và các thiết lập ống kính dự kiến sử dụng khi triển khai, rồi đưa ảnh vào
dataset/images/val/. Quá trình hiệu chuẩn đọc splitval. -
Gán nhãn độ sâu. Sử dụng một trong hai phương pháp dưới đây. Cả hai đều ghi một bản đồ độ sâu cho mỗi ảnh vào
dataset/depth/val/theo định dạng dataset.
Đo khoảng cách đến một vài điểm trong mỗi ảnh bằng máy đo khoảng cách laser hoặc thước dây, trên các bề mặt phẳng cách xa cạnh vật thể, rồi ghi lại tọa độ pixel của từng điểm trong points.csv:
image,x,y,meters
img_0001.jpg,352,453,3.15
img_0001.jpg,28,300,2.672
Sau đó, ghi các bản đồ độ sâu, để giá trị của mọi pixel chưa đo ở mức 0. Mỗi điểm được vẽ thành một chấm nhỏ để vẫn hiển thị sau khi đổi kích thước thành imgsz:
import csv
from collections import defaultdict
from pathlib import Path

import cv2
import numpy as np

points = defaultdict(list)
with open("points.csv") as f:  # columns: image, x, y, meters
    for row in csv.DictReader(f):
        points[row["image"]].append((int(row["x"]), int(row["y"]), float(row["meters"])))

for name, pts in points.items():
    h, w = cv2.imread(f"dataset/images/val/{name}").shape[:2]
    depth = np.zeros((h, w), np.uint16)  # 0 means no label
    r = max(h, w) // 768 + 1  # dot radius that survives the resize to imgsz=768
    for x, y, meters in pts:
        cv2.circle(depth, (x, y), r, round(meters * 100), -1)  # centimeters, matching depth_scale: 100
    out = Path("dataset/depth/val") / f"{Path(name).stem}.png"
    out.parent.mkdir(parents=True, exist_ok=True)
    cv2.imwrite(str(out), depth)
Máy đo khoảng cách đo khoảng cách đường thẳng đến một điểm, trong khi bản đồ độ sâu lưu khoảng cách dọc theo trục nhìn của camera. Hai giá trị trùng nhau ở tâm ảnh và chênh lệch khoảng 3,5% tại vị trí lệch tâm 15°, vì vậy hãy đo các điểm gần tâm hoặc chuyển đổi từng số đo bằng meters / sqrt(1 + ((x - cx) / fx) ** 2 + ((y - cy) / fy) ** 2) sử dụng thông số nội tại của camera.
-
Ghi YAML của dataset thành
calib.yaml.depth_scale: 100đọc các ảnh PNG tính bằng centimet từ những điểm đo và bị bỏ qua đối với bản đồ NPY:path: dataset train: images/val val: images/val depth_scale: 100 # PNG value 100 = 1 meter names: 0: depth -
Hiệu chuẩn và lưu, sau đó tải
yolo26s-depth-calibrated.ptđể dự đoán hoặc export:from ultralytics import YOLO model = YOLO("yolo26s-depth.pt") model.calibrate(data="calib.yaml", imgsz=768) model.save("yolo26s-depth-calibrated.pt")
Trong các thử nghiệm với yolo26s-depth.pt và 150 ảnh cho mỗi camera, kết quả hiệu chuẩn được phát hành có sai lệch từ 4% đến 46% so với hệ số tỷ lệ khớp trên ground truth đầy đủ đối với NYU, KITTI và camera có ống kính góc hẹp. Hiệu chuẩn bằng 5 điểm đo cho mỗi ảnh cho kết quả chênh lệch dưới 1% so với hệ số đó, còn khi dùng nhãn DA3METRIC-LARGE thì chênh lệch dưới 7%. Tăng số lượng ảnh có ích hơn tăng số điểm trên mỗi ảnh: 150 ảnh, mỗi ảnh có 1 điểm, cho kết quả chênh lệch khoảng 3%, trong khi 20 ảnh, mỗi ảnh có 5 điểm, cho kết quả sai lệch đến 9%.
Đánh giá#
Xác thực độ chính xác của model YOLO26n-depth đã huấn luyện trên dataset ước tính độ sâu. Truyền tường minh data để quá trình xác thực sử dụng đúng YAML của dataset. Các trọng số được phát hành được huấn luyện ở imgsz=768 trên ảnh được kéo giãn thành hình vuông thay vì thêm padding theo letterbox, vì vậy hãy xác thực và dự đoán ở kích thước đó để đạt độ chính xác tốt nhất. Quá trình dự đoán, xác thực và model.calibrate() đều kéo giãn đầu vào theo cùng một cách.
from ultralytics import YOLO

# Tải model
model = YOLO("yolo26n-depth.pt")  # tải model chính thức
model = YOLO("path/to/best.pt")  # tải model tùy chỉnh

# Xác thực model
metrics = model.val(data="nyu-depth.yaml")
metrics.delta1  # tỷ lệ pixel nằm trong ngưỡng δ=1.25
metrics.abs_rel  # sai số tương đối tuyệt đối trung bình
metrics.rmse  # căn bậc hai của sai số bình phương trung bình (mét)
metrics.silog  # sai số logarit bất biến theo scale
Dự đoán#
Sử dụng model YOLO26n-depth đã huấn luyện để chạy dự đoán trên ảnh.
from ultralytics import YOLO

# Tải model
model = YOLO("yolo26n-depth.pt")  # tải model chính thức
model = YOLO("path/to/best.pt")  # tải model tùy chỉnh

# Dự đoán bằng model
results = model("https://ultralytics.com/images/bus.jpg")  # dự đoán trên một ảnh

# Truy cập kết quả
for result in results:
    depth_map = result.depth.data.cpu().numpy()  # torch.Tensor -> NumPy float32, shape (H, W), đơn vị mét
Xem chi tiết đầy đủ về chế độ predict trên trang Dự đoán.
Đầu ra kết quả#
Ước tính depth bằng YOLO trả về một object Results cho mỗi ảnh. Mỗi result lưu một depth map float dày đặc cho toàn bộ ảnh.
| Thuộc tính | Kiểu | Hình dạng | Mô tả |
|---|---|---|---|
result.depth | DepthMap | (H,W) | Bản đồ độ sâu dày đặc theo từng pixel. |
result.depth.data | torch.Tensor | (H,W) | Giá trị độ sâu tính bằng mét; gọi .cpu().numpy() để lấy NumPy. |
result.boxes | - | - | Không có bbox đối tượng. |
result.masks | - | - | Không có mask đối tượng. |
Để xem các trường Results dành riêng cho từng tác vụ trên tất cả tác vụ, hãy tham khảo mục Kết quả dự đoán theo tác vụ.
Ước tính độ sâu từng đối tượng bằng phân đoạn instance#
Kết hợp phân đoạn instance với độ sâu để ước tính khoảng cách của từng đối tượng được phát hiện. Chạy cả hai model trên cùng một ảnh bằng retina_masks=True để các mask có cùng độ phân giải với bản đồ độ sâu ở độ phân giải ảnh gốc, rồi lấy trung vị của các pixel độ sâu hợp lệ bên trong từng mask.
from ultralytics import YOLO

image = "https://ultralytics.com/images/bus.jpg"
seg = YOLO("yolo26n-seg.pt")(image, retina_masks=True)[0]
depth = YOLO("yolo26n-depth.pt")(image)[0].depth.data  # (H, W) meters

if seg.masks is not None:
    for mask, cls in zip(seg.masks.data.bool(), seg.boxes.cls):
        values = depth[mask & (depth > 0)]  # valid depth pixels inside this mask
        if values.numel():
            print(f"{seg.names[int(cls)]}: {values.median():.2f} m")
Trung vị ít bị ảnh hưởng bởi các pixel nền ở rìa mask, nhưng phản ánh bề mặt nhìn thấy được của đối tượng thay vì tâm đối tượng; độ chính xác phụ thuộc vào thang đo độ sâu của model (xem Hiệu chỉnh thang đo độ sâu).
Tô màu depth map#
Depth map thô là một mảng float một kênh, đơn vị mét — hữu ích cho tính toán nhưng khó đọc trực tiếp. Để chuyển thành ảnh màu, hãy dùng helper colorize_depth trong ultralytics.utils.plotting, helper này ánh xạ mảng depth (H, W) sang ảnh BGR uint8 thuộc (H, W, 3) (các pixel không hợp lệ <= 0 được hiển thị màu đen).
result.plot() đã phủ màu hóa này lên ảnh đầu vào bằng các giá trị mặc định (cmap="jet", mode="disparity"); gọi trực tiếp colorize_depth khi bạn muốn có ảnh depth màu độc lập hoặc dùng colormap hay chuẩn hóa khác.
import cv2

from ultralytics import YOLO
from ultralytics.utils.plotting import colorize_depth

model = YOLO("yolo26n-depth.pt")
result = model("https://ultralytics.com/images/bus.jpg")[0]

depth = result.depth.data.cpu().numpy()  # (H, W) float32, meters

# Tô màu với vùng gần = màu ấm rồi lưu
cv2.imwrite("depth_colored.png", colorize_depth(depth, cmap="spectral"))  # (H, W, 3) BGR uint8

# Cố định dải giá trị ở mức 0-20 m để cùng một màu biểu thị cùng một khoảng cách qua các frame
cv2.imwrite("depth_metric.png", colorize_depth(depth, vmin=0.0, vmax=20.0, cmap="inferno", mode="metric"))

# Lớp phủ pha trộn trực tiếp từ object Results (dùng cmap="jet", mode="disparity")
result.save("depth_overlay.png")
Mọi colormap đều chuyển từ tông lạnh/tối → ấm/sáng. mode quyết định đầu nào biểu thị vùng gần, còn vmin/vmax cố định dải giá trị qua các frame để một màu luôn biểu thị cùng một khoảng cách.
| Đối số | Giá trị | Mô tả |
|---|---|---|
cmap | jet (mặc định) | Tương phản cao, chuyển từ xanh dương → xanh lá → đỏ; đây là bảng màu mà result.plot() sử dụng. |
cmap | inferno | Đen → tím → cam → vàng. Đồng đều về cảm nhận, thân thiện với người mù màu và dễ đọc ở thang xám. |
cmap | spectral | Đỏ → vàng → xanh lá → xanh dương (Spectral_r của matplotlib). |
mode | disparity (mặc định) | Chuẩn hóa depth nghịch đảo (1/d) trong khoảng từ phân vị thứ 2 đến thứ 98; màu ấm biểu thị vùng gần, còn các giá trị ngoại lệ ở xa được gộp lại. |
mode | metric | Chuẩn hóa depth theo mét tuyến tính trong khoảng từ vmin đến vmax; màu ấm biểu thị vùng xa, nhờ đó màu sắc phản ánh khoảng cách thực. |
Export#
Export model YOLO26n-depth sang định dạng khác như ONNX, CoreML, v.v.
from ultralytics import YOLO

# Tải model
model = YOLO("yolo26n-depth.pt")  # tải model chính thức
model = YOLO("path/to/best.pt")  # tải model tùy chỉnh

# # Xuất model
model.export(format="onnx")
Các định dạng export hiện có cho ước tính depth YOLO26 được liệt kê trong bảng bên dưới. Bạn có thể export sang bất kỳ định dạng nào bằng tham số format, chẳng hạn format='onnx' hoặc format='engine'. Bạn có thể predict hoặc validate trực tiếp trên các model đã export, chẳng hạn yolo predict model=yolo26n-depth.onnx. Ví dụ sử dụng cho model của bạn sẽ hiển thị sau khi quá trình export hoàn tất.
| Định dạng | Đối số format | Model | Metadata | Đối số |
|---|---|---|---|---|
| PyTorch | - | yolo26n-depth.pt | ✅ | - |
| TorchScript | torchscript | yolo26n-depth.torchscript | ✅ | imgsz, quantize, dynamic, nms, batch, device |
| ONNX | onnx | yolo26n-depth.onnx | ✅ | imgsz, quantize, dynamic, simplify, opset, nms, batch, data, fraction, device |
| OpenVINO | openvino | yolo26n-depth_openvino_model/ | ✅ | imgsz, quantize, dynamic, nms, batch, data, fraction, device |
| TensorRT | engine | yolo26n-depth.engine | ✅ | imgsz, quantize, dynamic, simplify, opset, workspace, nms, batch, data, fraction, device |
| CoreML | coreml | yolo26n-depth.mlpackage | ✅ | imgsz, dynamic, quantize, nms, batch, device |
| Apple Core AI | coreai | yolo26n-depth.aimodel | ✅ | imgsz, batch, quantize |
| TF SavedModel | saved_model | yolo26n-depth_saved_model/ | ✅ | imgsz, quantize, opset, nms, batch, data, fraction, device |
| TF GraphDef | pb | yolo26n-depth.pb | ❌ | imgsz, opset, batch, device |
| TF Edge TPU | edgetpu | yolo26n-depth_edgetpu.tflite | ✅ | imgsz, quantize, opset, data, fraction, device |
| LiteRT | litert | yolo26n-depth.tflite | ✅ | imgsz, quantize, batch, data, fraction, device |
| PaddlePaddle | paddle | yolo26n-depth_paddle_model/ | ✅ | imgsz, batch, device |
| MNN | mnn | yolo26n-depth.mnn | ✅ | imgsz, batch, dynamic, quantize, simplify, opset, nms, device |
| NCNN | ncnn | yolo26n-depth_ncnn_model/ | ✅ | imgsz, quantize, batch, device |
| IMX500 | imx | yolo26n-depth_imx_model/ | ✅ | imgsz, quantize, data, fraction, nms, device |
| RKNN | rknn | yolo26n-depth_rknn_model/ | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| ExecuTorch | executorch | yolo26n-depth_executorch_model/ | ✅ | imgsz, batch, device |
| Axelera | axelera | yolo26n-depth_axelera_model/ | ✅ | imgsz, batch, quantize, data, fraction, device |
| DEEPX | deepx | yolo26n-depth_deepx_model/ | ✅ | imgsz, quantize, simplify, opset, data, optimize, device |
| Qualcomm QNN | qnn | yolo26n-depth_qnn.onnx | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| Hailo | hailo | yolo26n-depth_hailo_model/ | ✅ | imgsz, name, quantize, data, fraction, simplify, conf, iou, device |
| Huawei Ascend | ascend | yolo26n-depth_ascend_model/ | ✅ | imgsz, batch, name, quantize, opset, simplify, nms, device |
| AMD Xilinx | xilinx | yolo26n-depth_xilinx_model/ | ✅ | imgsz, name, quantize, data, fraction, opset, simplify, device |
nms=None mặc định xuất đầu ra thô cho NMS bên ngoài. Đặt nms=False để chọn một head không dùng NMS hiện có; các định dạng không được hỗ trợ sẽ chuyển về luồng đầu ra gốc. Các mục nms ở trên xác định những định dạng có thể tích hợp NMS với nms=True.
Xem chi tiết đầy đủ về export trên trang Export.
Câu hỏi thường gặp#
Chuẩn bị các ảnh RGB đi kèm với ảnh depth PNG 16-bit hoặc depth map NPY dạng dấu phẩy động, đơn vị mét; sau đó tạo YAML dataset trỏ đến thư mục
images/của bạn. Bộ nạp tự động tìm các file depth bằng cách thayimagesbằngdepthtrong đường dẫn, ưu tiên.pngvà dùng.npynếu không có.Bắt đầu từ weights pretrained và dùng learning rate thấp cùng AdamW để fine-tune giữ lại những gì model đã biết (xem Fine-tune trên dữ liệu của riêng bạn để biết lý do):
Ví dụfrom ultralytics import YOLO # Tải model depth YOLO26 pretrained model = YOLO("yolo26s-depth.pt") # Fine-tune trên dataset depth tùy chỉnh results = model.train( data="path/to/your_dataset.yaml", epochs=20, imgsz=640, optimizer="AdamW", lr0=1e-4, warmup_bias_lr=1e-4, )Xem trang Cấu hình để biết thêm các tham số hiện có.
Validation cho tác vụ ước tính depth báo cáo bộ metric được sử dụng trong Depth Anything và các nghiên cứu liên quan về depth đơn ảnh:
- delta1 / delta2 / delta3 — tỷ lệ pixel có tỷ số giữa depth dự đoán và depth ground truth (hoặc nghịch đảo của tỷ số đó) nhỏ hơn lần lượt là 1.25, 1.25² và 1.25³. Giá trị càng cao càng tốt.
- abs_rel — sai số tương đối tuyệt đối trung bình. Giá trị càng thấp càng tốt.
- rmse — căn bậc hai của sai số bình phương trung bình, đơn vị mét. Giá trị càng thấp càng tốt.
- silog — sai số logarit bất biến theo scale. Giá trị càng thấp càng tốt.
Mỗi dự đoán được căn chỉnh theo trung vị với ground truth tương ứng trên từng ảnh; mỗi metric được tính hoàn tất trên ảnh đó, sau đó các kết quả theo từng ảnh được lấy trung bình trên toàn bộ tập validation. Vì vậy, mọi ảnh có trọng số như nhau bất kể có bao nhiêu pixel depth hợp lệ. Ảnh có ít hơn 10 pixel ground truth hợp lệ sẽ bị bỏ qua và không được đưa vào phép tính trung bình đó, vì việc căn chỉnh trung vị của chỉ một vài pixel là vô nghĩa; thay vào đó, các dự đoán không hữu hạn được chấm ở các giới hạn depth. Cách này khớp với phương pháp lấy trung bình theo từng mẫu và ngưỡng tối thiểu 10 pixel được dùng trong Depth Anything V2.
Depth map được lưu dưới dạng
torch.Tensorcó shape(H, W), trong đó mỗi giá trị là depth dự đoán theo mét (dùngresult.depth.data.cpu().numpy()để tạo mảng NumPyfloat32). Truy cập map thông quaresult.depth.datasau khi chạy dự đoán. Map được căn chỉnh theo độ phân giải ảnh đầu vào.Ultralytics YOLO26 cung cấp các cấu hình YAML dataset tích hợp sẵn cho một số dataset ước tính depth, bao gồm NYU Depth V2, KITTI, Hypersim, SUN RGB-D và ARKitScenes. Xem Hướng dẫn về Dataset Ước tính Depth để biết danh sách đầy đủ và chi tiết về định dạng.
Validate model depth YOLO26 pretrained bằng cách cung cấp YAML dataset được dùng để đánh giá:
Ví dụfrom ultralytics import YOLO # Tải model pretrained model = YOLO("yolo26n-depth.pt") # Xác thực model metrics = model.val(data="nyu-depth.yaml") print("delta1:", metrics.delta1) print("abs_rel:", metrics.abs_rel) print("rmse:", metrics.rmse)Export model depth YOLO26 sang ONNX bằng Python hoặc CLI:
Ví dụfrom ultralytics import YOLO # Tải model pretrained model = YOLO("yolo26n-depth.pt") # # Xuất model sang định dạng ONNX model.export(format="onnx")Để biết thêm chi tiết về cách export sang nhiều định dạng, hãy tham khảo trang Export.