أفضل الممارسات لنشر النماذج
مقدمة#
نشر النماذج هو الخطوة في مشروع الرؤية الحاسوبية التي تنقل النموذج من مرحلة التطوير إلى تطبيق في العالم الحقيقي. وتتعدد خيارات نشر النماذج: إذ يوفر النشر السحابي قابلية التوسع وسهولة الوصول، ويقلل النشر الطرفي زمن الاستجابة من خلال تقريب النموذج من مصدر البيانات، بينما يضمن النشر المحلي الخصوصية والتحكم. ويعتمد اختيار الاستراتيجية المناسبة على احتياجات تطبيقك، مع الموازنة بين السرعة والأمان وقابلية التوسع.
شاهد: كيفية تحسين نماذج الذكاء الاصطناعي ونشرها: أفضل الممارسات، واستكشاف الأخطاء وإصلاحها، واعتبارات الأمان
من المهم أيضًا اتباع أفضل الممارسات عند نشر النموذج، لأن النشر قد يؤثر تأثيرًا كبيرًا في فعالية أداء النموذج وموثوقيته. سنركز في هذا الدليل على كيفية ضمان نشر سلس وفعال وآمن لنموذجك.
خيارات نشر النماذج#
غالباً ما يحتاج النموذج، بعد تدريبه وتقييمه واختباره، إلى تحويله إلى تنسيقات محددة كي يُنشر بفعالية في بيئات متنوعة، مثل السحابة أو الأجهزة الطرفية أو الأجهزة المحلية.
باستخدام YOLO26، يمكنك تصدير نموذجك إلى تنسيقات متنوعة وفقًا لاحتياجات النشر. فعلى سبيل المثال، تُعد عملية تصدير YOLO26 إلى ONNX سهلة ومثالية لنقل النماذج بين أطر العمل. لاستكشاف مزيد من خيارات التكامل وضمان النشر السلس في بيئات مختلفة، تفضل بزيارة كتالوج تكامل النماذج.
اختيار بيئة النشر#
يعتمد اختيار مكان نشر نموذج الرؤية الحاسوبية على عوامل متعددة. لكل بيئة مزايا وتحديات فريدة، لذا من الضروري اختيار البيئة الأنسب لاحتياجاتك.
النشر السحابي#
يُعد النشر السحابي خياراً ممتازاً للتطبيقات التي تحتاج إلى التوسع بسرعة ومعالجة كميات كبيرة من البيانات. وتسهّل منصات مثل AWS وGoogle Cloud وAzure إدارة نماذجك من التدريب وحتى النشر. وتوفر خدمات مثل Amazon SageMaker وGoogle Vertex AI وAzure Machine Learning للمساعدة طوال العملية. كما تنشر منصة Ultralytics نماذج YOLO إلى نقاط نهاية مخصصة في 42 منطقة حول العالم.
لكن استخدام السحابة قد يكون مكلفًا، ولا سيما مع الاستخدام الكثيف للبيانات، وقد تواجه مشكلات في زمن الاستجابة إذا كان المستخدمون بعيدين عن مراكز البيانات. ولإدارة التكاليف والأداء، من المهم تحسين استخدام الموارد وضمان الامتثال لقواعد خصوصية البيانات.
النشر الطرفي#
يناسب النشر الطرفي التطبيقات التي تحتاج إلى استجابات آنية وزمن استجابة منخفض، خصوصاً في الأماكن ذات الاتصال المحدود بالإنترنت أو التي لا يتوفر فيها اتصال. ويضمن نشر النماذج على الأجهزة الطرفية مثل الهواتف الذكية أو أجهزة إنترنت الأشياء سرعة المعالجة وبقاء البيانات محلية، ما يعزز الخصوصية. كما يوفر النشر الطرفي النطاق الترددي بسبب تقليل البيانات المرسلة إلى السحابة.
لكن قدرات المعالجة في الأجهزة الطرفية غالباً ما تكون محدودة، لذا ستحتاج إلى تحسين نماذجك. ويمكن لبيئات التشغيل ومنصات العتاد مثل LiteRT وNVIDIA Jetson المساعدة في ذلك. ورغم هذه الفوائد، قد تشكل صيانة العديد من الأجهزة وتحديثها تحدياً.
النشر المحلي#
يكون النشر المحلي الأنسب عندما تكون خصوصية البيانات أمراً بالغ الأهمية، أو عندما يكون الاتصال بالإنترنت غير موثوق أو غير متاح. ويمنحك تشغيل النماذج على خوادم محلية أو أجهزة سطح المكتب تحكماً كاملاً ويحافظ على أمان بياناتك. كما قد يقلل زمن الاستجابة إذا كان الخادم قريباً من المستخدم.
لكن التوسع محلياً قد يكون صعباً، وقد تستغرق الصيانة وقتاً طويلاً. ويمكن أن يساعد استخدام أدوات مثل Docker للحاويات وKubernetes للإدارة على جعل عمليات النشر المحلية أكثر كفاءة. ومن الضروري إجراء تحديثات وصيانة منتظمة لضمان استمرار عمل كل شيء بسلاسة.
التغليف في حاويات لتبسيط النشر#
تجمع الحاويات النموذج وجميع تبعياته في وحدة موحدة تُسمى حاوية. تضمن هذه التقنية أداءً متسقًا في البيئات المختلفة وتبسّط عملية النشر.
فوائد استخدام Docker لنشر النماذج#
أصبح Docker المعيار الصناعي للتغليف في حاويات عند نشر تطبيقات التعلم الآلي لعدة أسباب:
- اتساق البيئة: تتضمن حاويات Docker نموذجك وجميع تبعياته، فتزيل مشكلة «يعمل على جهازي» عبر ضمان سلوك متسق في بيئات التطوير والاختبار والإنتاج.
- العزل: تعزل الحاويات التطبيقات بعضها عن بعض، ما يمنع التعارض بين إصدارات البرامج أو المكتبات المختلفة.
- قابلية النقل: يمكن تشغيل حاويات Docker على أي نظام يدعم Docker، ما يسهّل نشر النماذج عبر منصات مختلفة دون تعديل.
- قابلية التوسع: يمكن زيادة عدد الحاويات أو تقليله بسهولة وفقًا للطلب، كما يمكن لأدوات التنسيق مثل Kubernetes أتمتة هذه العملية.
- التحكم في الإصدارات: يمكن تعيين إصدارات لصور Docker، ما يتيح تتبع التغييرات والعودة إلى إصدارات سابقة عند الحاجة.
تنفيذ Docker لنشر YOLO26#
لـتحويل نموذج YOLO26 إلى حاوية، يمكنك إنشاء ملف Dockerfile يحدد جميع التبعيات والإعدادات اللازمة. إليك مثالًا أساسيًا:
FROM ultralytics/ultralytics:latest

WORKDIR /app

# Copy your model and any additional files
COPY ./models/yolo26n.pt /app/models/
COPY ./scripts /app/scripts/

# Set up any environment variables
ENV MODEL_PATH=/app/models/yolo26n.pt

# Command to run when the container starts
CMD ["python", "/app/scripts/predict.py"]
يضمن هذا النهج إمكانية إعادة إنتاج نشر نموذجك واتساقه في بيئات التطوير والاختبار والإنتاج.
تقنيات تحسين النماذج#
يساعد تحسين نموذج الرؤية الحاسوبية على تشغيله بكفاءة، لا سيما عند نشره في بيئات محدودة الموارد مثل الأجهزة الطرفية. إليك بعض التقنيات الأساسية لتحسين نموذجك.
تشذيب النماذج#
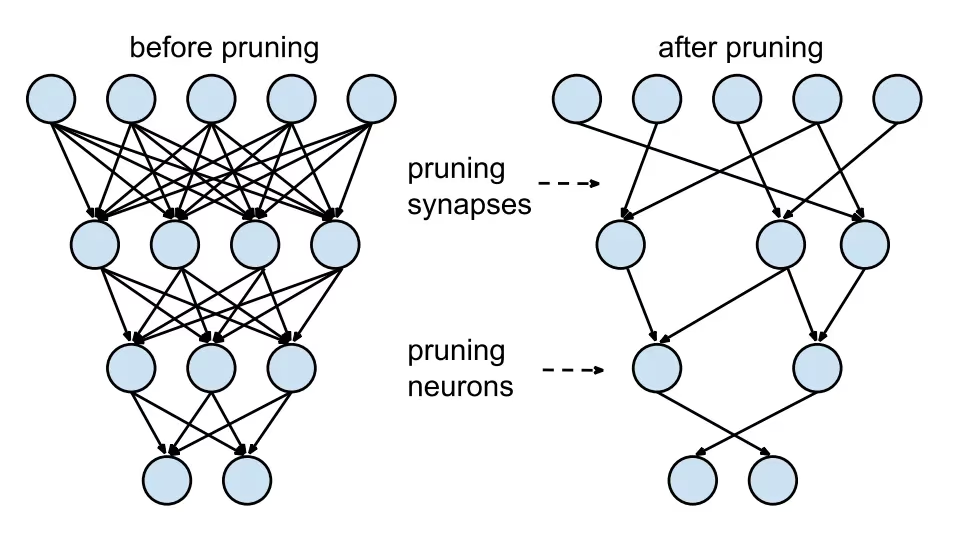
يقلّل التقليم حجم النموذج بإزالة الأوزان التي لا تسهم كثيرًا في المخرجات النهائية. ويجعل النموذج أصغر وأسرع من دون التأثير كثيرًا في الدقة. يتضمن التقليم تحديد المعلمات غير الضرورية وإزالتها، ما ينتج عنه نموذج أخف يحتاج إلى قدرة حوسبة أقل. وتكون هذه التقنية مفيدة على نحو خاص لنشر النماذج على الأجهزة محدودة الموارد.
تكميم النماذج#
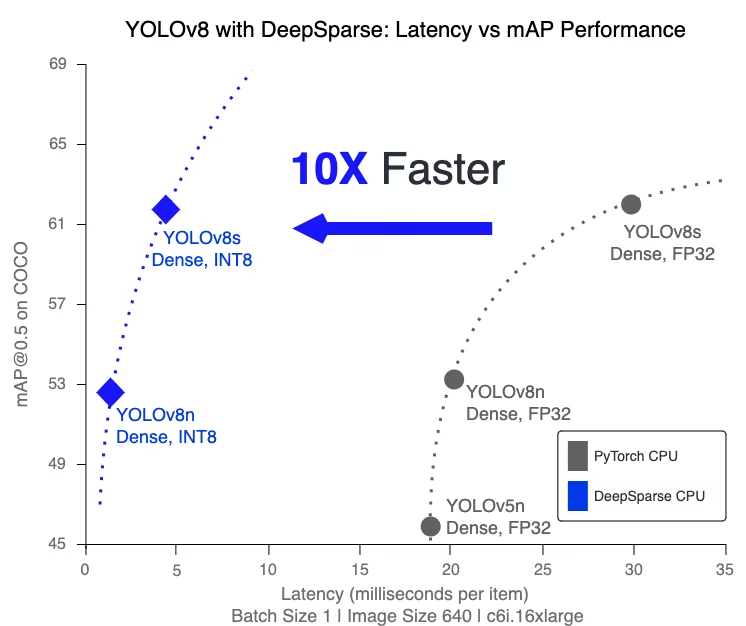
يحوّل التكميم أوزان النموذج وتفعيلاتِه من دقة عالية (مثل الأعداد العائمة ذات 32 بت) إلى دقة أقل (مثل الأعداد الصحيحة ذات 8 بت). ويؤدي تقليل حجم النموذج إلى تسريع الاستدلال. التدريب الواعي بالتكميم (QAT) أسلوب يُدرَّب فيه النموذج مع مراعاة التكميم، ما يحافظ على الدقة بصورة أفضل من التكميم بعد التدريب. ومن خلال معالجة التكميم أثناء مرحلة التدريب، يتعلم النموذج التكيف مع الدقة الأقل، ويحافظ على الأداء مع تقليل متطلبات الحوسبة. في Ultralytics YOLO، عيّن quantize=8 عند التصدير لإجراء تكميم INT8 بعد التدريب، أو أثناء التدريب لإجراء QAT.
تقطير المعرفة#
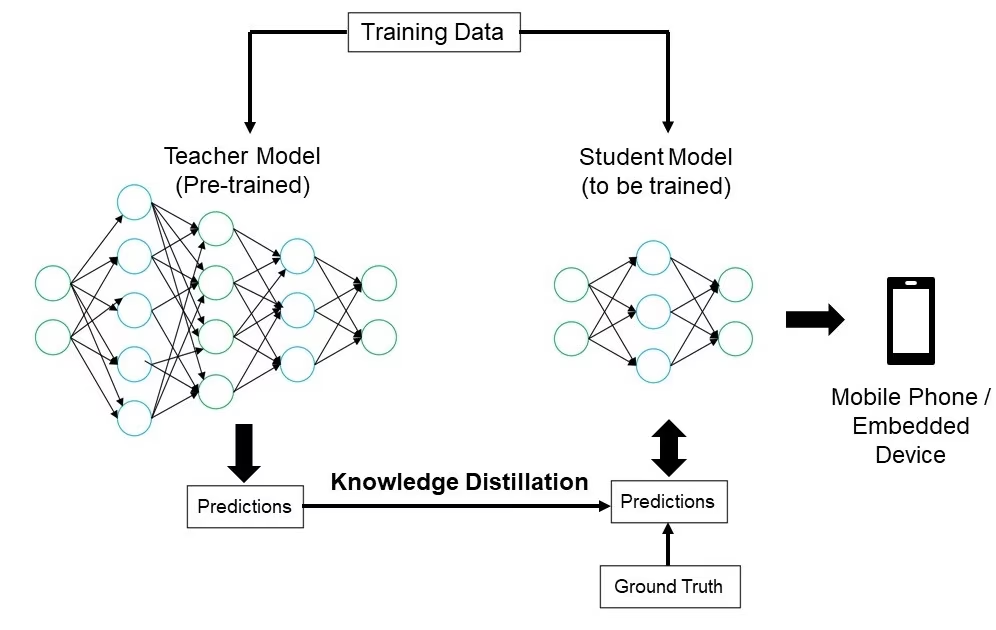
يتضمن تقطير المعرفة تدريب نموذج أصغر وأبسط (الطالب) على محاكاة مخرجات نموذج أكبر وأكثر تعقيدًا (المعلم). يتعلم نموذج الطالب تقريب تنبؤات المعلم، ما ينتج عنه نموذج مدمج يحتفظ بقدر كبير من دقة المعلم. تفيد هذه التقنية في إنشاء نماذج فعالة مناسبة للنشر على الأجهزة الطرفية محدودة الموارد. وتدعمها Ultralytics YOLO من خلال وسيطة التدريب distill_model.
استكشاف مشكلات النشر وإصلاحها#
قد تواجه تحديات عند نشر نماذج الرؤية الحاسوبية، لكن فهم المشكلات الشائعة وحلولها يمكن أن يجعل العملية أكثر سلاسة. إليك بعض نصائح استكشاف الأخطاء وإصلاحها العامة وأفضل الممارسات لمساعدتك على التعامل مع مشكلات النشر.
انخفاض دقة النموذج بعد النشر#
قد يرجع انخفاض دقة نموذجك بعد نشره إلى عوامل مختلفة. إليك بعض الخطوات التي تساعدك على تحديد المشكلة وحلها:
- تحقق من اتساق البيانات: تأكد من أن البيانات التي يعالجها نموذجك بعد النشر متسقة مع البيانات التي دُرّب عليها. يمكن للاختلافات في توزيع البيانات أو جودتها أو تنسيقها أن تؤثر كثيرًا في الأداء.
- تحقق من خطوات المعالجة المسبقة: تأكد من تطبيق جميع خطوات المعالجة المسبقة المستخدمة أثناء التدريب بالاتساق نفسه أثناء النشر. ويشمل ذلك تغيير أحجام الصور، وتطبيع قيم البكسل، وتحويلات البيانات الأخرى.
- قيّم بيئة النموذج: تأكد من أن تكوينات الأجهزة والبرامج المستخدمة أثناء النشر تطابق تلك المستخدمة أثناء التدريب. فقد تؤدي الاختلافات في المكتبات والإصدارات وإمكانات الأجهزة إلى حدوث تفاوتات.
- راقب استدلال النموذج: سجّل المدخلات والمخرجات في مراحل مختلفة من مسار الاستدلال لاكتشاف أي حالات شاذة. وقد يساعد ذلك على تحديد مشكلات مثل تلف البيانات أو التعامل غير السليم مع مخرجات النموذج.
- راجع تصدير النموذج وتحويله: أعد تصدير النموذج وتأكد من أن عملية التحويل تحافظ على سلامة أوزان النموذج وبنيته.
- اختبر باستخدام مجموعة بيانات مضبوطة: انشر النموذج في بيئة اختبار باستخدام مجموعة بيانات تتحكم فيها، ثم قارن النتائج بمرحلة التدريب. ويمكنك تحديد ما إذا كانت المشكلة في بيئة النشر أم في البيانات.
عند نشر YOLO26، قد تؤثر عوامل عدة في دقة النموذج. ينطوي تحويل النماذج إلى تنسيقات مثل TensorRT على تحسينات مثل تكميم الأوزان ودمج الطبقات، ما قد يؤدي إلى خسائر طفيفة في الدقة. يمكن أن يؤدي استخدام FP16 (نصف الدقة) بدلًا من FP32 (الدقة الكاملة) إلى تسريع الاستدلال، لكنه قد يُحدث أخطاء في الدقة العددية. كذلك، قد تؤثر قيود الأجهزة، مثل تلك الموجودة في Jetson Nano، ذات العدد الأقل من أنوية CUDA وانخفاض عرض نطاق الذاكرة، في الأداء.
الاستدلال يستغرق وقتًا أطول مما توقعت#
عند نشر نماذج التعلم الآلي، من المهم أن تعمل بكفاءة. إذا استغرق الاستدلال وقتًا أطول من المتوقع، فقد يؤثر ذلك في تجربة المستخدم وفاعلية تطبيقك. إليك بعض الخطوات التي تساعدك على تحديد المشكلة وحلها:
- نفّذ عمليات إحماء: غالبًا ما تتضمن عمليات التشغيل الأولية وقتًا إضافيًا للإعداد، ما قد يؤدي إلى تحريف قياسات زمن الاستجابة. أجرِ بضع عمليات استدلال للإحماء قبل قياس زمن الاستجابة. ويتيح استبعاد عمليات التشغيل الأولية قياسًا أدق لأداء النموذج.
- حسّن محرّك الاستدلال: تحقق جيدًا من أن محرّك الاستدلال محسّن بالكامل لبنية GPU المحددة لديك. استخدم أحدث برامج التشغيل وإصدارات البرامج الملائمة لأجهزتك لضمان أعلى أداء وتوافق.
- استخدم المعالجة غير المتزامنة: تساعد المعالجة غير المتزامنة على إدارة أعباء العمل بكفاءة أكبر. استخدم تقنيات المعالجة غير المتزامنة للتعامل مع عمليات استدلال متعددة بالتزامن، ما يساعد على توزيع الحمل وتقليل أوقات الانتظار.
- حلّل أداء مسار الاستدلال: يساعد تحديد الاختناقات في مسار الاستدلال على تعيين مصدر التأخير. استخدم أدوات تحليل الأداء لفحص كل خطوة من خطوات عملية الاستدلال، وحدد المراحل التي تسبب تأخيرات كبيرة وعالجها، مثل الطبقات غير الفعالة أو مشكلات نقل البيانات.
- استخدم دقة مناسبة: قد يؤدي استخدام دقة أعلى من اللازم إلى إبطاء أوقات الاستدلال. جرّب استخدام دقة أقل، مثل FP16 (
quantize=16عند التصدير)، بدلًا من FP32 (الدقة الكاملة). مع أن FP16 قد يقلل زمن الاستدلال، تذكّر أيضًا أنه قد يؤثر في دقة النموذج.
إذا واجهت هذه المشكلة أثناء نشر YOLO26، فتذكّر أن YOLO26 يوفر أحجامًا متنوعة للنماذج، مثل YOLO26n (nano) للأجهزة ذات سعة الذاكرة الأقل وYOLO26x (extra-large) لوحدات GPU الأقوى. ويمكن أن يساعد اختيار متغير النموذج المناسب لأجهزتك على تحقيق التوازن بين استخدام الذاكرة ووقت المعالجة.
ضع في الحسبان أيضًا أن حجم الصور المدخلة يؤثر مباشرةً في استخدام الذاكرة ووقت المعالجة. تقلل الدقة المنخفضة استخدام الذاكرة وتسرّع الاستدلال، بينما تحسن الدقة الأعلى الدقةَ لكنها تتطلب مزيدًا من الذاكرة وقدرة المعالجة.
اعتبارات الأمان عند نشر النماذج#
ومن الجوانب المهمة الأخرى للنشر الأمان. فأمان النماذج المنشورة ضروري لحماية البيانات الحساسة والملكية الفكرية. إليك بعض أفضل الممارسات التي يمكنك اتباعها لنشر النماذج بأمان.
نقل البيانات بأمان#
يُعد تأمين البيانات المرسلة بين العملاء والخوادم أمرًا ضروريًا لمنع اعتراضها أو وصول جهات غير مخولة إليها. يمكنك استخدام بروتوكولات التشفير مثل TLS (أمن طبقة النقل) لتشفير البيانات أثناء إرسالها. وحتى إذا اعترض أحدهم البيانات، فلن يتمكن من قراءتها. ويمكنك أيضًا استخدام التشفير من طرف إلى طرف لحماية البيانات من المصدر إلى الوجهة، بحيث لا يستطيع أي طرف وسيط الوصول إليها.
ضوابط الوصول#
من الضروري التحكم في الجهات التي يمكنها الوصول إلى النموذج وبياناته لمنع الاستخدام غير المصرّح به. استخدم أساليب مصادقة قوية للتحقق من هوية المستخدمين أو الأنظمة التي تحاول الوصول إلى النموذج، وفكّر في إضافة طبقة أمان أخرى باستخدام المصادقة متعددة العوامل (MFA). أعدد التحكم بالوصول القائم على الأدوار (RBAC) لتعيين الأذونات بناءً على أدوار المستخدمين، بحيث لا يتمكن الأشخاص من الوصول إلا إلى ما يحتاجون إليه. احتفظ بسجلات تدقيق مفصلة لتتبع جميع عمليات الوصول والتغييرات التي تطرأ على النموذج وبياناته، وراجع هذه السجلات بانتظام لرصد أي نشاط مريب.
تمويه النموذج#
يمكن حماية النموذج من الهندسة العكسية أو إساءة الاستخدام عبر تمويهه. ويتضمن ذلك تشفير معلمات النموذج، مثل الأوزان والانحيازات في الشبكات العصبية، لتصعيب فهم النموذج أو تعديله على الأشخاص غير المصرّح لهم. ويمكنك أيضًا تمويه بنية النموذج بإعادة تسمية الطبقات والمعلمات أو بإضافة طبقات وهمية، ما يجعل الهندسة العكسية أصعب على المهاجمين. كما يمكن أن يوفر تقديم النموذج في بيئة آمنة، مثل منطقة آمنة معزولة أو بيئة تنفيذ موثوقة (TEE)، طبقة حماية إضافية أثناء الاستدلال.
الخلاصة والخطوات التالية#
استعرضنا بعض أفضل الممارسات التي ينبغي اتباعها عند نشر نماذج الرؤية الحاسوبية. فمن خلال تأمين البيانات، والتحكم في الوصول، وتمويه تفاصيل النموذج، يمكنك حماية المعلومات الحساسة مع ضمان سلاسة تشغيل نماذجك. كما ناقشنا معالجة المشكلات الشائعة، مثل انخفاض الدقة وبطء الاستدلال، باستخدام استراتيجيات مثل عمليات الإحماء، وتحسين المحركات، والمعالجة غير المتزامنة، وتحليل مسارات الاستدلال، واختيار الدقة المناسبة.
بعد نشر النموذج، تتمثل الخطوة التالية في مراقبة تطبيقك وصيانته وتوثيقه. تساعد المراقبة المنتظمة على اكتشاف المشكلات وحلها بسرعة، وتحافظ الصيانة على تحديث النماذج وعملها، فيما يوثق التوثيق الجيد جميع التغييرات والتحديثات. ستساعدك هذه الخطوات على تحقيق أهداف مشروع الرؤية الحاسوبية.
الأسئلة الشائعة#
يتطلب نشر نموذج تعلّم آلي، ولا سيما باستخدام Ultralytics YOLO26، اتباع عدة ممارسات لضمان الكفاءة والموثوقية. أولًا، اختر بيئة النشر التي تلبي احتياجاتك، سواء كانت سحابية أو طرفية أو محلية. حسّن النموذج باستخدام تقنيات مثل التقليم والتكميم وتقطير المعرفة لنشره بكفاءة في البيئات محدودة الموارد. فكّر في استخدام الحاويات مع Docker لضمان الاتساق بين البيئات المختلفة. وأخيرًا، تأكد من اتساق البيانات ومن توافق خطوات المعالجة المسبقة مع مرحلة التدريب للحفاظ على الأداء. ويمكنك أيضًا الرجوع إلى خيارات نشر النماذج للاطلاع على إرشادات أكثر تفصيلًا.
يمكن تقسيم استكشاف مشكلات النشر وإصلاحها إلى بضع خطوات أساسية. إذا انخفضت دقة النموذج بعد النشر، فتحقق من اتساق البيانات، وتأكد من صحة خطوات المعالجة المسبقة، ومن تطابق بيئة الأجهزة والبرامج مع البيئة المستخدمة أثناء التدريب. أما إذا كان الاستدلال بطيئًا، فنفّذ عمليات إحماء، وحسّن محرّك الاستدلال، واستخدم المعالجة غير المتزامنة، وحلّل مسار الاستدلال. راجع دليل استكشاف مشكلات النشر وإصلاحها للاطلاع على شرح مفصل لأفضل الممارسات هذه.
يتضمن تحسين نماذج Ultralytics YOLO26 للأجهزة الطرفية استخدام تقنيات مثل التقليم لتقليل حجم النموذج، والتكميم لتحويل الأوزان إلى دقة أقل، وتقطير المعرفة لتدريب نماذج أصغر تحاكي النماذج الأكبر. وتضمن هذه التقنيات تشغيل النموذج بكفاءة على الأجهزة ذات القدرة الحاسوبية المحدودة. وتفيد أدوات مثل LiteRT وNVIDIA Jetson بوجه خاص في هذه التحسينات. تعرّف على المزيد عن هذه التقنيات في قسم تحسين النماذج.
يكتسب الأمان أهمية قصوى عند نشر نماذج التعلّم الآلي. احرص على نقل البيانات بأمان باستخدام بروتوكولات تشفير مثل TLS. وطبّق ضوابط وصول قوية، تشمل المصادقة القوية والتحكم بالوصول القائم على الأدوار (RBAC). وتوفر تقنيات تمويه النماذج، مثل تشفير معلمات النموذج وتقديم النماذج في بيئة آمنة كبيئة التنفيذ الموثوقة (TEE)، حماية إضافية. للاطلاع على الممارسات المفصلة، راجع اعتبارات الأمان.
يعتمد اختيار بيئة النشر المثلى لنموذج Ultralytics YOLO26 على الاحتياجات المحددة لتطبيقك. يوفر النشر السحابي قابلية التوسع وسهولة الوصول، ما يجعله مثاليًا للتطبيقات ذات أحجام البيانات الكبيرة. أما النشر الطرفي فيناسب التطبيقات منخفضة زمن الاستجابة التي تتطلب استجابات آنية، باستخدام أدوات مثل LiteRT. ويناسب النشر المحلي الحالات التي تتطلب خصوصية صارمة للبيانات وتحكمًا كاملًا بها. للاطلاع على نظرة شاملة على كل بيئة، تفضل بزيارة قسمنا حول اختيار بيئة النشر.


التعليقات10
اطرح سؤالًا، وشارك نتائجك، أو ساعد شخصًا آخر.
 TaoBenHui
shafa~hahaha
Taufiq-Ahmed
Hi, I Have trained my custom dataset on yolov8s model. Now I want to optimized the model by using pruning and quantization. could you please tell me How I can implement it and what is the python code of it?
 Paula DerrengerUltralytics
@Taufiq-Ahmed to optimize your YOLOv8 model using pruning and quantization, you can follow these steps:
-
Pruning: This involves removing weights that contribute little to the final output, making the model smaller and faster. You can use libraries like TensorFlow Model Optimization Toolkit or PyTorch's pruning methods.
-
Quantization: This converts the model's weights and activations from high precision (e.g., 32-bit floats) to lower precision (e.g., 8-bit integers), reducing model size and speeding up inference. You can use TensorFlow Lite for post-training quantization or PyTorch's quantization tools.
For detailed guidance and code examples, please refer to the Ultralytics documentation on model optimization. This resource provides comprehensive instructions and best practices for deploying and optimizing your models effectively.
-
Thank you so much for your reply. One think I would like to know, is it possible to do pruning and quantization in my YOLOv8 best.pt model with TensorFlow Model Optimization Toolkit or PyTorch's pruning methods. Do do I need to convert it and also need to convert my dataset from YOLO format to any other format?
- Paula DerrengerUltralytics
Yes, you can perform pruning and quantization on your YOLOv8 model using TensorFlow Model Optimization Toolkit or PyTorch's pruning methods. You don't need to convert your dataset format, but you may need to convert your model to a compatible format like ONNX if using TensorFlow tools. For PyTorch, you can directly apply pruning and quantization techniques. For detailed steps, please refer to the Ultralytics documentation on model deployment practices.
Thank you for your reply. could you please give me any git hub repositories or any coding example on how to apply pruning and quantization techniques on the best.pt model on custom dataset. and how will i maintain the accuracy of the model.
- Paula DerrengerUltralytics
@Taufiq-Ahmed for pruning and quantization of your YOLOv8 model, you can use PyTorch's built-in functionalities. You don't need to convert your dataset format. For pruning, you can use
torch.nn.utils.prune, and for quantization, you can usetorch.quantization. If you need specific code examples, please let me know. For more detailed guidance, you can refer to the Ultralytics documentation on model deployment practices. Thank you for your reply. it would be better for me if you share a coding example of how to prune and quantize the model on the custom data to reduce it's size and weights using pytorch and how to ´maintain it's accuracy. do I need to train it again or there is some other way to maintain it's accuracy.
Hi could you please check whether this idea works:
import torch import torch.nn as nn from torch.nn.utils import prune from ultralytics import YOLO
model = YOLO('best.pt')
def gradual_prune_model(model, prune_step=0.05, prune_iterations=10): for i in range(prune_iterations):
    for name, module in model.model.named_modules():
        if isinstance(module, nn.Conv2d):
            prune.l1_unstructured(module, name='weight', amount=prune_step)
            prune.remove(module, 'weight')  # Remove pruning reparameterization

    print(f'Fine-tuning after pruning iteration {i+1}/{prune_iterations}')
    model.train(data='dataset.yaml', epochs=2, lr=1e-4)
gradual_prune_model(model, prune_step=0.05, prune_iterations=10)
print('Final fine-tuning after pruning') model.train(data='/path/to/your/dataset.yaml', epochs=10, lr=1e-5)
model.save('pruned_yolov8.pt')
is this pruned technique works? and after pruning is this the right way to regain it's accuracy?
- Paula DerrengerUltralytics
Your approach to pruning looks good. Gradual pruning followed by fine-tuning can help maintain accuracy. After pruning, fine-tuning with a lower learning rate is essential to regain any lost accuracy. For quantization, you can use PyTorch's quantization tools. Ensure you validate the model's performance after each step. For more detailed guidance, refer to the Ultralytics documentation on model deployment practices.