تصدير Qualcomm QNN
Qualcomm AI Engine Direct، المعروف أيضًا باسم QNN، هو بيئة تشغيل Qualcomm لوحدة Hexagon NPU في معالجات Snapdragon وDragonwing. يؤدي تصدير نموذج Ultralytics YOLO26 باستخدام format="qnn" إلى إنشاء yolo26n_qnn.onnx، وهو نموذج ONNX لا تحتوي عقدته الوحيدة إلا على سياق QNN ثنائي، جُمّع باستخدام أوزان INT8 وتفعيلات 16-بت للجيل الذي تحدده من Hexagon Tensor Processor (HTP) باستخدام الوسيطة name. يعمل التصدير باستخدام ONNX Runtime على حاسوبك، ولا يتطلب حسابًا أو جهازًا من Qualcomm.
لمحة سريعة#
| الخاصية | التفاصيل |
|---|---|
وسيطة format | qnn |
| المخرجات | yolo26n_qnn.onnx، ملف ONNX واحد بعقدة EPContext تضمّن ثنائية سياق QNN المترجمة، وأسماء الفئات والمهمة وحجم الصورة بوصفها بيانات وصفية |
| يعمل على | وحدات NPU من Hexagon التابعة لأجيال HTP المحددة باستخدام name: هواتف Snapdragon من Snapdragon 888 إلى 8 Elite Gen 5، وحواسيب Snapdragon X Elite المحمولة، وDragonwing IQ-8275؛ راجع أهداف HTP المدعومة |
| بيئة التشغيل | ONNX Runtime مع موفّر تنفيذ QNN: حزمة Python onnxruntime-qnn على Windows وLinux، أو ONNX Runtime مع QNN في تطبيق Android |
| الدقة | W8A16 فقط: أوزان INT8 وتنشيطات 16 بت، مع معايرتها باستخدام صور من data. حجم YOLO26n هو 3.6 MB |
| جهاز التصدير | Linux بنظام x86-64 أو ARM64، أو Windows بنظام x64 أو ARM64، مع Python 3.11 أو أحدث. لا يدعم macOS. اختُبر على Ubuntu 24.04 بنظام x86-64. تُجرى عملية التصدير على CPU ولا تحتاج إلى GPU أو جهاز Snapdragon |
يمكن لـ منصة Ultralytics تصدير نموذج مدرّب إلى QNN للهدف HTP الذي تحدده، لذا لا تحتاج إلى بيئة تصدير محلية.
البدء السريع#
ثبّت حزمة Ultralytics مع تبعيات تصدير ONNX وموفّر تنفيذ QNN:
pip install "ultralytics[export-base]" onnxruntime-qnnتوفّر onnxruntime-qnn مكتبات Qualcomm AI Runtime (QAIRT) وتُثبّت بجوار onnxruntime، الذي تتطلبه. عند استخدام pip install ultralytics عادي، تثبّت عملية التصدير الأولى onnx وonnxslim وonnxruntime وonnxruntime-qnn تلقائيًا، وتسجّل Restart runtime or rerun command for updates to take effect، وتكتمل مع ذلك في التشغيل نفسه. تتطلب عملية التصدير الإصدارات التالية:
| المتطلب | الإصدار |
|---|---|
| Python | من 3.11 إلى 3.14، وهي الإصدارات التي تتوفر لها حزم onnxruntime-qnn 2.x. نُفّذت عمليات التصدير باستخدام Python 3.11 و3.12 و3.14 |
| نظام التشغيل | Linux بنظام x86-64 مع glibc 2.35 أو أحدث، وLinux بنظام ARM64 مع glibc 2.34 أو أحدث، وWindows بنظام x64 أو ARM64. لا تتوفر حزم onnxruntime-qnn لنظام macOS؛ راجع القيود |
onnxruntime-qnn | الإصدار 2.8.0 لكل عملية تصدير في هذه الصفحة، مع onnxruntime 1.32.0. لا تثبّت Ultralytics إصدارًا محددًا |
للاطلاع على طرق التثبيت الأخرى، راجع دليل التثبيت. ثم صدّر نموذجك:
from ultralytics import YOLO
# تحميل نموذج YOLO26
model = YOLO("yolo26n.pt")
# # صدّر النموذج إلى تنسيق QNN لجهاز Snapdragon 8 Elite Gen 5 (HTP v81)
model.export(format="qnn", name="81", imgsz=640) # # ينشئ 'yolo26n_qnn.onnx'تكتب عملية التصدير yolo26n_qnn.onnx بجوار yolo26n.pt، وتفشل إذا كان الملف موجودًا بالفعل؛ لذا احذفه أو أعد تسميته قبل التصدير مجددًا. في غياب data، تُجري المعايرة على مجموعة البيانات الافتراضية الصغيرة للمهمة، مثل الصور الأربع في coco8.yaml، وهي كافية لاختبار التصدير؛ عاير باستخدام صور من بيانات النشر قبل شحن النموذج، وراجع المعايرة.
بعد ذلك، انسخ yolo26n_qnn.onnx إلى جهاز Snapdragon؛ راجع النشر. يعمل كل من Predict وValidate أيضًا، ببطء، على مضيف التصدير Linux بنظام x86-64، لتتمكن من فحص الملف المُصدّر قبل نسخه. شغّل كلًا منهما في عملية Python جديدة، لأن تشغيل نموذج QNN ثانٍ في عملية واحدة يفشل؛ راجع القيود:
from ultralytics import YOLO
# # حمّل نموذج QNN المُصدّر
model = YOLO("yolo26n_qnn.onnx")
# تنفيذ الاستدلال
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# # حمّل نموذج QNN المُصدّر
model = YOLO("yolo26n_qnn.onnx")
# # التحقق من الدقة على مجموعة بيانات COCO8
metrics = model.val(data="coco8.yaml")المهام المدعومة#
يدعم تصدير QNN مهام Ultralytics السبع كلها: الكشف، وتجزئة الصور، والتجزئة الدلالية، وتقدير العمق، والتصنيف، وتقدير الوضعية، وOBB. لا يتوفر كل من التجزئة الدلالية وتقدير العمق إلا مع YOLO26، وهي عائلة النماذج الوحيدة التي تتضمن رأسي الإخراج هذين. صُدّر فحص YOLO26n لكل مهمة وشُغّل على مضيف التصدير، وكذلك نموذج كشف YOLO11. لم تُختبر عائلات النماذج الأخرى.
وسيطات التصدير#
| المعامل | النوع | الافتراضي | الوصف |
|---|---|---|---|
format | str | 'qnn' | التنسيق المستهدف للنموذج المُصدَّر، ويحدد مدى توافقه مع بيئات النشر المختلفة. |
name | str | '73' | جيل HTP أو SoC الذي تُترجم ثنائية السياق من أجله، مثل '81' أو 'iq-8275'. راجع أهداف HTP المدعومة. |
imgsz | int أو tuple | 640 | حجم صورة إدخال النموذج، وهو ثابت في ثنائية السياق: عدد صحيح للصور المربعة أو مجموعة (height, width). إذا لم تحدده، تستخدم عملية التصدير الحجم الذي دُرّب عليه الفحص، مثل 1024 لـ OBB و224 للتصنيف. |
quantize | int أو str | None | الدقة. عند عدم التحديد أو استخدام 'w8a16'، تُبنى الدقة الوحيدة المتاحة، وهي أوزان INT8 وتنشيطات 16 بت؛ أما 8 و16 و32 فتؤدي إلى خطأ؛ راجع الدقة. يحل هذا الخيار محل علامتي half/int8 المهملتين. |
data | str | None | ملف YAML لمجموعة البيانات التي تضم صور المعايرة؛ أما التصنيف فيتطلب دليل مجموعة بيانات أو اسم مجموعة بيانات مضمّنة. تستخدم المعايرة تقسيم val ما لم يُحدّد split. وإذا لم يُحدّد، تستخدم Ultralytics مجموعة البيانات الافتراضية الصغيرة للمهمة، مثل coco8.yaml. |
fraction | float أو int أو list | 1.0 | مجموعة المعايرة الفرعية: نسبة أو عدد صور (الأعداد الصحيحة الأكبر من 1) أو قائمة [train, val, test]، ويُستخدم منها الإدخال الخاص بقسم المعايرة. |
batch | int | 1 | حجم الدفعة للنموذج المُصدَّر، وهو ثابت في شكل الإدخال. وهو أيضًا حجم الدفعة المستخدم للمعايرة. |
nms | bool، اختياري | None | لا تأثير له: تكتب جميع القيم المخرجات الخام لـ None؛ راجع تنسيق المخرجات. |
opset | int | None | إصدار ONNX opset للرسم البياني الوسيط لـ ONNX. عند عدم تحديده، يُستخدم أعلى opset يدعمه إصدار PyTorch لديك حتى 18، وهو 18 مع PyTorch 2.4 أو أحدث. ترفع أداة تكميم ONNX Runtime الإصدار إلى 21 لدعم التنشيطات ذات 16 بت. |
simplify | bool | True | يبسّط رسم ONNX الوسيط باستخدام onnxslim. |
device | str | None | الجهاز المستخدم لتتبّع الرسم البياني الوسيط لـ ONNX، وهو cpu افتراضيًا. |
للاطلاع على الوسيطات المشتركة بين جميع التنسيقات، راجع وثائق وضع التصدير.
صُدّرت نماذج الأجهزة المحمولة الرسمية QNN وLiteRT وCore ML بالحجم imgsz=640، وبالحجم imgsz=224 للتصنيف. تُصدّر فحوص Cityscapes للتجزئة الدلالية والعمق وOBB افتراضيًا بحجم أكبر؛ لذا مرّر imgsz=640 لمطابقتها. تتوفر نماذج QNN للمهام السبع كلها وبجميع الأحجام، لكل من HTP v73 وv81، ضمن إصدار v0.7.0 من yolo-flutter-app.
أهداف HTP المدعومة#
تُترجم ثنائية السياق لجيل HTP واحد، لذا صدّر باستخدام name الخاص بجهازك. يسرد ملف README الخاص بإضافة Flutter جهاز Snapdragon 8 Gen 2 أو أحدث بوصفه متطلبًا لنماذج _v73 الرسمية؛ ولم تُختبر تركيبات أجيال التصدير والأجهزة الأخرى. يقبل name اسم الجيل مع بادئة v أو من دونها، مثل 81 أو v81 أو V81، أو أحد اسمي SoC، بأي حالة أحرف. الأحجام التالية تخص كشف YOLO26n عند imgsz=640:
name | Hexagon HTP | أمثلة على الأجهزة | خيار ONNX Runtime | ملف YOLO26n |
|---|---|---|---|---|
68 | v68 | Snapdragon 888 | htp_arch=68 | 3.7 MB |
69 | v69 | Snapdragon 8 Gen 1 | htp_arch=69 | 3.8 MB |
73 (افتراضي) | v73 | Snapdragon 8 Gen 2، Snapdragon X Elite | htp_arch=73 | 3.6 MB |
75 | v75 | Snapdragon 8 Gen 3 | htp_arch=75 | 3.6 MB |
79 | v79 | Snapdragon 8 Elite (SM8750) | soc_model=69 | 3.6 MB |
81 | v81 | Snapdragon 8 Elite Gen 5 | htp_arch=81 | 3.6 MB |
iq-8275 | v75 | Dragonwing IQ-8275 | soc_model=82 | 3.5 MB |
qcs8275 | v75 | Dragonwing QCS8275 | soc_model=82 | 3.5 MB |
أجهزة Snapdragon أمثلة على كل جيل وليست قائمة شاملة. في غياب name، تسجّل عملية التصدير Qualcomm QNN export requires a missing 'name' arg for the target Hexagon HTP architecture. Using default name='73' (Snapdragon 8 Gen 2).. وتؤدي أي قيمة أخرى إلى فشل مع Invalid Qualcomm QNN target '66'. Valid targets are ('68', '69', '73', '75', '79', '81', 'iq-8275', 'qcs8275').. يحتوي Dragonwing IQ-615 (QCS615) على DSP من نوع Hexagon v66، ولا يتوفر له هدف QNN في Ultralytics؛ لذا صدّر نموذج ONNX عاديًا لاستخدام CPU أو GPU.
from ultralytics import YOLO
model = YOLO("yolo26n.pt")
model.export(format="qnn", name="iq-8275", imgsz=640) # # ينشئ 'yolo26n_qnn.onnx'الدقة#
تُكمَّم كل عملية تصدير QNN باستخدام مسار QNN QDQ في ONNX Runtime إلى أوزان INT8 وتنشيطات 16 بت (W8A16). لا يتوفر تصدير FP32 أو FP16، ولا تصدير INT8 بتنشيطات 8 بت:
quantize | النتيجة |
|---|---|
غير محدد أو 'w8a16' | ثنائية سياق W8A16. حجم YOLO26n هو 3.6 MB. في غياب quantize، تسجّل عملية التصدير qnn export requires INT8 quantization, enabling it. |
8 | يفشل باستخدام quantize=8 (INT8) is not supported; format='qnn' supports quantize='w8a16' (INT8 weights + INT16 activations). |
16 | يفشل باستخدام quantize=16 (FP16) is not supported; format='qnn' supports quantize='w8a16' (INT8 weights + INT16 activations). |
32 | يفشل باستخدام quantize=32 (FP32) is not supported; format='qnn' supports quantize='w8a16' (INT8 weights + INT16 activations). |
يظل الإدخال والمخرجات من النوع float32، باستثناء خريطة الفئات الدلالية، لأن تكميم الإدخال وإزالة تكميم المخرجات يجريان داخل ثنائية السياق.
المعايرة#
تعاير عملية التصدير نطاقات التنشيط على كل دفعة كاملة من تقسيم val في data، أو من التقسيم الذي تحدده باستخدام split، وتُصدر تحذيرًا >300 images recommended for INT8 calibration, found 4 images. عند وجود أقل من 300 صورة. مرّر data مع صور تشبه بيانات النشر لديك، واستخدم fraction لتحديد عددها. عند الاستخدام الأول، ينزّل coco.yaml مجموعة بيانات COCO كاملة، بحجم يقارب 20 GB:
from ultralytics import YOLO
model = YOLO("yolo26n.pt")
# عاير باستخدام 10% من صور التحقق في COCO (500 صورة)؛ واستبدل coco.yaml بمجموعة بياناتك الخاصة
model.export(format="qnn", name="81", imgsz=640, data="coco.yaml", fraction=0.1)على آخر 500 صورة من COCO val2017، التي لا تستخدمها المعايرة المذكورة أعلاه، حقق YOLO26n النتائج التالية في val على مضيف التصدير بنظام x86-64، مقارنةً بفحص PyTorch وتصدير ONNX بدقة FP32 على الصور نفسها:
| النموذج | mAPval 50-95 | mAPval 50 |
|---|---|---|
| PyTorch | 42.1 | 57.1 |
| ONNX FP32 | 42.0 | 56.9 |
QNN، تمت معايرته باستخدام coco8.yaml (4 صور) | 38.9 | 54.6 |
QNN، تمت معايرته باستخدام coco.yaml مع fraction=0.1 (500 صورة) | 39.1 | 54.5 |
أدت المعايرة على 500 صورة من COCO بدلًا من الصور الأربع في coco8.yaml إلى رفع mAPval 50-95 بمقدار 0.2 نقطة وخفض mAPval 50 بمقدار 0.1 نقطة، وسجّل كلا نموذجي QNN نتائج تقل عن تصدير ONNX بدقة FP32 بمقدار 2.9 إلى 3.1 نقطة في mAPval 50-95. في مجموعات البيانات الافتراضية الصغيرة، كان فقدان تقدير العمق هو الأكبر: على صور التحقق الأربع في depth8.yaml، التي استُخدمت أيضًا للمعايرة، بلغ delta1 لنموذج QNN لتقدير العمق 56.0% مقابل 89.7% لتصدير ONNX بدقة FP32. تحقّق من النموذج المُصدّر باستخدام بياناتك قبل نشره.
تنسيق المخرجات#
تكتب عملية التصدير ملفًا واحدًا وتُبقي نموذج ONNX الوسيط بجانبه:
| الملف | المحتويات |
|---|---|
yolo26n_qnn.onnx | نموذج ONNX بعقدة EPContext واحدة تضمّن ثنائية سياق QNN، وأسماء الفئات والمهمة وحجم الصورة وحجم الدفعة والخطوة ومُعاملات التصدير بوصفها بيانات وصفية في ONNX، تقرؤها Ultralytics عند تحميل النموذج |
yolo26n.onnx | الرسم البياني لـ ONNX بدقة FP32 الذي جرى تكميمه، مع الإدخال نفسه بترتيب القنوات أخيرًا. يحل محل تصدير yolo26n.onnx سابق للفحص نفسه في ذلك الدليل. لا يلزم للنشر: لا يستطيع YOLO() تشغيله ويفشل مع Got invalid dimensions for input: images |
يستقبل النموذج إدخالًا واحدًا باسم images وبالشكل (batch, height, width, 3): RGB، والقنوات أخيرًا (NHWC)، وfloat32، مع تحجيم القيم إلى 0-1. يختلف هذا عن الإدخال ذي القنوات أولًا في تصدير ONNX، ويطابق ترتيب إطارات الكاميرا وHTP. للمخرجات أشكال تصدير ONNX الافتراضي. الأشكال أدناه لفحوص YOLO26n عند imgsz=640، وهو حجم نماذج الأجهزة المحمولة الرسمية، وimgsz=224 للتصنيف، مع فحص Cityscapes yolo26n-sem.pt للتجزئة الدلالية:
| المهمة | imgsz | المخرجات |
|---|---|---|
| Detect | 640 | (1, 84, 8400) |
| Segment | 640 | (1, 116, 8400) و(1, 32, 160, 160) |
| دلالي | 640 | (1, 640, 640) وuint8، مؤشر الفئة لكل بكسل |
| العمق | 640 | (1, 1, 640, 640)، خريطة عمق |
| التصنيف | 224 | (1, 1000)، احتمالات الفئات |
| الوضعية | 640 | (1, 56, 8400) |
| OBB | 640 | (1, 20, 8400) |
- المخرجات الخام: لكل مرساة، مركز الصندوق x ومركزه y وعرضه وارتفاعه بوحدات بكسل الإدخال، ثم درجات الفئات، ثم قيم المهمة (32 معاملًا للقناع، أو 17 × 3 قيمة لنقاط المفتاح، أو زاوية OBB بالراديان). طبّق NMS بنفسك. راجع تنسيق مخرجات ONNX للاطلاع على تخطيط كل مهمة. لا تتوفر مخرجات بلا NMS أو مخرجات تتضمن NMS: يسجّل
nms=FalseThis export format does not support end2end models, disabling the end2end branch.، ويسجّلnms=Trueformat=qnn does not support embedded NMS; using nms=None.، ويكتبان كلاهما هذه المخرجات الخام. - التجزئة الدلالية: المخرج هو فهرس الفئة لكل بكسل بصيغة
uint8(وint32للنماذج التي تضم أكثر من 256 فئة)، ويُحتسب على NPU، وليس درجة لكل فئة. - التجزئة: يحتوي المخرج الثاني على نماذج أولية للقناع.
- التخطيط نفسه كما في ONNX: لكل مهمة وعلى صورة واحدة، طابق شكل كل مخرج ونوعه في نماذج QNN مخرجات تصدير ONNX بدقة FP32 للفحص نفسه. بلغ الارتباط 0.999 أو أكثر للمخرج الأول في مهام الكشف والتجزئة والوضعية وOBB، و0.95 للنماذج الأولية لقناع التجزئة. اختلفت المخرجات الخام بدرجة أكبر في التصنيف (ارتباط 0.76) والتجزئة الدلالية (تطابق 69% من وحدات البكسل) وتقدير العمق (ارتباط 0.24). في
valضمن مجموعات البيانات الافتراضية الصغيرة، كان فقدان تقدير العمق هو الأكبر؛ راجع المعايرة.
يقرأ YOLO("yolo26n_qnn.onnx") التخطيط من بيانات ONNX الوصفية؛ لذا لا تحتاج إلى هذه التفاصيل إلا عند تشغيل النموذج في شيفرتك الخاصة. تشمل مفاتيح البيانات الوصفية names وtask وimgsz وstride وbatch وend2end وargs، وkpt_shape لنماذج الوضعية.
التشغيل باستخدام ONNX Runtime#
لتشغيل النموذج خارج حزمة Ultralytics، سجّل موفّر تنفيذ QNN الخاص بـ onnxruntime-qnn مع ONNX Runtime، وحدّد مسار مكتبة الواجهة الخلفية لـ HTP. يتطلب الإصدار onnxruntime-qnn 2.x، الذي يوفر الوحدة onnxruntime_qnn. نُفّذ هذا على مضيف التصدير بنظام x86-64 ولم يُشغّل على جهاز Snapdragon:
# # صدّر أولًا: yolo export model=yolo26n.pt format=qnn name=81 imgsz=640
import ast
import numpy as np
import onnxruntime as ort
import onnxruntime_qnn as qnn_ep
ort.register_execution_provider_library("QNNExecutionProvider", qnn_ep.get_library_path())
devices = [d for d in ort.get_ep_devices() if d.ep_name == "QNNExecutionProvider"]
options = ort.SessionOptions()
options.add_provider_for_devices(devices, {"backend_path": qnn_ep.get_qnn_htp_path()})
session = ort.InferenceSession("yolo26n_qnn.onnx", sess_options=options)
image = np.zeros((1, 640, 640, 3), dtype=np.float32) # # صورتك بعد إضافة الحواف: RGB، NHWC، 0-1
output = session.run(None, {session.get_inputs()[0].name: image})[0]
assert output.shape == (1, 84, 8400), "export a detection model at imgsz=640"
names = ast.literal_eval(session.get_modelmeta().custom_metadata_map["names"]) # {0: 'شخص', 1: 'دراجة', ...}النشر#
على حاسوب محمول يعمل بنظام Windows على Snapdragon، أو لوحة Linux ARM64 يوفّر BSP الخاص بها بيئة تشغيل HTP (راجع لوحات Qualcomm Linux)، ثبّت الحزمة باستخدام pip install ultralytics onnxruntime-qnn وانسخ yolo26n_qnn.onnx إليها. يسجّل YOLO("yolo26n_qnn.onnx") بعد ذلك موفّر تنفيذ QNN ويشغّل ثنائية السياق بواجهة HTP الخلفية. لم تُشغّل عمليات التصدير المنفّذة باستخدام onnxruntime-qnn 2.8.0 لهذه الصفحة على جهاز Snapdragon؛ واستخدمت قياسات Windows عمليات تصدير v73 أقدم.
- مطابقة HTP: صدّر باستخدام
nameالخاص بجيل HTP في جهازك. - تطبيقات Android: يسرد ملف README الخاص بـ إضافة Flutter الإعداد المستخدم لنماذج
_qnn.onnx: حزمتاcom.microsoft.onnxruntime1.29.0وcom.qualcomm.qti2.51.0، وuseLegacyPackaging = trueفيpackagingOptions.jniLibs، لأن محمّل Hexagon DSP يحتاج إلى ملفات.soفعلية. ويذكر أيضًا أن عمليات التصدير المنفّذة قبل Ultralytics 8.4.188 باستخدامonnxruntime-qnn2.4 أو أحدث تفشل في التحميل هناك معInput name not found. لم يُجرّب هذا الإعداد مع عمليات التصدير الواردة في هذه الصفحة. - NPU فقط: تعمل ثنائية السياق على HTP فقط في جهاز Snapdragon. لاستخدام GPU من Adreno أو CPU، صدّر نموذج LiteRT أو ONNX عاديًا بدلًا منه؛ تقارن قياسات Android بين LiteRT على CPU وGPU وQNN على NPU.
- شكل إدخال ثابت: يعمل النموذج دائمًا باستخدام
imgszوbatchالمحددين عند التصدير، واللذين تقرؤهما Ultralytics من بيانات ONNX الوصفية. يُتجاهلimgszإذا مُرّر إلىpredictأوval. تُضاف حشوة إلى الدفعات الأصغر، كما شغّل نموذجbatch=2تنبؤات على صورة واحدة وثلاث صور. - نموذج QNN واحد لكل عملية: حمّل نموذج QNN ثانيًا، أو شغّل
valبعدpredict، في عملية Python جديدة؛ راجع القيود. - اسم الملف: أبقِ
_qnn.onnxفي نهاية اسم الملف، لأن Ultralytics تتعرّف على التنسيق من خلاله. يُحمّل الملف المنسوخ باسمyolo26n_npu.onnxكنموذج ONNX عادي ويفشل معEPContext node generated by 'QNNExecutionProvider' is not compatible with any execution provider added to the session.
إضافة Ultralytics Flutter#
تشغّل إضافة Ultralytics YOLO لـ Flutter عمليات تصدير QNN لمهام YOLO26 السبع كلها على Android، للاستدلال الفوري عبر الكاميرا والتنبؤ بصورة واحدة. دعم QNN اختياري: فعّل بيئة تشغيل QNN وأضف تبعية ONNX Runtime الخاصة بها كما هو موضّح في ملف README للإضافة. أُجريت قياسات Android الواردة في هذه الصفحة باستخدامها. لنظام iOS، راجع SDK Ultralytics لنظام iOS وتكامل Core ML.
لوحات Qualcomm Linux#
على لوحة Dragonwing مثل IQ-8275، التي تعمل بنظام Qualcomm Linux أو BSP من Yocto، تأتي بيئة التشغيل من BSP المزوّد من الشركة المصنّعة للوحة والمفعّل لـ QAIRT، ولا تُضمّن في النموذج المُصدّر. لاستدلال HTP، يجب أن يوفر BSP موفّر تنفيذ ONNX Runtime QNN وlibQnnSystem.so وlibQnnHtp.so ومكتبات HTP stub وskeleton الخاصة بجيل HTP في اللوحة (v75 لـ IQ-8275) ودعم FastRPC في مساحة المستخدم مثل libcdsprpc.so وبرنامج DSP الثابت ومشغّلات FastRPC المتوافقة مع النواة. يجب أن تكون مكتبة skeleton في مسار مكتبات DSP الخاص بـ BSP. يتطلب تنفيذ GPU استخدام libQnnGpu.so ومشغّل Adreno في مساحة المستخدم بدلًا من ذلك، مع تصدير ONNX عادي، لأن ملفات _qnn.onnx تستهدف HTP.
أدلة النشر#
- موفّر تنفيذ ONNX Runtime QNN: الخيارات والمعاملات المدعومة وحزم Android وWindows للموفّر الذي يحمّل ملفات
_qnn.onnx. - مجموعة تطوير برامج Qualcomm AI Engine Direct: مرجع Qualcomm لـ QNN وQAIRT.
- إضافة Ultralytics YOLO لـ Flutter: تطبيقات Android التي تستخدم نماذج QNN وLiteRT وCore ML.
- LiteRT وMediaTek Dimensity: النشر على Android باستخدام CPU وGPU، وكذلك وحدات NPU من MediaTek.
- خيارات نشر النماذج: قارن QNN بتنسيقات التصدير الأخرى.
القيود واستكشاف الأخطاء وإصلاحها#
- macOS وPython 3.10: تتوفر حزم
onnxruntime-qnn2.x فقط لـ Python من 3.11 إلى 3.14 على Linux وWindows. على macOS وعلى Linux مع Python 3.10، يفشل تثبيتonnxruntime-qnn(يبلّغ pip عنNo matching distribution found for onnxruntime-qnn)، ثم تتابع عملية التصدير وتكمّم النموذج قبل أن تفشل معFailed to load library .../onnxruntime/capi/libonnxruntime_providers_qnn.so. على Windows x64 مع Python 3.10، يثبّت pip الإصدار الأقدمonnxruntime-qnn1.23.2 بدلًا منه، ولم يُختبر هذا الإصدار. صدّر على Linux أو Windows باستخدام Python 3.11 أو أحدث، أو عبر منصة Ultralytics. - تعطيل التثبيت التلقائي: عند استخدام
YOLO_AUTOINSTALL=falseمن دونonnxruntime-qnn، تسجّل عملية التصديرUltralytics requirement ['onnxruntime-qnn'] not found, AutoUpdate disabled by YOLO_AUTOINSTALL=Falseوتفشل مع الخطأ نفسهFailed to load library. ثبّته كما هو موضّح في دليل البدء السريع. - ملف إخراج موجود: تكتب عملية التصدير
yolo26n_qnn.onnxبجوار ملف.pt، ولا تستبدله ONNX Runtime: إذا كان الملف موجودًا، تفشل عملية التصدير معFailed to generate EP context model since the file '"yolo26n_qnn.onnx"' exists already. Please remove the EP context model if you want to re-generate it.، وقد تنتهي عملية Python بعد ذلك بخطأ تجزئة. احذف الملف السابق أو أعد تسميته قبل التصدير مجددًا، حتى عند استخدامnameأوimgszأوdataمختلف. - نموذج QNN ثانٍ في عملية واحدة: يفشل تحميل نموذج
_qnn.onnxثانٍ، أو تشغيلvalأو عملية تصدير بعدpredictمع نموذج QNN، مع الخطأEP library is already registered under QNNExecutionProvider. ينجح تنفيذ التنبؤ عدة مرات باستخدام كائنYOLOنفسه، وكذلك ينجحpredictمباشرة بعد التصدير. استخدم عملية Python جديدة لكل نموذج، كما تفعل واجهة CLIyolo. - شكل إدخال ثابت: يفشل
dynamic=Trueمعargument 'dynamic' is not supported for format='qnn'. أعد التصدير لتغيير حجم الصورة أو حجم الدفعة. - المعايرة من دون
data: تسجّل عملية التصديرINT8 export requires a missing 'data' arg for calibration. Using default 'data=coco8.yaml'.وتجري المعايرة على مجموعة البيانات الافتراضية الصغيرة للمهمة. مرّرdataمع صور تمثّل بيانات النشر لديك. - تحذير opset: ما لم تمرّر
opset=21، تسجّل أداة تكميم ONNX RuntimeThe original model opset version is 18, which does not support 16-bit integer quantization natively. Please update the model to opset >= 21. Automatically update the model to opset 21. Please verify the quantized model.، مع وضع opset الخاص بتصديرك بدلًا من 18، وترفع الرسم البياني إلى opset 21. تتابع عملية التصدير ولا يلزم اتخاذ أي إجراء. - الفحوص المدرّبة باستخدام
quantize=8: يفشل فحص ضُبط باستخدام التدريب الواعي بالتكميم معformat='qnn' cannot export a QAT model: its Q/DQ ranges are only read by the 'onnx' and 'engine' backends. صدّر الفحص الذي بدأت منه الضبط بدلًا منه. - الاستدلال على مضيف التصدير: على Linux بنظام x86-64، شغّل
onnxruntime-qnnثنائيتي السياقname=73وname=81على CPU، بزمن يقارب 0.3 ثانية (للتصنيف) إلى 16 ثانية (للعمق) لكل صورة لـ YOLO26n على CPU خادم مزدحم، مقارنةً ببضعة أجزاء من الثانية على الهاتف. استخدمه لفحص التصدير، لا لقياس سرعته.
للاطلاع على الأخطاء الأخرى، راجع دليل المشكلات الشائعة.
الأداء المقاس#
تعرض الجداول أدناه زمن استجابة صورة واحدة على جهازي Snapdragon، مقاسًا باستخدام نماذج HTP v81 المنشورة v0.7.0 (Android) وعمليات تصدير HTP v73 الأقدم (Windows)، وحجم عمليات التصدير المُنشأة على خادم Linux بنظام x86-64 لهذه الصفحة. تعرض كل خلية لزمن الاستجابة الزمن الإجمالي بالمللي ثانية، مع تقسيم المعالجة المسبقة / الاستدلال / المعالجة اللاحقة أسفلها، ويظهر عمود النموذج الأسرع بالخط العريض. تعرض صفحة نموذج YOLO26 دقة فحوص PyTorch.
هاتف Android#
الأجهزة: Xiaomi 17 بذاكرة LPDDR5X سعتها 12 GB ونظام Android 17 / API 37. يحتوي معالجه Snapdragon 8 Elite Gen 5 بدقة تصنيع 3 nm (SM8850) على CPU Qualcomm Oryon بثماني نوى (نواتا Prime بتردد يصل إلى 4.6 GHz و6 نوى Performance بتردد يصل إلى 3.62 GHz) وGPU من Adreno وNPU من Hexagon (HTP v81).
| النموذج | المهمة | الحجم (بكسل) | CPU w8a32 LiteRT (مللي ثانية) | GPU w8a32 LiteRT (مللي ثانية) | NPU QNN W8A16 (ms) |
|---|---|---|---|---|---|
| YOLO26n | Detect | 640 | 36.9 1.9 / 32.6 / 2.3 | 10.6 1.8 / 6.2 / 2.6 | 10.2 1.9 / 6.0 / 2.3 |
| YOLO26n-seg | Segment | 640 | 50.5 1.9 / 42.9 / 5.8 | 18.0 1.9 / 9.5 / 6.6 | 16.2 2.1 / 8.4 / 5.7 |
| YOLO26n-sem | دلالي | 640 | 45.7 1.9 / 35.7 / 8.2 | 30.6 1.9 / 20.5 / 8.3 | 10.8 2.0 / 6.2 / 2.6 |
| YOLO26n-depth | العمق | 640 | 66.8 2.2 / 55.0 / 9.7 | 21.9 2.1 / 10.1 / 9.8 | 19.3 2.2 / 7.4 / 9.7 |
| YOLO26n-cls | التصنيف | 224 | 3.6 0.3 / 3.3 / 0.0 | 2.0 0.4 / 1.4 / 0.2 | 0.8 0.3 / 0.5 / 0.0 |
| YOLO26n-pose | الوضعية | 640 | 39.9 2.0 / 36.5 / 1.4 | 10.0 1.8 / 6.7 / 1.4 | 9.7 1.9 / 5.9 / 1.8 |
| YOLO26n-obb | OBB | 640 | 36.3 2.0 / 33.2 / 1.2 | 10.1 2.6 / 5.9 / 1.6 | 8.1 1.9 / 5.1 / 1.0 |
- قيم السرعة هي أزمنة استجابة للدفعات على صورة واحدة: متوسط 15 تشغيلًا بعد 3 عمليات إحماء على
bus.jpg، مقاسًا باستخدام أداة قياس الأداء على الجهاز0.7.1الخاصة بـإضافة Flutter وأصولv0.7.0الرسمية (عمليات تصدير Ultralytics 8.4.188). تناوب ترتيب الواجهات الخلفية بين المهام في جولة تسلسلية واحدة. أكدت السجلات الأصلية أن كل صف CPU استخدم LiteRT CPU/XNNPACK، وأن كل صف GPU فوّض الرسم البياني كاملًا إلى LiteRT OpenCL (LITERT_CL)، وأن كل صف NPU استخدم واجهة QNN الخلفية لـ Hexagon HTP. - يمثل عمودا CPU وGPU نماذج LiteRT
w8a32من الإصدار نفسه (LiteRT]، لذا يقارن الجدول NPU بالمعالجات الأخرى في الهاتف نفسه. - يتوفر سجل قياس الأداء التفصيلي في وثيقة أداء Flutter.
- قارن أجهزة Android الأخرى في تكامل LiteRT، بما في ذلك دليل MediaTek Dimensity، وأجهزة Apple في تكامل Core ML.
حاسوب محمول بنظام Windows على Snapdragon#
الأجهزة: حاسوب Lenovo محمول بذاكرة 32 GB ونظام Windows 11. يحتوي Snapdragon X Elite (X1E78100) على CPU Qualcomm Oryon باثنتي عشرة نواة وGPU من Adreno وNPU من Hexagon (HTP v73). لم يُسجّل طراز Lenovo المحدد.
تقارن هذه الجولة السابقة خط أساس CPU بدقة PyTorch FP32 بنماذج QNN على NPU من Hexagon. أُجريت باستخدام ultralytics 8.4.67 وonnxruntime-qnn 2.2.0 وtorch 2.10.0+cpu وPython 3.12.10، على نماذج v73 صُدّرت قبل اعتماد أحجام الأجهزة المحمولة 224/640 معيارًا؛ لذا عمل نموذجا التجزئة الدلالية وOBB عند 1024 بكسل، ولا يوجد صف للعمق. تعرض كل خلية الزمن الإجمالي الكامل لـ model.predict() مع تقسيم المعالجة المسبقة / الاستدلال / المعالجة اللاحقة المبلّغ عنه أسفلها؛ وقد يشمل الإجمالي النفقات العامة لإطار العمل خارج هذه المراحل الثلاث.
| النموذج | المهمة | الحجم (بكسل) | CPU PT FP32 (ms) | NPU Hexagon QNN W8A16 (ms) |
|---|---|---|---|---|
| YOLO26n | Detect | 640 | 91.4 4.3 / 75.2 / 0.1 | 27.2 4.9 / 19.4 / 0.9 |
| YOLO26n-seg | Segment | 640 | 138.8 4.5 / 127.1 / 2.8 | 34.3 5.0 / 24.0 / 5.1 |
| YOLO26n-sem | دلالي | 1024 | 295.8 9.1 / 189.2 / 94.8 | 133.0 8.8 / 37.4 / 83.9 |
| YOLO26n-cls | التصنيف | 224 | 15.4 3.0 / 9.8 / 0.0 | 11.7 2.7 / 5.5 / 0.0 |
| YOLO26n-pose | الوضعية | 640 | 109.6 4.6 / 102.9 / 0.2 | 28.9 5.3 / 23.3 / 0.6 |
| YOLO26n-obb | OBB | 1024 | 267.8 8.1 / 254.6 / 0.1 | 64.8 8.9 / 54.7 / 0.6 |
- قيم السرعة هي أزمنة استجابة للدفعات على صورة واحدة: متوسط 100 تشغيل بعد 10 عمليات إحماء على
bus.jpg، مقاسًا باستخدامtime.perf_counter()حول استدعاءmodel.predict()الكامل على جهاز استقر حراريًا. - كان NPU من Hexagon أسرع بمقدار 2.2 إلى 4.1 مرات من خط أساس CPU في PyTorch عند 640 و1024 بكسل، وأسرع بمقدار 1.3 مرة لمصنّف 224 بكسل، حيث يكون لزمن المعالجة المسبقة الثابت أثر أكبر.
حجم النموذج#
حجم نماذج كشف YOLO26 بالميغابايت (10^6 بايت)، بوصفها فحص PyTorch وملف _qnn.onnx لـ HTP v81 عند imgsz=640. تطبع سجلات التصدير الحجم بوحدة MiB، مثل (3.5 MB) لـ YOLO26n v81:
| النموذج | PyTorch | QNN v81 |
|---|---|---|
| YOLO26n | 5.5 | 3.6 |
| YOLO26s | 20.4 | 11.1 |
| YOLO26m | 44.3 | 22.8 |
| YOLO26l | 53.2 | 27.9 |
| YOLO26x | 118.7 | 60.6 |
صُدّرت باستخدام ultralytics 8.4.215 وonnxruntime-qnn 2.8.0 وonnxruntime 1.32.0 على خادم Linux بنظام x86-64 من دون أجهزة Snapdragon. يسرد قسم المعايرة دقة تصدير YOLO26n على COCO.
نبذة عن Qualcomm QNN#
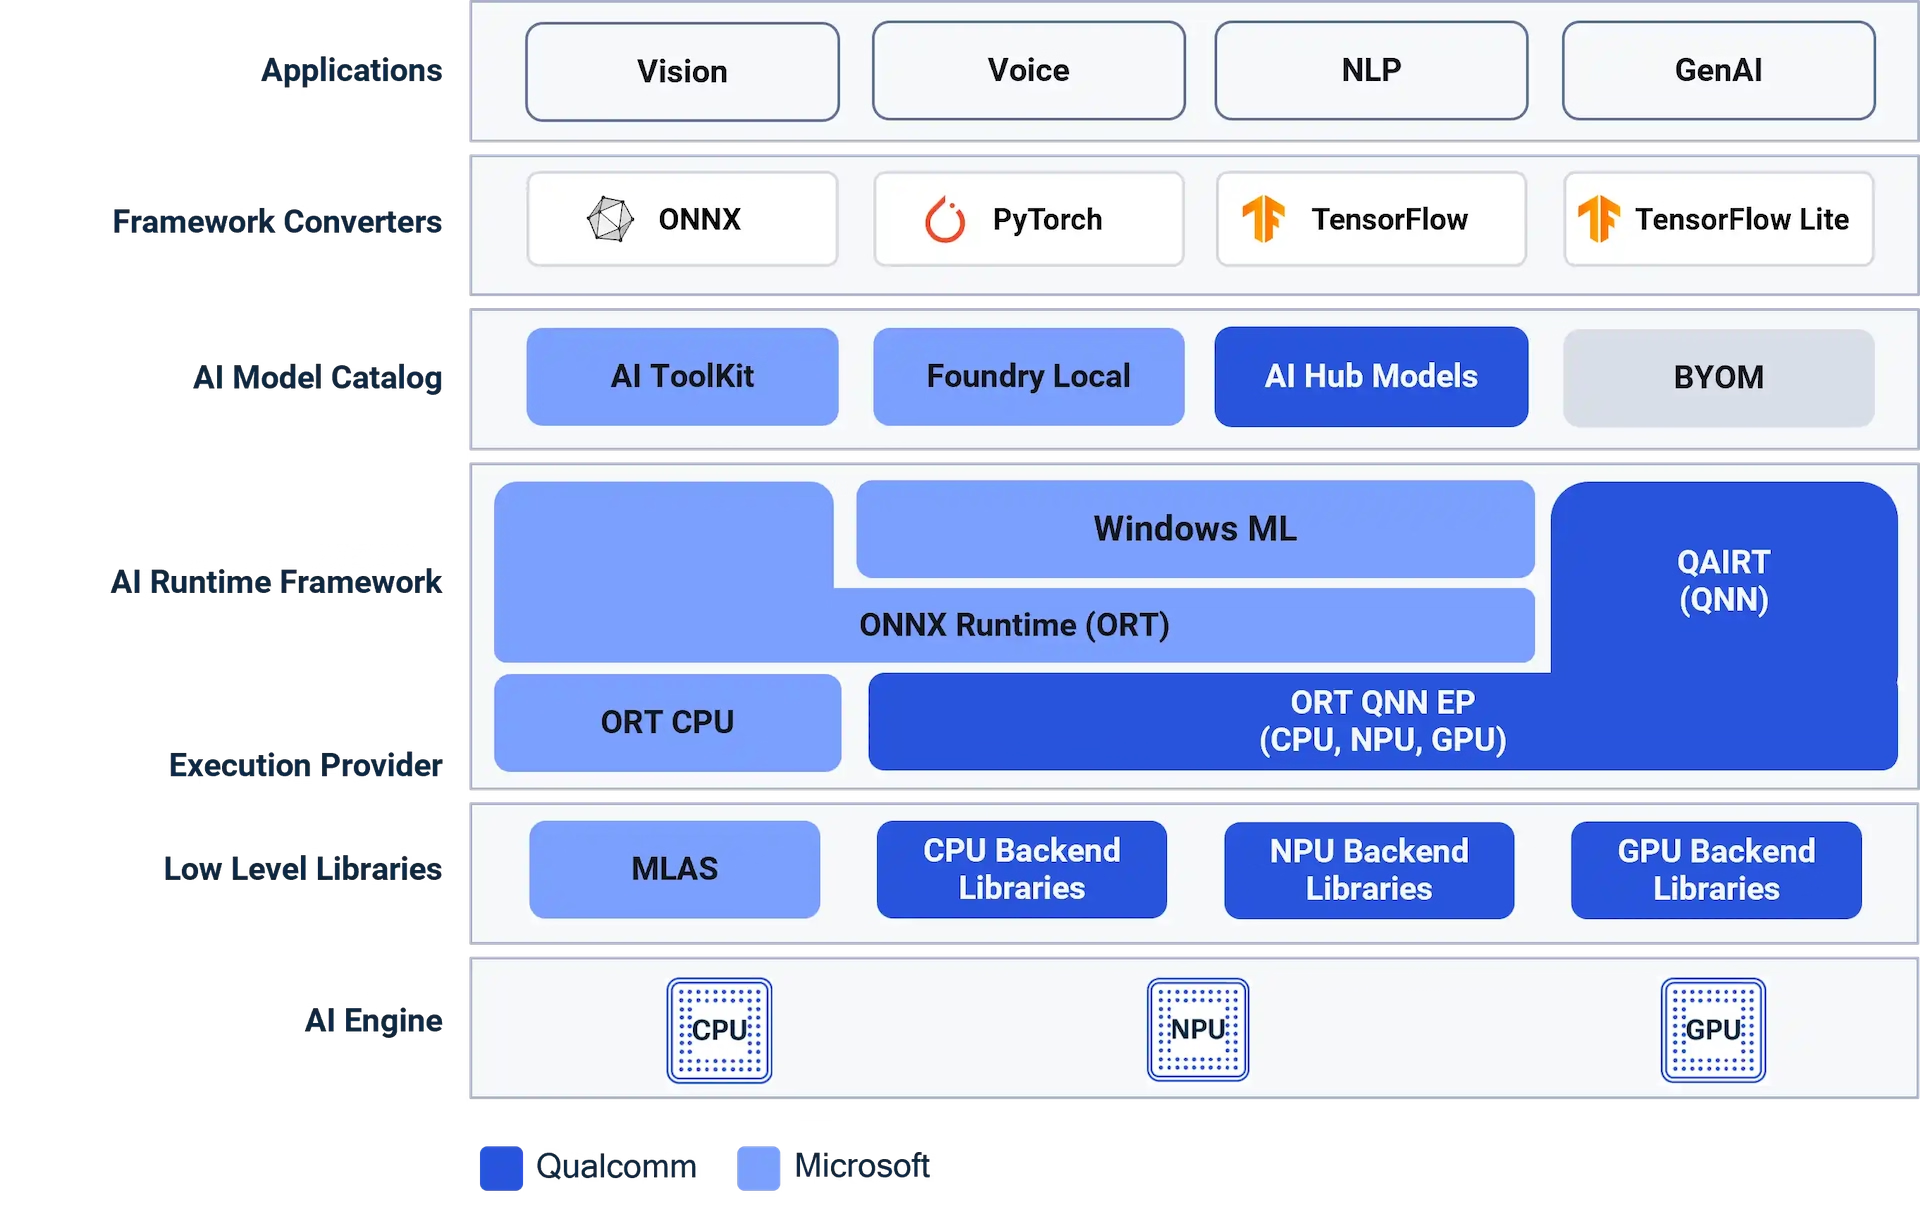
يشكّل Qualcomm AI Engine Direct (QNN) جزءًا من حزمة تطوير البرامج Qualcomm AI Runtime (QAIRT)، ويشغّل الشبكات العصبية على CPU وGPU من Adreno وNPU من Hexagon في معالجات Snapdragon وDragonwing عبر واجهة API واحدة ومكتبة واجهة خلفية لكل معالج. وهو يحل محل حزمة تطوير البرامج الأقدم Snapdragon Neural Processing Engine (SNPE). تستخدم Ultralytics واجهته الخلفية HTP عبر موفّر تنفيذ ONNX Runtime QNN. للاطلاع على المرجع الكامل، راجع مجموعة تطوير برامج Qualcomm AI Engine Direct.
الأسئلة الشائعة#
لا. تُجرى عملية التصدير باستخدام حزمة
onnxruntime-qnnمن PyPI، التي تتضمن مكتبات QAIRT، ونُفّذت جميع عمليات التصدير المُدرجة في هذه الصفحة على خادم Linux بنظام x86-64 من دون حساب Qualcomm أو تنزيل SDK أو أجهزة Snapdragon. لا تحتاج إلى الجهاز إلا لتشغيل النموذج بسرعة NPU.Qualcomm AI Hub هي خدمة Qualcomm السحابية لتجميع النماذج وتنميط أدائها وقياسه على أجهزة Snapdragon المستضافة، وتتطلب حسابًا لدى Qualcomm. يجمّع تصدير Ultralytics ملفًا ثنائيًا لسياق QNN لـ Hexagon NPU نفسه على حاسوبك باستخدام استدعاء واحد لـ
export(format="qnn")، من دون حساب أو رفع ملفات، ويمكنك قياس سرعته على جهازك.


التعليقات
اطرح سؤالًا، وشارك نتائجك، أو ساعد شخصًا آخر.