التجزئة الدلالية باستخدام Ultralytics YOLO#
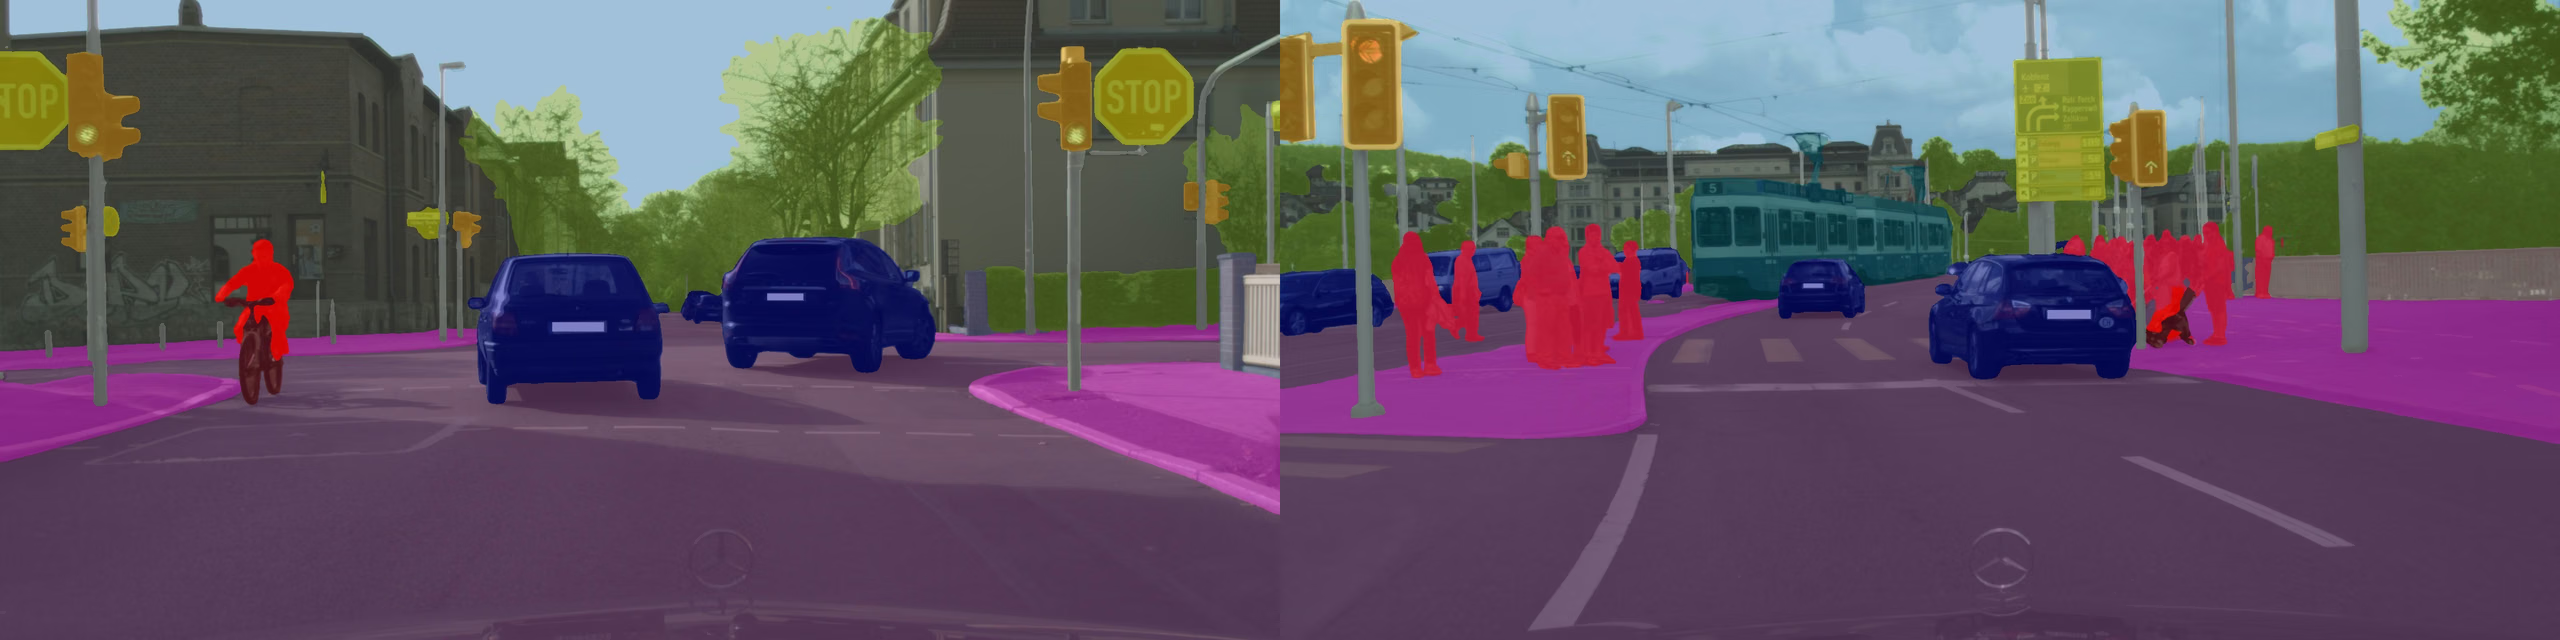
يُسند التقسيم الدلالي تصنيفًا إلى كل بكسل في الصورة، منتجًا خريطة تصنيف كثيفة تغطي المشهد بأكمله. وعلى خلاف تقسيم المثيلات، الذي يفصل الكائنات الفردية، يجمع التقسيم الدلالي جميع البكسلات من التصنيف نفسه معًا بغض النظر عن عدد الكائنات المميزة الموجودة.
Watch: Semantic Segmentation with Ultralytics YOLO26 | Quickstart Tutorial
يتمثل ناتج نموذج التقسيم الدلالي في خريطة تصنيف واحدة بارتفاع الصورة وعرضها، حيث تتوافق قيمة كل بكسل مع معرّف التصنيف المتنبأ به. وهذا يجعل التقسيم الدلالي مثاليًا لمهام تحليل المشهد مثل القيادة الذاتية، والتصوير الطبي، ورسم خرائط الغطاء الأرضي.
استخدم مهمة task=semantic أو مهمة CLI yolo semantic للتقسيم الدلالي. تستخدم ملفات نماذج التقسيم الدلالي YOLO26 اللاحقة -sem، مثل yolo26n-sem.pt.
النماذج#
تظهر أدناه نماذج التقسيم الدلالي YOLO26 المدرّبة مسبقًا على مجموعة بيانات Cityscapes.
تُنزل النماذج تلقائيًا من أحدث إصدار من Ultralytics عند الاستخدام الأول.
| النموذج | الحجم (بكسل) | mIoUval | السرعة RTX3090 PyTorch (ms) | المعاملات (M) | FLOPs (B) |
|---|---|---|---|---|---|
| YOLO26n-sem | 1024 × 2048 | 78.3 | 4.4 ± 0.0 | 1.6 | 23.8 |
| YOLO26s-sem | 1024 × 2048 | 80.8 | 8.4 ± 0.0 | 6.5 | 91.0 |
| YOLO26m-sem | 1024 × 2048 | 82.0 | 19.9 ± 0.1 | 14.3 | 305.5 |
| YOLO26l-sem | 1024 × 2048 | 82.9 | 26.5 ± 0.1 | 17.8 | 388.2 |
| YOLO26x-sem | 1024 × 2048 | 83.6 | 48.9 ± 0.2 | 40.1 | 866.9 |
- قيم mIoUval مخصّصة لنموذج واحد وبمقياس واحد على مجموعة التحقق Cityscapes.
أعد الإنتاج باستخدامyolo semantic val data=cityscapes.yaml device=0 imgsz=2048 - تُحسَب مقاييس السرعة كمتوسط على صور التحقق من Cityscapes باستخدام مثيل RTX3090.
أعد الإنتاج باستخدامyolo semantic val data=cityscapes.yaml batch=1 device=0|cpu imgsz=2048 - قيم Params وFLOPs مخصّصة للنموذج المدمج بعد تنفيذ
model.fuse()، الذي يدمج طبقات Conv وBatchNorm. وتحتفظ نقاط التحقق المدرّبة مسبقًا ببنية التدريب الكاملة، وقد تُظهر أعدادًا أعلى.
تظهر أدناه نماذج التقسيم الدلالي YOLO26 المدرّبة مسبقًا على مجموعة بيانات ADE20K.
تُنزل النماذج تلقائيًا من أحدث إصدار من Ultralytics عند الاستخدام الأول.
| النموذج | الحجم (بكسل) | mIoUval | السرعة RTX3090 PyTorch (ms) | المعاملات (M) | FLOPs (B) |
|---|---|---|---|---|---|
| YOLO26n-sem-ade20k | 640 | 38.8 | 3.9 ± 0.2 | 1.6 | 4.5 |
| YOLO26s-sem-ade20k | 640 | 45.6 | 4.2 ± 0.3 | 6.5 | 17.5 |
| YOLO26m-sem-ade20k | 640 | 47.4 | 4.7 ± 0.3 | 14.4 | 59.6 |
| YOLO26l-sem-ade20k | 640 | 49.7 | 8.3 ± 0.2 | 17.9 | 75.2 |
| YOLO26x-sem-ade20k | 640 | 51.5 | 9.9 ± 0.3 | 40.2 | 168.4 |
- قيم mIoUval مخصّصة لنموذج واحد وبمقياس واحد على مجموعة التحقق ADE20K.
أعد الإنتاج باستخدامyolo semantic val model=yolo26n-sem-ade20k.pt data=ade20k.yaml device=0 imgsz=640، مع استبدالyolo26n-sem-ade20k.ptبنقطة التحققyolo26*-sem-ade20k.ptالمطلوبة. - تُحسَب مقاييس السرعة كمتوسط على صور التحقق من ADE20K باستخدام مثيل RTX3090.
أعد الإنتاج باستخدامyolo semantic val model=yolo26n-sem-ade20k.pt data=ade20k.yaml batch=1 device=0|cpu imgsz=640، مع استبدالyolo26n-sem-ade20k.ptبنقطة التحققyolo26*-sem-ade20k.ptالمطلوبة. - قيم Params وFLOPs مخصّصة للنموذج المدمج بعد تنفيذ
model.fuse()، الذي يدمج طبقات Conv وBatchNorm. وتحتفظ نقاط التحقق المدرّبة مسبقًا ببنية التدريب الكاملة، وقد تُظهر أعدادًا أعلى.
راجع مع معاينة YOLO27 غير الإصدار الرسمي للحصول على نتائج mIoU الأولية لـ Cityscapes.
التدريب#
درّب YOLO26n-sem على مجموعة بيانات Cityscapes8 لمدة 100 حقبة وبحجم صورة 1024. للحصول على قائمة كاملة بالوسائط المتاحة، راجع صفحة الإعداد.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-sem.yaml")  # build a new model from YAML
model = YOLO("yolo26n-sem.pt")  # load a pretrained model (recommended for training)
model = YOLO("yolo26n-sem.yaml").load("yolo26n-sem.pt")  # build from YAML and transfer weights

# Train the model
results = model.train(data="cityscapes8.yaml", epochs=100, imgsz=1024)
اطّلع على التفاصيل الكاملة لوضع train في صفحة التدريب. ويمكن أيضًا تدريب نماذج التقسيم الدلالي باستخدام التدريب السحابي على منصة Ultralytics.
تنسيق مجموعة البيانات#
تستخدم مجموعات بيانات التقسيم الدلالي صور أقنعة أحادية القناة، عادةً بصيغة PNG، حيث تمثل قيمة كل بكسل معرّف تصنيف. تُعامل البكسلات التي قيمتها 255 على أنها "تجاهل" وتُستبعد من حساب الخسارة. يجب أن يحدد ملف YAML لمجموعة البيانات مسارات الصور ومجلدات الأقنعة المقابلة لها. راجع دليل مجموعة بيانات التقسيم الدلالي لمعرفة تفاصيل التنسيق. تشمل مجموعات البيانات المدعومة Cityscapes وADE20K. ويمكنك إدارة مجموعات البيانات الدلالية ووضع تسميات لها باستخدام إضافة التعليقات التوضيحية على منصة Ultralytics.
التحقق#
تحقق من دقة نموذج YOLO26n-sem المدرّب على مجموعة بيانات للتقسيم الدلالي. مرّر data صراحةً لضمان استخدام ملف YAML المقصود لمجموعة البيانات أثناء التحقق.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-sem.pt")  # load an official model
model = YOLO("path/to/best.pt")  # load a custom model

# Validate the model
metrics = model.val(data="cityscapes.yaml")
metrics.miou  # mean Intersection over Union
metrics.pixel_accuracy # overall pixel accuracyالتنبؤ#
استخدم نموذج YOLO26n-sem مدرّبًا لإجراء التنبؤات على الصور.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-sem.pt")  # load an official model
model = YOLO("path/to/best.pt")  # load a custom model

# Predict with the model
results = model("https://ultralytics.com/images/bus.jpg")  # predict on an image

# Access the results
for result in results:
    semantic_mask = result.semantic_mask.data  # class map, shape (H,W), integer dtype selected by class count
راجع تفاصيل الوضع predict الكاملة في صفحة التنبؤ.
مخرجات النتائج#
يعيد التقسيم الدلالي في YOLO كائن Results واحدًا لكل صورة. تخزّن كل نتيجة خريطة تصنيف كثيفة واحدة للصورة بأكملها بدلًا من قائمة بأقنعة الكائنات. تتشارك البكسلات ذات التصنيف المتنبأ به نفسه معرّف التصنيف نفسه، حتى عندما تنتمي إلى كائنات منفصلة.
| السمة | النوع | الشكل | الوصف |
|---|---|---|---|
result.semantic_mask | SemanticMask | (H,W) | خريطة الفئات الكثيفة. |
result.semantic_mask.data | torch.uint8torch.int16torch.int32 | (H,W) | معرّفات التصنيف؛ يحدد عدد التصنيفات نوع البيانات. |
result.masks | - | - | لا توجد أقنعة مثيلات. |
result.boxes | - | - | لا توجد مربعات مثيلات أو درجات ثقة. |
result.masks.xy | - | - | لا توجد مضلعات افتراضيًا. |
للاطلاع على حقول Results الخاصة بالمهمة عبر جميع المهام، راجع قسم نتائج التنبؤ حسب المهمة.
يتنبأ التقسيم الدلالي بخريطة تصنيف كثيفة، ثم يعيد تغيير حجمها إلى أبعاد الصورة لعرضها واستخدامها لاحقًا. لذلك قد تبدو البُنى الرفيعة جدًا، مثل علامات المسارات وخطوط الملاعب والأعمدة والأسلاك، متدرجة عند تشغيل الاستدلال بقيمة imgsz أقل بكثير من دقة الصورة الأصلية. إذا بدت الحدود متعرجة، فأعد أولًا اختبار نموذج PyTorch الأصلي .pt باستخدام قيمة أكبر لـimgsz، مثل 1024 أو 1280، أو أقرب قيمة عملية إلى حجم الصورة المصدر. استخدم النماذج المُصدّرة فقط بعد التأكد من أن ناتج .pt مقبول، إذ لا يمكن للمدخلات منخفضة الدقة استعادة التفاصيل الدقيقة التي لم تكن موجودة في خريطة التصنيف المتنبأ بها.
التقسيم إلى مثيلات مقابل التقسيم الدلالي#
| الجانب | تقسيم المثيلات (task="segment") | التقسيم الدلالي (task="semantic") |
|---|---|---|
| هدف التنبؤ | تقسيم كل كائن مكتشف على حدة | إسناد معرّف تصنيف واحد إلى كل بكسل |
| حقل الناتج | result.masks | result.semantic_mask |
| البيانات الأساسية | result.masks.data | result.semantic_mask.data |
| الشكل | (N,H,W) | (H,W) |
| قيم البكسلات | قيم القناع الثنائي: 0 أو 1 | معرّفات التصنيف: 0، 1، 2، ... |
| نوع البيانات | torch.uint8 | torch.uint8torch.int16torch.int32 |
| الكائنات من التصنيف نفسه | تُحفظ كمثيلات منفصلة | تُدمج في المنطقة التصنيفية نفسها |
| المضلعات | نعم، من خلال result.masks.xy وresult.masks.xyn | لا يوجد ناتج مضلعات افتراضيًا |
| المربعات ودرجة الثقة | نعم، من خلال result.boxes | لا توجد مربعات أو درجات ثقة لكل مثيل |
| الاستخدام المعتاد | العدّ، والتتبع، والقص، والقياس على مستوى الكائن | وضع تسميات كثيف للمشهد، والمساحة القابلة للقيادة، والغطاء الأرضي، والمناطق الطبية |
التصدير#
صدّر نموذج YOLO26n-sem إلى تنسيق مختلف مثل ONNX أو CoreML أو غير ذلك.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-sem.pt")  # load an official model
model = YOLO("path/to/best.pt")  # load a custom model

# Export the model
model.export(format="onnx")
توجد تنسيقات التصدير المتاحة للتقسيم الدلالي YOLO26 في الجدول أدناه. يمكنك التصدير إلى أي تنسيق باستخدام الوسيط format، أي format='onnx' أو format='engine'. ويمكنك إجراء التنبؤ أو التحقق مباشرةً على النماذج المُصدّرة، أي yolo predict model=yolo26n-sem.onnx. تظهر أمثلة الاستخدام لنموذجك بعد اكتمال التصدير.
| التنسيق | وسيط format | النموذج | البيانات الوصفية | الوسائط |
|---|---|---|---|---|
| PyTorch | - | yolo26n-sem.pt | ✅ | - |
| TorchScript | torchscript | yolo26n-sem.torchscript | ✅ | imgsz، quantize، dynamic، nms، batch، device |
| ONNX | onnx | yolo26n-sem.onnx | ✅ | imgsz، quantize، dynamic، simplify، opset، nms، batch، data، fraction، device |
| OpenVINO | openvino | yolo26n-sem_openvino_model/ | ✅ | imgsz، quantize، dynamic، nms، batch، data، fraction، device |
| TensorRT | engine | yolo26n-sem.engine | ✅ | imgsz، quantize، dynamic، simplify، opset، workspace، nms، batch، data، fraction، device |
| CoreML | coreml | yolo26n-sem.mlpackage | ✅ | imgsz، dynamic، quantize، nms، batch، device |
| TF SavedModel | saved_model | yolo26n-sem_saved_model/ | ✅ | imgsz، keras، quantize، opset، nms، batch، data، fraction، device |
| TF GraphDef | pb | yolo26n-sem.pb | ❌ | imgsz، opset، batch، device |
| TF Edge TPU | edgetpu | yolo26n-sem_edgetpu.tflite | ✅ | imgsz، quantize، opset، data، fraction، device |
| PaddlePaddle | paddle | yolo26n-sem_paddle_model/ | ✅ | imgsz، batch، device |
| MNN | mnn | yolo26n-sem.mnn | ✅ | imgsz، batch، dynamic، quantize، simplify، opset، nms، device |
| NCNN | ncnn | yolo26n-sem_ncnn_model/ | ✅ | imgsz، quantize، batch، device |
| IMX500 | imx | yolo26n-sem_imx_model/ | ✅ | imgsz، quantize، data، fraction، nms، device |
| RKNN | rknn | yolo26n-sem_rknn_model/ | ✅ | imgsz، batch، name، quantize، simplify، opset، data، fraction، device |
| ExecuTorch | executorch | yolo26n-sem_executorch_model/ | ✅ | imgsz، batch، device |
| Axelera | axelera | yolo26n-sem_axelera_model/ | ✅ | imgsz، batch، quantize، data، fraction، device |
| DEEPX | deepx | yolo26n-sem_deepx_model/ | ✅ | imgsz، quantize، simplify، opset، data، optimize، device |
| Qualcomm QNN | qnn | yolo26n-sem_qnn.onnx | ✅ | imgsz، batch، name، quantize، simplify، opset، data، fraction، device |
| LiteRT | litert | yolo26n-sem.tflite | ✅ | imgsz، quantize، batch، data، fraction، device |
| Hailo | hailo | yolo26n-sem_hailo_model/ | ✅ | imgsz، name، quantize، data، fraction، simplify، conf، iou |
| Huawei Ascend | ascend | yolo26n-sem_ascend_model/ | ✅ | imgsz، batch، name، quantize، opset، simplify، nms |
| Apple Core AI | coreai | yolo26n-sem.aimodel | ✅ | imgsz، batch، quantize |
يفترض nms=None المخرجات الخام لـ NMS الخارجي. قم بتعيين nms=False لتحديد رأس متاح خالٍ من NMS؛ وتتراجع التنسيقات غير المدعومة إلى مسار إخراجها الأصلي. وتحدد مُدخلات nms أعلاه التنسيقات التي يمكنها تضمين NMS باستخدام nms=True.
راجع تفاصيل export الكاملة في صفحة التصدير.
الأسئلة الشائعة#
لتدريب نموذج تقسيم دلالي YOLO26 على مجموعة بيانات مخصصة، تحتاج إلى إعداد صور أقنعة PNG حيث تمثل قيمة كل بكسل معرّف تصنيف (0، 1، 2، ...) وتُتجاهل البكسلات التي قيمتها 255 أثناء التدريب. أنشئ ملف YAML لمجموعة البيانات يشير إلى دليلي الصور والأقنعة، ثم درّب النموذج:
مثالfrom ultralytics import YOLO # Load a pretrained YOLO26 semantic segmentation model model = YOLO("yolo26n-sem.pt") # Train the model results = model.train(data="path/to/your_dataset.yaml", epochs=100, imgsz=512)راجع صفحة الإعدادات للاطلاع على مزيد من الوسائط المتاحة.
يُعد تقسيم المثيلات والتقسيم الدلالي مهمتين على مستوى البكسل، لكنهما يختلفان في جانب أساسي:
- يسند التقسيم الدلالي تصنيفًا إلى كل بكسل، لكنه لا يميز بين الكائنات الفردية من التصنيف نفسه. فعلى سبيل المثال، تشترك جميع السيارات في المشهد في تصنيف واحد.
- يحدد تقسيم المثيلات كل كائن فردي على حدة، منتجًا أقنعة مميزة لكل كائن حتى إن كانت تنتمي إلى التصنيف نفسه.
يناسب التقسيم الدلالي مهام فهم المشهد مثل القيادة الذاتية ورسم خرائط الغطاء الأرضي، بينما يُفضّل تقسيم المثيلات عندما يكون عدّ الكائنات الفردية أو تتبعها مهمًا.
نعم. إذا كانت مجموعة البيانات تستخدم تسميات المضلعات الخاصة بـUltralytics YOLO (واحد
.txtلكل صورة)، فاحذفmasks_dirمن ملف YAML لمجموعة البيانات، وتأكد من عدم وجود مجلدmasks/بجوار صورك في جذر مجموعة البيانات (فوجوده وحده يفعّل وضع قناع PNG حتى من دون تعيينmasks_dir). ثم يحوّل المحمّل المضلعات إلى أقنعة دلالية لكل صورة أثناء التشغيل. بالنسبة إلى مجموعات البيانات متعددة التصنيفات (N > 1)، يُلحَق تصنيفbackgroundإضافي تلقائيًا بـnames. وبالنسبة إلى مجموعات البيانات أحادية التصنيف (N == 1)، يظل التدريب بتصنيف واحد — ويصبح تصنيفك المعلن1في القناع، بينما تصبح البكسلات غير المغطاة0. راجع دليل مجموعة بيانات التقسيم الدلالي لمعرفة التفاصيل.يوفر Ultralytics YOLO26 إعدادات مضمّنة لعدة مجموعات بيانات للتقسيم الدلالي:
- Cityscapes: مشاهد شوارع حضرية تضم 19 تصنيفًا، وتُستخدم على نطاق واسع في أبحاث القيادة الذاتية.
- ADE20K: مجموعة بيانات واسعة النطاق لتحليل المشاهد تضم 150 تصنيفًا.
يمكنك أيضًا استخدام أي مجموعة بيانات مخصصة توفر تعليقات توضيحية للأقنعة بصيغة PNG، حيث تتوافق قيم البكسلات مع معرّفات التصنيف.
تحقق من نموذج تقسيم دلالي YOLO26 مدرّب مسبقًا باستخدام ملف YAML لمجموعة البيانات المستخدم للتقييم:
مثالfrom ultralytics import YOLO # Load a pretrained model model = YOLO("yolo26n-sem.pt") # Validate the model metrics = model.val(data="cityscapes.yaml") print("Mean IoU:", metrics.miou) print("Pixel Accuracy:", metrics.pixel_accuracy)ستوفر لك هذه الخطوات مقاييس تحقق مثل متوسط التقاطع على الاتحاد (mIoU) ودقة البكسلات، وهما مقياسان قياسيان لتقييم أداء التقسيم الدلالي.
صدّر نموذج تقسيم دلالي YOLO26 إلى تنسيق ONNX باستخدام أوامر Python أو CLI:
مثالfrom ultralytics import YOLO # Load a pretrained model model = YOLO("yolo26n-sem.pt") # Export the model to ONNX format model.export(format="onnx")لمزيد من التفاصيل حول التصدير إلى تنسيقات متنوعة، راجع صفحة التصدير.