Jeu de données COCO-Seg#
Le jeu de données COCO-Seg fournit des masques de segmentation d’instances COCO (objets courants en contexte) — 118,287 images d’entraînement et 5,000 images de validation, avec des masques polygonaux couvrant 80 catégories d’objets — au format d’annotation Ultralytics YOLO. Il reprend les images originales de COCO et ses annotations de segmentation natives, converties pour l’entraînement YOLO, ce qui en fait une ressource de référence pour les chercheurs et développeurs travaillant sur des tâches de segmentation d’instances.
Modèles COCO-Seg préentraînés#
| Modèle | taille (pixels) | mAPboîte50-95 (e2e) | mAPmasque50-95 (e2e) | Vitesse CPU ONNX (ms) | Vitesse T4 TensorRT10 (ms) | paramètres (M) | FLOPs (B) |
|---|---|---|---|---|---|---|---|
| YOLO26n-seg | 640 | 39.6 | 33.9 | 53.3 ± 0.5 | 2.1 ± 0.0 | 2.7 | 9.3 |
| YOLO26s-seg | 640 | 47.3 | 40.0 | 118.4 ± 0.9 | 3.3 ± 0.0 | 10.4 | 34.5 |
| YOLO26m-seg | 640 | 52.5 | 44.1 | 328.2 ± 2.4 | 6.7 ± 0.1 | 23.6 | 121.7 |
| YOLO26l-seg | 640 | 54.4 | 45.5 | 387.0 ± 3.7 | 8.0 ± 0.1 | 28.0 | 140.1 |
| YOLO26x-seg | 640 | 56.5 | 47.0 | 787.0 ± 6.8 | 16.4 ± 0.1 | 62.8 | 314.0 |
Fonctionnalités clés#
- COCO-Seg fournit des masques de segmentation d’instances pour 123 287 images annotées de COCO train2017/val2017 (118 287 pour l’entraînement + 5 000 pour la validation), sur les quelque 330 000 images de la version complète de COCO.
- Le jeu de données comprend les mêmes 80 catégories d’objets que le jeu de données COCO d’origine.
- Les annotations fournissent des masques de segmentation d’instances au format d’étiquettes polygonales YOLO.
- COCO-Seg fournit des métriques mAP et mAR standardisées pour évaluer les performances de segmentation d’instances et comparer efficacement les performances des modèles.
- Taille du téléchargement : environ 20,3 Go lors de la première utilisation (
train2017.zip+val2017.zip+ étiquettes). Le fichiertest2017.zipde 7 Go n’est pas téléchargé automatiquement, car les annotations de référence de ces images ne sont pas publiées et qu’elles ne sont nécessaires que pour une soumission test-dev2017.
Structure du jeu de données#
Le jeu de données COCO-Seg est réparti en trois sous-ensembles :
- Train2017 : 118 287 images pour entraîner des modèles de segmentation d’instances.
- Val2017 : 5 000 images utilisées pour la validation lors du développement du modèle.
- Test-dev2017 : 20 288 des 40 670 images test2017, utilisées pour l’évaluation comparative. Les annotations de vérité terrain de ce sous-ensemble ne sont pas accessibles au public : les prédictions doivent donc être envoyées au serveur d’évaluation COCO pour être notées.
Pour des expérimentations à plus petite échelle, consulte les sous-ensembles COCO128-Seg (128 images) et COCO8-Seg (8 images).
Applications#
COCO-Seg est largement utilisé pour entraîner et évaluer des modèles d’apprentissage profond pour la segmentation d’instances, notamment les modèles YOLO. Le grand nombre d’images annotées, la diversité des catégories d’objets et les métriques d’évaluation normalisées en font une ressource de référence pour les chercheurs et les spécialistes de la vision par ordinateur. Les annotations COCO-Seg complètes peuvent également être consultées et gérées sur Ultralytics Platform.
Fichier YAML du jeu de données#
Un fichier YAML définit la configuration du jeu de données. Il contient des informations sur les chemins d’accès, les classes et d’autres éléments pertinents. Pour le jeu de données COCO-Seg, le fichier coco.yaml est maintenu à https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO 2017 dataset https://cocodataset.org by Microsoft
# Documentation: https://docs.ultralytics.com/datasets/detect/coco
# Example usage: yolo train data=coco.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco ← downloads here (20.3 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco # dataset root dir
train: train2017.txt # train images (relative to 'path') 118287 images
val: val2017.txt # val images (relative to 'path') 5000 images
test: test-dev2017.txt # 20288 of 40670 images, submit via https://cocodataset.org/#detection-eval

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: |
  from pathlib import Path

  from ultralytics.utils import ASSETS_URL
  from ultralytics.utils.downloads import download

  # Download labels
  segments = True  # segment or box labels
  dir = Path(yaml["path"])  # dataset root dir
  urls = [ASSETS_URL + ("/coco2017labels-segments.zip" if segments else "/coco2017labels.zip")]  # labels
  download(urls, dir=dir.parent)

  # Download data (test2017.zip excluded: ground truth is withheld, only used for the eval-server test-dev split)
  urls = [
      "http://images.cocodataset.org/zips/train2017.zip",  # 19G, 118k images
      "http://images.cocodataset.org/zips/val2017.zip",  # 1G, 5k images
  ]
download(urls, dir=dir / "images", threads=3)Utilisation#
Pour entraîner un modèle YOLO26n-seg sur le jeu de données COCO-Seg pendant 100 époques, avec une taille d’image de 640, tu peux utiliser les extraits de code suivants.
from ultralytics import YOLO

# Charger un modèle
model = YOLO("yolo26n-seg.pt")  # charger un modèle préentraîné (recommandé pour l’entraînement)

# Entraîner le modèle
results = model.train(data="coco.yaml", epochs=100, imgsz=640)
Exemples d’images et annotations#
COCO-Seg contient les mêmes images variées, catégories d’objets et scènes complexes que COCO, avec des masques de segmentation d’instances au format d’étiquettes YOLO. Voici quelques exemples d’images du jeu de données, accompagnées des masques de segmentation d’instances correspondants :
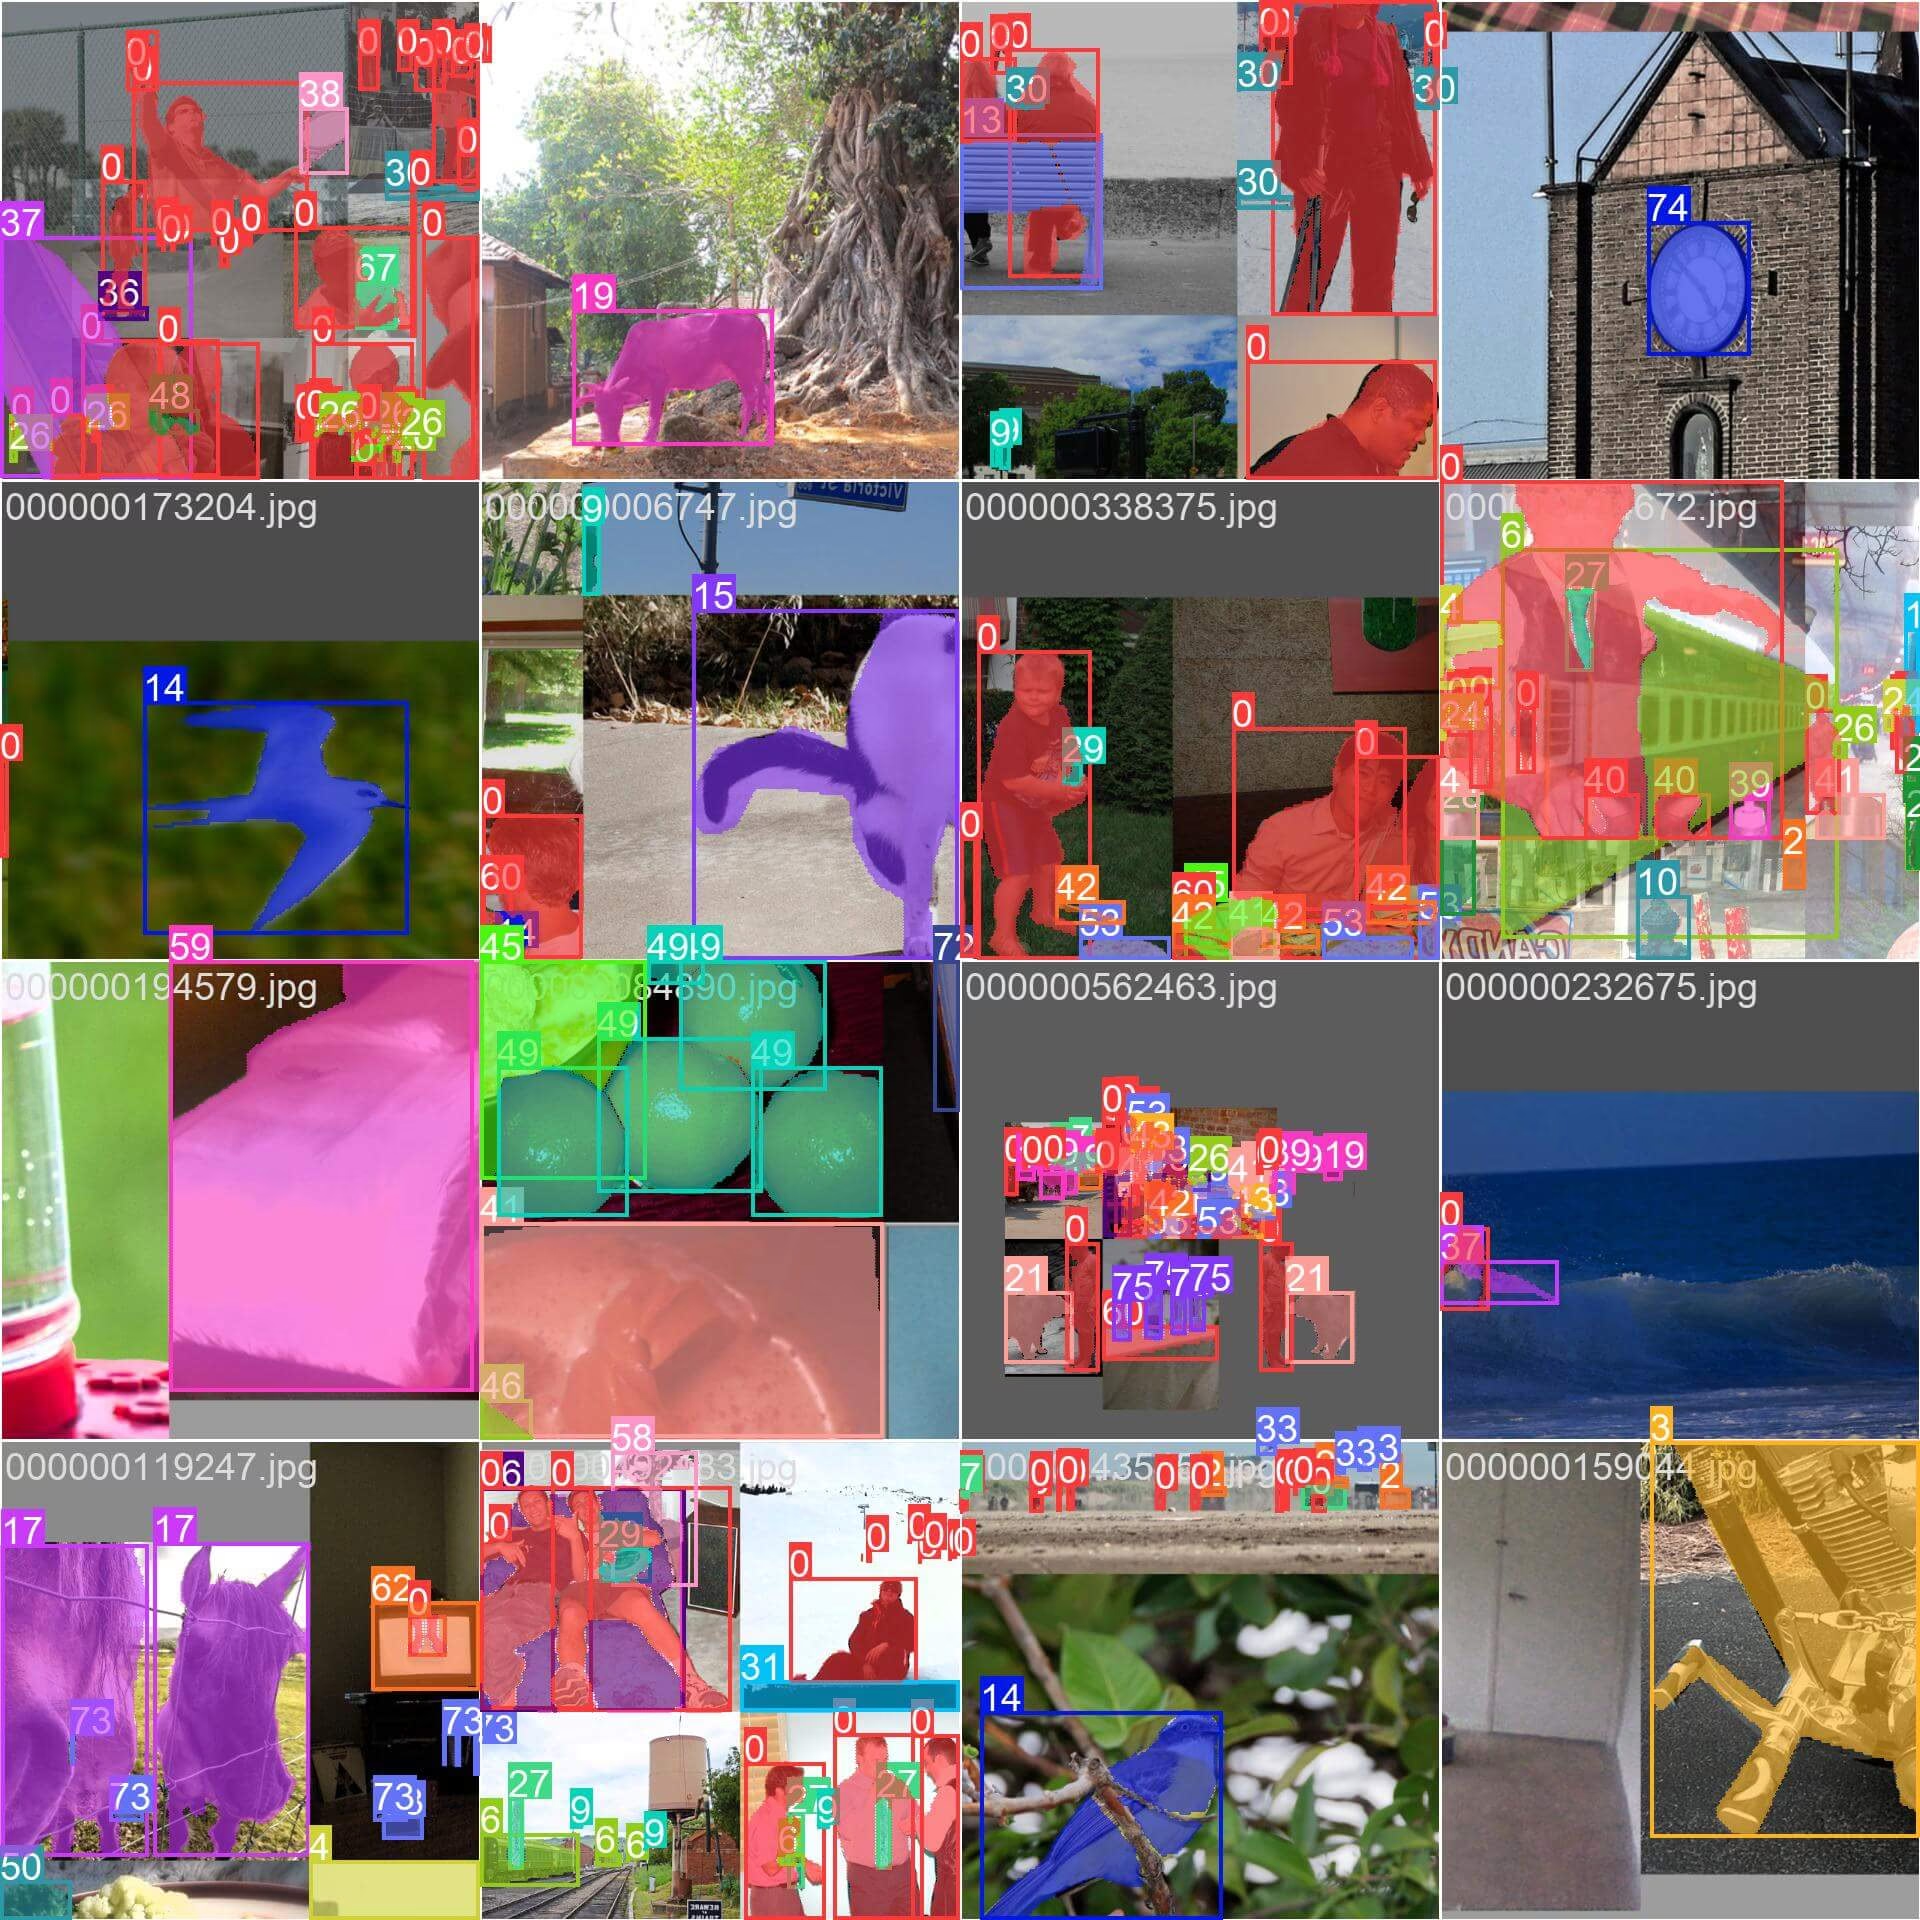
- Image en mosaïque : cette image montre un lot d’entraînement composé d’images du jeu de données assemblées en mosaïque. La mosaïque est une technique utilisée pendant l’entraînement qui combine plusieurs images en une seule afin d’augmenter la variété des objets et des scènes dans chaque lot d’entraînement. Cela aide le modèle à généraliser à différentes tailles d’objets, proportions et contextes.
Citations et remerciements#
Si tu utilises le jeu de données COCO-Seg dans tes travaux de recherche ou de développement, cite l’article original sur COCO et mentionne l’extension COCO-Seg :
@misc{lin2015microsoft,
      title={Microsoft COCO: Common Objects in Context},
      author={Tsung-Yi Lin and Michael Maire and Serge Belongie and Lubomir Bourdev and Ross Girshick and James Hays and Pietro Perona and Deva Ramanan and C. Lawrence Zitnick and Piotr Dollár},
      year={2015},
      eprint={1405.0312},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Nous remercions le consortium COCO d’avoir créé et maintenu cette précieuse ressource pour la communauté de la vision par ordinateur.
FAQ#
COCO-Seg est le conditionnement au format Ultralytics YOLO des masques natifs de segmentation d’instances de COCO (objets courants en contexte), pour les mêmes 118,287 images train2017 et 5,000 images val2017. Les annotations COCO originales comprennent déjà ces masques polygonaux pour les 80 catégories d’objets ; COCO-Seg les convertit au format d’annotation YOLO utilisé pour l’entraînement à la segmentation d’instances d’objets.
Pour entraîner un modèle YOLO26n-seg sur le jeu de données COCO-Seg pendant 100 époques avec une taille d’image de 640, tu peux utiliser les extraits de code suivants. Pour obtenir la liste détaillée des arguments d’entraînement disponibles, consulte la page Entraînement du modèle.
Exemple d’entraînementfrom ultralytics import YOLO # Charger un modèle model = YOLO("yolo26n-seg.pt") # charger un modèle préentraîné (recommandé pour l’entraînement) # Entraîner le modèle results = model.train(data="coco.yaml", epochs=100, imgsz=640)Le jeu de données COCO-Seg comprend plusieurs caractéristiques clés :
- Fournit des masques de segmentation d’instances pour 123 287 images COCO train2017/val2017 annotées (118 287 pour l’entraînement + 5 000 pour la validation).
- Annote les mêmes 80 catégories d’objets que celles du COCO original.
- Fournit des masques de segmentation d’instances au format polygonal des étiquettes YOLO.
- Utilise des métriques d’évaluation normalisées, comme la précision moyenne (mAP) et le rappel moyen (mAR), pour les tâches de segmentation d’instances.
Le jeu de données COCO-Seg prend en charge plusieurs modèles de segmentation YOLO26 préentraînés, dont les métriques de performance varient. Voici un résumé des modèles disponibles et de leurs principales métriques :
Modèle taille
(pixels)mAPboîte50-95
(e2e)mAPmasque50-95
(e2e)Vitesse
CPU ONNX
(ms)Vitesse
T4 TensorRT10
(ms)paramètres
(M)FLOPs
(B)YOLO26n-seg 640 39.6 33.9 53.3 ± 0.5 2.1 ± 0.0 2.7 9.3 YOLO26s-seg 640 47.3 40.0 118.4 ± 0.9 3.3 ± 0.0 10.4 34.5 YOLO26m-seg 640 52.5 44.1 328.2 ± 2.4 6.7 ± 0.1 23.6 121.7 YOLO26l-seg 640 54.4 45.5 387.0 ± 3.7 8.0 ± 0.1 28.0 140.1 YOLO26x-seg 640 56.5 47.0 787.0 ± 6.8 16.4 ± 0.1 62.8 314.0 Ces modèles vont du modèle léger YOLO26n-seg au modèle plus précis YOLO26x-seg, et offrent différents compromis entre vitesse et précision adaptés aux exigences de diverses applications.
Le jeu de données COCO-Seg est réparti en trois sous-ensembles répondant à des besoins spécifiques d’entraînement et d’évaluation :
- Train2017 : contient 118 287 images principalement utilisées pour entraîner des modèles de segmentation d’instances.
- Val2017 : comprend 5,000 images utilisées pour la validation pendant l’entraînement.
- Test-dev2017 : contient 20,288 des 40,670 images test2017 réservées aux tests et à l’évaluation comparative des modèles entraînés. Note que les annotations de référence de ce sous-ensemble ne sont pas publiques et que les résultats de performance sont soumis au serveur d’évaluation COCO.
Pour des expérimentations à plus petite échelle, tu peux également envisager le jeu de données COCO128-Seg (128 images) ou le jeu de données COCO8-Seg, une version compacte qui ne contient que 8 images du jeu COCO train 2017.
Commentaires10
Pose une question, partage tes résultats ou aide quelqu’un d’autre.
liujieKermit
what the label format if I want to train my custom dataset, please give the solution step by step like label, train, val, export, predict
 Glenn JocherUltralytics(modifié)
@liujieKermit for custom segmentation training with YOLO26, follow these steps:
-
Label Format: Use YOLO segmentation format - one text file per image with class index and normalized polygon coordinates (minimum 3 points per object). Example:
<class> <x1> <y1> <x2> <y2> ... <xn> <yn> -
Dataset YAML: Create a YAML file (example
data.yaml):
path: /path/to/dataset train: images/train val: images/val names: 0: class1 1: class2- Train:
from ultralytics import YOLO model = YOLO('yolo26n-seg.pt') model.train(data='data.yaml', epochs=100, imgsz=640)- Export/Predict:
model.export(format='onnx')  # export
model.predict('image.jpg')  # predict
For full details see our Dataset Format Guide and Auto-Annotation Tools. For commercial use, review our license terms.
-
YingdiZhang
Thanks for the great work. I am new to YOLO and AI. How to download the COCO dataset? is just running python coco.yaml?
- Glenn JocherUltralytics(modifié)
@YingdiZhang to download the COCO dataset, you can run
yolo segment train data=coco.yamlin your terminal. This will automatically download the dataset for you. For more details, you can visit the Ultralytics documentation.
SacherTorte280
Dear developpers, I need to build a much simpler case where I'll only need <=5 labels, can I remove the others that i'll never use ?
 Paula DerrengerUltralytics(modifié)
@SacherTorte280 yes, you can customize the dataset to include only the labels you need. To do this, modify the
coco.yamlfile to include only the desired classes in thenamessection and adjust the dataset paths accordingly. Also make sure the class indices in your label files are remapped to match the newnames(0 to N-1) and remove labels of the dropped classes. This will allow you to train your model with a simplified set of labels. For more details on configuring the dataset, please refer to the COCO-Seg documentation.
MoAbbasid
i get a list out of index error when running convert_coco function please help
- Paula DerrengerUltralytics
Hi there! It looks like you're encountering a
list index out of rangeerror with theconvert_cocofunction. This can often happen if the script is trying to access an element that doesn't exist in a list. To help you resolve this issue, please ensure that:- The data paths in your
coco.yamlconfig file are correctly set and point to valid files. - The COCO dataset is correctly downloaded and structured as expected by the script.
If the paths and dataset structure are correct, it might be helpful to check if the specific segment of data causing the error is formatted correctly or missing elements.
Here's a quick check you can perform:
try:
    # Assuming convert_coco is called here
    convert_coco()
except IndexError as e:
    print("An index error occurred: ", e)
    # You can add more debugging information here to understand which part of the data is causing the problem
This snippet will catch the
IndexErrorand print it, potentially providing more insight on what's going wrong. If you need further assistance, please don't hesitate to share a snippet of the data or more details on the error! - The data paths in your
mohamed-ladjal
Greetings, I possess medical imagery depicting bone lesions. These images comprise 3D volumes of dimensions (256, 256, 128), with each volume containing 128 slices. Corresponding masks of identical dimensions are available. My objective is to either fine-tune or train a model using these slices to accurately segment the lesions mohamed mohamed.laadjel2019@gmail.com
- Glenn JocherUltralytics(modifié)
Hello Mohamed,
Great to hear about your project on segmenting bone lesions from medical imagery! For your 3D volumes, you can approach this by treating each slice as a separate 2D image for segmentation.
Given your setup, you might consider using our YOLO26-seg models, which are well-suited for segmentation tasks. Here’s a basic example of how you could set up your training with YOLO26:
from ultralytics import YOLO

# Load a pretrained segmentation model
model = YOLO('yolo26n-seg.pt')  # Choose the appropriate model size

# Prepare your dataset in a compatible format
# Ensure your dataset directory structure and annotations are correctly set up

# Train the model
results = model.train(data='your_dataset_config.yaml', epochs=100, imgsz=640)
Make sure your dataset is annotated similarly to how COCO-Seg annotations are structured, with masks corresponding to each slice. You might need to adjust the
your_dataset_config.yamlto correctly point to your training, validation, and test images along with their annotations.For more detailed guidance on preparing your dataset and annotations, you can refer to our documentation on COCO-Seg Dataset.
If you have any more questions or need further assistance, feel free to ask. Happy training! 🚀