Best practice per la distribuzione dei modelli#
Introduzione#
La distribuzione del modello è il passaggio di un progetto di computer vision che porta un modello dalla fase di sviluppo a un'applicazione reale. Esistono diverse opzioni di distribuzione dei modelli: la distribuzione cloud offre scalabilità e facilità di accesso, quella edge riduce la latenza avvicinando il modello alla fonte dei dati, mentre quella locale garantisce privacy e controllo. La scelta della strategia giusta dipende dalle esigenze della tua applicazione e richiede di bilanciare velocità, sicurezza e scalabilità.
Guarda: Come ottimizzare e distribuire modelli di IA: best practice, risoluzione dei problemi e considerazioni sulla sicurezza
È importante anche seguire le best practice quando distribuisci un modello, perché la distribuzione può influire notevolmente sull'efficacia e sull'affidabilità delle prestazioni del modello. In questa guida ci concentreremo su come assicurarti che la distribuzione del tuo modello sia fluida, efficiente e sicura.
Opzioni di distribuzione dei modelli#
Spesso, dopo aver addestrato, valutato e testato un modello, è necessario convertirlo in formati specifici per distribuirlo efficacemente in ambienti diversi, come cloud, edge o dispositivi locali.
Con YOLO26 puoi esportare il tuo modello in diversi formati in base alle tue esigenze di distribuzione. Ad esempio, esportare YOLO26 in ONNX è semplice ed è ideale per trasferire modelli tra framework. Per scoprire altre opzioni di integrazione e garantire una distribuzione fluida in ambienti diversi, visita il nostro catalogo delle integrazioni dei modelli.
Scelta dell'ambiente di distribuzione#
La scelta di dove distribuire il tuo modello di computer vision dipende da diversi fattori. Ogni ambiente presenta vantaggi e sfide specifici, quindi è fondamentale scegliere quello più adatto alle tue esigenze.
Distribuzione cloud#
La distribuzione cloud è ideale per le applicazioni che devono scalare rapidamente e gestire grandi quantità di dati. Piattaforme come AWS, Google Cloud e Azure semplificano la gestione dei modelli, dall'addestramento alla distribuzione. Offrono servizi come AWS SageMaker, Google AI Platform e Azure Machine Learning per aiutarti in ogni fase.
Tuttavia, il cloud può essere costoso, soprattutto in caso di utilizzo intensivo dei dati, e potresti riscontrare problemi di latenza se gli utenti si trovano lontano dai data center. Per gestire costi e prestazioni, è importante ottimizzare l'uso delle risorse e assicurarsi di rispettare le norme sulla privacy dei dati.
Distribuzione edge#
La distribuzione edge è adatta alle applicazioni che richiedono risposte in tempo reale e bassa latenza, in particolare in luoghi con accesso a Internet limitato o assente. Distribuire modelli su dispositivi edge come smartphone o dispositivi IoT garantisce un'elaborazione rapida e mantiene i dati in locale, migliorando così la privacy. La distribuzione edge consente inoltre di risparmiare banda perché riduce la quantità di dati inviati al cloud.
Tuttavia, spesso i dispositivi edge hanno una potenza di elaborazione limitata, quindi dovrai ottimizzare i tuoi modelli. Strumenti come LiteRT e NVIDIA Jetson possono aiutarti. Nonostante i vantaggi, gestire e aggiornare numerosi dispositivi può essere complesso.
Distribuzione locale#
La distribuzione locale è la scelta migliore quando la privacy dei dati è fondamentale o l'accesso a Internet è inaffidabile o assente. Eseguire i modelli su server locali o computer desktop ti offre il pieno controllo e mantiene al sicuro i tuoi dati. Può anche ridurre la latenza se il server è vicino all'utente.
Tuttavia, scalare in locale può essere difficile e la manutenzione può richiedere molto tempo. Usare strumenti come Docker per la containerizzazione e Kubernetes per la gestione può rendere più efficienti le distribuzioni locali. Per garantire il corretto funzionamento, sono necessari aggiornamenti e manutenzione regolari.
Containerizzazione per semplificare la distribuzione#
La containerizzazione è un approccio efficace che racchiude il tuo modello e tutte le sue dipendenze in un'unità standardizzata chiamata container. Questa tecnica garantisce prestazioni uniformi in ambienti diversi e semplifica il processo di distribuzione.
Vantaggi dell'uso di Docker per la distribuzione dei modelli#
Docker è diventato lo standard del settore per la containerizzazione nelle distribuzioni di machine learning per diversi motivi:
- Uniformità dell'ambiente: i container Docker racchiudono il tuo modello e tutte le sue dipendenze, eliminando il problema «sul mio computer funziona» e garantendo un comportamento uniforme negli ambienti di sviluppo, test e produzione.
- Isolamento: i container isolano le applicazioni l'una dall'altra, evitando conflitti tra versioni software o librerie diverse.
- Portabilità: i container Docker possono essere eseguiti su qualsiasi sistema che supporti Docker, semplificando la distribuzione dei modelli su piattaforme diverse senza modifiche.
- Scalabilità: puoi aumentare o ridurre facilmente il numero di container in base alla domanda, mentre strumenti di orchestrazione come Kubernetes possono automatizzare il processo.
- Controllo delle versioni: puoi assegnare una versione alle immagini Docker, monitorare le modifiche e, se necessario, ripristinare versioni precedenti.
Implementazione di Docker per distribuire YOLO26#
Per containerizzare il tuo modello YOLO26, puoi creare un Dockerfile che specifichi tutte le dipendenze e le configurazioni necessarie. Ecco un esempio di base:
FROM ultralytics/ultralytics:latest

WORKDIR /app

# Copy your model and any additional files
COPY ./models/yolo26n.pt /app/models/
COPY ./scripts /app/scripts/

# Set up any environment variables
ENV MODEL_PATH=/app/models/yolo26n.pt

# Command to run when the container starts
CMD ["python", "/app/scripts/predict.py"]
Questo approccio garantisce che la distribuzione del tuo modello sia riproducibile e uniforme negli ambienti di sviluppo, test e produzione.
Tecniche di ottimizzazione dei modelli#
Ottimizzare il tuo modello di computer vision aiuta a eseguirlo in modo efficiente, soprattutto quando lo distribuisci in ambienti con risorse limitate, come i dispositivi edge. Ecco alcune tecniche chiave per ottimizzare il modello.
Potatura del modello#
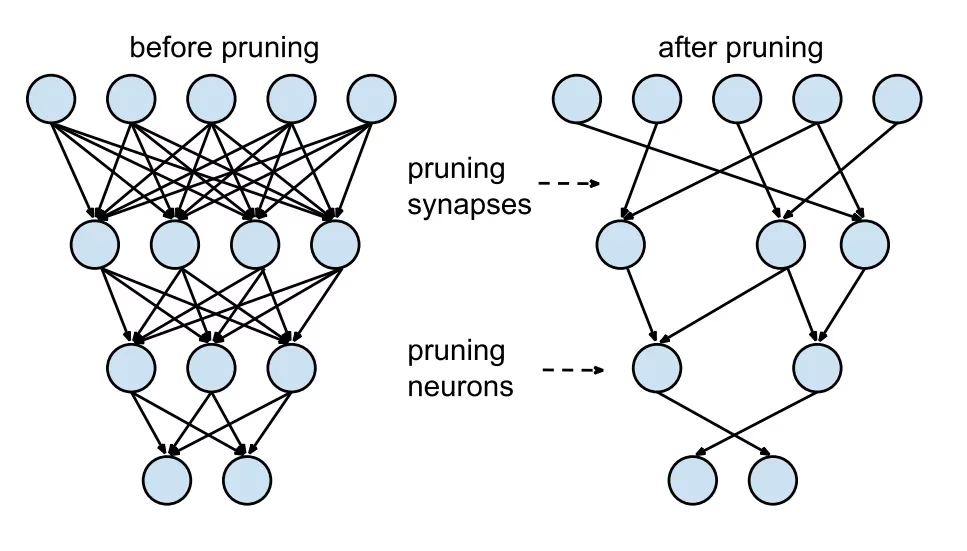
La potatura riduce le dimensioni del modello rimuovendo i pesi che contribuiscono poco al risultato finale. Rende il modello più piccolo e veloce senza comprometterne significativamente la precisione. La potatura consiste nell'individuare ed eliminare i parametri superflui, ottenendo un modello più leggero che richiede meno potenza di calcolo. È particolarmente utile per distribuire modelli su dispositivi con risorse limitate.
Quantizzazione del modello#
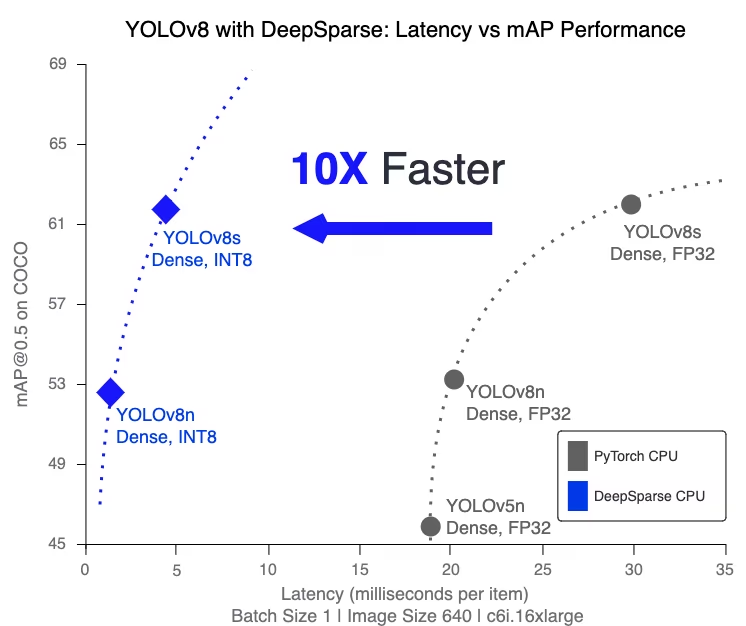
La quantizzazione converte i pesi e le attivazioni del modello da una precisione elevata (ad esempio, numeri in virgola mobile a 32 bit) a una precisione inferiore (ad esempio, interi a 8 bit). Riducendo le dimensioni del modello, accelera l'inferenza. L'addestramento consapevole della quantizzazione (QAT) è un metodo che tiene conto della quantizzazione durante l'addestramento del modello, preservando la precisione meglio della quantizzazione post-addestramento. Gestendo la quantizzazione durante la fase di addestramento, il modello impara ad adattarsi a una precisione inferiore, mantenendo le prestazioni e riducendo il fabbisogno computazionale.
Distillazione della conoscenza#
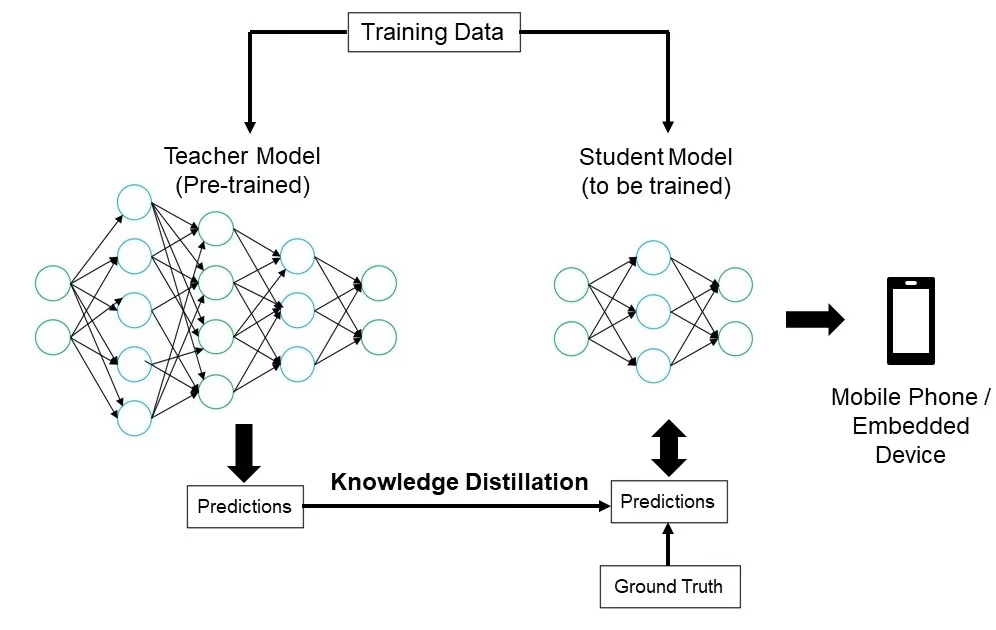
La distillazione della conoscenza consiste nell'addestrare un modello più piccolo e semplice (lo studente) a imitare gli output di un modello più grande e complesso (l'insegnante). Il modello studente impara ad approssimare le previsioni dell'insegnante, ottenendo un modello compatto che conserva gran parte della precisione dell'insegnante. Questa tecnica è utile per creare modelli efficienti, adatti alla distribuzione su dispositivi edge con risorse limitate.
Risoluzione dei problemi di distribuzione#
Potresti incontrare difficoltà durante la distribuzione dei tuoi modelli di visione artificiale, ma conoscere i problemi più comuni e le relative soluzioni può rendere il processo più agevole. Ecco alcuni suggerimenti generali per la risoluzione dei problemi e alcune buone pratiche che ti aiuteranno a gestire le difficoltà di distribuzione.
Il tuo modello è meno accurato dopo la distribuzione#
Un calo dell'accuratezza del tuo modello dopo la distribuzione può essere frustrante. Questo problema può dipendere da diversi fattori. Ecco alcuni passaggi che ti aiuteranno a individuare e risolvere il problema:
- Verifica la coerenza dei dati: controlla che i dati elaborati dal tuo modello dopo la distribuzione siano coerenti con quelli usati per l'addestramento. Differenze nella distribuzione, nella qualità o nel formato dei dati possono influire notevolmente sulle prestazioni.
- Convalida i passaggi di pre-elaborazione: verifica che tutti i passaggi di pre-elaborazione applicati durante l'addestramento vengano applicati con coerenza anche durante la distribuzione. Tra questi rientrano il ridimensionamento delle immagini, la normalizzazione dei valori dei pixel e altre trasformazioni dei dati.
- Valuta l'ambiente del modello: assicurati che le configurazioni hardware e software usate durante la distribuzione corrispondano a quelle usate durante l'addestramento. Differenze nelle librerie, nelle versioni e nelle capacità hardware possono generare discrepanze.
- Monitora l'inferenza del modello: registra input e output nelle varie fasi della pipeline di inferenza per rilevare eventuali anomalie. Questo può aiutarti a individuare problemi come il danneggiamento dei dati o la gestione non corretta degli output del modello.
- Rivedi l'esportazione e la conversione del modello: esporta nuovamente il modello e assicurati che il processo di conversione preservi l'integrità dei pesi e dell'architettura del modello.
- Esegui test con un dataset controllato: distribuisci il modello in un ambiente di test con un dataset sotto il tuo controllo e confronta i risultati con quelli della fase di addestramento. Potrai capire se il problema dipende dall'ambiente di distribuzione o dai dati.
Quando distribuisci YOLO26, diversi fattori possono influire sull'accuratezza del modello. La conversione dei modelli in formati come TensorRT comporta ottimizzazioni quali la quantizzazione dei pesi e la fusione dei layer, che possono causare lievi perdite di precisione. L'uso di FP16 (precisione a 16 bit) invece di FP32 (precisione a 32 bit) può accelerare l'inferenza, ma può introdurre errori di precisione numerica. Anche i vincoli hardware, come quelli di Jetson Nano, con un numero inferiore di core CUDA e una larghezza di banda della memoria ridotta, possono influire sulle prestazioni.
Le inferenze richiedono più tempo del previsto#
Quando distribuisci modelli di machine learning, è importante che funzionino in modo efficiente. Se le inferenze richiedono più tempo del previsto, l'esperienza utente e l'efficacia della tua applicazione possono risentirne. Ecco alcuni passaggi che ti aiuteranno a individuare e risolvere il problema:
- Esegui cicli di riscaldamento: i cicli iniziali spesso includono il tempo necessario alla configurazione, che può alterare le misurazioni della latenza. Esegui alcune inferenze di riscaldamento prima di misurare la latenza. Escludendo questi cicli iniziali otterrai una misurazione più accurata delle prestazioni del modello.
- Ottimizza il motore di inferenza: verifica che il motore di inferenza sia ottimizzato per la specifica architettura della tua GPU. Usa i driver e le versioni software più recenti, progettati per il tuo hardware, per garantire prestazioni e compatibilità ottimali.
- Usa l'elaborazione asincrona: l'elaborazione asincrona può aiutarti a gestire i carichi di lavoro in modo più efficiente. Usa tecniche di elaborazione asincrona per gestire più inferenze contemporaneamente, distribuire il carico e ridurre i tempi di attesa.
- Analizza la pipeline di inferenza: individuare i colli di bottiglia nella pipeline di inferenza può aiutarti a identificare la causa dei ritardi. Usa strumenti di profilazione per analizzare ogni passaggio del processo di inferenza e individuare e risolvere le fasi che causano ritardi significativi, come i layer inefficienti o i problemi di trasferimento dei dati.
- Usa una precisione adeguata: una precisione superiore al necessario può rallentare l'inferenza. Prova a usare una precisione inferiore, ad esempio FP16 (precisione a 16 bit) invece di FP32 (precisione a 32 bit). FP16 può ridurre i tempi di inferenza, ma tieni presente che può anche influire sull'accuratezza del modello.
Se riscontri questo problema durante la distribuzione di YOLO26, considera che YOLO26 offre diverse dimensioni dei modelli, ad esempio YOLO26n (nano) per i dispositivi con poca memoria e YOLO26x (extra-large) per le GPU più potenti. Scegliere la variante del modello più adatta al tuo hardware può aiutarti a bilanciare l'uso della memoria e i tempi di elaborazione.
Tieni inoltre presente che la dimensione delle immagini di input influisce direttamente sull'uso della memoria e sui tempi di elaborazione. Risoluzioni inferiori riducono l'uso della memoria e accelerano l'inferenza, mentre risoluzioni superiori migliorano l'accuratezza, ma richiedono più memoria e potenza di elaborazione.
Considerazioni sulla sicurezza nella distribuzione dei modelli#
Un altro aspetto importante della distribuzione è la sicurezza. Proteggere i modelli distribuiti è fondamentale per tutelare i dati sensibili e la proprietà intellettuale. Ecco alcune buone pratiche da seguire per distribuire i modelli in modo sicuro.
Trasmissione sicura dei dati#
È molto importante assicurarsi che i dati inviati tra client e server siano protetti, per impedire che vengano intercettati o consultati da persone non autorizzate. Puoi usare protocolli di crittografia come TLS (Transport Layer Security) per cifrare i dati durante la trasmissione. Anche se qualcuno li intercetta, non potrà leggerli. Puoi inoltre usare la crittografia end-to-end, che protegge i dati dalla fonte alla destinazione, impedendo a chiunque si trovi nel mezzo di accedervi.
Controlli degli accessi#
È fondamentale controllare chi può accedere al tuo modello e ai relativi dati per prevenirne l'uso non autorizzato. Usa metodi di autenticazione robusti per verificare l'identità degli utenti o dei sistemi che tentano di accedere al modello e valuta l'aggiunta dell'autenticazione a più fattori (MFA) per aumentare la sicurezza. Configura il controllo degli accessi basato sui ruoli (RBAC) per assegnare le autorizzazioni in base ai ruoli degli utenti, così che ciascuno possa accedere solo a ciò di cui ha bisogno. Conserva registri di controllo dettagliati per tracciare tutti gli accessi e le modifiche al modello e ai relativi dati, quindi controllali regolarmente per individuare eventuali attività sospette.
Offuscamento del modello#
Puoi proteggere il tuo modello dal reverse engineering e dagli usi impropri ricorrendo all'offuscamento. Questa tecnica prevede la crittografia dei parametri del modello, come pesi e bias nelle reti neurali, per rendere difficile alle persone non autorizzate comprendere o modificare il modello. Puoi anche offuscare l'architettura del modello rinominando layer e parametri oppure aggiungendo layer fittizi, rendendo più difficile il reverse engineering da parte degli aggressori. Anche distribuire il modello in un ambiente sicuro, come un enclave sicuro o un ambiente di esecuzione attendibile (TEE), può offrire un ulteriore livello di protezione durante l'inferenza.
Conclusioni e passaggi successivi#
Abbiamo esaminato alcune buone pratiche da seguire quando distribuisci modelli di visione artificiale. Proteggendo i dati, controllando gli accessi e offuscando i dettagli del modello, puoi tutelare le informazioni sensibili e mantenere i modelli in funzione senza problemi. Abbiamo anche visto come affrontare problemi comuni, come la riduzione dell'accuratezza e le inferenze lente, con strategie quali i cicli di riscaldamento, l'ottimizzazione dei motori, l'elaborazione asincrona, la profilazione delle pipeline e la scelta della precisione adeguata.
Dopo aver distribuito il modello, il passo successivo consiste nel monitorare, mantenere e documentare la tua applicazione. Il monitoraggio regolare aiuta a individuare e risolvere rapidamente i problemi, la manutenzione mantiene i modelli aggiornati e funzionanti e una buona documentazione tiene traccia di tutte le modifiche e gli aggiornamenti. Questi passaggi ti aiuteranno a raggiungere gli obiettivi del tuo progetto di visione artificiale.
Domande frequenti#
La distribuzione di un modello di machine learning, in particolare con Ultralytics YOLO26, prevede diverse buone pratiche per garantire efficienza e affidabilità. Per prima cosa, scegli l'ambiente di distribuzione più adatto alle tue esigenze: cloud, edge o locale. Ottimizza il modello con tecniche come pruning, quantizzazione e distillazione della conoscenza per distribuirlo in modo efficiente in ambienti con risorse limitate. Valuta l'uso della containerizzazione con Docker per garantire la coerenza tra ambienti diversi. Infine, assicurati che i dati siano coerenti e che i passaggi di pre-elaborazione corrispondano a quelli della fase di addestramento, così da mantenere le prestazioni. Per indicazioni più dettagliate, puoi anche consultare le opzioni di distribuzione dei modelli.
La risoluzione dei problemi di distribuzione può essere suddivisa in alcuni passaggi fondamentali. Se l'accuratezza del modello diminuisce dopo la distribuzione, verifica la coerenza dei dati, convalida i passaggi di pre-elaborazione e assicurati che l'ambiente hardware e software corrisponda a quello usato durante l'addestramento. Per ridurre i tempi di inferenza, esegui cicli di riscaldamento, ottimizza il motore di inferenza, usa l'elaborazione asincrona e analizza la pipeline di inferenza. Consulta la guida alla risoluzione dei problemi di distribuzione per approfondire queste buone pratiche.
L'ottimizzazione dei modelli Ultralytics YOLO26 per i dispositivi edge prevede tecniche come il pruning per ridurre le dimensioni del modello, la quantizzazione per convertire i pesi a una precisione inferiore e la distillazione della conoscenza per addestrare modelli più piccoli che emulano quelli più grandi. Queste tecniche consentono al modello di funzionare in modo efficiente su dispositivi con potenza di calcolo limitata. Strumenti come LiteRT e NVIDIA Jetson sono particolarmente utili per queste ottimizzazioni. Scopri di più su queste tecniche nella sezione dedicata all'ottimizzazione dei modelli.
La sicurezza è fondamentale quando distribuisci modelli di machine learning. Assicurati che i dati vengano trasmessi in modo sicuro usando protocolli di crittografia come TLS. Implementa controlli degli accessi robusti, che includano un'autenticazione efficace e il controllo degli accessi basato sui ruoli (RBAC). Le tecniche di offuscamento del modello, come la crittografia dei parametri e la distribuzione dei modelli in un ambiente sicuro, ad esempio un ambiente di esecuzione attendibile (TEE), offrono un'ulteriore protezione. Per indicazioni dettagliate, consulta le considerazioni sulla sicurezza.
La scelta dell'ambiente di distribuzione ottimale per il tuo modello Ultralytics YOLO26 dipende dalle esigenze specifiche della tua applicazione. La distribuzione cloud offre scalabilità e facilità di accesso, caratteristiche che la rendono ideale per applicazioni con volumi elevati di dati. La distribuzione edge è più indicata per le applicazioni a bassa latenza che richiedono risposte in tempo reale e usa strumenti come LiteRT. La distribuzione locale è adatta agli scenari che richiedono rigide misure di privacy e controllo dei dati. Per una panoramica completa dei vari ambienti, consulta la sezione sulla scelta di un ambiente di distribuzione.