ImageNetデータセット#
Ultralytics ImageNetデータセット(data="imagenet")は、画像分類モデルのトレーニングとベンチマークに使用されるImageNet-1k / ILSVRC-2012サブセットです。1,000の物体クラスが含まれ、トレーニング画像1,281,167枚と検証画像50,000枚で構成されます。通常は画像サイズ224x224でトレーニングされ、ダウンロードデータ量は約144 GBです。より広範なImageNetデータベースには、20,000を超えるカテゴリにわたり、WordNet synsetでアノテーションされた高解像度画像が1,400万枚以上含まれます。一方、Ultralyticsがトレーニングに使用するのは、コンピュータービジョンにおけるディープラーニングの事実上の標準ベンチマークとなった、標準化済みの1,000クラスILSVRCサブセットです。
ImageNet事前トレーニング済みモデル#
| モデル | サイズ (ピクセル) | 精度 top1 | 精度 top5 | 速度 CPU ONNX (ms) | 速度 T4 TensorRT10 (ms) | パラメーター (M) | FLOPs (B)、入力サイズ224 |
|---|---|---|---|---|---|---|---|
| YOLO26n-cls | 224 | 71.4 | 90.1 | 5.0 ± 0.3 | 1.1 ± 0.0 | 2.8 | 0.4 |
| YOLO26s-cls | 224 | 76.0 | 92.9 | 7.9 ± 0.2 | 1.3 ± 0.0 | 6.7 | 1.5 |
| YOLO26m-cls | 224 | 78.1 | 94.2 | 17.2 ± 0.4 | 2.0 ± 0.0 | 11.6 | 4.8 |
| YOLO26l-cls | 224 | 79.0 | 94.6 | 23.2 ± 0.3 | 2.8 ± 0.0 | 14.1 | 6.0 |
| YOLO26x-cls | 224 | 79.9 | 95.0 | 41.4 ± 0.9 | 3.8 ± 0.0 | 29.6 | 13.5 |
主な機能#
- Ultralyticsの
imagenetデータセットは1,000クラスを含み、トレーニング画像1,281,167枚と検証画像50,000枚(ILSVRC-2012)で構成される、画像分類の標準的な事前トレーニング用ベンチマークです。 - クラスはWordNet階層に従って整理されており、各クラスはsynset(同義語の集合)に対応しています。
- 画像は224x224でトレーニングされ、データセット全体のダウンロードサイズは約~144 GBです。
- 年次開催のImageNet大規模視覚認識チャレンジ(ILSVRC)は、コンピュータービジョン研究の発展に大きく貢献してきました。
データセットの構成#
Ultralytics ImageNetデータセットでは、ILSVRC-2012の分割を使用します。
| 分割 | 画像 | クラス |
|---|---|---|
| 学習 | 1,281,167 | 1,000 |
| 検証 | 50,000 | 1,000 |
画像はWordNet synset IDで命名されたクラス別フォルダに保存されます(例: n01440764)。この構成は、Ultralyticsの分類トレーニングで想定されている形式です。1,000クラスのそれぞれがWordNet synsetに対応し、独立したテスト分割はないため、精度の測定には検証画像50,000枚を使用します。
ImageNet-1kのダウンロードサイズは約~144 GBです。トレーニングを始める前に、十分なディスク容量があることを確認してください。手早く実験する場合は、より小規模なImageNetteとImageNet10サブセットを使用できます。どちらも同じフォルダ形式で、はるかに短時間でトレーニングできます。
ImageNet大規模視覚認識チャレンジ(ILSVRC)#
毎年開催されるImageNet大規模視覚認識チャレンジ(ILSVRC)では、一貫した評価指標を備えた大規模かつ標準化されたデータセットを用いて、研究者がアルゴリズムのベンチマークを実施できました。このチャレンジは、画像分類、物体検出などのビジョンタスクにおけるディープラーニングの大きな進歩を促しました。特に、2012年のAlexNetの優勝は、現代のディープラーニング時代の幕開けに貢献しました。
用途#
ImageNetデータセットは、画像分類、物体検出、物体位置特定のディープラーニングモデルのトレーニングと評価に広く使われています。AlexNet、VGG、ResNetなどの画期的なアーキテクチャは、いずれもImageNetで開発およびベンチマークされました。ImageNetで事前トレーニングされた重みは、さまざまなビジョンタスクの転移学習で、今も一般的な出発点となっています。
使用方法#
ImageNetでYOLO分類モデルをトレーニングするには、画像サイズを224x224に設定し、100エポック実行します。以下のコードスニペットを使用してください。使用可能な引数の包括的な一覧については、モデルのトレーニングページをご覧ください。
from ultralytics import YOLO

# モデルを読み込む
model = YOLO("yolo26n-cls.pt")  # 事前トレーニング済みモデルを読み込みます(トレーニングにはこちらを推奨します)

# モデルをトレーニングする
results = model.train(data="imagenet", epochs=100, imgsz=224)
Ultralytics Platformを使って、分類データセットを管理し、クラウドでトレーニングを実行することもできます。
サンプル画像とアノテーション#
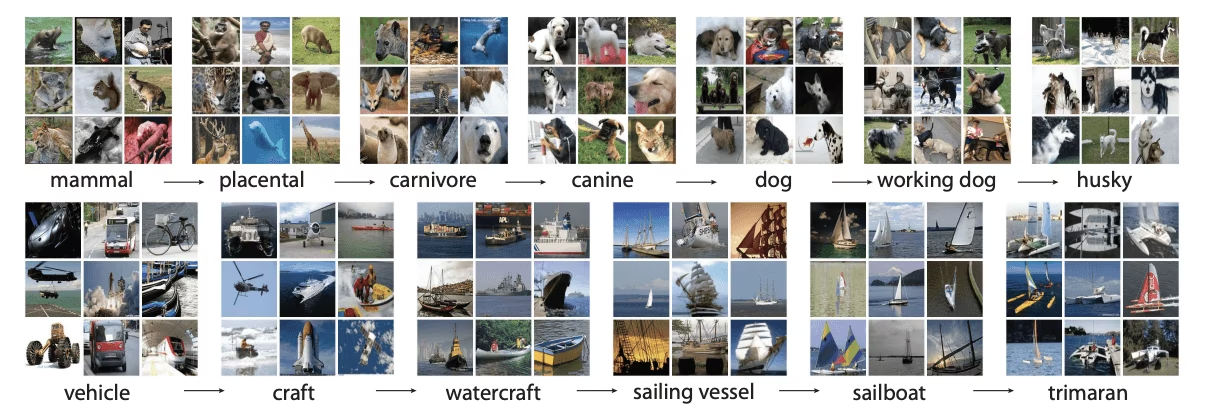
ImageNetデータセットは、ILSVRC-2012の1,000クラスを網羅し、コンピュータービジョンモデルのトレーニングと評価に利用できる、多様で大規模なリソースです。データセットのサンプル画像を以下に示します。
引用と謝辞#
研究または開発でImageNetデータセットを使用する場合は、以下の論文を引用してください。
@article{ILSVRC15,
         author = {Olga Russakovsky and Jia Deng and Hao Su and Jonathan Krause and Sanjeev Satheesh and Sean Ma and Zhiheng Huang and Andrej Karpathy and Aditya Khosla and Michael Bernstein and Alexander C. Berg and Li Fei-Fei},
         title={ImageNet Large Scale Visual Recognition Challenge},
         year={2015},
         journal={International Journal of Computer Vision (IJCV)},
         volume={115},
         number={3},
         pages={211-252}
}ImageNetデータセットを作成・管理し、機械学習およびコンピュータービジョンの研究コミュニティに貴重なリソースを提供している、Olga Russakovsky、Jia Deng、Li Fei-Feiが率いるImageNetチームに感謝いたします。ImageNetデータセットとその作成者の詳細については、ImageNetのウェブサイトをご覧ください。
よくある質問#
ImageNetデータセットは、WordNet synsetでアノテーションされた高解像度画像を1,400万枚以上収録する大規模画像データベースです。Ultralyticsの
data="imagenet"は、画像分類の事前トレーニングにおける事実上の標準ベンチマークである、標準化済みの1,000クラスILSVRC-2012サブセットでトレーニングされます。AlexNet、VGG、ResNetなどの画期的なモデルはImageNetでトレーニングおよびベンチマークされており、コンピュータービジョンの発展におけるImageNetの役割を示しています。Ultralyticsの
imagenetデータセットは、1,000クラス、トレーニング画像1,281,167枚、検証画像50,000枚を含むILSVRC-2012サブセットを使用します。通常、画像サイズ224x224でトレーニングされ、ダウンロードサイズは約144 GBです。ImageNetデータベース全体はさらに大規模で、20,000を超えるWordNet synsetにわたり1,400万枚以上の画像が含まれますが、分類のトレーニングとベンチマークには1,000クラスのサブセットが使用されます。ImageNetでUltralytics YOLOモデルをトレーニングするには、事前トレーニング済みの分類モデルを読み込み、
dataをimagenetに指定します。トレーニング例from ultralytics import YOLO # モデルを読み込む model = YOLO("yolo26n-cls.pt") # 事前トレーニング済みモデルを読み込みます(トレーニングにはこちらを推奨します) # モデルをトレーニングする results = model.train(data="imagenet", epochs=100, imgsz=224)トレーニングの詳細については、トレーニングページをご覧ください。
Ultralytics YOLO26の事前トレーニング済みモデルは、さまざまなコンピュータービジョンタスクで、速度と精度において最先端の性能を発揮します。たとえば、YOLO26n-clsモデルはtop-1精度71.4%、top-5精度90.1%を達成し、リアルタイムアプリケーション向けに最適化されています。事前トレーニング済みモデルを使うと、ゼロからトレーニングする場合に必要な計算リソースを削減し、開発サイクルを短縮できます。ImageNet事前トレーニング済みモデルのセクションで、YOLO26モデルの性能指標について詳しくご確認ください。
毎年開催されるImageNet大規模視覚認識チャレンジ(ILSVRC)は、大規模で標準化されたデータセット上でアルゴリズムを評価する競争の場を提供し、コンピュータービジョンの発展を促しました。一貫した評価指標により、画像分類、物体検出、画像セグメンテーションのイノベーションが促進され、ディープラーニングとコンピュータービジョンの可能性を継続的に広げました。