MNISTデータセット#
MNIST(米国国立標準技術研究所の修正版)データセットは、10クラス(数字の0〜9)にわたる、手書き数字の28x28グレースケール画像70,000枚を含む画像分類ベンチマークです。あらかじめ60,000枚のトレーニング画像と10,000枚のテスト画像に分割されており、機械学習やコンピュータービジョンアルゴリズムを評価する標準的なベンチマークとして長年利用されています。より難易度の高い衣類画像版については、関連するFashion-MNISTデータセットを、カラー画像についてはCIFAR-10を参照してください。
Ultralytics Platform上のMNISTを確認すると、サンプルのプレビュー、データセット統計の確認、トレーニング用のクローン作成ができます。
主な機能#
- MNISTには手書き数字のトレーニング画像が60,000枚、テスト画像が10,000枚あり、合計70,000枚です。
- 各画像は1桁の数字を表す28x28のグレースケール画像です。サイズが正規化され、アンチエイリアス処理によって20x20の枠内に収まるように調整され、28x28のフレームの中央に配置されています。
- 10クラスは数字の0〜9で構成され、各クラスの画像数はおおむね均等です。
- トレーニング用とテスト用にあらかじめ分割されているため、手動または自動で分割する必要はありません。
- MNISTは、画像分類とディープラーニングの研究で標準的なベンチマークとして使用されています。
データセットの構成#
MNISTには公式の分割があらかじめ用意されているため、自動または手動で分割する必要はありません。
- クラス: 10(手書き数字の0〜9)
- 画像総数: 70,000枚(28x28グレースケール)
- トレーニングセット: 画像60,000枚
- テストセット: 画像10,000枚
MNISTには独立した検証用フォルダーがないため、Ultralyticsはデフォルトでトレーニング時に10,000枚のテストセットを検証用データとして使用します。
各画像には対応する数字(0〜9)のラベルが付いているため、MNISTは分類タスクに最適な教師ありデータセットです。
用途#
MNISTは、従来の畳み込みニューラルネットワーク(CNNs)やサポートベクターマシン(SVMs)から最新のディープアーキテクチャまで、画像分類モデルのトレーニングと評価に広く使用されています。小さなグレースケール画像と10個の数字クラスで構成されるため、アルゴリズム比較やコンピュータービジョンの実験を、迅速かつ再現性の高い形で行えるベンチマークです。
一般的な用途には、次のようなものがあります。
- 新しい分類アルゴリズムのベンチマーク
- 機械学習の概念を教えるための教育用途
- 画像認識システムのプロトタイピング
- モデル最適化手法のテスト
使用方法#
画像サイズを28に設定し、YOLO分類モデルをMNISTで100エポックトレーニングします。初回使用時にデータセットは自動的にダウンロードされ、キャッシュされます。前処理を完全に制御したい場合は、元のgzipアーカイブをMNISTデータベースから入手することもできます。利用可能な引数の全一覧については、トレーニングページと画像分類タスクガイドを参照してください。
from ultralytics import YOLO

# モデルを読み込む
model = YOLO("yolo26n-cls.pt")  # 事前トレーニング済みモデルを読み込みます(トレーニングにはこちらを推奨します)

# モデルをトレーニングする
results = model.train(data="mnist", epochs=100, imgsz=28)Ultralyticsではdata="mnist160"も利用できます。これは、トレーニング用とテスト用の各分割から、数字(0〜9)ごとに最初の8枚を取得した160枚のサブセットです。MNISTと同じディレクトリ構造を採用しているため、ほかの引数を変更せずにデータセットを切り替えられます。CIパイプラインや、70,000枚の完全なデータセットを使う前の動作確認に最適です。
yolo classify train data=mnist160 model=yolo26n-cls.pt epochs=5 imgsz=28サンプル画像とアノテーション#
MNISTデータセットのサンプル画像:
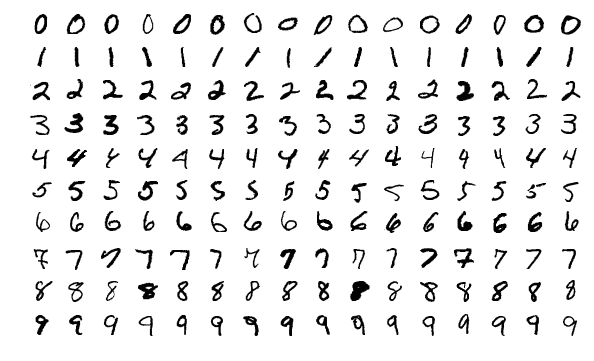
サンプルからは、10個の数字クラスにわたってデータセットが捉えている手書きスタイルの幅広さがわかります。
引用と謝辞#
研究または開発でMNISTデータセットを使用する場合は、次の論文を引用してください。
@article{lecun2010mnist,
         title={MNIST handwritten digit database},
         author={LeCun, Yann and Cortes, Corinna and Burges, CJ},
         journal={ATT Labs [Online]},
         volume={2},
         year={2010}
}MNISTデータセットを作成・管理し、機械学習およびコンピュータービジョンの研究コミュニティに貴重なリソースを提供しているYann LeCun、Corinna Cortes、Christopher J.C. Burgesに謝意を表します。MNISTデータセットとその作成者の詳細については、MNISTデータセットのウェブサイトをご覧ください。
よくある質問#
MNISTには、手書き数字の0〜9に対応する10クラスがあり、28x28ピクセルのグレースケール画像が合計70,000枚含まれています。トレーニング画像60,000枚とテスト画像10,000枚にあらかじめ分割されており、各数字のサンプル数はおおむね均等です。
MNISTでUltralytics YOLOモデルをトレーニングするには、以下のコードスニペットを使用します。初回使用時にデータセットが自動的にダウンロードされます。利用可能なトレーニング引数の詳細な一覧については、トレーニングページを参照してください。
トレーニング例from ultralytics import YOLO # モデルを読み込む model = YOLO("yolo26n-cls.pt") # 事前トレーニング済みモデルを読み込みます(トレーニングにはこちらを推奨します) # モデルをトレーニングする results = model.train(data="mnist", epochs=100, imgsz=28)MNISTは、トレーニング画像60,000枚とテスト画像10,000枚にあらかじめ分割されています。Ultralyticsが自動で分割するフォルダーベースの分類データセットとは異なり、MNISTでは公式の分割をそのまま使用し、デフォルトでトレーニング時にテストセットを検証用データとして使用します。
MNISTデータセットには手書き数字のみが含まれていますが、拡張MNIST(EMNIST)データセットには数字に加えて大文字と小文字のアルファベットも含まれています。EMNISTはMNISTの後継として開発され、同じ28x28ピクセル形式を使用しているため、元のMNISTデータセット向けに設計されたツールやモデルと互換性があります。より幅広い文字を扱えるため、EMNISTはさらに多様な機械学習アプリケーションに役立ちます。
はい。Ultralytics Platformでは、データセットをアップロードし、画像分類モデルをトレーニングして、複雑なコーディングを行わずにデプロイできます。クラウドでMNISTの実験を行う便利な方法です。関連する選択肢については、分類データセットの概要をご覧ください。
MNISTはCIFAR-10やImageNetなどの多くの最新データセットよりもシンプルで、初心者や迅速な実験に最適です。より複雑なデータセットでは、カラー画像や多様なオブジェクトカテゴリによって難易度が高まりますが、MNISTはシンプルさ、ファイルサイズの小ささ、機械学習アルゴリズムの発展における歴史的重要性から、今も価値があります。同じ構造でより難易度の高い置き換え先をお探しの場合は、数字ではなく衣類を扱うFashion-MNISTを参照してください。