Global Wheat Headデータセット#
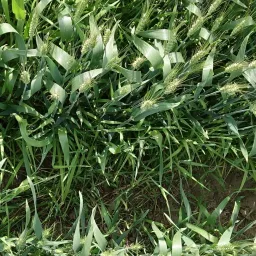
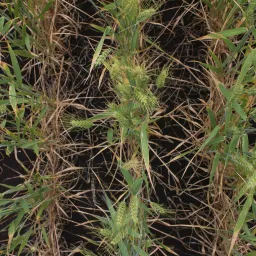
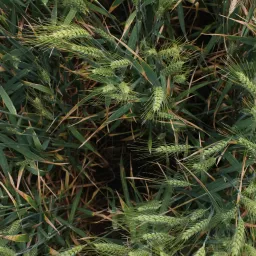
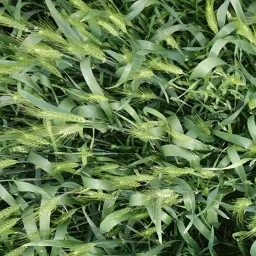
Global Wheat Head Dataset(GWHD)は、屋外の圃場画像からコムギの穂(コムギの植物のうち、穀粒を実らせる穂状の部分)を検出するための、単一クラスの物体検出データセットです。複数の栽培地域で撮影されたトレーニング画像3,422枚、検証画像748枚、テスト画像1,276枚を収録しています。また、異なる環境でモデルが汎化できるよう、7か国の9つの研究機関が協力して作成しました。正確なコムギの穂検出は、植物フェノタイピングや作物管理における穂密度、サイズ、収量ポテンシャルの推定を支えます。
主な機能#
- 実際の屋外圃場画像を使用しており、コムギの穂の外観、照明、生育段階に見られる自然なばらつきを捉えています。
- 7か国の9つの研究機関によって構築されており、ヨーロッパ、北米、アジア、オーストラリアの栽培地域を網羅し、環境をまたいだ高い汎化性能を実現します。
- 単一クラス
wheat_headのバウンディングボックスアノテーションを備え、物体検出およびトラッキングパイプラインですぐに使用できます。 - テスト画像はトレーニング時に未使用の遺伝子型および地域から取得しており、実質的な汎化性能のベンチマークを提供します。
データセットの構成#
Global Wheat Headデータセットは、GlobalWheat2020.yaml設定で定義された3つのサブセットに整理されており、すべて単一クラスwheat_headでアノテーションされています。
| 分割 | 画像 | 地域 |
|---|---|---|
| 学習 | 3,422 | ヨーロッパ(フランス、英国、スイス)、北米(カナダ) |
| 検証 | 748 | スイス(ETH Zürich) |
| テスト | 1,276 | オーストラリア、日本、中国 |
検証セット(748枚)はethz_1サブセットで、トレーニングセットにも含まれています。そのため、検証指標はモデルがトレーニングにも使用した画像で測定されます。オーストラリア、日本、中国のホールドアウトテストセットを使用して、トレーニング中に見ていない環境への汎化性能を測定します。
用途#
Global Wheat Head Datasetは、小麦の穂の検出モデルをトレーニングおよび評価するために広く使用されています。深層学習 地域、遺伝子型、条件にわたる多様な画像を含むため、植物フェノタイピングや作物管理に役立つ貴重なリソースとなり、収量推定、作物の健康状態のモニタリング、表現型解析を支援します。
フィールド画像のアノテーション、トレーニング、データセットのバージョン管理をブラウザーで行うには、Ultralytics Platformを使用してワークフロー全体を実行します。
データセットYAML#
データセットの設定を定義するには、YAMLファイルを使用します。このファイルでは、データセットのパス、クラス、その他の設定詳細を定義します。Global Wheat Head Datasetでは、GlobalWheat2020.yamlファイルがhttps://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/GlobalWheat2020.yamlで管理されています。
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Global Wheat 2020 dataset https://www.global-wheat.com/ by University of Saskatchewan
# Documentation: https://docs.ultralytics.com/datasets/detect/globalwheat2020
# Example usage: yolo train data=GlobalWheat2020.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── GlobalWheat2020 ← downloads here (7.0 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: GlobalWheat2020 # dataset root dir
train: # train images (relative to 'path') 3422 images
  - images/arvalis_1
  - images/arvalis_2
  - images/arvalis_3
  - images/ethz_1
  - images/rres_1
  - images/inrae_1
  - images/usask_1
val: # val images (relative to 'path') 748 images (WARNING: train set contains ethz_1)
  - images/ethz_1
test: # test images (optional) 1276 images
  - images/utokyo_1
  - images/utokyo_2
  - images/nau_1
  - images/uq_1

# Classes
names:
  0: wheat_head

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  from pathlib import Path

  from ultralytics.utils.downloads import download

  # Download
  dir = Path(yaml["path"])  # dataset root dir
  urls = [
      "https://zenodo.org/record/4298502/files/global-wheat-codalab-official.zip",
      "https://github.com/ultralytics/assets/releases/download/v0.0.0/GlobalWheat2020_labels.zip",
  ]
  download(urls, dir=dir)

  # Make Directories
  for p in "annotations", "images", "labels":
      (dir / p).mkdir(parents=True, exist_ok=True)

  # Move
  for p in (
      "arvalis_1",
      "arvalis_2",
      "arvalis_3",
      "ethz_1",
      "rres_1",
      "inrae_1",
      "usask_1",
      "utokyo_1",
      "utokyo_2",
      "nau_1",
      "uq_1",
  ):
      (dir / "global-wheat-codalab-official" / p).rename(dir / "images" / p)  # move to /images
      f = (dir / "global-wheat-codalab-official" / p).with_suffix(".json")  # json file
      if f.exists():
f.rename((dir / "annotations" / p).with_suffix(".json")) # move to /annotations使用方法#
Global Wheat Head DatasetでYOLO26nモデルを画像サイズ640、100エポックでトレーニングするには、以下のコードスニペットを使用できます。データセット(~7.0 GB)は初回使用時に自動でダウンロードされます。利用可能な引数の一覧については、モデルのトレーニングページをご覧ください。
from ultralytics import YOLO

# モデルを読み込む
model = YOLO("yolo26n.pt")  # 事前トレーニング済みモデルを読み込みます(トレーニングにはこちらを推奨します)

# モデルをトレーニングする
results = model.train(data="GlobalWheat2020.yaml", epochs=100, imgsz=640)サンプル画像とアノテーション#
Global Wheat Head Datasetには、屋外の圃場で撮影された多様な画像が含まれており、小麦の穂の外観、環境、条件の自然なばらつきを捉えています。以下に、データセットの画像例と対応するアノテーションを示します。
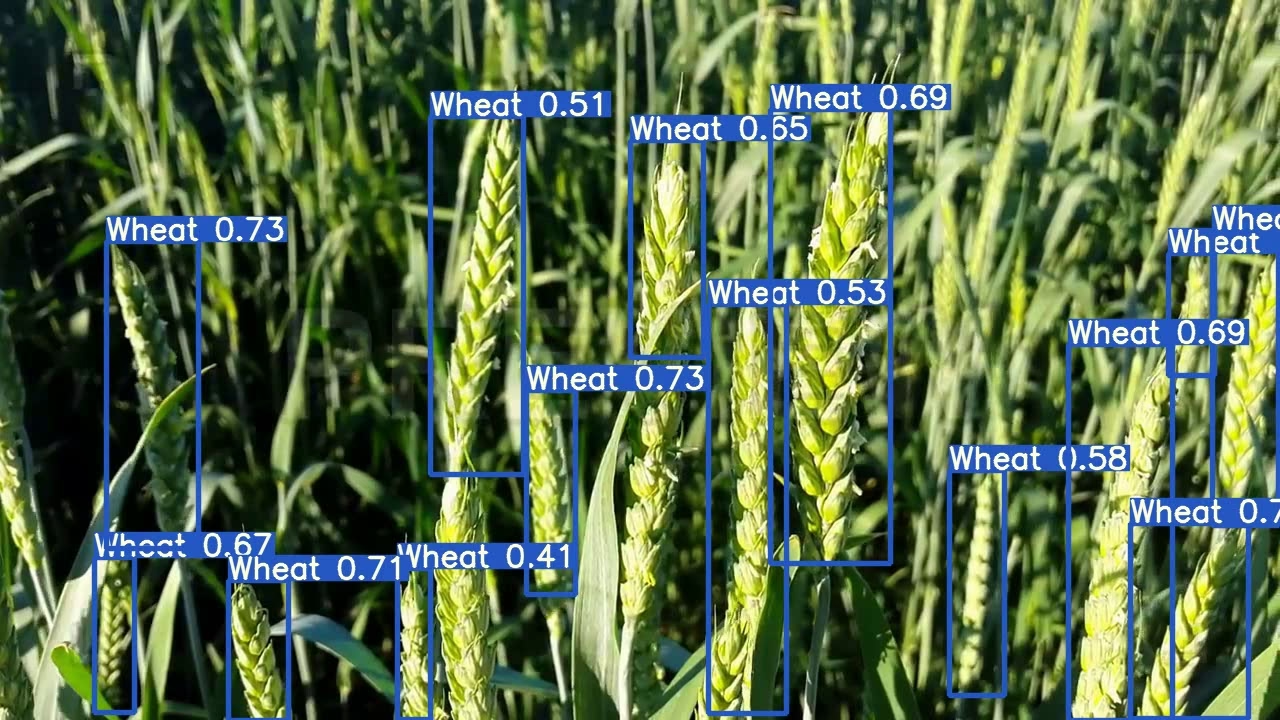
- 小麦の穂の検出:多様で複雑なデータセットを反映するさまざまな圃場条件の画像で、物体検出用に小麦の穂をバウンディングボックスでアノテーションしています。
引用と謝辞#
研究または開発でGlobal Wheat Head Datasetを使用する場合は、以下の論文を引用してください。
@article{david2020global,
         title={Global Wheat Head Detection (GWHD) Dataset: A Large and Diverse Dataset of High-Resolution RGB-Labelled Images to Develop and Benchmark Wheat Head Detection Methods},
         author={David, Etienne and Madec, Simon and Sadeghi-Tehran, Pouria and Aasen, Helge and Zheng, Bangyou and Liu, Shouyang and Kirchgessner, Norbert and Ishikawa, Goro and Nagasawa, Koichi and Badhon, Minhajul and others},
         journal={arXiv preprint arXiv:2005.02162},
         year={2020}
}
植物フェノタイピングおよび作物管理の研究コミュニティにとって貴重なリソースであるGlobal Wheat Head Datasetの作成と維持に貢献した研究者および機関に感謝します。データセットと作成者の詳細については、Global Wheat Head Datasetのウェブサイトをご覧ください。
よくある質問#
Global Wheat Head Datasetは主に、小麦の穂の検出を目的とする深層学習モデルの開発とトレーニングに使用されます。これは、小麦のフェノタイピングや作物管理の用途において重要であり、小麦の穂の密度やサイズ、作物全体の収量ポテンシャルをより正確に推定できます。正確な検出手法は、効率的な作物管理に欠かせない作物の健康状態や成熟度の評価に役立ちます。
Global Wheat Head Datasetには1つのクラス
wheat_headがあり、3つのサブセットに分割されています。トレーニング画像は3,422枚、検証画像は748枚、テスト画像は1,276枚です。トレーニング画像と検証画像はヨーロッパおよび北米のもので、テストセットはオーストラリア、日本、中国の画像で構成され、未知の環境への汎化性能を評価します。Global Wheat Head DatasetでYOLO26nモデルをトレーニングするには、以下のコードスニペットを使用できます。データセットのパスとクラスを指定する
GlobalWheat2020.yaml設定ファイルがあることを確認してください。トレーニング例from ultralytics import YOLO # 事前トレーニング済みモデルを読み込みます(トレーニングに推奨) model = YOLO("yolo26n.pt") # モデルをトレーニングする results = model.train(data="GlobalWheat2020.yaml", epochs=100, imgsz=640)利用可能な引数の一覧については、モデルのトレーニングページをご覧ください。
データセット(~7.0 GB)は、
data="GlobalWheat2020.yaml"で初めてトレーニングするときに自動でダウンロードされるため、手動での操作は不要です。Ultralyticsが画像とラベルを取得し、ローカルのデータセットディレクトリに展開します。関連データセットは検出データセットの概要でご覧いただけます。GlobalWheat2020.yamlという名前のGlobal Wheat Head Datasetの設定YAMLファイルは、GitHubで公開されています。https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/GlobalWheat2020.yamlからアクセスできます。このファイルには、Ultralytics YOLOでモデルをトレーニングするために必要なデータセットのパス、クラス、その他の設定詳細が含まれています。