アノテーション済みコンピュータービジョンデータの前処理手法#
データの前処理では、アノテーション済みの未加工画像を、コンピュータービジョンモデルが適切にトレーニングするために必要な、クリーンで一貫性のある入力データに変換します。Ultralytics YOLO26では、RGB変換、[0, 1]へのスケーリング、リサイズといった基本的なピクセル操作がトレーニングパイプライン内で自動的に行われるため、残る作業はデータセットの適切な分割、クラスのバランス調整、拡張方法の選択です。このガイドでは、リサイズ、正規化、データセット分割、データ拡張、探索的データ分析(EDA)という基本手法を解説します。
視聴: データの前処理と拡張を使って実環境でのモデル精度を向上させる方法 🚀
このステップは、プロジェクトの目標を定義し、データを収集してアノテーションした後、コンピュータービジョンプロジェクトのワークフローの早い段階で行います。
前処理が重要な理由#
前処理により、計算負荷を軽減し、モデルの性能を向上させる形式にデータを整えます。未加工データによくある次の3つの問題に対処します。
- ノイズ: データ内の無関係な変動やランダムな変動です。
- 不整合: 画像のサイズ、形式、品質のばらつきです。
- 不均衡: データセット内でクラスやカテゴリの分布が均等でない状態です。
前処理の手法#
主な手法は、リサイズ、正規化、データセット分割、データ拡張です。YOLO26では最初の2つが自動で行われ、分割とデータ拡張では選択が特に重要になります。
画像のリサイズ#
多くのモデルでは一貫した入力サイズが必要なため、リサイズによって画像のサイズを統一し、計算量を減らします。一般的な補間方法は次の2つです。
- バイリニア補間: 近傍にある4つのピクセルの加重平均を取って、ピクセル値を滑らかにします。
- 最近傍補間: 平均化せずに最も近いピクセル値をコピーします。高速ですが、画像が粗くなります。
OpenCVやPIL(Pillow)などのライブラリには、これらの関数が用意されていますが、YOLO26では通常、手動でリサイズする必要はありません。imgsz引数が処理を行います。固定サイズの正方形入力経路では、検証と推論において、アスペクト比を維持しながら画像をレターボックス化し、imgsz × imgsz入力(たとえば640 × 640)に合わせます。余白はグレー(値114)で埋めます。大きな画像は収まるように縮小されますが、拡大が無効の場合、小さな画像は拡大されません。デフォルトのトレーニング経路では、代わりにmosaic=1.0によって4枚の画像を大きなキャンバスにタイル状に配置し、imgszに合わせて切り抜きます。最終エポックでclose_mosaicによってモザイクが無効になると、画像はレターボックス化された後も、何も変更せずに入力されるのではなく、ランダム変換されます。矩形バッチ(rect=True)とmulti_scaleでは、異なる入力形状が使用されます。
ピクセル値の正規化#
正規化では、ピクセル値を標準的な範囲にスケーリングします。これにより、トレーニング時のモデルの収束が速くなります。一般的な手法は次の2つです。
- Min-Maxスケーリング: ピクセル値を0から1の範囲にスケーリングします。
- Zスコア正規化: 平均と標準偏差に基づいてピクセル値をスケーリングします。
YOLO26では、前処理パイプラインの一環として正規化が自動的に行われます。画像をRGBに変換し、255で割る(Min-Maxスケーリング)ことで、ピクセル値を[0, 1]の範囲にスケーリングします。YOLOはデフォルトではImageNet形式の平均・標準偏差(Zスコア)正規化を適用しないため、手動で正規化する必要はありません。
データセットの分割#
データをトレーニング、検証、テストの各セットに分割すると、未見のデータでモデルを評価し、汎化性能を測定できます。一般的な分割比率は、トレーニング70%、検証20%、テスト10%です。scikit-learnやTensorFlowなどのツールを使うと、簡単に分割できます。
分割する際は、次の点に注意してください。
- クラス分布の維持: トレーニング、検証、テストの各セットに、各クラスが比例して含まれるようにします。
- クラスのバランス調整: 不均衡なデータセットでは、トレーニングセット内に限り、少数クラスのオーバーサンプリングや多数クラスのアンダーサンプリングを検討します。
データセットは、拡張やその他の前処理を適用する前に分割し、変換はトレーニングセットのみに適用します。分割前にデータ拡張を行うと、検証画像やテスト画像の情報がトレーニングに影響し、実環境のデータでは再現できない、誤解を招くほど高いスコアにつながります。
データセットの拡張#
データ拡張では、既存の画像を加工したバージョンを作成し、データセットの規模を人工的に拡大します。過学習の抑制と汎化性能の向上に役立ち、次のような利点があります。
- より堅牢なモデル: 照明、向き、スケールに変化を加えることで、実環境における歪みに対するモデルの耐性が高まります。
- 費用対効果: 新しいデータを収集してラベリングせずに、トレーニングセットを拡張できます。
- データの有効活用: アノテーション済みの各画像から、複数のトレーニング用バリエーションを生成できます。
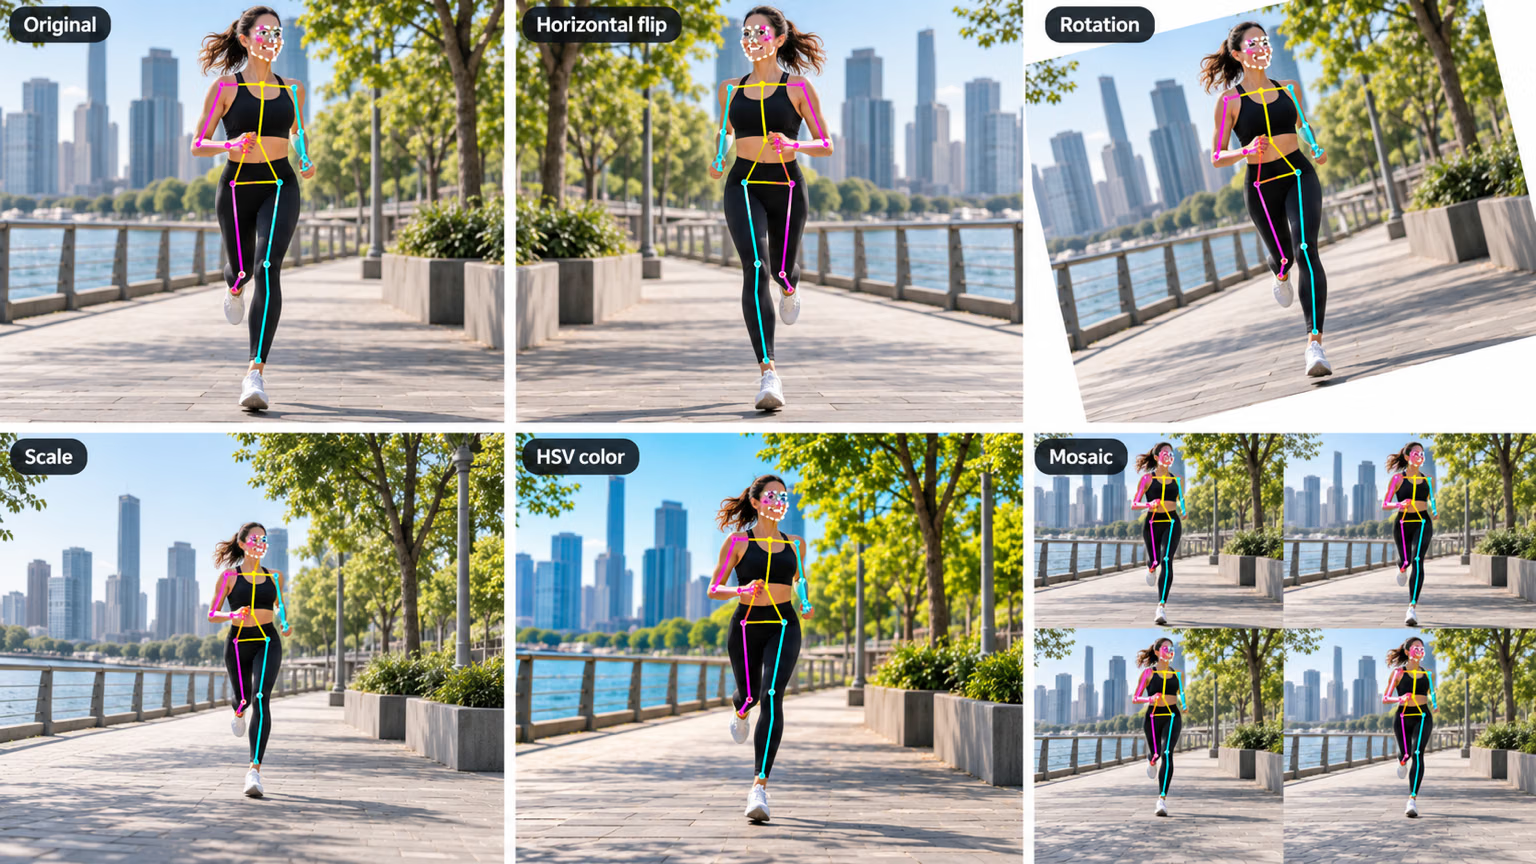
YOLO26では、データ拡張の強度はmodel.train()または同等のCLIフラグに渡すトレーニング引数で制御します。データセットYAMLはパス、クラス名、分割などのデータセットメタデータを定義するものであり、編集して設定するものではありません。例外はflip_idxです。ポーズデータセットでは、左右のキーポイントペアを対応付けるために、データセットYAMLでこれを宣言します。設定がない場合、YOLOはfliplrとflipudを完全に無効にします。組み込みのデータ拡張には次のものがあります。
- Mosaic、MixUp、CutMix(
mosaic、mixup、cutmix): 複数の画像を1つのトレーニングサンプルに組み合わせます。 - 反転(
fliplr、flipud): 画像を水平方向または垂直方向に反転します。 - 幾何変換(
degrees、translate、scale、shear、perspective): 画像を回転、移動、ズーム、変形します。 - HSVカラーのジッター(
hsv_h、hsv_s、hsv_v): 色相、彩度、明度を変化させます。 - コピー&ペースト(
copy_paste): セグメント化されたオブジェクトの複製を追加で貼り付けます。デフォルトでは同じ画像内で反転して貼り付け、copy_paste_mode=mixupを使うと別の画像から貼り付けます。 - チャンネルの入れ替え(
bgr): RGBのチャンネル順をBGRに入れ替えます。 - 分類用変換(
auto_augment、erasing): 分類器のトレーニング時に、自動データ拡張ポリシーとランダム消去を適用します。
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# データ拡張はトレーニング引数で設定し、データセットYAMLでは設定しません
model.train(data="coco8.yaml", epochs=10, hsv_h=0.015, fliplr=0.5, mosaic=1.0, degrees=10.0)データ拡張の引数とデフォルト値の全一覧については、データ拡張設定のリファレンスと、専用のYOLOデータ拡張ガイドをご覧ください。albumentationsパッケージがインストールされている場合、YOLOはAlbumentationsベースの組み込みデータ拡張も自動的に有効にします。
ケーススタディ: 車両検出の前処理#
バウンディングボックスとラベルでアノテーションされた画像を使い、YOLO26で交通画像内の車両を検出・分類するプロジェクトを考えてみましょう。各前処理の判断は次のようになります。
- リサイズ: 手動作業は不要です。YOLO26はトレーニング中に
imgszへリサイズします。 - 正規化: 手動作業は不要です。YOLO26はピクセル値を自動的に
[0, 1]へスケーリングします。 - 分割: クラス分布を分割間で一貫させながら、データセットをトレーニング用70%、検証用20%、テスト用10%に分割します。
- データ拡張: 交通シーンに適したトレーニング引数を設定します。たとえば、方向の不変性には
fliplr、昼夜の照明にはhsv_v、物体密度の変化にはmosaicを設定します。
これらの判断を済ませると、データセットは探索的データ分析(EDA)に進む準備が整います。
探索的データ分析(EDA)#
EDAでは、統計と可視化を使ってデータのパターンや分布を明らかにします。トレーニング前に、クラス不均衡や外れ値などの問題を見つけるのに役立ちます。
統計的EDAの手法#
統計的EDAでは、平均値、中央値、標準偏差、範囲といった基本指標から始めます。これらは、ピクセル強度の分布などの特性について計算します。データセットの品質をすばやく把握し、早い段階で不規則性を明らかにできます。
視覚的EDAの手法#
可視化すると、クラス不均衡や外れ値など、要約統計だけでは見つけにくいパターンが明らかになります。一般的なツールは次のとおりです。
- ヒストグラムと箱ひげ図: ピクセル値の分布を示し、強度や特徴量の分布における外れ値を検出します。
- 棒グラフ: 各クラスのサンプル数を比較し、クラス不均衡を明らかにします。
- 散布図: 画像の特徴量やアノテーション間の関係を調べます。
- ヒートマップ: ピクセル強度の分布や、画像全体におけるアノテーションの空間分布を可視化します。
EDA向けUltralytics Platform#
コードを書かずにEDAを行うには、データセットをUltralytics Platformにアップロードします。データセットのChartsタブでは、分割の分布、上位クラスの件数、画像の幅と高さのヒストグラム、アノテーション位置と画像サイズの2Dヒートマップなど、主要なEDA可視化が自動生成されます。Imagesタブでは、アノテーションを重ねて表示しながら、グリッド、コンパクト、テーブルの各表示形式でデータを閲覧できます。コードを書かずに、誤ラベルの例やクラスの不均衡を簡単に見つけられます。
結論#
適切に分割、正規化、拡張されたデータは、ノイズを減らして汎化性能を向上させ、画像の未加工データを信頼性の高いトレーニングセットに変えます。データセットの前処理が完了したら、次はモデルをトレーニングします。途中で疑問が生じた場合は、Ultralytics GitHubリポジトリまたはUltralytics Discordサーバーでコミュニティに質問してください。
よくある質問#
前処理によって、データがクリーンで一貫性のある、トレーニングに最適化された形式になります。未加工データのノイズ、不整合、クラス不均衡に対処し、リサイズ、正規化、データ拡張、データセット分割などの手順で計算負荷を軽減し、モデルの性能を向上させます。より広範なワークフローにおける位置付けについては、コンピュータービジョンプロジェクトの手順をご覧ください。
データ拡張は、データセットYAMLではなくトレーニング引数で設定します。
fliplr、mosaic、hsv_h、degreesなどの引数をmodel.train()に渡す(または同等のCLIフラグを使用する)ことで、各変換の確率と強度を設定できます。これらの引数はデータ拡張設定で定義され、YOLOデータ拡張ガイドで解説されています。ポーズデータセットは例外です。キーポイントを対応付けるflip_idxはデータセットYAMLで設定し、設定がない場合は反転が無効になります。最も一般的な手法は、Min-Maxスケーリング(ピクセルを0から1の範囲に再スケーリング)とZスコア正規化(平均と標準偏差に基づいて再スケーリング)です。YOLO26ではMin-Maxスケーリングが自動的に適用され、画像をRGBに変換してピクセル値を255で割るため、手動で正規化する必要はありません。デフォルトではZスコア正規化は適用されません。
一般的な分割比率は、トレーニング用70%、検証用20%、テスト用10%です。3つすべての分割でクラス分布を維持し、分割後にトレーニングセットだけにデータ拡張を適用して、データリークを避けます。scikit-learnやTensorFlowなどのツールを使うと、効率的に分割できます。データセット準備の前段階については、データ収集・アノテーションガイドをご覧ください。
はい。
imgsz引数で、手動作業なしに入力の目標サイズを指定できます。固定サイズの正方形入力経路では、検証と推論において、アスペクト比を維持しながら画像を指定された形状にレターボックス化します。大きな画像は収まるように縮小されますが、拡大が無効の場合、小さな画像は拡大されません。トレーニング中は、デフォルトのモザイクデータ拡張で4枚の画像をタイル状に配置して切り抜くことで、目標サイズに合わせます。矩形バッチ(rect=True)とmulti_scaleでは、異なる入力形状が使用されます。詳しくはモデルのトレーニングのドキュメントをご覧ください。