Amazon S3インテグレーション
Amazon S3インテグレーションを使用すると、S3バケットをUltralytics Platformに接続できます。画像はバケット内に保持され、Platformはその場でインデックスを作成するため、コピーをアップロードせずにYOLOモデルの閲覧、アノテーション、トレーニングを行えます。AI機能をオンにすると、Platformはスマートアノテーション、自動アノテーション、類似画像検索、クラウドトレーニングにも画像を使用できます。
Amazon S3データセットを利用するには、ProまたはEnterpriseプランが必要です。無料ワークスペースではインテグレーションが表示され、接続時にアップグレードを求められます。サブスクリプション終了後も、既存のAmazon S3データセットには引き続き完全にアクセスできます。Proが必要なのは、新しい接続とインポートのみです。
IAMユーザーを作成する#
読み取りアクセスで利用できる機能のうち、画像生成だけはオブジェクトも作成するため例外です。Platformがオブジェクトを変更または削除することはありません。専用のIAMユーザーを使用し、root認証情報は決して使用しないでください。
-
AWSコンソールで IAM > Users に移動し、コンソールアクセス権のないユーザーを作成します。
-
接続するバケットに対して、一覧表示と読み取りアクセス権を付与するポリシーをアタッチします。
{ "Version": "2012-10-17", "Statement": [ { "Effect": "Allow", "Action": "s3:ListAllMyBuckets", "Resource": "*" }, { "Effect": "Allow", "Action": ["s3:ListBucket", "s3:GetObject"], "Resource": ["arn:aws:s3:::my-bucket", "arn:aws:s3:::my-bucket/*"] } ] }s3:ListAllMyBucketsは任意です。設定すると、バケット名を入力しなくてもPlatformがバケットを検出できます。画像生成を利用する場合は、
s3:PutObjectも許可してください。{ "Effect": "Allow", "Action": "s3:PutObject", "Resource": [ "arn:aws:s3:::my-bucket/generated/*", "arn:aws:s3:::my-bucket/*/generated/*", "arn:aws:s3:::my-bucket/.ultralytics-write-check" ] }S3には作成専用の権限がないため、書き込み先を
generated/フォルダーと、Platformが書き込みアクセス権のテストに使用する.ultralytics-write-checkキーに限定します(このテストは常に拒否されるため、何も保存されません)。Platform自身による書き込みで既存のオブジェクトが上書きされることはありません。 -
ユーザーの Security credentials タブを開き、access key を作成して、アクセスキーIDとシークレットアクセスキーをコピーします。
Platformは一時的なAWS認証情報を拒否します。AWS STSが発行するキー(ASIA で始まるもの、ロール セッション認証情報、IAM Identity Centerのキーを含む)は、データセットの接続中に期限切れになるため、長期間有効なアクセスキーを持つ専用のIAM ユーザーが必要です。
Platformに接続する#
- Settings > Integrations に移動し、インテグレーション一覧から Amazon S3 を選択します。
- アクセスキーID、シークレットアクセスキー、バケットのリージョン(例:
us-east-1)を入力します。 - Find available buckets をクリックし、接続するバケットを選択します。ポリシーで検出が許可されていない場合は、 既知のバケット名を手動で入力してください。
- Connectをクリックします。Platformは、何も保存する前に、選択した各バケットの一覧表示と読み取りが可能かを検証します。また、S3が常に拒否するリクエストを使ってキーで書き込みが可能かを確認するため、何も保存されません。
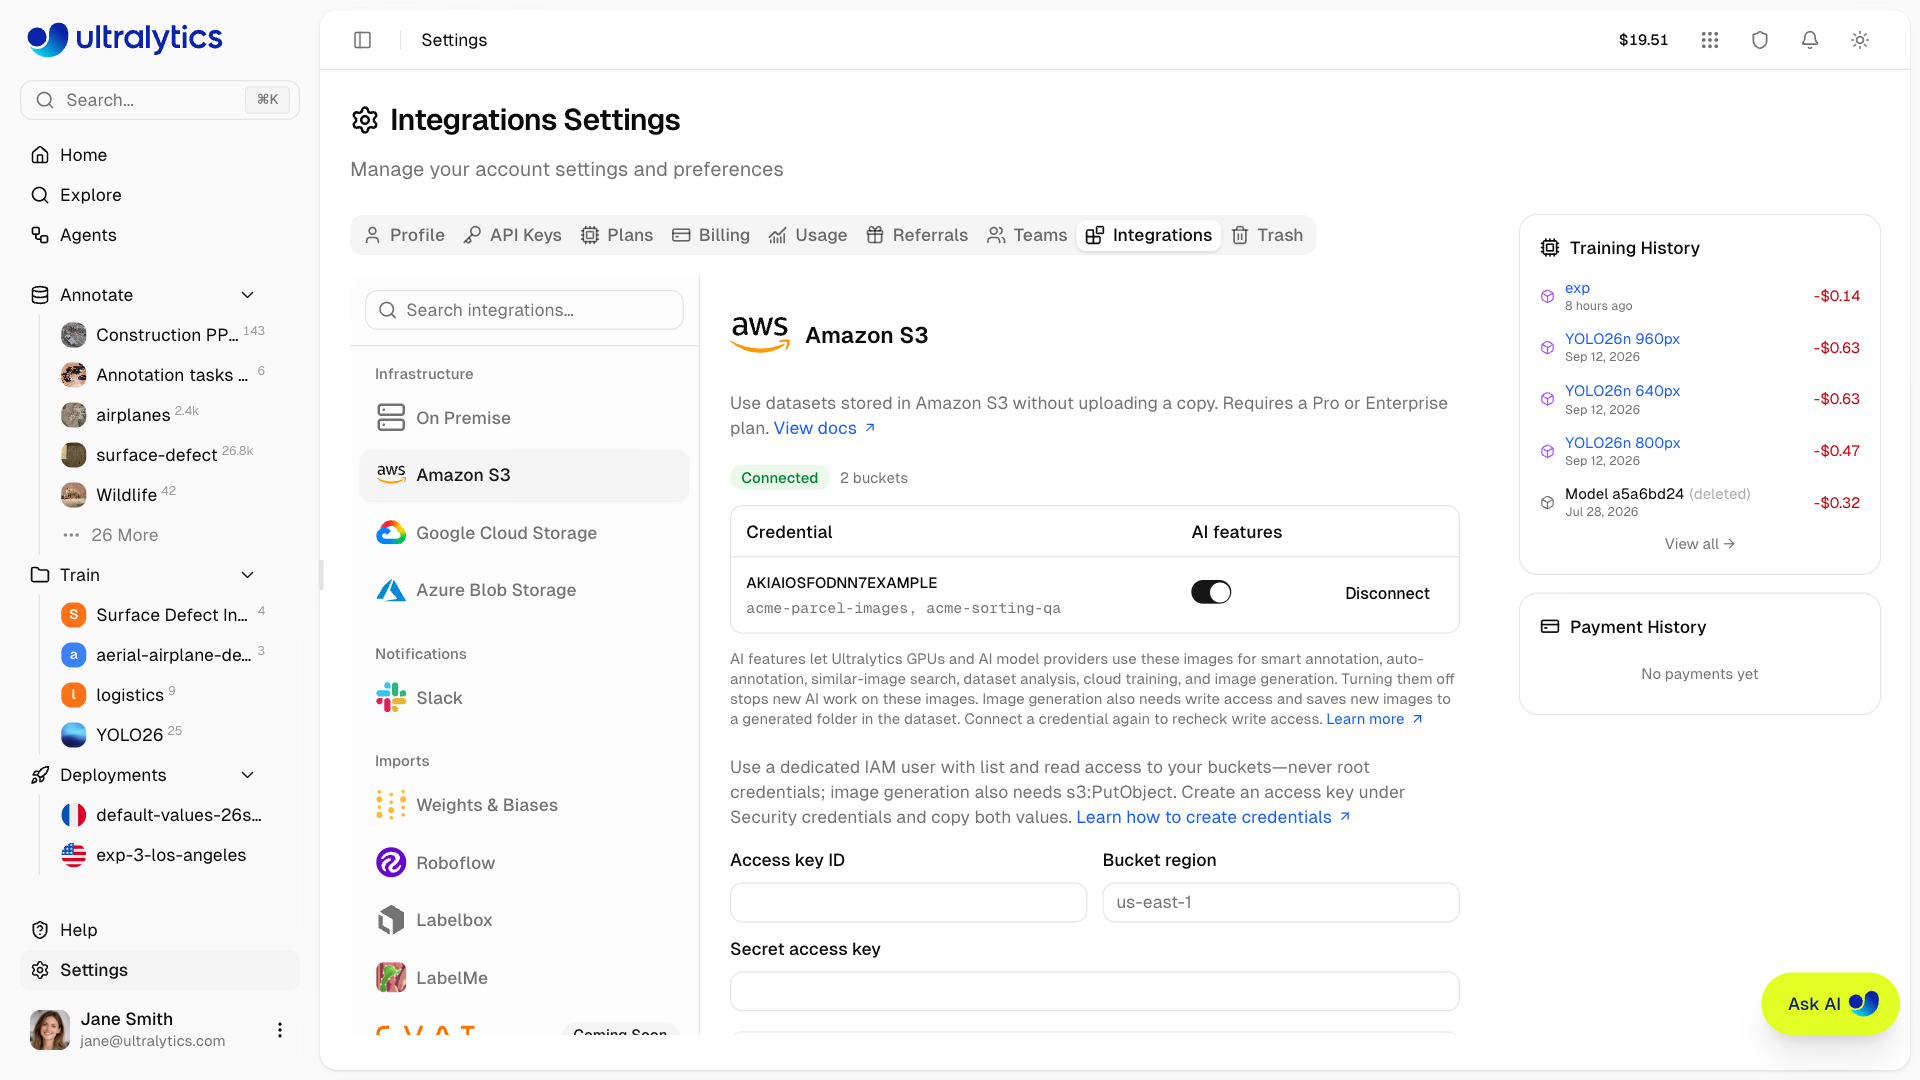
接続済みの各認証情報にはAI機能スイッチがあります。IAMポリシーを変更した後は、同じIAMユーザーを再接続して書き込みアクセス権を再確認してください。
クラウドストレージを接続するには、ワークスペースの管理者またはオーナーのロールが必要です。一度に最大50個のバケットを追加でき、検出ではキーから参照できるバケットのうち最大300個が一覧表示されます。
後から同じIAMユーザーを再接続すると、既存のインテグレーションに新しいバケットが追加されます。保存済みの認証情報は、置き換え後も接続済みのすべてのバケットを読み取れる場合にのみ更新されます。読み取れないバケットがある場合は、同じIAMユーザーで以前に接続したバケットを含め、そのバケット名がエラーに表示されます。
1つの接続で読み取るバケットは、入力したリージョン内のものです。バケットが複数のリージョンにある場合は、リージョンごとに接続してください。
認証情報は保存時にAES-256-GCMで暗号化され、ブラウザーに返されたり、トレーニングのワークロードに公開されたりすることはありません。アクセスを取り消すには、AWS IAMでアクセスキーを無効化してください。
AI機能#
接続済みの各認証情報には、デフォルトでオンのSettings > Integrations内のAI機能スイッチがあります。オンの場合、UltralyticsのGPUとAIモデルプロバイダーは、その認証情報にある画像を次の用途に使用することがあります。
- SAMスマートアノテーション、および単一画像とバッチの自動アノテーション
- 類似画像検索とクラスタリング分析
- クラウドトレーニング
- 書き込みアクセス権のあるバケットでの画像生成
AIモデルプロバイダーが関与するのは、Google Geminiが元画像をもとにプロンプトを作成する画像生成と、ワークスペース独自のプロバイダーキーで実行する有料アノテーションモデルに限られます。Platformは画像のコピーを保持しません。各機能は必要に応じて画像を読み込み、クラウドトレーニングでは実行中のみ一時コピーを使用します。また、類似画像検索では各画像の埋め込みを保持し、画像がPlatformから削除されると埋め込みも削除されます。
スイッチをオフにすると、画像がUltralyticsのGPUやAIモデルプロバイダーに渡らないようにできます。オフにすると新しいAI処理は停止しますが、すでに実行中の処理は完了します。その認証情報を使用するデータセットには、これらの設定へのリンクとともにAI features offと表示され、利用できない各機能には理由が示されます。手動アノテーション、共有、ローカルトレーニングは引き続き利用でき、すでに作成したラベル、モデル、検索結果は保持されます。
スイッチを変更するには、ワークスペースの管理者またはオーナーのロールが必要です。REST APIを使用して、GET /api/integrations/bucketsから返されるインテグレーションIDを指定することもできます。
curl -X PATCH \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"processing": false}' \
https://platform.ultralytics.com/api/integrations/buckets/INTEGRATION_ID画像生成#
類似画像の生成は、IAMユーザーがバケットに書き込めるAmazon S3データセットで、AI機能がオンの場合に利用できます。追加する画像は、データセットのフォルダー内のgenerated/フォルダーに書き込まれ、他のインデックス済み画像と同様にデータセットに追加されます。Platformはそこに新しいオブジェクトのみを作成し、既存のオブジェクトを上書きまたは削除することはありません。この操作で書き込みアクセス権が必要と表示された場合は、必要に応じて権限を付与し、Settings > Integrationsで同じIAMユーザーを再接続してください。
S3バケットからデータセットを作成する#
- New Datasetをクリックし、Cloudタブを開きます。
- 接続済みのバケットを選択し、データを含むフォルダーを開きます。
- フォルダーを確定し、データセット名を調整して、データセットを作成します。
Platformはフォルダーの一覧を一度取得し、見つかった内容をインデックス化します。
- 画像 —
.jpg、.jpeg、.png、.webp、.avifの各オブジェクトをインデックス化し、上限付きリクエストで寸法を読み取ります。Platformはソース画像のコピーを別途保存しません。 - ラベル — YOLOの
.txtサイドカーファイルを解析してPlatformのアノテーションに変換し、標準的なimages/→labels/の構成、または同じフォルダー内のファイルとして対応付けます。 - メタデータ — YAMLファイルからクラス名とポーズのキーポイント形状を取得します。これはアーカイブのアップロードと同じです。フォルダーに複数のYAMLファイルがある場合は、
data.yamlとdata.ymlが優先されます。 - タスク — ラベルファイルのサンプルからタスクを判定するため、ダイアログで選択したタスクではなく、ラベルの形状に基づいてセグメンテーション、ポーズ、OBBのフォルダーを認識します。
- 分割 — オブジェクトキー内のフォルダー名
train、val、testに基づき、データ分割が自動的に割り当てられます。
作成したデータセットは、他のデータセットと同様に利用できます。閲覧やアノテーション、公開・非公開の設定、チームとの共有、マネージドトレーニングによるトレーニングが可能です。元画像は必要に応じてストリーミングされ、インデックス化された画像はPlatformのストレージクォータを消費しません。
1回のインポートで最大500,000個のオブジェクトと、各1 MBまでのラベルファイルまたはYAMLファイルをインデックス化できます。より大きなバケットは複数のデータセットに分割してください。
インデックス化された各画像はS3オブジェクトのETagに固定されており、オブジェクトが変更されるとPlatformは安全側に処理を停止します。既存のオブジェクトを上書きせず、新しいオブジェクトを追加してください。
インポートの失敗#
空のフォルダー、パスの入力ミス、権限の取り消しなどが原因でインポートに失敗すると、データセットのページにエラーが表示されます。編集者は Retry import をクリックすると、保存済みのバケットとフォルダーを使って再試行できます。または、修正したパスを指定して新しいデータセットを作成できます。
再試行では処理を再開せず、フォルダーを再度一覧表示します。最初の試行以降に追加されたオブジェクトは取り込まれ、すでに存在しないオブジェクトはデータセットから除外されます。
トレーニング#
AI機能がオンの場合、通常のトレーニングフローでマネージドトレーニングを実行できます。トレーニングでは、固定した画像のPlatform独自のコピーを実行中のみ使用します。AWSの認証情報がトレーニングワークロードに公開されることはありません。AI機能がオフの場合、トレーニングダイアログにクラウドトレーニングを利用できない理由が表示され、代わりにローカルトレーニングが提示されます。
接続を解除する#
接続を解除すると、保存済みの認証情報が削除されますが、AWS上のデータには影響しません。それらのバケットから作成したデータセットは、クラス、ラベル、アノテーションとともにワークスペースに残りますが、同じIAMユーザーを再接続するまで画像の読み込み、プレビュー、トレーニングはできません。接続解除中も、データセット名の変更、ラベルの編集、データセットの削除は可能です。
接続を解除するには、Settings > Integrations に移動し、Amazon S3 を選択して、認証情報の横にある Disconnect をクリックし、確認します。そのデータセットを開くと、これらの設定へのリンクとともに Amazon S3 Disconnected と表示されます。再接続すると、データセットは自動的に再び利用可能になります。
REST APIを使って接続を解除することもできます。その際は、GET /api/integrations/buckets が返すインテグレーションIDを使用します。
curl -X DELETE \
  -H "Authorization: Bearer YOUR_API_KEY" \
  https://platform.ultralytics.com/api/integrations/buckets/INTEGRATION_ID
from ultralytics_platform import Platform
client = Platform() # reads ULTRALYTICS_API_KEY
integrations = client.storage_integrations.list()
client.storage_integrations.delete("INTEGRATION_ID")接続元でアクセスを取り消すには、AWS IAMでアクセスキーを無効化または削除してください。
現在の制限事項#
S3を使用するデータセットでは、Platformが所有する画像のコピーを必要とする機能(データセットの複製、変更不可のバージョンスナップショット、顔ぼかし、他のデータセットからの画像の貼り付け)は利用できません。スマートアノテーション、自動アノテーション、類似画像検索、クラスタリング、クラウドトレーニング、画像生成にはAI機能をオンにする必要があります。
S3連携データセット、またはその個別画像を削除しても、Platformの参照情報のみが削除され、オブジェクトには一切触れません。
Google Cloud StorageおよびAzure Blob Storageのインテグレーションもご覧ください。
よくある質問#
データセットは作成時に一度だけインデックス化されます。新しいオブジェクトは、新しいデータセットを作成するか、失敗したインポートを再試行するまで取り込まれません。また、インデックス化された各画像はそのバージョンに固定されるため、オブジェクトを上書きすると、Platformはその画像の処理を安全側に停止します。既存のオブジェクトを置き換えず、新しいオブジェクトを追加してください。
画像生成の場合に限り、IAMユーザーに
s3:PutObjectがあり、AI機能がオンの場合にのみ書き込みます。Platformはデータセットのフォルダー内のgenerated/の下に新しいオブジェクトを作成し、既存のオブジェクトを上書きまたは削除することはありません。保存済みの認証情報を削除するには、Settings > Integrationsでインテグレーションを切断するか、AWS IAMでアクセスキーを無効化または削除してください。どちらの操作もバケット内のデータには影響しません。切断せずに画像がUltralyticsのGPUに渡らないようにするには、AI機能をオフにしてください。


コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。