Insights sobre avaliação e ajuste fino de modelos
Após treinar um modelo YOLO, o próximo passo é medir seu desempenho e ajustá-lo para corrigir as lacunas. A avaliação usa métricas como mAP e IoU para quantificar a precisão, enquanto o ajuste fino modifica os parâmetros de treinamento para fortalecer os pontos fracos e garantir que o modelo atenda ao objetivo do seu projeto. Este guia explica as principais métricas de avaliação, como interpretá-las e como agir com base no que elas mostram.
Assista: Análise da avaliação e do ajuste fino de modelos | Dicas para melhorar a precisão média média
A avaliação e o ajuste fino acontecem perto do fim do fluxo de trabalho do projeto de visão computacional, quando o treinamento já está em andamento e você precisa verificar se o modelo é preciso, eficiente e está pronto para implantação.
Principais métricas de avaliação#
Várias métricas medem a eficácia do desempenho de um modelo. Essas métricas de desempenho fornecem informações numéricas claras que orientam melhorias para garantir que o modelo atinja os objetivos pretendidos.
Pontuação de confiança#
A pontuação de confiança representa o grau de certeza do modelo de que um objeto detetado pertence a uma determinada classe. Varia entre 0 e 1, sendo que pontuações mais altas indicam maior confiança. A pontuação de confiança ajuda a filtrar previsões: só são consideradas válidas as deteções com pontuações de confiança acima de um limiar especificado.
Ao executar a inferência, se você não estiver vendo previsões e já tiver verificado todo o resto, tente reduzir o limiar de confiança. Às vezes, o limiar está alto demais, fazendo com que o modelo ignore previsões válidas. Reduzi-lo permite que o modelo considere mais possibilidades. Talvez isso não atenda aos objetivos finais do seu projeto, mas é uma boa maneira de ver o que o modelo consegue fazer e decidir como ajustá-lo.
Intersection over Union#
A interseção sobre união (IoU) é uma métrica de deteção de objetos que mede a sobreposição entre a caixa delimitadora prevista e a caixa delimitadora de referência. Os valores de IoU variam entre 0 e 1, sendo que 1 representa uma correspondência perfeita. A IoU é essencial porque mede o grau de correspondência entre os limites previstos e os limites reais do objeto.
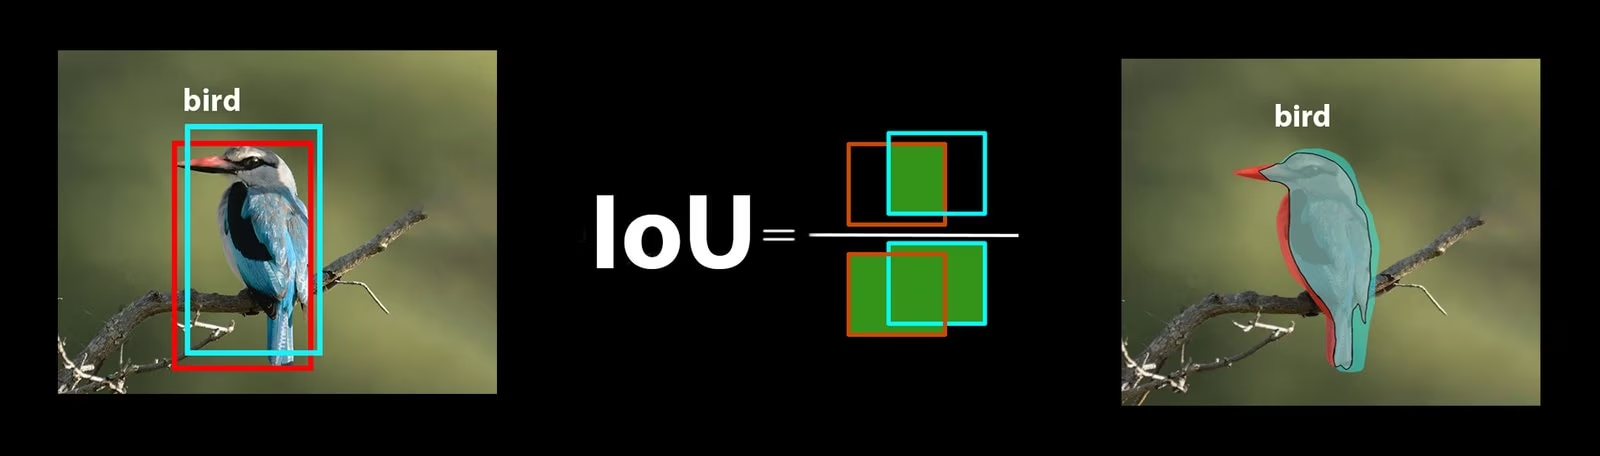
Precisão média#
A precisão média média (mAP) mede o desempenho geral de um modelo de deteção de objetos. Considera a precisão da deteção de cada classe de objeto, calcula a média destas pontuações e produz um único valor que indica a precisão com que o modelo consegue identificar e classificar objetos.
Duas métricas mAP são as mais comumente relatadas:
- mAP50: mede a precisão média num único limiar IoU de 0.5. Esta métrica verifica se o modelo consegue encontrar objetos corretamente com um requisito de precisão menos rigoroso. Avalia se o objeto está aproximadamente no sítio certo, sem exigir uma localização perfeita, e ajuda a perceber se o modelo é geralmente bom a detetar objetos.
- mAP50-95: calcula a média dos valores mAP obtidos em vários limiares IoU, de 0.5 a 0.95, com incrementos de 0.05. Esta métrica é mais detalhada e rigorosa. Dá uma visão mais completa da precisão com que o modelo encontra objetos em diferentes níveis de exigência e é especialmente útil em aplicações que necessitam de deteção precisa de objetos.
Outras métricas mAP incluem mAP75, que usa um limiar IoU mais rigoroso de 0.75, e APS, APM e APL, que avaliam a precisão em objetos pequenos, médios e grandes.
Avaliação de um modelo YOLO26#
Você pode avaliar um modelo YOLO26 treinado com o modo de validação. Para uma análise mais aprofundada de como cada métrica é calculada e interpretada, consulte o guia de métricas de desempenho do YOLO26.
Como lidar com tamanhos variáveis de imagem#
Avaliar o teu modelo em imagens de tamanhos diferentes ajuda a entender o desempenho dele em conjuntos de dados diversos. Por padrão, a validação usa lotes retangulares (rect=True em model.val()): agrupa imagens por proporção e preenche cada lote para formar um retângulo, para que as imagens retangulares sejam avaliadas sem serem forçadas a caber em um quadrado.
O parâmetro imgsz define o tamanho da imagem usado durante a validação. Se não definires esse parâmetro explicitamente, o YOLO26 reutiliza o valor salvo nas configurações do modelo (640 para os modelos pré-treinados oficiais ou o tamanho usado no treinamento de um checkpoint personalizado). Com rect=True, as formas usadas na validação podem diferir das de predict (consulta rect). Ajusta imgsz conforme as dimensões do teu conjunto de dados e a memória GPU disponível.
Acessar as métricas de YOLO26#
Para entender detalhadamente o desempenho do seu modelo, você pode acessar métricas de avaliação específicas com algumas linhas de Python. O trecho de código abaixo carrega um modelo, executa a validação e exibe as métricas mais úteis.
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n.pt")

# Execute a validação no seu conjunto de dados
results = model.val(data="coco8.yaml")

# Métricas gerais
print("mAP50-95:", results.box.map)  # mAP com IoU de 0.50:0.95
print("mAP50:", results.box.map50)  # mAP com IoU de 0.50
print("mAP75:", results.box.map75)  # mAP com IoU de 0.75
print("Mean precision:", results.box.mp)
print("Mean recall:", results.box.mr)
print("Fitness:", results.box.fitness())  # pontuação ponderada usada para selecionar o modelo

# Métricas por classe
print("Class indices evaluated:", results.box.ap_class_index)
print("Per-class mAP50-95:", results.box.maps)  # as classes ausentes do conjunto de validação recebem o mAP geral

# Precisão, recall, F1, TP, FP e FN por imagem
print("Per-image metrics:", results.box.image_metrics)

# Detalhamento do tempo por etapa, em milissegundos por imagem
print("Timing breakdown (ms/image):", results.speed)
Observe que fitness() é um método e deve ser chamado com parênteses, enquanto métricas como map, map50 e mp são propriedades acessadas diretamente.
O atributo results.box.image_metrics é um dicionário por imagem indexado pelo caminho da imagem relativo ao diretório comum de imagens, que contém precision, recall, f1, tp, fp e fn com IoU de 0.5 para cada imagem. Os tempos de pré-processamento, inferência, perda e pós-processamento são informados separadamente no dicionário results.speed. Em conjunto, esses dados permitem identificar com precisão quais imagens são difíceis para o modelo e ajustar o modelo adequadamente.
Ajustar o seu modelo#
O ajuste fino parte de um modelo pré-treinado e ajusta os seus parâmetros para melhorar o desempenho numa tarefa ou conjunto de dados específico. Também conhecido como retreino do modelo, permite que o modelo compreenda melhor os dados que encontrará em aplicações do mundo real e faça previsões mais adequadas. Com base nos resultados da avaliação, retreinas o modelo com os teus próprios dados, ajustando os argumentos de treino abordados no guia de ajuste fino.
Divisão de imagens em blocos para objetos pequenos#
O recorte de imagens em blocos pode melhorar a precisão da deteção de objetos pequenos. Ao dividir imagens maiores em segmentos menores, como dividir imagens de 1280x1280 em vários segmentos de 640x640, preservas a resolução original e permites que o modelo aprenda com fragmentos de alta resolução. Usa tile=True para o recorte em blocos de alta resolução durante o treinamento, a validação e a previsão. O treinamento recorta as anotações de acordo com cada bloco, enquanto a validação e a previsão combinam os resultados dos blocos para gerar resultados da imagem inteira.
Conclusão#
A avaliação e o ajuste fino transformam um modelo treinado num modelo fiável e pronto para implantação: métricas como mAP e IoU revelam pontos fracos, e alterações direcionadas nos parâmetros ajudam a resolvê-los. Comece pelo modo de validação para avaliar o seu modelo e, em seguida, retreine-o com os argumentos descritos no guia de ajuste fino, continuando a iterar com novos parâmetros, técnicas e conjuntos de dados. Se surgirem dúvidas durante o processo, pergunte à comunidade no repositório GitHub da Ultralytics ou no servidor Discord da Ultralytics.
Perguntas frequentes#
Para avaliar o desempenho dos modelos YOLO26, as métricas importantes incluem a pontuação de confiança, a interseção sobre união (IoU) e a precisão média (mAP). A pontuação de confiança mede o grau de certeza do modelo para cada classe de objeto detetada. IoU avalia o grau de sobreposição entre a caixa delimitadora prevista e a verdade de referência. A precisão média (mAP) agrega as pontuações de precisão em várias classes, sendo mAP50 e mAP50-95 dois tipos comuns para diferentes limiares IoU. Sabe mais sobre estas métricas no nosso guia de métricas de desempenho do YOLO26.
O ajuste fino de um modelo YOLO26 pré-treinado envolve ajustar seus parâmetros para melhorar o desempenho em uma tarefa ou conjunto de dados específico. Comece avaliando o modelo com métricas e, em seguida, treine-o novamente com seus próprios dados, partindo dos pesos pré-treinados. Durante a avaliação, parâmetros como
rect=Trueajudam a lidar com eficácia com tamanhos variados de imagem.Para lidar com tamanhos de imagem variáveis durante a avaliação, use a validação retangular (
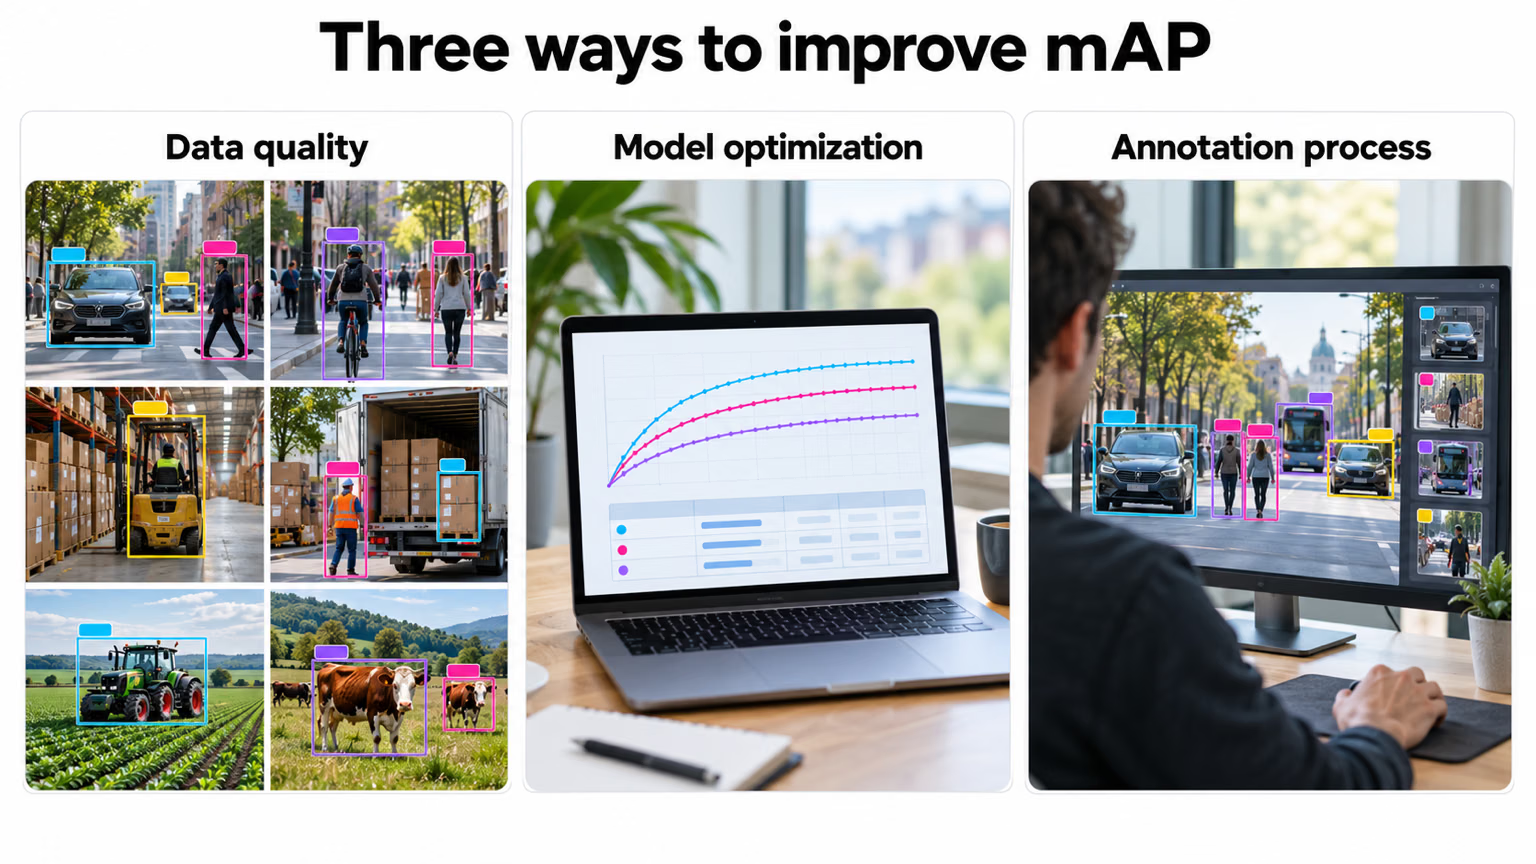
rect=True, o padrão demodel.val()), que agrupa imagens pela proporção e aplica preenchimento a cada lote, em vez de forçar todas as imagens a terem formato quadrado. O parâmetroimgszdefine o tamanho da imagem para a validação; se você não o substituir, YOLO26 reutiliza o valor salvo no modelo (640 nos modelos oficiais pré-treinados). Ajusteimgszde acordo com o seu conjunto de dados e a memória da GPU. Para mais detalhes, visite a nossa secção sobre como lidar com tamanhos de imagem variáveis.Melhorar a precisão média (mAP) de um modelo YOLO26 envolve várias etapas:
- Afinação de hiperparâmetros: experimenta diferentes taxas de aprendizagem, tamanhos de lote e aumentos de dados de imagem.
- Aumento de dados: use técnicas como Mosaic e MixUp para criar amostras de treinamento diversificadas.
- Divisão de imagens em blocos: divida imagens maiores em blocos menores para melhorar a precisão da deteção de objetos pequenos.
Para saber mais sobre os argumentos de treinamento relacionados com as etapas 1 e 2, consulte o guia de ajuste fino; a etapa 3 é abordada em divisão de imagens em blocos.
Você pode aceder às métricas de avaliação de um modelo YOLO26 com Python depois de executar a validação:
Usofrom ultralytics import YOLO # Carregar um modelo model = YOLO("yolo26n.pt") # Executar a validação results = model.val(data="coco8.yaml") # Aceder às métricas principais print("Mean average precision at IoU=0.50:", results.box.map50) print("Mean average precision at IoU=0.50:0.95:", results.box.map) print("Mean recall:", results.box.mr) print("Class indices evaluated:", results.box.ap_class_index)A análise destas métricas ajuda você a ajustar e otimizar o seu modelo YOLO26. Para uma análise mais aprofundada, consulte o nosso guia sobre métricas de desempenho do YOLO.


Comentários2
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
ILIAHHne63
Hello, I'm using YoLOv10, how can I load the pretrained backbone, but leave the head unpretrained?
 Glenn JocherUltralytics
@ILIAHHne63 to load a pretrained backbone while leaving the head unpretrained in YOLOv10, you can initialize the model with the pretrained weights and then manually reset the head layers. This allows you to retain the pretrained features of the backbone while training the head from scratch. For detailed steps, refer to the model fine-tuning section in our documentation. If you encounter any issues, ensure you're using the latest version of the package.