Оценка монокулярной глубины с Ultralytics YOLO#
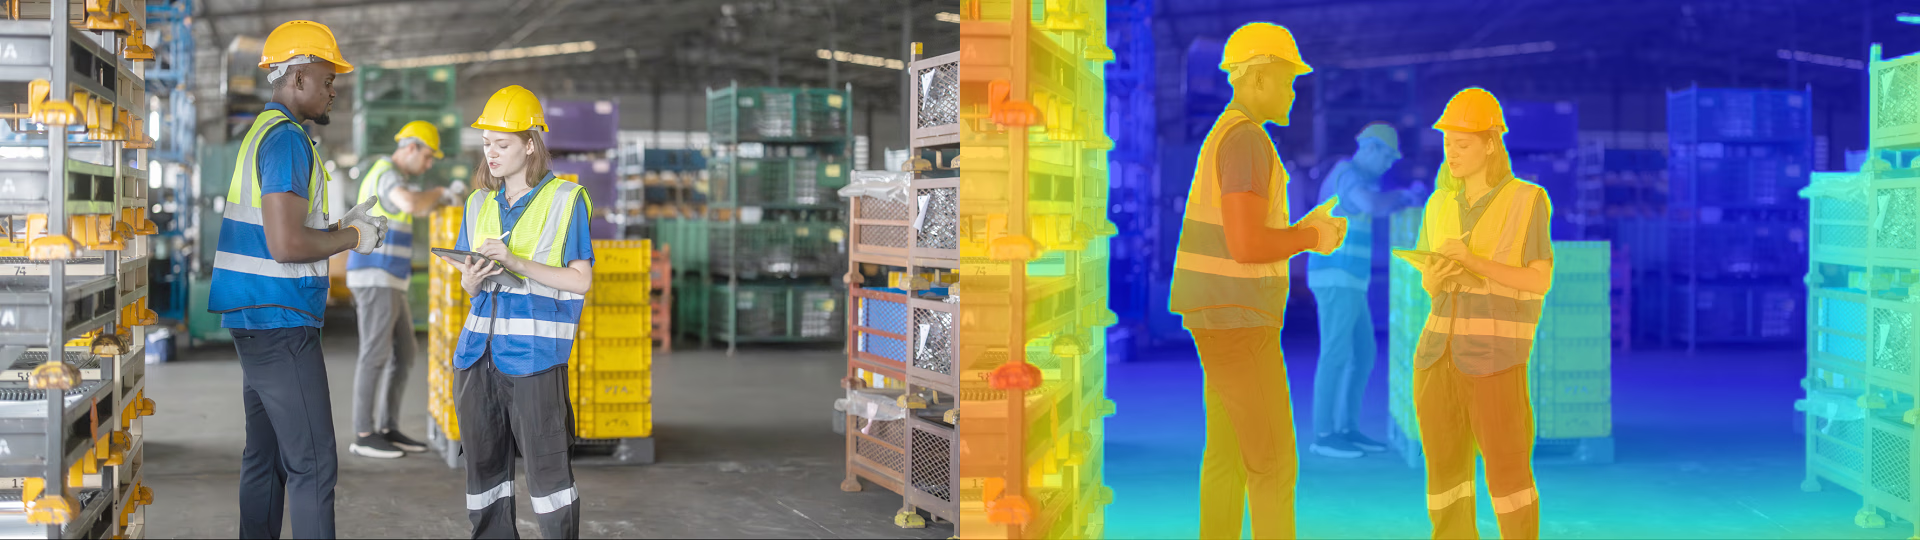
Оценка монокулярной глубины предсказывает карту глубины для каждого пикселя по одному RGB-изображению. Каждый выходной пиксель содержит значение глубины в метрах, которое показывает предполагаемое расстояние от камеры до соответствующей точки поверхности.
На выходе модели оценки глубины получается плотная карта чисел с плавающей точкой формы (H, W), совмещенная с входным изображением. Такое попиксельное представление делает оценку монокулярной глубины подходящей для реконструкции 3D-сцен, навигации роботов, создания AR/VR-контента и любых приложений, которым нужна информация о пространственной структуре по изображению с одной камеры.
Смотри: Монокулярная оценка глубины с Ultralytics YOLO26 | Руководство по Python | Vision AI 🚀
Для оценки монокулярной глубины используй задачу task=depth или задачу CLI yolo depth. Файлы моделей оценки глубины YOLO26 имеют суффикс -depth, например yolo26n-depth.pt.
Модели#
Ниже представлены модели оценки глубины YOLO26, предварительно обученные на широком наборе данных из разных датасетов (в помещении и на улице, ~2.19M изображений). Метрики в столбцах рассчитаны на тестовой выборке Eigen датасета NYU Depth V2.
Модели автоматически загружаются из последнего релиза Ultralytics при первом использовании.
| Модель | размер (пиксели) | delta1NYU | abs_relNYU | rmseNYU | Скорость CPU ONNX (мс) | Скорость T4 TensorRT10 (мс) | параметры (M) | FLOPs (B) |
|---|---|---|---|---|---|---|---|---|
| YOLO26n-depth | 768 | 0.882 | 0.109 | 0.414 | 272.0 ± 27.2 | 2.7 ± 0.1 | 6.3 | 46.9 |
| YOLO26s-depth | 768 | 0.896 | 0.104 | 0.399 | 393.7 ± 13.1 | 3.8 ± 0.0 | 13.2 | 68.0 |
| YOLO26m-depth | 768 | 0.921 | 0.089 | 0.364 | 621.5 ± 49.7 | 6.0 ± 0.1 | 23.3 | 130.4 |
| YOLO26l-depth | 768 | 0.930 | 0.083 | 0.351 | 821.9 ± 50.7 | 7.7 ± 0.1 | 27.7 | 157.0 |
| YOLO26x-depth | 768 | 0.933 | 0.080 | 0.344 | 1240.9 ± 73.3 | 13.6 ± 0.2 | 57.0 | 301.7 |
- delta1NYU — доля пикселей, для которых предсказанная глубина отличается от истинной не более чем в 1,25 раза. Метрика рассчитана на тестовой выборке Eigen датасета NYU Depth V2 (654 изображения) с TTA с несколькими масштабами и горизонтальным отражением, а также выравниванием методом наименьших квадратов в логарифмическом пространстве.
- Точность при одном масштабе без TTA можно воспроизвести с помощью
yolo depth val model=yolo26n-depth.pt data=nyu-depth.yaml imgsz=768 device=0(подставляйmodel=для каждого размера). Этот режим использует выравнивание по медиане (только масштаб) и дает более низкие значения delta1: 0.783 (n), 0.793 (s), 0.840 (m), 0.853 (l), 0.860 (x). - abs_rel — средняя абсолютная относительная ошибка между предсказанными и истинными значениями глубины.
- rmse — среднеквадратичная ошибка в метрах.
- Скорость — задержка только на инференсе (без предварительной и последующей обработки) при
imgsz=768,batch=1; указано среднее значение ± стандартное отклонение по замерам после прогрева. CPU ONNX — ONNX Runtime fp32 на 32-ядерном Intel Xeon (Skylake); T4 TensorRT10 — TensorRT fp16 на Tesla T4. - params и FLOPs измерены при разрешении 768×768 — разрешении обучения выпущенных весов.
Смотри предварительные результаты на NYU Depth V2 в превью невыпущенной YOLO27.
Сравнение скорости с Depth Anything V2#
Depth Anything V2 — широко используемая открытая базовая модель для оценки монокулярной глубины. Ее основа DINOv2 с визуальным трансформером и декодер DPT требуют больших вычислительных ресурсов, поэтому при запуске на одной и той же Tesla T4 с TensorRT fp16 самая маленькая выпущенная модель Depth Anything V2 работает медленнее любой модели оценки глубины YOLO26 — включая YOLO26x-depth, число параметров которой более чем вдвое выше.
При разрешении ~768 px — imgsz=768 для YOLO26, на котором обучены выпущенные веса, и 770 px для Depth Anything V2, поскольку для основы DINOv2 требуется размер, кратный размеру патча 14:
| Модель | params (M) | FLOPs (B) | T4 TensorRT10 (мс) | FPS | Ускорение относительно V2 Small | Ускорение относительно V2 Base |
|---|---|---|---|---|---|---|
| Depth Anything V2 Base | 97.5 | 1025.5 | 55.40 | 18.1 | — | — |
| Depth Anything V2 Small | 24.8 | 346.9 | 20.99 | 47.6 | — | — |
| YOLO26x-depth | 57.0 | 301.7 | 13.57 | 73.7 | 1.5× | 4.1× |
| YOLO26l-depth | 27.7 | 157.0 | 7.68 | 130.2 | 2.7× | 7.2× |
| YOLO26m-depth | 23.3 | 130.4 | 6.00 | 166.7 | 3.5× | 9.2× |
| YOLO26s-depth | 13.2 | 68.0 | 3.82 | 261.6 | 5.5× | 14.5× |
| YOLO26n-depth | 6.3 | 46.9 | 2.73 | 365.8 | 7.7× | 20.3× |
При разрешении ~640 px — imgsz=640 и 644 px соответственно — порядок моделей не меняется, а YOLO26n-depth работает в 5.9 раза быстрее Depth Anything V2 Small:
| Модель | T4 TensorRT10 (мс) | FPS |
|---|---|---|
| Depth Anything V2 Base | 35.10 | 28.5 |
| Depth Anything V2 Small | 13.62 | 73.4 |
| YOLO26x-depth | 10.26 | 97.5 |
| YOLO26l-depth | 6.14 | 162.8 |
| YOLO26m-depth | 4.71 | 212.1 |
| YOLO26s-depth | 3.08 | 324.4 |
| YOLO26n-depth | 2.29 | 436.9 |
- Задержка измерена только на инференсе при
batch=1с TensorRT fp16 на Tesla T4 — на той же тестовой системе, что и для таблицы моделей выше; здесь значения округлены до двух знаков после запятой. FPS — обратная величина неокругленной задержки. В столбцах Ускорение задержка Depth Anything V2 Small (20.99 мс) и Base (55.40 мс) делится на задержку YOLO26. - Depth Anything V2 Small и Base — выпущенные контрольные точки ViT-S и ViT-B.
- Сравнение охватывает только задержку: эти два семейства моделей здесь не оцениваются по единому протоколу точности.
Диапазон глубины и логарифмическая голова оценки глубины#
Голова оценки глубины предсказывает exp(logit) — неограниченный (~0.02–150 м) — и разделяет форму сцены и абсолютный масштаб: сеть предсказывает относительное поле логарифмической глубины, а абсолютные значения в метрах задаются отдельным двухпараметрическим преобразованием (exp(a·log d + b)), которое определяется при оценке, с помощью простой калибровки или дообучения. Распространенная альтернатива — ограниченная голова sigmoid × max_depth, в архитектуру которой заложен фиксированный верхний предел. Поэтому глубина больше max_depth обрезается, что не позволяет обучаться на сценах с большой дальностью и предсказывать их.
Контролируемый A/B-тест: одни и те же данные, тот же график обучения, различается только голова. Обучение обеих голов с нуля на одинаковой смеси данных из помещений (≤10 м) и с улицы (≤80 м):
| Голова | Диапазон выходных значений | δ1 на валидации для смешанных диапазонов | Поведение при обучении |
|---|---|---|---|
sigmoid × max_depth (10 м) | ограниченный диапазон 0–10 м | 0.221 | выходит на плато на 1-й эпохе |
log (без ограничений) | 0–~150 m | 0.367 (+66%) | продолжает улучшаться на протяжении всего обучения |
Ограниченная голова не может представлять большую часть уличных пикселей с глубиной >10 м, поэтому почти сразу перестает улучшаться; голова log обучается на всем диапазоне.
Проблема, которую решает такой подход: дообучение на одном датасете с разбивкой по диапазону глубины. Дообучение ограниченной головы (10 м) на отдельных датасетах работает, если данные укладываются в заданный предел, и приводит к резкому ухудшению, если выходят за него:
| Датасет | Диапазон глубины | δ1 для ограниченной головы |
|---|---|---|
| SUN RGB-D | ≤10 m | 0.78 ✅ |
| Hypersim | преимущественно ≤10 м | 0.74 ✅ |
| KITTI | ~80 m | 0.08 ❌ (abs_rel ≈ 7.0 — несоответствие масштаба 80/10) |
| vKITTI2 | 80 m | 0.04 ❌ |
Резкое ухудшение происходит точно на границе ограничения. У головы log такой границы нет.
Выпущенные модели — качество на разных диапазонах. Семейство с головой log, доступное в выпущенных моделях, оценивалось на тестах с диапазоном глубины от 10 м (NYU, iBims-1) до 80 м (KITTI); приведена δ1 с выравниванием масштаба:
| Бенчмарк | Диапазон | YOLO26x-depth (log) | предыдущая версия с ограниченной головой |
|---|---|---|---|
| NYU Eigen | 10 m | 0.933 | 0.934 |
| iBims-1 | 10 m | 0.961 | 0.945 |
| ETH3D | ~60 m | 0.959 | 0.931 |
| Make3D | ~70 m | 0.302 | 0.296 |
| KITTI Eigen | 80 m | 0.942 | 0.891 |
| Среднее | — | 0.819 | 0.799 |
Оба столбца приведены без изменений из опубликованных данных. Для остальных строк использован протокол TTA и логарифмического выравнивания методом наименьших квадратов, описанный на страницах соответствующих датасетов. Валидатор в этом репозитории его не реализует, поэтому строку KITTI нельзя повторно измерить на тех же условиях; на странице KITTI приведены значения, измеренные на канонической выборке Eigen из 652 кадров.
Наибольший прирост наблюдается на уличных тестах с большей дальностью (KITTI, ETH3D) — именно там фиксированный предел в 10 м вредит сильнее всего; при этом качество на данных из помещений сохраняется.
Обучение#
Обучи YOLO26n-depth на датасете Depth8 в течение 100 эпох с размером изображения 640. Полный список доступных аргументов смотри на странице Configuration.
from ultralytics import YOLO

# Загрузить модель
model = YOLO("yolo26n-depth.yaml")  # создать новую модель из YAML
model = YOLO("yolo26n-depth.pt")  # загрузить предварительно обученную модель (рекомендуется для обучения)
model = YOLO("yolo26n-depth.yaml").load("yolo26n-depth.pt")  # создать модель из YAML и перенести веса

# Обучить модель
results = model.train(data="depth8.yaml", epochs=100, imgsz=640)
Полное описание режима train смотри на странице Train. Модели оценки глубины также можно обучать в облачной среде Ultralytics Platform.
Формат датасета#
Датасеты для оценки глубины сопоставляют каждому RGB-изображению масштабированную карту глубины в формате uint16 PNG или NPY с числами с плавающей точкой, где глубина задана в метрах. По умолчанию значения PNG указываются в миллиметрах; для датасетов с другой системой единиц в YAML задается depth_scale. Загрузчик формирует путь к карте глубины, заменяя компонент images на depth, и сначала ищет .png, а если его нет — .npy.
dataset/
├── images/
│   ├── train/
│   └── val/
└── depth/
    ├── train/
    └── val/
Например, изображению по пути images/train/scene_001.jpg соответствует карта глубины по пути depth/train/scene_001.png. Полную спецификацию формата смотри в руководстве по датасетам для оценки глубины.
Дообучение на собственных данных#
При адаптации предварительно обученной модели оценки глубины под пользовательский датасет уменьши скорость обучения и используй оптимизатор AdamW. Настройки оптимизатора по умолчанию рассчитаны на обучение с нуля; применение этих настроек к уже сошедшейся модели оценки глубины может привести к утрате предварительно изученных знаний и ухудшению результатов — особенно при дообучении на данных из одной предметной области.
from ultralytics import YOLO

model = YOLO("yolo26s-depth.pt")  # начни с предобученных весов

model.train(
    data="path/to/your_dataset.yaml",
    epochs=20,
    imgsz=640,
    optimizer="AdamW",
    lr0=1e-4,  # примерно в 100 раз ниже значения по умолчанию для обучения с нуля
    warmup_bias_lr=1e-4,  # также используй плавный разогрев
)
Дополнительные советы:
- Аугментация настраивается стандартными аргументами (
degrees,translate,scale,shear,perspective,flipud,fliplr,hsv_h,hsv_s,hsv_v); геометрические преобразования и отражения одинаково применяются к парной карте глубины. Чтобы узнать точный рецепт, использованный для выпущенных весов YOLO26-Depth, проверьtrain_args, сохранённый в чекпойнте, — см. Проверка параметров обучения в чекпойнте YOLO26. mosaic,mixup,cutmixиcopy_pasteне реализованы для оценки глубины. Загрузчик набора данных глубины автоматически устанавливает вероятности этих преобразований в 0, поэтому передача этих аргументов ни на что не влияет. Эти аугментации не поддерживаются, поскольку объединяют несколько изображений, что привело бы к некорректным парным картам глубины.- Любой диапазон глубины работает без дополнительной настройки. Модели с головой
logпредсказывают неограниченную глубину, поэтому без изменений адаптируются к данным с малым (макросъёмка) или большим диапазоном (съёмка на улице/в движении). Указаниеmax_depth:в YAML-файле набора данных (в метрах) ограничивает значения GT-пикселей, учитываемых при расчёте метрик валидации. - Сохраняй обобщающую способность. Если модель должна оставаться точной на сценах, не входивших в обучающую выборку, добавь в обучающие данные небольшую долю (~5–10%) разнообразных изображений общего назначения; это значительно уменьшит катастрофическое забывание при дообучении.
- Обучай с нуля (
model=yolo26s-depth.yaml), только если твоя предметная область сильно отличается от исходной и у тебя большой набор данных: в этом случае подходит значениеoptimizer=autoпо умолчанию, поскольку сохранять предобученные веса не требуется.
Калибровка масштаба глубины#
Голова оценки глубины разделяет форму (относительную структуру сцены) и масштаб (абсолютные значения в метрах). Если модель уже хорошо оценивает относительную глубину в твоих сценах, но абсолютные значения не подходят для твоей камеры, ты можешь за секунды скорректировать масштаб с помощью model.calibrate() — это замкнутая форма подгонки только масштаба лог-аффинного преобразования головы по небольшому размеченному набору данных. Подгонка применяется, только если она показывает лучший результат по δ1 на отложенных данных при кросс-валидации, без обучения градиентным спуском и изменения весов сети, поэтому относительная структура не может ухудшиться.
from ultralytics import YOLO

model = YOLO("yolo26s-depth.pt")

# Подгони масштаб на размеченной выборке (достаточно примерно 100 и более изображений), затем сохрани результат
model.calibrate(data="path/to/your_dataset.yaml")
model.save("yolo26s-depth-calibrated.pt")
Для калибровки нужна эталонная глубина, поэтому она выполняется на размеченной выборке — при инференсе без разметки провести её нельзя. Подгонка и оценка выполняются по тем же пикселям, которые используются для расчёта метрик валидации: значения GT, равные или превышающие max_depth из YAML-файла набора данных (по умолчанию 100 м), исключаются. Используй эту калибровку, когда относительная глубина уже оценивается хорошо, а неверен только масштаб/диапазон; если для твоей предметной области нужно изменить саму относительную структуру, вместо этого выполни дообучение.
model.calibrate() оценивает три варианта по δ1 исходного масштаба на отложенных изображениях, используя двухблочную кросс-валидацию максимум примерно на 200 изображениях из размеченной выборки, и записывает победивший вариант в модель:
- identity: исходный выход головы без калибровки.
- current: калибровка, которая уже есть у модели, например встроенная в опубликованные контрольные точки.
- scale-only: новый общий масштаб, повторно подогнанный по всем этим изображениям при выборе этого варианта.
Вариант identity сохраняется, если current или scale-only не превосходит его более чем на 0.002 δ1; в противном случае выбирается вариант с более высоким результатом из этих двух, а при равенстве сохраняется current. Таким образом, модель сохраняет имеющуюся калибровку, если только новый масштаб не показывает более высокий результат или ни одна из калибровок не превосходит исходный выход на указанную величину.
Во время обучения этот же выбор выполняется автоматически: после завершения model.train(...) контрольные точки best и last калибруются на валидационной выборке, чтобы сразу выдавать глубину в метрическом масштабе. Модель, обученная с нуля по YAML, не имеет калибровки, поэтому current совпадает с identity. Модель, дообученная на опубликованной контрольной точке, наследует её калибровку, которая участвует в сравнении как current.
Опубликованные контрольные точки yolo26*-depth.pt поставляются с уже встроенной калибровкой, подогнанной на смеси валидационных данных предобучения. Это единый общий масштаб для всех доменов, поэтому для наиболее точной абсолютной оценки глубины с конкретной камерой или в конкретном типе сцен запусти model.calibrate() на небольшой размеченной выборке из собственных данных.
Получение эталонных данных о глубине без камеры глубины#
Если в камере нет датчика глубины, её всё равно можно откалибровать. При калибровке подбирается единый масштаб для всего изображения, а пиксели со значением глубины 0 игнорируются, поэтому для каждого изображения достаточно нескольких измеренных точек.
-
Собери изображения. Сделай от 50 до 150 снимков камерой с теми же разрешением и настройками объектива, которые будешь использовать при работе, и помести их в
dataset/images/val/. Для калибровки считывается разделval. -
Разметь глубину. Используй один из двух способов ниже. Оба сохраняют по одной карте глубины на изображение в
dataset/depth/val/в формате датасета.
Измерь расстояние до нескольких точек на каждом изображении лазерным дальномером или рулеткой. Выбирай ровные поверхности вдали от границ объектов и записывай координаты пикселей каждой точки в points.csv:
image,x,y,meters
img_0001.jpg,352,453,3.15
img_0001.jpg,28,300,2.672
Затем создай карты глубины, оставив все неизмеренные пиксели со значением 0. Каждая точка отображается маленьким кружком, чтобы сохранить её при изменении размера до imgsz:
import csv
from collections import defaultdict
from pathlib import Path

import cv2
import numpy as np

points = defaultdict(list)
with open("points.csv") as f:  # columns: image, x, y, meters
    for row in csv.DictReader(f):
        points[row["image"]].append((int(row["x"]), int(row["y"]), float(row["meters"])))

for name, pts in points.items():
    h, w = cv2.imread(f"dataset/images/val/{name}").shape[:2]
    depth = np.zeros((h, w), np.uint16)  # 0 means no label
    r = max(h, w) // 768 + 1  # dot radius that survives the resize to imgsz=768
    for x, y, meters in pts:
        cv2.circle(depth, (x, y), r, round(meters * 100), -1)  # centimeters, matching depth_scale: 100
    out = Path("dataset/depth/val") / f"{Path(name).stem}.png"
    out.parent.mkdir(parents=True, exist_ok=True)
    cv2.imwrite(str(out), depth)
Дальномер измеряет расстояние по прямой до точки, а карты глубины хранят расстояние вдоль оси обзора камеры. В центре изображения эти значения совпадают, а при отклонении на 15° от центра разница составляет около 3,5%. Поэтому измеряй точки ближе к центру или пересчитывай каждое показание с помощью meters / sqrt(1 + ((x - cx) / fx) ** 2 + ((y - cy) / fy) ** 2), используя внутренние параметры камеры.
-
Создай YAML-файл датасета
calib.yaml.depth_scale: 100считывает PNG-файлы с глубиной в сантиметрах, созданные по измеренным точкам, и игнорируется для карт NPY:path: dataset train: images/val val: images/val depth_scale: 100 # PNG value 100 = 1 meter names: 0: depth -
Выполни калибровку и сохрани её, затем загрузи
yolo26s-depth-calibrated.ptдля предсказания или экспорта:from ultralytics import YOLO model = YOLO("yolo26s-depth.pt") model.calibrate(data="calib.yaml", imgsz=768) model.save("yolo26s-depth-calibrated.pt")
В тестах с yolo26s-depth.pt и 150 изображениями на камеру опубликованная калибровка отличалась на 4–46% от масштаба, подобранного по полной эталонной разметке для NYU, KITTI и камеры с узкоугольным объективом. Калибровка по 5 измеренным точкам на изображение отличалась от этого значения менее чем на 1%, а по разметке DA3METRIC-LARGE — менее чем на 7%. Увеличение числа изображений даёт больший эффект, чем увеличение числа точек на изображение: для 150 изображений с 1 точкой на каждом отклонение составило около 3%, а для 20 изображений с 5 точками на каждом достигало 9%.
Валидация#
Проверь точность обученной модели YOLO26n-depth на датасете для оценки глубины. Явно укажи data, чтобы при проверке использовался нужный YAML-файл датасета. Опубликованные веса обучены на imgsz=768 на изображениях, растянутых до квадрата, а не дополненных полями при сохранении пропорций. Для наилучшей точности выполняй проверку и предсказание с этим размером. Предсказание, проверка и model.calibrate() одинаково растягивают входное изображение.
from ultralytics import YOLO

# Загрузить модель
model = YOLO("yolo26n-depth.pt")  # загрузить официальную модель
model = YOLO("path/to/best.pt")  # загрузить пользовательскую модель

# Валидировать модель
metrics = model.val(data="nyu-depth.yaml")
metrics.delta1  # доля пикселей, отклонение которых не превышает порог δ=1.25
metrics.abs_rel  # средняя абсолютная относительная ошибка
metrics.rmse  # среднеквадратичная ошибка (в метрах)
metrics.silog # логарифмическая ошибка, инвариантная к масштабуПредсказание#
Используй обученную модель YOLO26n-depth для предсказаний на изображениях.
from ultralytics import YOLO

# Загрузить модель
model = YOLO("yolo26n-depth.pt")  # загрузить официальную модель
model = YOLO("path/to/best.pt")  # загрузить пользовательскую модель

# Получи предсказания с помощью модели
results = model("https://ultralytics.com/images/bus.jpg")  # получи предсказание для изображения

# Обратись к результатам
for result in results:
    depth_map = result.depth.data.cpu().numpy()  # torch.Tensor -> NumPy float32, форма (H, W), метры
Полное описание режима predict см. на странице Предсказание.
Результаты работы#
При оценке глубины YOLO возвращает один объект Results для каждого изображения. Каждый результат содержит одну плотную карту глубины с плавающей точкой для всего изображения.
| Атрибут | Тип | Форма | Описание |
|---|---|---|---|
result.depth | DepthMap | (H,W) | Плотная карта глубины с отдельным значением для каждого пикселя. |
result.depth.data | torch.Tensor | (H,W) | Значения глубины в метрах; вызови .cpu().numpy() для NumPy. |
result.boxes | - | - | Боксы экземпляров отсутствуют. |
result.masks | - | - | Маски экземпляров отсутствуют. |
Описание полей Results, специфичных для каждой задачи, см. в разделе Результаты предсказаний по задачам.
Глубина для каждого объекта при сегментации экземпляров#
Сочетай сегментацию экземпляров с оценкой глубины, чтобы определить расстояние до каждого обнаруженного объекта. Запусти обе модели на одном изображении с помощью retina_masks=True, чтобы маски имели исходное разрешение карты глубины, соответствующее разрешению изображения, а затем возьми медиану допустимых значений глубины внутри каждой маски.
from ultralytics import YOLO

image = "https://ultralytics.com/images/bus.jpg"
seg = YOLO("yolo26n-seg.pt")(image, retina_masks=True)[0]
depth = YOLO("yolo26n-depth.pt")(image)[0].depth.data  # (H, W) meters

if seg.masks is not None:
    for mask, cls in zip(seg.masks.data.bool(), seg.boxes.cls):
        values = depth[mask & (depth > 0)]  # valid depth pixels inside this mask
        if values.numel():
            print(f"{seg.names[int(cls)]}: {values.median():.2f} m")
Медиана устойчива к влиянию пикселей фона по краям маски, но описывает видимую поверхность объекта, а не его центр; точность зависит от масштаба глубины модели (см. Калибровка масштаба глубины).
Раскрашивание карты глубины#
Исходная карта глубины — это одноканальный массив чисел с плавающей точкой в метрах: он удобен для вычислений, но его сложно интерпретировать напрямую. Чтобы преобразовать его в цветное изображение, используй функцию colorize_depth из ultralytics.utils.plotting: она преобразует массив глубины (H, W) в цветное изображение BGR (H, W, 3) uint8 (недопустимые пиксели <= 0 отображаются чёрным).
result.plot() уже накладывает эту раскраску на входное изображение с параметрами по умолчанию (cmap="jet", mode="disparity"); вызывай colorize_depth напрямую, если тебе нужно отдельное цветное изображение глубины или другая цветовая карта либо нормализация.
import cv2

from ultralytics import YOLO
from ultralytics.utils.plotting import colorize_depth

model = YOLO("yolo26n-depth.pt")
result = model("https://ultralytics.com/images/bus.jpg")[0]

depth = result.depth.data.cpu().numpy()  # (H, W) float32, meters

# Раскрась так, чтобы ближние объекты были тёплых цветов, и сохрани результат
cv2.imwrite("depth_colored.png", colorize_depth(depth, cmap="spectral"))  # (H, W, 3) BGR uint8

# Зафиксируй диапазон 0–20 м, чтобы один и тот же цвет соответствовал одному и тому же расстоянию на разных кадрах
cv2.imwrite("depth_metric.png", colorize_depth(depth, vmin=0.0, vmax=20.0, cmap="inferno", mode="metric"))

# Наложение с цветовой картой напрямую из объекта Results (используются cmap="jet", mode="disparity")
result.save("depth_overlay.png")
Во всех цветовых картах оттенки меняются от холодных/тёмных к тёплым/ярким. Параметр mode определяет, какой конец шкалы соответствует ближним объектам, а vmin/vmax фиксируют диапазон для разных кадров, чтобы один и тот же цвет всегда обозначал одно и то же расстояние.
| Аргумент | Значение | Описание |
|---|---|---|
cmap | jet (по умолчанию) | Контрастная шкала от синего через зелёный к красному — палитра, используемая в result.plot(). |
cmap | inferno | От чёрного через фиолетовый и оранжевый к жёлтому. Перцептивно равномерная, удобная для людей с нарушениями цветового зрения и хорошо различимая в градациях серого. |
cmap | spectral | От красного через жёлтый и зелёный к синему (matplotlib Spectral_r). |
mode | disparity (по умолчанию) | Нормализует обратную глубину (1/d) между 2-м и 98-м процентилями; тёплые цвета обозначают близкие объекты, а крайние дальние значения сглаживаются. |
mode | metric | Линейно нормализует глубину в метрах между vmin и vmax; тёплые цвета обозначают дальние объекты, поэтому цвета соответствуют фактическому расстоянию. |
Экспорт#
Экспортируй модель YOLO26n-depth в другой формат, например ONNX, CoreML и т. д.
from ultralytics import YOLO

# Загрузить модель
model = YOLO("yolo26n-depth.pt")  # загрузить официальную модель
model = YOLO("path/to/best.pt")  # загрузить пользовательскую модель

# Экспортировать модель
model.export(format="onnx")
Доступные форматы экспорта для оценки глубины YOLO26 перечислены в таблице ниже. Ты можешь экспортировать модель в любой формат с помощью аргумента format, например format='onnx' или format='engine'. Ты можешь напрямую выполнять предсказания или валидацию экспортированных моделей, например yolo predict model=yolo26n-depth.onnx. После завершения экспорта появятся примеры использования твоей модели.
| Формат | Аргумент format | Модель | Метаданные | Аргументы |
|---|---|---|---|---|
| PyTorch | - | yolo26n-depth.pt | ✅ | - |
| TorchScript | torchscript | yolo26n-depth.torchscript | ✅ | imgsz, quantize, dynamic, nms, batch, device |
| ONNX | onnx | yolo26n-depth.onnx | ✅ | imgsz, quantize, dynamic, simplify, opset, nms, batch, data, fraction, device |
| OpenVINO | openvino | yolo26n-depth_openvino_model/ | ✅ | imgsz, quantize, dynamic, nms, batch, data, fraction, device |
| TensorRT | engine | yolo26n-depth.engine | ✅ | imgsz, quantize, dynamic, simplify, opset, workspace, nms, batch, data, fraction, device |
| CoreML | coreml | yolo26n-depth.mlpackage | ✅ | imgsz, dynamic, quantize, nms, batch, device |
| Apple Core AI | coreai | yolo26n-depth.aimodel | ✅ | imgsz, batch, quantize |
| TF SavedModel | saved_model | yolo26n-depth_saved_model/ | ✅ | imgsz, quantize, opset, nms, batch, data, fraction, device |
| TF GraphDef | pb | yolo26n-depth.pb | ❌ | imgsz, opset, batch, device |
| TF Edge TPU | edgetpu | yolo26n-depth_edgetpu.tflite | ✅ | imgsz, quantize, opset, data, fraction, device |
| LiteRT | litert | yolo26n-depth.tflite | ✅ | imgsz, quantize, batch, data, fraction, device |
| PaddlePaddle | paddle | yolo26n-depth_paddle_model/ | ✅ | imgsz, batch, device |
| MNN | mnn | yolo26n-depth.mnn | ✅ | imgsz, batch, dynamic, quantize, simplify, opset, nms, device |
| NCNN | ncnn | yolo26n-depth_ncnn_model/ | ✅ | imgsz, quantize, batch, device |
| IMX500 | imx | yolo11n_imx_model/ | ✅ | imgsz, quantize, data, fraction, nms, device |
| RKNN | rknn | yolo26n-depth_rknn_model/ | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| ExecuTorch | executorch | yolo26n-depth_executorch_model/ | ✅ | imgsz, batch, device |
| Axelera | axelera | yolo26n-depth_axelera_model/ | ✅ | imgsz, batch, quantize, data, fraction, device |
| DEEPX | deepx | yolo26n-depth_deepx_model/ | ✅ | imgsz, quantize, simplify, opset, data, optimize, device |
| Qualcomm QNN | qnn | yolo26n-depth_qnn.onnx | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| Hailo | hailo | yolo26n-depth_hailo_model/ | ✅ | imgsz, name, quantize, data, fraction, simplify, conf, iou, device |
| Huawei Ascend | ascend | yolo26n-depth_ascend_model/ | ✅ | imgsz, batch, name, quantize, opset, simplify, nms, device |
| AMD Xilinx | xilinx | yolo26n-depth_xilinx_model/ | ✅ | imgsz, name, quantize, data, fraction, opset, simplify, device |
nms=None по умолчанию выдаёт необработанные выходные данные для внешней NMS (YOLO26 сохраняет голову без NMS на Axelera). Укажи nms=False, чтобы выбрать доступную голову без NMS; неподдерживаемые форматы используют собственный путь вывода. Записи nms выше указывают форматы, в которые можно встроить NMS с помощью nms=True.
Полное описание export смотри на странице экспорта.
Часто задаваемые вопросы#
Подготовь парные RGB-изображения и карты глубины в формате 16-битных PNG или NPY с числами с плавающей точкой в метрах, затем создай YAML-файл набора данных, указывающий на каталог
images/. Загрузчик автоматически находит файлы глубины, заменяяimagesнаdepthв пути; в первую очередь он ищет.png, а при его отсутствии —.npy.Начни с предобученных весов и используй низкую скорость обучения с AdamW, чтобы при дообучении модель сохранила уже имеющиеся знания (объяснение см. в разделе Дообучение на собственных данных):
Примерfrom ultralytics import YOLO # Загрузи предобученную модель YOLO26 для оценки глубины model = YOLO("yolo26s-depth.pt") # Дообучи модель на собственном наборе данных для оценки глубины results = model.train( data="path/to/your_dataset.yaml", epochs=20, imgsz=640, optimizer="AdamW", lr0=1e-4, warmup_bias_lr=1e-4, )Другие доступные аргументы смотри на странице Configuration.
При валидации оценки глубины выводится набор метрик, используемый в Depth Anything и других работах по монокулярной оценке глубины:
- delta1 / delta2 / delta3 — доля пикселей, в которых отношение предсказанной глубины к эталонной (или обратное отношение) меньше 1.25, 1.25² и 1.25³ соответственно. Чем выше значение, тем лучше.
- abs_rel — средняя абсолютная относительная ошибка. Чем ниже значение, тем лучше.
- rmse — среднеквадратичная ошибка в метрах. Чем ниже значение, тем лучше.
- silog — логарифмическая ошибка, инвариантная к масштабу. Чем ниже значение, тем лучше.
Для каждого изображения предсказание выравнивается по медиане с эталонной глубиной, затем вычисляются метрики этого изображения, а результаты по отдельным изображениям усредняются по всей валидационной выборке. Поэтому все изображения имеют одинаковый вес независимо от количества допустимых пикселей глубины. Изображения, содержащие менее 10 допустимых пикселей с эталонной глубиной, пропускаются и не участвуют в усреднении, поскольку выравнивание медиан по небольшому количеству пикселей бессмысленно; вместо этого для нечисловых предсказаний используются границы диапазона глубины. Такой подход соответствует усреднению по образцам и порогу в 10 пикселей, применяемым в Depth Anything V2.
Карта глубины хранится в виде
torch.Tensorс формой(H, W), где каждое значение — предсказанная глубина в метрах (для массива NumPyfloat32используйresult.depth.data.cpu().numpy()). Получить доступ к карте можно черезresult.depth.dataпосле выполнения предсказания. Её разрешение совпадает с разрешением входного изображения.Ultralytics YOLO26 включает встроенные конфигурации YAML для нескольких наборов данных по оценке глубины, в том числе NYU Depth V2, KITTI, Hypersim, SUN RGB-D и ARKitScenes. Полный список и сведения о форматах см. в руководстве по наборам данных для оценки глубины.
Чтобы выполнить валидацию предобученной модели YOLO26 для оценки глубины, укажи YAML-файл набора данных, используемый для оценки:
Примерfrom ultralytics import YOLO # Загрузи предварительно обученную модель model = YOLO("yolo26n-depth.pt") # Валидировать модель metrics = model.val(data="nyu-depth.yaml") print("delta1:", metrics.delta1) print("abs_rel:", metrics.abs_rel) print("rmse:", metrics.rmse)Экспортируй модель YOLO26 для оценки глубины в ONNX с помощью Python или CLI:
Примерfrom ultralytics import YOLO # Загрузи предварительно обученную модель model = YOLO("yolo26n-depth.pt") # Экспортировать модель в формат ONNX model.export(format="onnx")Подробности об экспорте в различные форматы смотри на странице Export.